

深入解析 JavaScript 代码压缩与代码混淆的核心差异、底层原理、工程实践与技术选型指南。通过直观的代码示例、架构对比图与实施步骤,帮助前端开发者准确选用最适合的技术方案。
JS代码压缩与混淆有什么区别?
作者:极速慢跑
时间:2026-11-19
浏览:629
文章目录
一、核心维度全景对比
在日常前端开发和构建配置中,“压缩”和“混淆”常被放在打包流水线的最后环节一起讨论,导致不少初学者误以为“压缩就是一种初级的混淆”或者“混淆兼具更强的压缩功能”。 事实上,两者在设计初衷、算法策略、性能影响和工程定位上有着本质的差异。
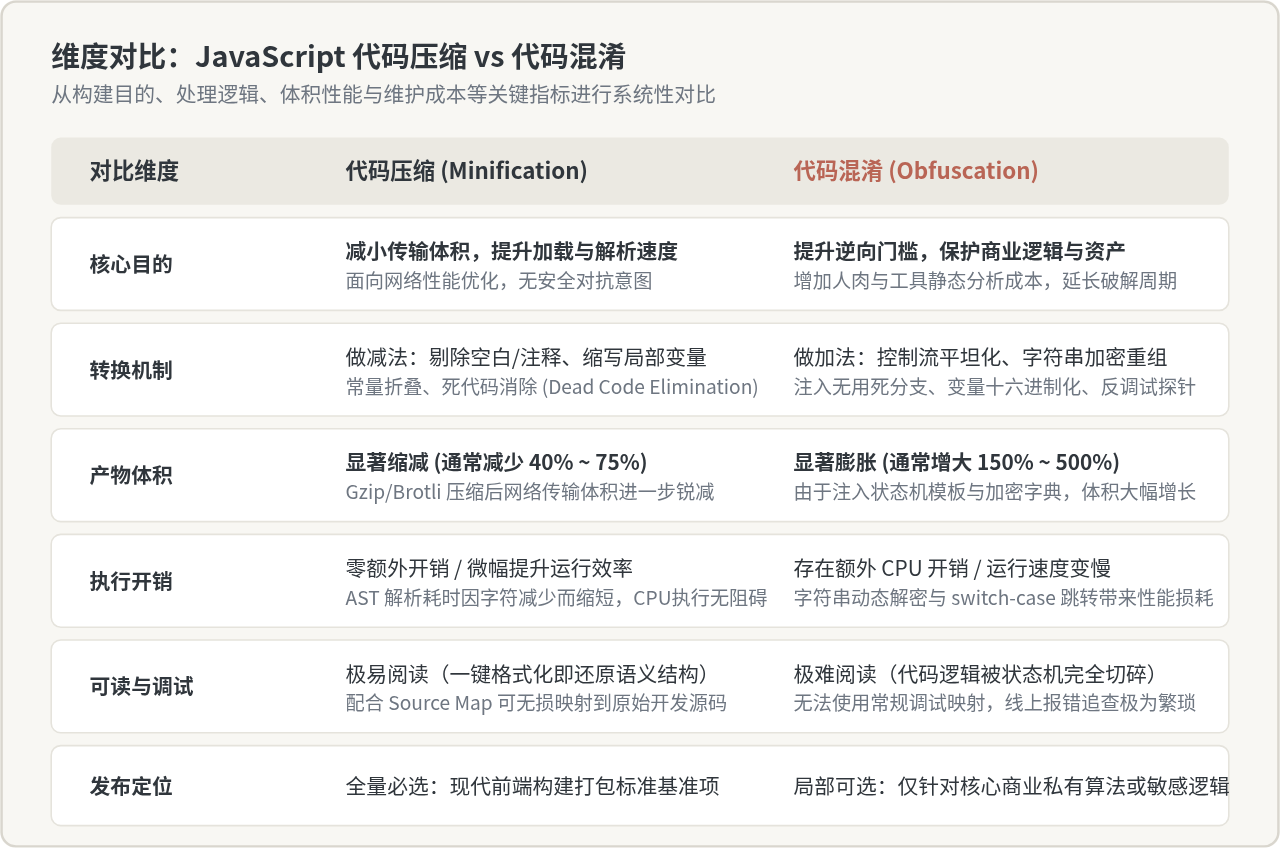
通过上述对照可以看出:
- 压缩是“减法工程”:所有转换动作都为了剔除多余字节。不仅体积锐减,而且不会对运行期 CPU 产生额外开销,是任何现代线上项目的必选基础设施。
- 混淆是“加法工程”:为了对抗静态逆向与语义分析,编译器主动插入了大量复杂的中间状态机、解密函数和死分支。体积显著增大且存在不可忽视的性能开销,属于商业核心代码的按需选配。
二、深入解析:什么是 JS 代码压缩?
JavaScript 作为一种解释型脚本语言,在部署到生产环境之前,源码中包含了大量面向人类开发者的辅助信息,例如语义化的长变量名、空行缩进、逻辑注释以及开发环境特有的调试分支。这些信息对于浏览器内核执行来说毫无价值,只会白白消耗用户的网络带宽和首屏等待时间。
代码压缩的目标是在100% 保持原有业务运行逻辑的前提下,将代码体积缩减至极限。它主要执行以下三项核心处理:
- 语法修剪(Whitespace & Comments Removal):彻底消除所有缩进空格、连续换行、末尾无用分号以及单行/多行注释。
- 作用域安全短名化(Identifier Mangling):分析当前闭包与函数局部作用域,在确保不破坏全局变量和对外暴露 API 的前提下,把类似
calculateMonthlyInvoiceAmount的局部长变量重命名为a、b、c等单字符。 - 死代码消除与常量折叠(Dead Code Elimination / Tree-Shaking):静态计算恒定表达式(如将
24 * 60 * 60 * 1000编译为86400000),并根据环境变量剪除永远不会被执行的分支(如if (process.env.NODE_ENV !== 'production'))。
代码对比示例:压缩前后
我们来看一段未压缩的原始订单处理函数:
// 源码:包含长变量名、注释与空行
function calculateOrderTotal(basePrice, taxRate, discountAmount) {
    // 计算税费部分
    const calculatedTax = basePrice * taxRate;

    // 计算扣减折扣后的应收总价
    const finalPayableAmount = basePrice + calculatedTax - discountAmount;

    if (finalPayableAmount < 0) {
        return 0;
    }
    return finalPayableAmount;
}
经过专业压缩工具(如 Terser 或 esbuild)处理后,输出结果如下:
function calculateOrderTotal(e,t,r){const n=e+e*t-r;return n<0?0:n}
压缩的本质边界:
可以看到,虽然变量名变短了,但逻辑关系依然非常清晰(
n = e + e * t - r)。任何开发者只需在 Chrome 开发者工具中点击左下角的代码格式化按钮({}),就能在几秒钟内完全还原出原有函数的控制逻辑。因此,压缩绝不具备防范逆向破解的能力。
三、深入解析:什么是 JS 代码混淆?
代码混淆的核心目标是安全防御与对抗逆向。由于 JavaScript 运行在完全不受开发者信任的客户端(浏览器、小程序、桌面客户端环境),只要代码被下载到本地,黑客、爬虫作者或竞争对手就能直接审查。
如果前端包含了诸如核心加密通信算法、自定义前端签名生成器、设备指纹风控探针、知识产权私有计算模型等敏感逻辑,普通的压缩代码便会门户大开。混淆器通过对 AST 抽象语法树进行重构,将直观的代码改写为在人类看来极其混乱、极难被静态反编译工具理解的形式。
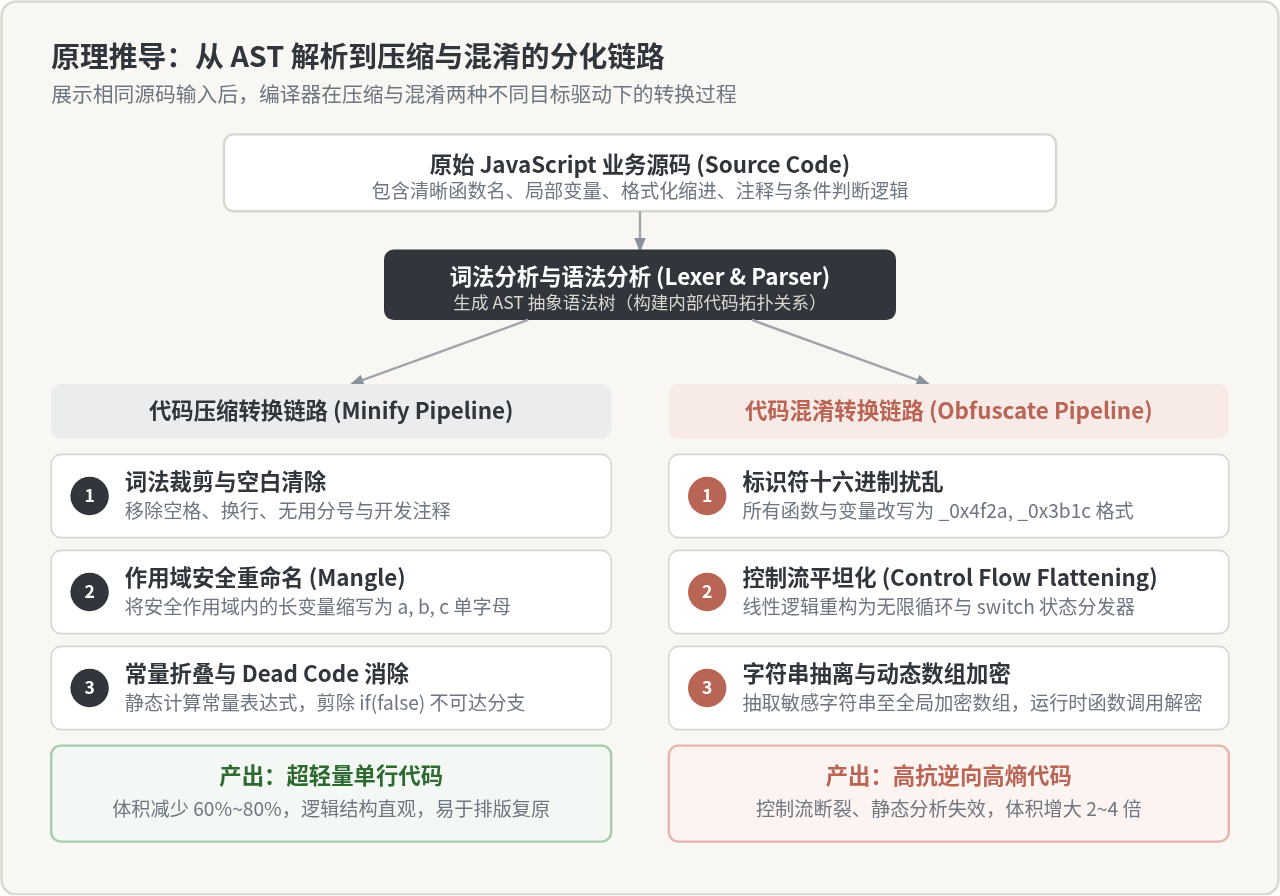
混淆器常用的四种深度对抗手段
- 1. 标识符十六进制混乱化:将全部函数名、参数名和局部变量转换为极具迷惑性的无序十六进制字符,例如
_0x4f1a、_0x2b8c,从视觉上彻底剥离语意。 - 2. 控制流平坦化(Control Flow Flattening):打破原本自然的
if-else、for、while线性控制流,将其解构为一个包裹在无限循环中的巨大switch-case状态分发机,使得任何反编译分析工具都无法推断真实的执行顺序。 - 3. 字符串数组提取与动态解密(String Array Rotation):将代码中出现的所有明文字符串提取到一个全局加密大数组中,运行时通过复杂的偏移量函数进行动态解密调用,阻断基于关键词的静态搜索。
- 4. 死代码注入与反调试(Dead Code & Self Defending):在关键函数中插入大量永远不会执行但语法合法的无用垃圾指令;同时加入
debugger定时器循环与函数完整性校验,一旦检测到控制台打开或代码被改动,直接使运行环境挂起崩溃。
代码对比示例:混淆处理效果
还是上述同样的计算函数,若使用主流混淆器(如 javascript-obfuscator)启用控制流平坦化与字符串加密,产出代码会转变为类似以下形式:
const _0x1c4a = ['split', '1|3|0|2', 'state'];
(function(_0x2d, _0x1a){
    // 字符串数组移位与自校验逻辑
})(_0x1c4a, 0x1f4);

function calculateOrderTotal(_0x4b12, _0x3e18, _0x5a01) {
    var _0x29f4 = _0x1c4a[1]['split']('|'), _0x38d1 = 0;
    while (!![]) {
        switch (_0x29f4[_0x38d1++]) {
            case '0': if (_0x5f02 < 0) return 0; continue;
            case '1': var _0x11e9 = _0x4b12 * _0x3e18; continue;
            case '2': return _0x5f02;
            case '3': var _0x5f02 = _0x4b12 + _0x11e9 - _0x5a01; continue;
        }
        break;
    }
}
混淆的沉重代价:
可以看到,仅仅 10 行逻辑的代码,在混淆后体积暴增了 3 倍以上。更关键的是,运行期每次执行都需要进行字符串解析、数组查找和
switch-case 跳转,对移动端设备或高频调用函数的性能损耗极为显著。
四、工程化落地:现代前端构建流水线中的实施步骤
在实际的前端工程化实践中,我们既不能为了追求绝对安全而“全站混淆”,也不能仅凭压缩“裸奔上线”。工业界的标准做法是:全站全量执行现代压缩,核心敏感模块进行定向定向混淆。
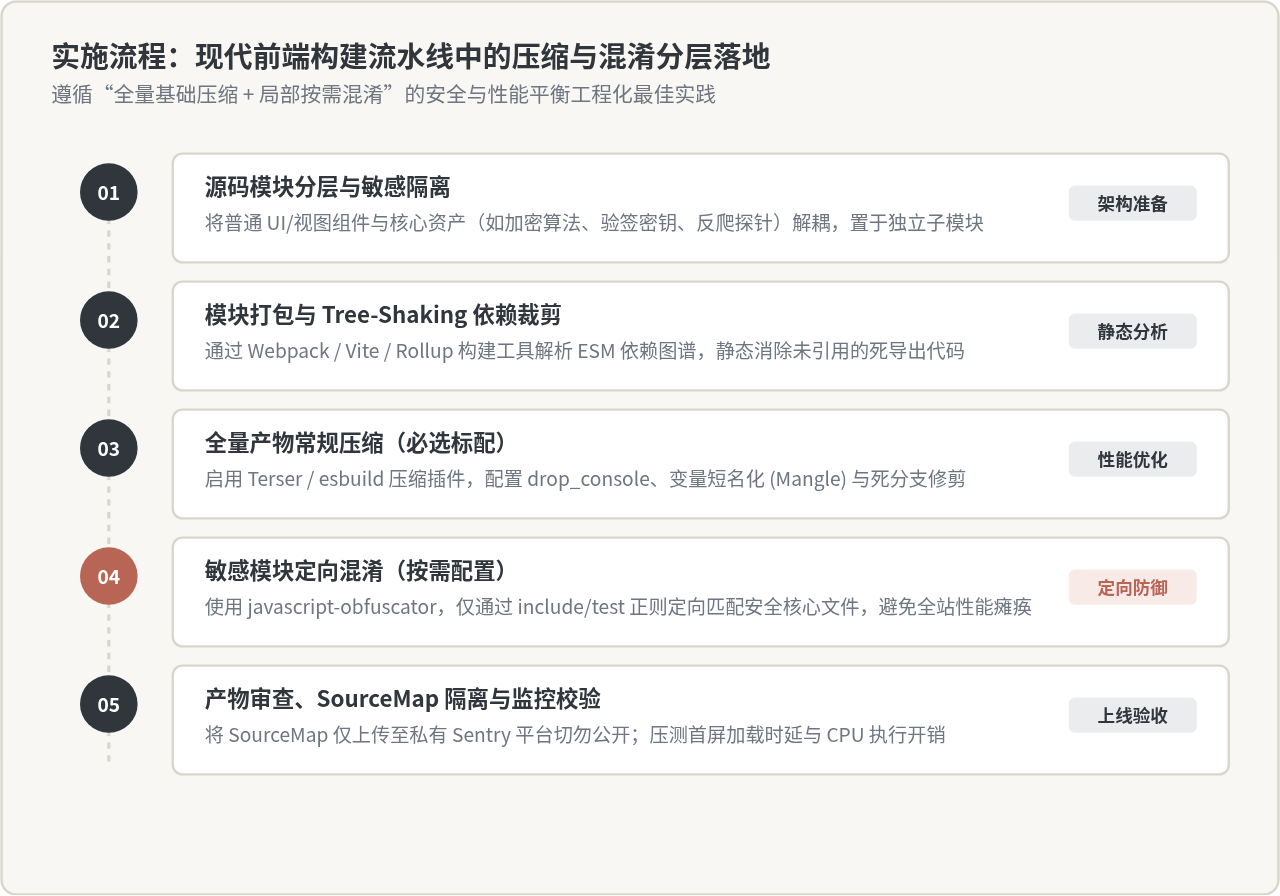
关键步骤与配置参考
以下以主流的构建工具配置为例,展示如何将代码压缩与定向混淆安全整合:
-
第一步:源码目录规范隔离
将业务 UI 页面与敏感算法剥离,例如创建src/security/crypto-core.js专门存放接口签名与私有计算,其他业务组件仅做普通引用。 -
第二步:启用全局压缩(Terser / esbuild)
在打包工具中保持默认的生产压缩设置,确保 100% 的静态文件完成空白剔除与死代码消除。 -
第三步:配置局部定向混淆插件
通过正则过滤仅针对security/目录下的构建产物应用混淆插件,示例如下(以 Webpack 插件配置为例):
const JavaScriptObfuscator = require('webpack-obfuscator');

module.exports = {
    // ... 其他基础构建配置
    optimization: {
        minimize: true, // 全局启用常规 Terser 压缩
    },
    plugins: [
        new JavaScriptObfuscator({
            // 混淆参数配置
            rotateStringArray: true,
            stringArray: true,
            controlFlowFlattening: true,
            controlFlowFlatteningThreshold: 0.75,
            deadCodeInjection: false, // 慎用:注入死代码会导致体积剧增
        }, [
            // 关键:排除所有普通业务 chunk,仅匹配核心安全模块
            '**/!(security-core*).js'
        ])
    ]
};-
第四步:Source Map 安全隔离
生产环境严禁将.map源码映射文件直接公开上传到 CDN!应在 CI/CD 流水线中把 Source Map 仅上传到内部 Sentry/监控平台,随后从公网发布目录中彻底删除。 -
第五步:性能与异常监控验收
在准发布环境中,重点对比开启混淆前后核心页面的首屏加载时延(LCP/FID)与 CPU 占用率,确保没有引入死循环或内存泄漏。
五、常见认知误区与安全底线
在面对代码保护和性能优化时,开发者最常陷入以下三个认知误区:
| 认知误区 | 客观技术事实 | 推荐工程对策 |
|---|---|---|
| 误区 1:只要代码混淆了,前端系统就是绝对安全的 | 混淆本质上只是“增加逆向的时间与精力成本”,绝非密码学级别的加密。任何在浏览器端运行的代码,攻击者都可以通过动态插桩、内存 Hook 或 AST 反混淆工具逐步还原。 | 安全底线在后端:永远不要把核心鉴权、重要业务规则、数据库连接凭据依赖于前端;必须建立在完善的服务端权限验证上。 |
| 误区 2:代码压缩后变量都变短了,也能起到防盗版作用 | 压缩仅仅缩减了变量名,函数调用链、API 路由、数据结构完全直白可见。熟练工程师仅凭 Network 抓包与断点调试,即可在半小时内摸清压缩代码的业务逻辑。 | 不要把压缩当防守武器。需要防范爬虫和逆向时,必须使用专门的混淆手段或动态风控方案。 |
| 误区 3:为了万无一失,应该全站所有文件都深度混淆 | 全站开启控制流平坦化与字符串加密,会导致 Bundle 体积增长 200%~400%,在移动端造成严重掉帧、电池发热,并使 Sentry 等监控堆栈完全失真。 | 遵循最小必要原则。98% 的通用业务 UI 代码只需标准压缩,仅对 2% 的关键算法使用混淆。 |
六、技术选型与防护策略总结
在做技术选型决策时,请参考下方根据业务性质与运行环境总结的决策路径:
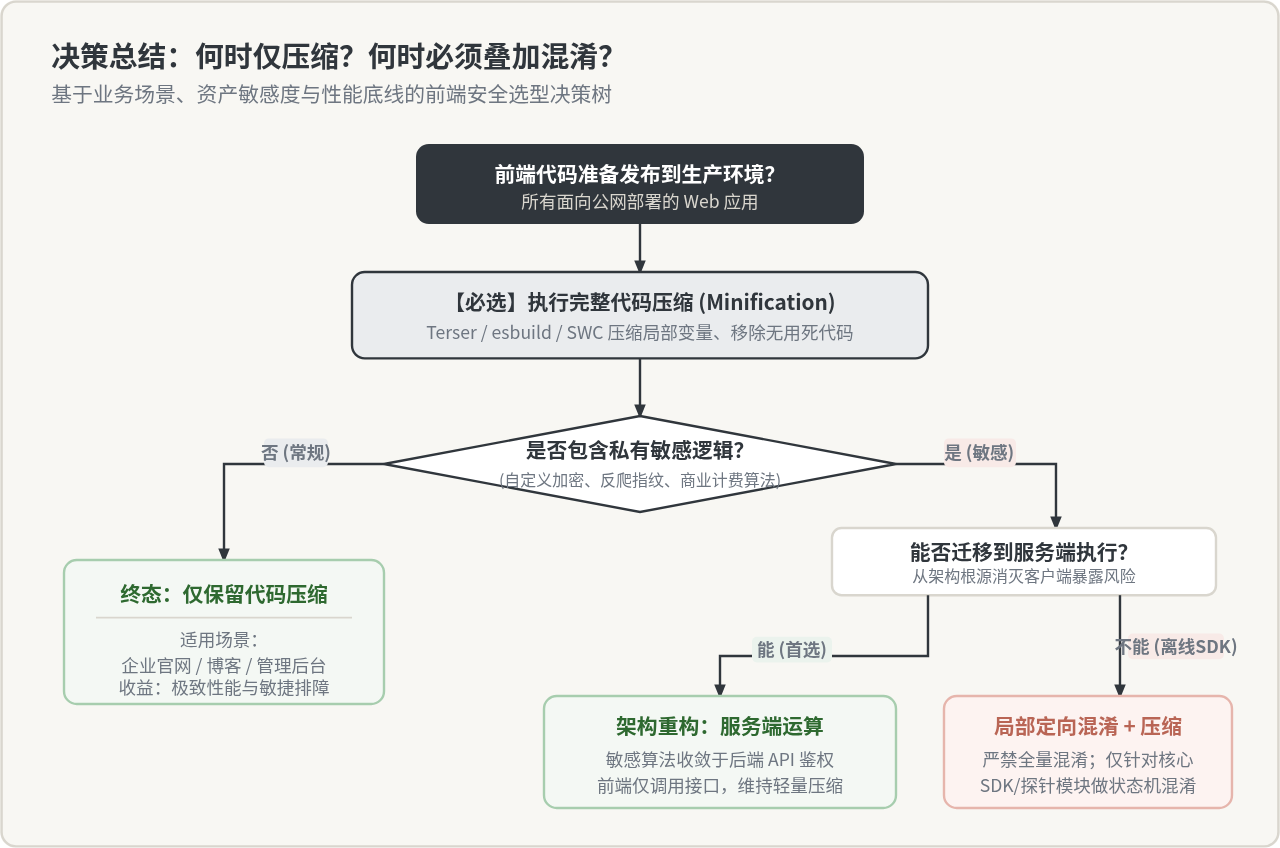
核心行动原则归纳:
- 默认底线:无论任何前端项目,只要发布到生产环境,代码压缩(Minification)是 100% 必须执行的标配。
- 架构首选:遇到核心算法与商业机密,第一优先级是重构架构转移至服务端运行,从物理根源上切断代码在公网暴露的可能。
- 最后防线:对于离线运行、SDK 发行包或防爬风控探针等不可避免必须在客户端运行的模块,采用“定向局部混淆 + 基础压缩”的组合策略,以最小的性能代价换取最大化的逆向阻断效果。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章