

深入解析 JavaScript 反混淆核心原理,讲解如何利用 AST(抽象语法树)实现代码结构化建模、常量折叠、字符串数组解密、控制流平坦化还原及无用代码剔除。
JS反混淆原理简述:AST抽象语法树怎么还原代码结构
作者:小括号
时间:2026-11-03
浏览:80
文章目录
技术原理
JavaScript 逆向
编译器前端
阅读时长约 8 分钟
代码规范:Babel AST
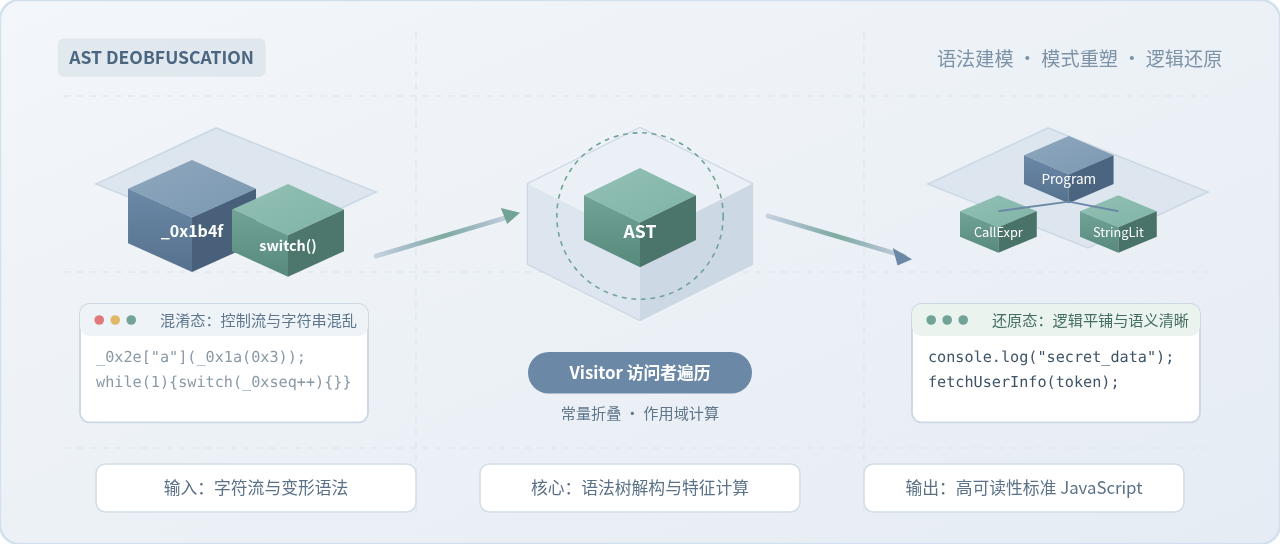
JavaScript 反混淆的核心本质,不是依靠容易误伤且缺乏上下文感知的正则表达式进行字符替换,而是借助编译器前端的 AST(Abstract Syntax Tree,抽象语法树) 技术,将非结构化的代码字符序列转换为拥有语法类型、层级嵌套与词法作用域的“树状对象”。在语法树层面,程序逻辑被拆解为可精确识别的节点单元,开发者得以通过静态遍历、表达式安全求值、依赖追踪以及节点重组,把被打散的控制流、隐藏的加密字符串和嵌套的二元运算精确还原为易于阅读的原生代码结构。
一、为什么文本匹配无法胜任 JS 代码反混淆
在面对现代混淆工具(如 Obfuscator、Terser 等)生成的代码时,初学者往往倾向于使用正则表达式或编辑器全局查找替换。这种做法在处理简单的十六进制字面量(如将 a 替换为 "a")时勉强可行,但一旦涉及复杂的语法结构,文本匹配便会迅速失效:
- 缺乏作用域感知: 正则表达式只能匹配字符形态,无法区分变量的生命周期。同名变量在不同函数嵌套作用域中代表完全不同的实体,粗暴替换会导致全局或闭包变量被意外污染。
- 无法解析上下文语义与嵌套优先级: 如
var a = b + c * d;与var a = (b + c) * d;,文本层面非常相似,但运算符结合律带来的语法结构差异仅靠正则极难可靠推导。 - 无法应对结构性变形: 诸如控制流平坦化将代码打散进
while-switch状态机,或者字符串通过动态自执行函数索引,这类混淆本质上是语法逻辑的扭曲,纯文本层面根本不存在直接对应明文的规律。
因此,反混淆必须深入到“编译器语法分析”的层次,将扁平的代码字符串构建成包含完整语义的抽象语法树。
二、什么是 AST:从源码文本到语法树对象
浏览器引擎在执行 JavaScript 时,首先会经历两个核心解析阶段:词法分析(Lexical Analysis) 与 语法分析(Syntactic Analysis)。AST 正是语法分析阶段的输出成果。
词法分析器(Scanner / Tokenizer)逐字符扫描源代码,将其切割为不可再分的词法单元流(Tokens),例如保留关键字 var、标识符 total、赋值符号 = 和数值常量 10。
语法分析器(Parser)随后依据 ECMAScript 语法文法,将线性的 Tokens 按照运算符优先级、语句结合规则组合成一棵自顶向下的多叉树,树上的每个节点都对应着代码中的一个语法结构单元。
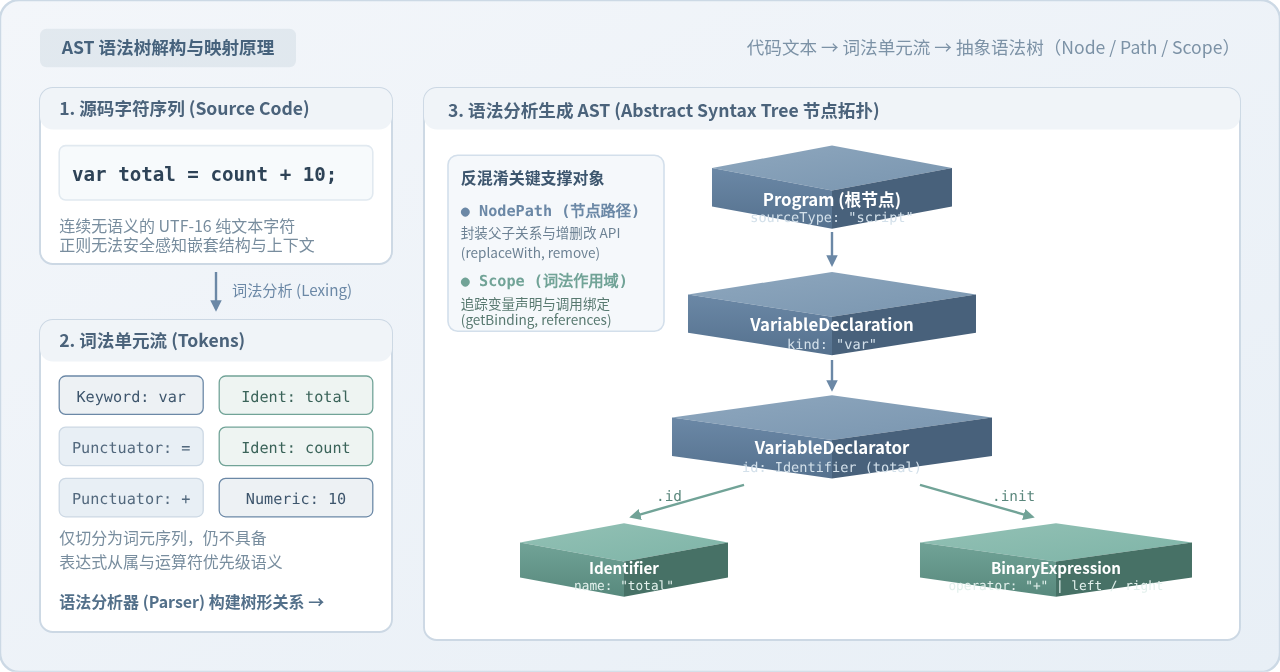
以一条简单的变量赋值语句 var total = count + 10; 为例,在标准 AST 中会被拆解为以下分层节点:
Program:整个脚本文件的根节点,包含所有顶层语句。VariableDeclaration:变量声明语句节点,记录声明关键字kind = "var"。VariableDeclarator:具体的变量声明项,左侧id为Identifier(name="total"),右侧init指向初始化表达式。BinaryExpression:二元加法表达式节点,其operator属性为"+",左子节点left为Identifier(count),右子节点right为NumericLiteral(value=10)。
核心支撑对象:NodePath 与 Scope
在实际编写 AST 脚本(如 Babel 工具链)时,我们操作的往往不是孤立的节点(Node),而是封装后的 NodePath(节点路径)。NodePath 记录了当前节点在整棵树中的相对位置、父子关系以及替换与删除节点的 API;同时,每个节点所处的 Scope(词法作用域) 记录了当前作用域内所有标识符的声明来源(Binding)及所有引用位置(References),这是追踪混淆变量生命周期与调用关系的基石。
在实际编写 AST 脚本(如 Babel 工具链)时,我们操作的往往不是孤立的节点(Node),而是封装后的 NodePath(节点路径)。NodePath 记录了当前节点在整棵树中的相对位置、父子关系以及替换与删除节点的 API;同时,每个节点所处的 Scope(词法作用域) 记录了当前作用域内所有标识符的声明来源(Binding)及所有引用位置(References),这是追踪混淆变量生命周期与调用关系的基石。
三、基于 Babel 的 AST 反混淆标准化操作流水线
在 JavaScript 工程生态中,Babel 是最成熟且广泛使用的编译器前端工具链。利用 Babel 进行反混淆,标准操作流程包含五个闭环阶段:
- 语法建模(Parse): 使用
@babel/parser读取混淆的 JS 脚本字符串,指定现代语法支持插件(如 optionalChaining、nullishCoalescing 等),将其解析为内存中的 AST 树对象。 - 模式检测(Traverse): 使用
@babel/traverse深度优先遍历语法树。通过“访问者模式(Visitor Pattern)”,针对感兴趣的节点类型(如BinaryExpression、CallExpression、SwitchStatement等)注册处理函数。 - 作用域与语义计算(Evaluate): 访问到目标节点时,结合当前 NodePath 的
scope.getBinding()验证变量是否为全局常量或闭包内固定算法,利用path.evaluate()对常量表达式进行静态推导。 - 结构重塑与节点置换(Transform): 使用
@babel/types构建标准化的新节点,通过path.replaceWith()将混淆节点替换为计算后的明文节点,或者通过path.remove()安全移除死代码。 - 代码重现(Generate): 使用
@babel/generator将修改后的 AST 重新格式化输出为排版规整、语义清晰的 JavaScript 代码。
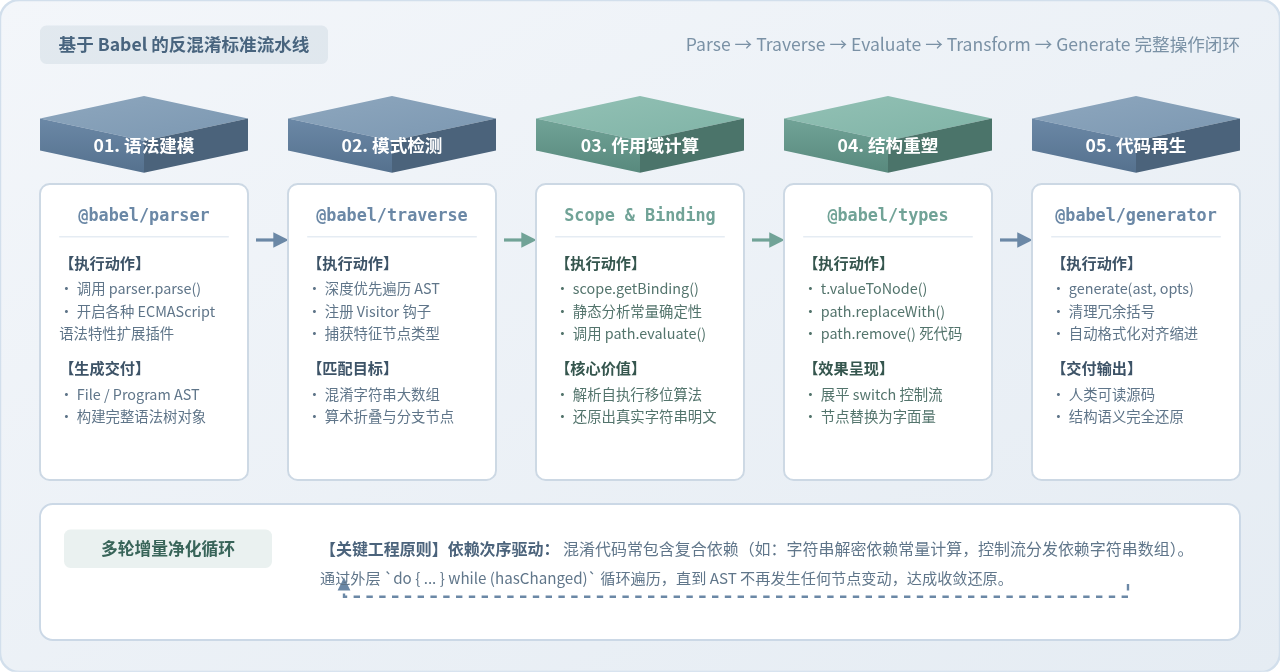
需要特别注意,复杂的混淆器往往存在层层嵌套的特征(例如先通过常量折叠求出数组下标,才能解密字符串;解密出字符串后,才能确定控制流的分发顺序)。因此,工程实现中通常采用 多轮增量迭代(Fixed-point Iteration) 机制,通过循环遍历直到整棵 AST 不再发生任何修改,从而达成彻底还原。
四、AST 还原混淆代码结构的四大核心场景
无论是商业加固工具还是开源混淆器(如 javascript-obfuscator),其常见手法均可在 AST 层面找到确定性的逆向还原方案。
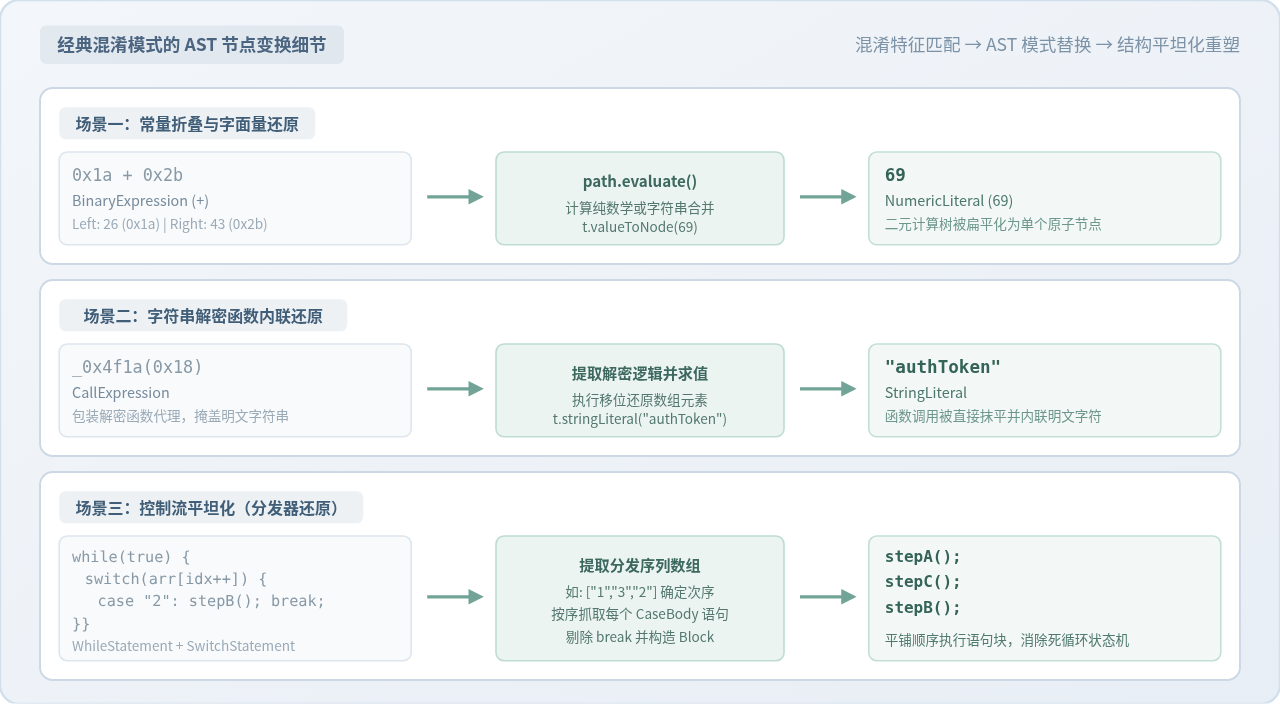
1. 常量折叠与字面量还原
混淆器经常将简单的数字或布尔值拆分成晦涩的运算式,例如用 0x1a + 0x2b 代替 69,用 ![] + [] 代替 "false",或者将字符串转义为 16 进制字符(如 hello)。
还原思路: 遍历所有的 BinaryExpression 节点,调用 Babel 提供的 path.evaluate()。如果计算结果属性 confident 为 true,说明该表达式为纯确定性常量,没有外部运行时副作用,直接调用 types.valueToNode(value) 创建新的字面量节点替换原有二元运算。
2. 字符串数组提取与解密函数内联
这是最典型的特征混淆:混淆器将全局所有敏感字符串提取到一个大数组中,紧接着通过自执行函数进行数组乱序位移,并在业务代码中使用包装函数(如 _0x4f1a(0x18))按索引动态取回字符串。
还原思路:
- 在 AST 中定位大数组声明与自执行移位函数代码块。
- 在受控的 Node.js 上下文中预先执行这部分初始化算法,使解密函数在内存中恢复可用状态。
- 遍历 AST 中所有的
CallExpression节点,匹配调用名称是否为解密函数名(如_0x4f1a)。 - 提取调用传入的实参(如数字字面量),在本地执行解密函数获取解密后的真实字符串,最后将当前的
CallExpression节点直接替换为types.stringLiteral(decryptedStr)。
3. 控制流平坦化重构
控制流平坦化将代码原有的线性逻辑切成多个碎片,全部塞进 while(true) { switch(...) { ... } } 的状态机中,由一个以特定模式索引的分发变量(如字符串序列 "3|1|2")来串联执行顺序,极大破坏了反编译工具和逆向者的代码阅读连贯性。
还原思路:
- 匹配
WhileStatement内嵌套单个SwitchStatement的特征结构。 - 提取
switch依赖的分发序列变量(如常量数组或字符串拆分表达式"3|1|2".split("|"))。 - 遍历收集
SwitchCase映射表,提取每个case块中的所有有效语句,剔除末尾无意义的break;或continue;。 - 根据分发序列数组的顺序(如先 3、再 1、后 2),按逻辑次序将语句重新组合为一个平坦的
BlockStatement数组,替换掉原来的整个while死循环。
4. 无用死代码剔除与作用域净化
混淆器通常会插入大量永远不会执行的分支(如 if (false) { ... })或从未被调用的混淆函数,以此干扰逆向分析。
还原思路: 借助 Scope 对象进行引用计数检测。当所有解密调用和常量表达式被内联之后,通过 path.scope.getBinding(varName) 查询该标识符的引用记录。如果 binding.referenced === false,说明该变量或函数在整棵语法树中已无任何使用者,可安全调用 path.remove() 将其连同声明一并彻底剥离。
可运行实战示例:Node.js AST 脚本
以下提供一个基于 Babel 编写的完整脱混淆最小原型,展示如何将混淆代码解析、折叠算术表达式并内联明文字符串:
const parser = require("@babel/parser");
const traverse = require("@babel/traverse").default;
const types = require("@babel/types");
const generator = require("@babel/generator").default;

// 待还原的混淆代码片段
const obfuscatedSource = `
var _0xarr = ["admin", "read", "token"];
function _0xget(idx) { return _0xarr[idx]; }
var authKey = _0xget(0);
var timeout = 0x3e8 + 0x7d0; // 1000 + 2000
var deadVar = "unused_trash";
`;

// 1. 语法建模 Parse
const ast = parser.parse(obfuscatedSource);

// 2. 遍历匹配与节点变换 Transform
traverse(ast, {
  // 场景A:二元运算常量折叠 (1000 + 2000 => 3000)
  BinaryExpression(path) {
    const evaluated = path.evaluate();
    if (evaluated.confident) {
      path.replaceWith(types.valueToNode(evaluated.value));
    }
  },

  // 场景B:函数调用内联解密 (_0xget(0) => "admin")
  CallExpression(path) {
    const { callee, arguments: args } = path.node;
    if (types.isIdentifier(callee, { name: "_0xget" }) && args.length === 1) {
      if (types.isNumericLiteral(args[0])) {
        const targetStr = ["admin", "read", "token"][args[0].value];
        path.replaceWith(types.stringLiteral(targetStr));
      }
    }
  },

  // 场景C:清理无引用死代码
  VariableDeclarator(path) {
    const binding = path.scope.getBinding(path.node.id.name);
    // 移除非自身引用的无用变量
    if (binding && !binding.referenced && path.node.id.name === "deadVar") {
      path.remove();
    }
  }
});

// 3. 代码重现 Generate
const { code: restoredSource } = generator(ast, {
  comments: false,
  compact: false
});

console.log("=== 还原后的清晰代码 ===");
console.log(restoredSource);
运行上述脚本后,混淆代码中的十六进制常量加法被直接折叠为数字 3000,加密调用 _0xget(0) 被直接替换为明文字符串 "admin",而死代码变量 deadVar 则被整洁剔除。
五、AST 反混淆的实际工程边界与注意事项
尽管 AST 在语法与逻辑层面的结构重组能力极其强大,但在面对生产级高度对抗的加固代码时,依然存在明确的能力边界与工程限制。
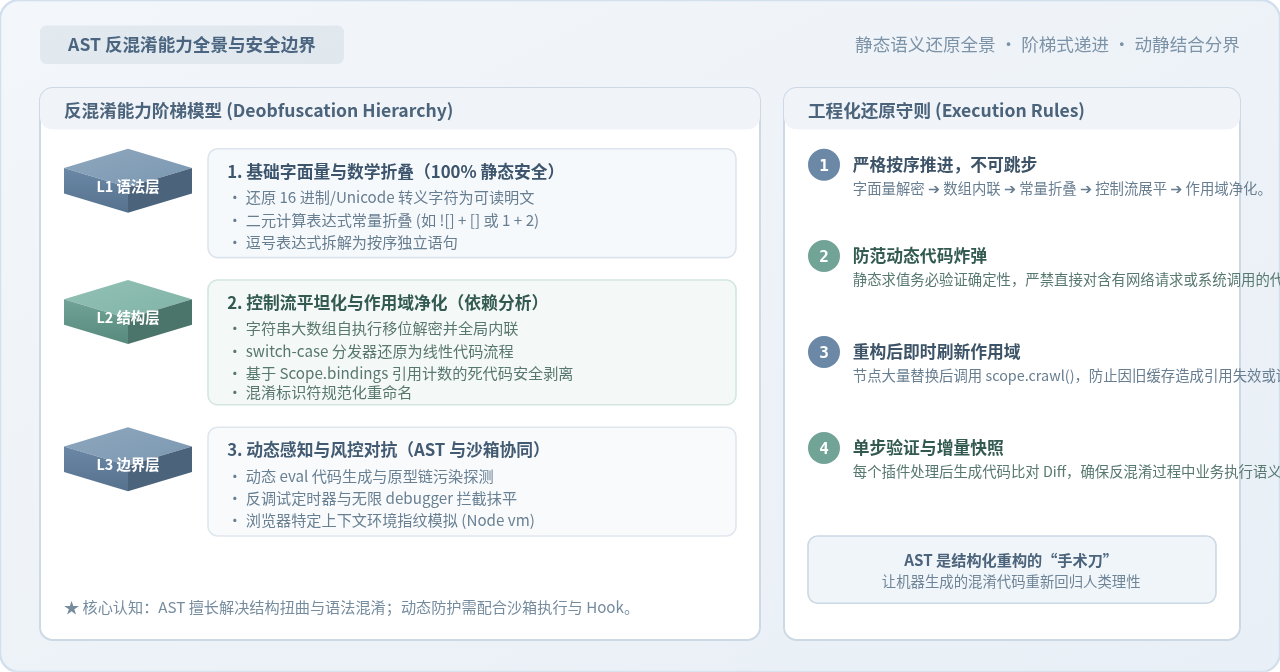
1. 严格遵守执行次序
反混淆插件的执行步骤存在极强的单向依赖关系。如果过早进行死代码清理,可能会误删尚未被内联的解密函数;若先执行控制流展开,此时分发器判断条件可能还包含未解密的表达式。规范的执行链条必须保持:
- 解密字典构建: 先还原自执行移位函数与基础字典数组;
- 调用处内联: 将所有包装调用替换为基础字面量;
- 通用表达式折叠: 解决所有确定性数值与布尔计算;
- 控制流结构平铺: 将状态机 switch-case 恢复为顺序块;
- 清理净化: 刷新作用域(
scope.crawl()),安全剔除无用变量并规范命名。
防范静态求值中的“代码炸弹”
不要对混淆代码中的函数盲目执行原生
不要对混淆代码中的函数盲目执行原生
eval。高对抗性混淆器会特意埋入带有副作用的陷阱代码(如检测宿主环境是否具备 Node.js 的 process 对象,一旦发现便触发无限死循环或内存耗尽崩溃)。对于复杂的解密函数,务必将其剥离并置于轻量级沙箱(如 Node.js 的 vm 模块)中隔离执行。
2. AST 静态分析与动态分析的结合边界
对于纯语法与控制流层面的变形(L1 语法层与 L2 结构层),纯静态 AST 分析即可达到完全还原的效果。然而,面对基于动态上下文风控、原型链篡改、以及检测代码 Function.prototype.toString() 的强动态防御(L3 边界层),仅依靠静态语法树是无法感知运行时真实状态的。
成熟的逆向工程实践通常采用“AST 静态结构还原 + 浏览器/沙箱动态补环境插桩”的双轮驱动架构:先借助 AST 将大部分混乱逻辑“脱水”为清晰代码,再通过动态调试补齐运行环境,从而彻底打破前端混淆的保护屏障。
六、核心技术要点总结速查表
| 混淆手法 | AST 节点识别特征 | 核心还原机制 / API | 还原后输出形式 |
|---|---|---|---|
| 十六进制 / 进制混淆 | NumericLiteral (带有 extra.raw 16进制形态) |
delete path.node.extra 或重新构造字面量 |
原生十进制数值 (如 255) |
| 二元表达式混淆 | BinaryExpression (纯确定性子节点) |
path.evaluate() 结合 types.valueToNode() |
折叠后的常量结果 (如 true, "hello") |
| 字符串移位数组 | CallExpression (特定解密函数名与整数参数) |
提取移位算法求值,替换为 types.stringLiteral() |
内联明文字符串 (如 "loginApi") |
| 控制流平坦化 | WhileStatement + 嵌套 SwitchStatement |
分析分发数组,重排 case 语句块为 BlockStatement |
线性的自顶向下顺序执行代码 |
| 僵尸死代码 | 无引用的 VariableDeclarator / FunctionDeclaration |
scope.getBinding().referenced === false 调用 path.remove() |
冗余语句彻底剥离,源码体积减小 |
掌握 AST 的核心意义在于,它让逆向分析跳出了“字符捉迷藏”的低效泥潭,直接立足于程序语法的客观规律。无论是自动化脱混淆工具开发,还是对复杂前端代码的深入理解,AST 都是开发者手中最为精准而强大的“手术刀”。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章