
深入讲解JavaScript正则表达式的两种创建方式(字面量与RegExp构造函数)的运行机制、编译时机与双重转义差异,系统归纳常用元字符(字符组、边界符、量词、分组)的匹配逻辑与安全开发避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
JS正则表达式基础:字面量与RegExp构造函数的区别及常用元字符
作者:拾光
时间:2026-11-05
浏览:447
文章目录
两种创建方式的语法与运作机制
在 JavaScript 中,正则表达式是 RegExp 类的实例对象。虽然字面量和构造函数最终都会生成正则表达式对象,但在书写形式与底层执行机制上各有明确的分工。
1. 字面量方式(RegExp Literal)
字面量语法将匹配模式直接包裹在两个正斜杠 /pattern/flags 之间,末尾附带可选的修饰符(如 g、i、m、u、s)。
// 匹配 11 位中国大陆手机号码的字面量正则
const phoneRegex = /^1[3-9]\d{9}$/;

// 执行验证
const isValid = phoneRegex.test("13800138000"); // 结果:true字面量语法的核心特征是编译时静态解析。当 JavaScript 引擎加载并解析脚本代码时,字面量正则表达式便被编译成内部匹配状态机。如果表达式本身固定不变,使用字面量不仅语法紧凑,而且能够避免运行时的重复编译开销。
2. RegExp 构造函数方式(RegExp Constructor)
构造函数语法通过 new RegExp(patternString, flagsString) 创建正则对象。它的首个参数为表示模式的字符串,第二个参数为修饰符字符串。
// 通过构造函数创建等价的正则对象
const phoneRegex = new RegExp("^1[3-9]\d{9}$");

// 也可以动态传入修饰符
const caseInsensitiveRegex = new RegExp("hello", "i");构造函数的关键能力在于运行时动态编译。由于接收的是普通字符串,开发者可以在程序运行阶段根据变量、接口返回数据或用户在界面输入的搜索词,动态拼装正则表达式。
字面量与 RegExp 构造函数的核心区别
许多初学者常将两者视为“简单的写法不同”,但在实际工程中,两者的差异直接决定了代码是否报错以及运行性能表现。核心差异主要体现在以下三个维度:
| 对比维度 | 字面量语法 (/pattern/) |
RegExp 构造函数 (new RegExp()) |
|---|---|---|
| 编译时机 | 脚本加载解析阶段完成静态编译 | 代码运行到该构造语句时动态编译 |
| 动态变量支持 | 不支持变量拼接与动态插值(写死模式) | 完全支持,可用模板字符串或加号灵活拼接 |
| 转义字符写法 | 单层转义(如 \d、\.) |
双重转义(需写作 "\d"、"\.") |
| 循环内执行性能 | 引擎可对不变的字面量进行缓存优化 | 每次执行都会重新解析字符串并编译,消耗内存与 CPU |
| 适用场景 | 固定的格式校验规则(手机号、邮箱、身份证) | 根据外部参数、搜索关键字动态生成的模式 |
核心难点:反斜杠 \ 的双重转义陷阱
为什么在构造函数中写 new RegExp("\d+") 会匹配失败?这是由于 JavaScript 的两阶段字符串解析机制造成的。
当我们在 JavaScript 源代码中书写双引号或单引号字符串时,反斜杠 \ 是字符串字面量本身的转义引导符(例如
表示换行, 表示制表符)。如果反斜杠后面跟随的不是合法的字符转义序列,JavaScript 字符串解析器会默认忽略反斜杠,将其视为普通字符本身。
- 字面量流程:
/\d+/直接由词法分析器交由正则表达式编译器,编译器直接识别\d为预定义数字字符。 - 构造函数流程: 源码
"\d+"先经过字符串解析,由于\d不是标准转义序列,反斜杠被丢弃,内存中的实际字符串变成了"d+"。随后该字符串被传递给正则引擎,正则引擎最终生成的规则是/d+/(匹配字母 d 一次或多次),导致数字校验完全失效。
因此,若要在构造函数中保留正则元字符的反斜杠语义,必须在字符串层使用两个反斜杠 \ 进行自身转义:第一个 \ 转义第二个 \,使得传给正则引擎的内存字符串为 \d。

常用元字符体系与实战匹配逻辑
正则表达式的强大匹配能力源自元字符(Metacharacters)。元字符是在正则语法中拥有特殊指示含义的保留符号。按照功能范畴,JavaScript 常用的元字符可系统归纳为四大体系:
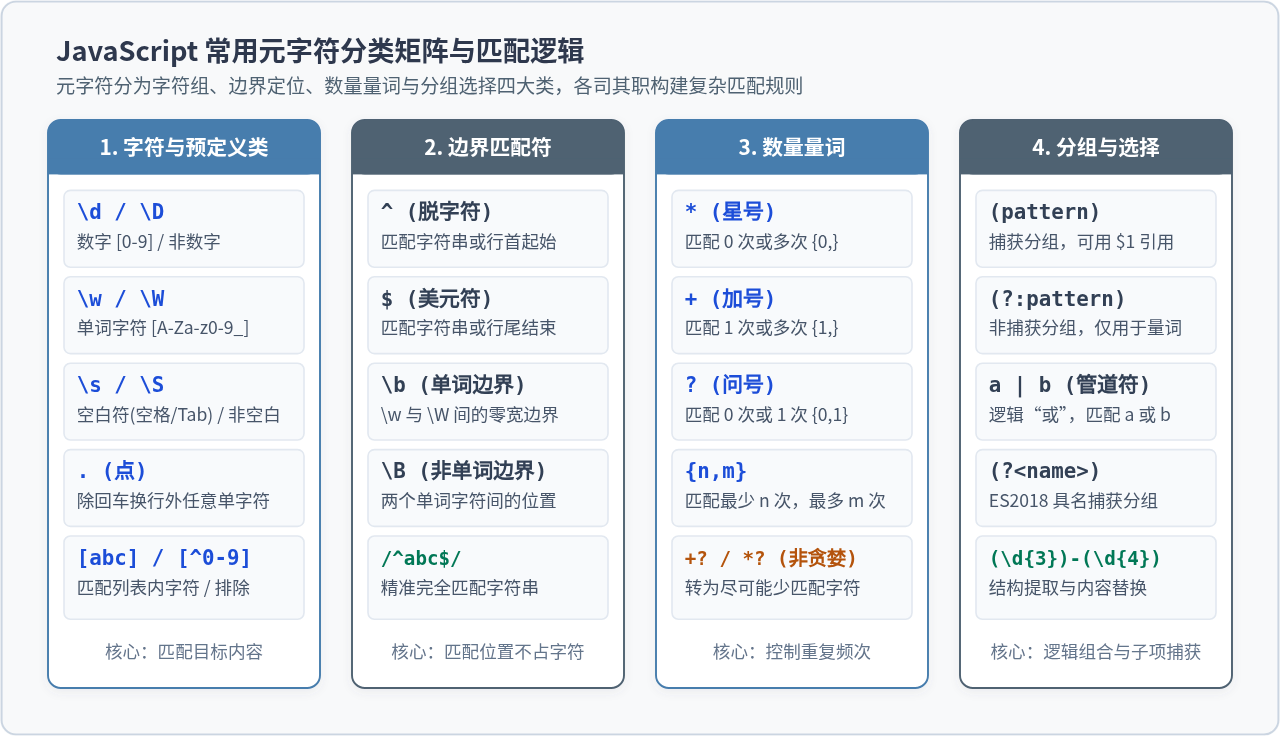
1. 预定义字符集与字符组
用于指定目标位置可以匹配哪些具体字符:
\d:匹配任意单个十进制阿拉伯数字,等价于[0-9]。\D:匹配任意单个非数字字符,等价于[^0-9]。\w:匹配任意单词字符,包括大写字母、小写字母、数字及下划线,等价于[A-Za-z0-9_]。\W:匹配任意非单词字符,等价于[^A-Za-z0-9_]。\s:匹配任意单个空白符,包含空格、制表符(\S:匹配任意单个非空白符。.(点号):匹配除行终止符(s(dotAll)修饰符,则包含换行符。[abc](自定义字符组):匹配方括号内列出的任意一个字符。例如[aeiou]匹配任意一个元音字母。[^abc](反向字符组):匹配除了方括号内字符以外的任意单个字符。
2. 位置边界定位符
边界符不消耗(占用)任何字符文本,它们匹配的是字符之间的“零宽位置”:
^:匹配输入字符串的开头。在多行模式(m修饰符)下,还匹配每一行的行首。$:匹配输入字符串的结尾。在多行模式下,还匹配每一行的行尾。:匹配单词边界。即单词字符(\w)与非单词字符(\W或行首/行尾)之间的缝隙。例如/cat/只能精确匹配单词 "cat",而不会误匹配 "category" 或 "bobcat"。\B:匹配非单词边界,即前后同为单词字符或同为非单词字符的位置。
边界符的重要性:全文本校验 vs 部分包含
如果不加
^ 和 $,例如使用 /\d{6}/ 验证 6 位纯数字邮编,字符串 "abc123456xyz" 也会被判断为 true,因为其中“包含”连续 6 位数字。只有写成 /^\d{6}$/ 才能确保从头到尾纯粹由 6 位数字构成。
3. 数量量词与贪婪/非贪婪模式
量词用来指定其前面紧邻的字符或子表达式允许重复出现的次数:
*:匹配前面的模式 0 次或多次,等价于{0,}。+:匹配前面的模式 1 次或多次,等价于{1,}。?:匹配前面的模式 0 次或 1 次(即该项可选),等价于{0,1}。{n}:精确匹配前面的模式 n 次。{n,}:至少匹配前面的模式 n 次。{n,m}:匹配前面的模式最少 n 次,最多 m 次。
贪婪与非贪婪:JavaScript 正则量词默认是“贪婪”的,即尽可能多地吞噬符合条件的字符。如果在一个量词后面紧跟一个 ?(例如 *?、+?、{n,m}?),则会将其切换为“非贪婪(惰性)模式”,仅匹配满足条件的最小可能子串。
const html = '<div>Hello</div><div>World</div>';

// 贪婪匹配:匹配从第一个 <div 开始直到最后一个 </div>
console.log(html.match(/<div>.*<\/div>/)[0]);
// 输出: "<div>Hello</div><div>World</div>"

// 惰性匹配(加 ?):匹配最近闭合的单个标签
console.log(html.match(/<div>.*?<\/div>/)[0]);
// 输出: "<div>Hello</div>"
4. 分组与分支选择
圆括号 () 用于将多个字符包裹成一个独立的逻辑单元,同时具备捕获功能;管道符 | 则用于表达“逻辑或”。
(abc):普通捕获分组。不仅将abc作为一个整体供量词修饰(如(ab)+),还会记住匹配到的内容,后续可在replace中使用$1引用。(?:abc):非捕获分组。仅用于逻辑组合或量词约束,不保存匹配结果,节省内存并提升匹配效率。a|b:分支选择符。匹配a或者b。注意|的优先级较低,通常需要用括号明确范围,例如/(red|blue|green)/。
动态构建 RegExp 的实战安全规范
在实际业务开发中,最常使用 new RegExp() 的场景是用户搜索高亮或根据配置项过滤列表。然而,如果直接将用户输入的原始字符串塞入 new RegExp(),会导致严重隐患:一旦用户输入了 (、[、*、?、+ 等元字符,正则引擎会因括号未闭合或量词缺失目标而直接抛出 SyntaxError: Invalid regular expression 异常,导致前端界面崩溃。
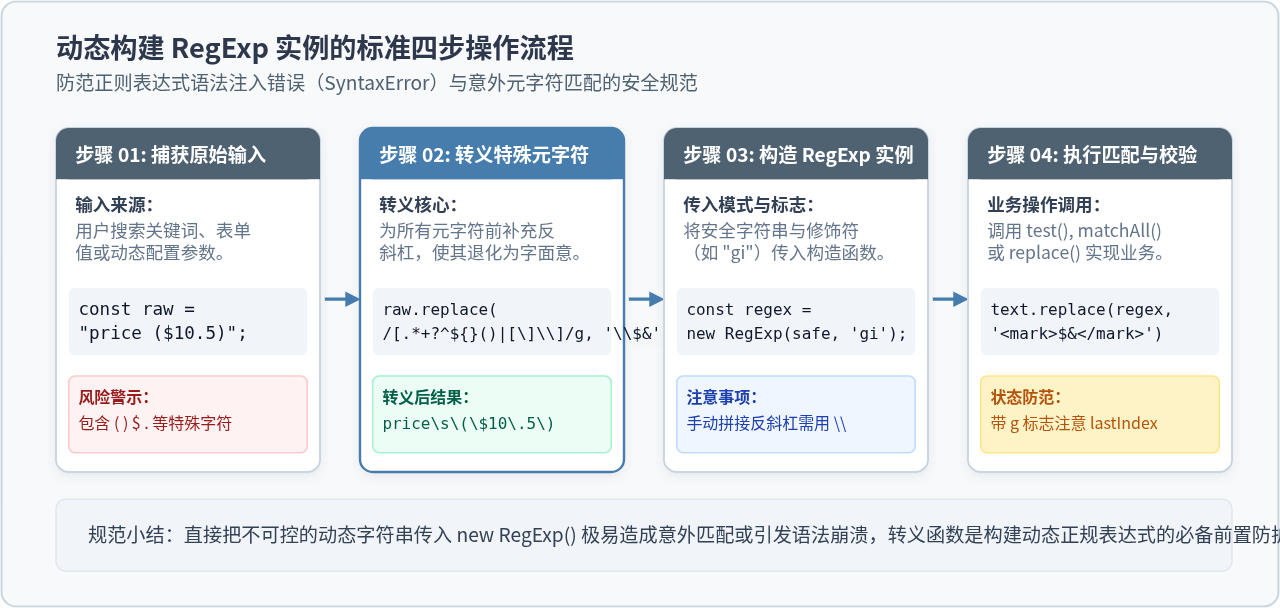
四步标准构建代码实现
为了保证运行安全,必须在传入构造函数之前,对用户字符串中的所有保留元字符进行转义。以下是生产环境标准的实现方案:
/**
 * 步骤 2 核心工具:转义用户输入中的所有正则表达式特殊字符
 * @param {string} text - 原始字符串
 * @returns {string} 转义后的安全字符串
 */
function escapeRegExp(text) {
  // 匹配所有正则特殊元字符,并在匹配项前追加反斜杠
  return text.replace(/[.*+?^${}()|[\]\\]/g, '\\$&');
}

/**
 * 完整示例:安全实现关键字搜索并高亮文本
 */
function highlightKeywords(content, userKeyword) {
  // 步骤 1:捕获并检查原始输入
  if (!userKeyword || typeof userKeyword !== 'string') {
    return content;
  }

  // 步骤 2:对原始输入进行特殊元字符安全转义
  const safeKeyword = escapeRegExp(userKeyword.trim());

  // 步骤 3:使用构造函数安全实例化,配置全局与忽略大小写修饰符
  const searchRegex = new RegExp(safeKeyword, 'gi');

  // 步骤 4:执行业务替换操作
  return content.replace(searchRegex, match => `<mark>${match}</mark>`);
}

// 验证测试:即使输入包含括号、美元符号与加号,程序依然稳健运行
const rawText = "产品价格是 $10.50,升级套餐包是 $10.50+!";
const result = highlightKeywords(rawText, "$10.50+");
console.log(result);
// 输出: "产品价格是 $10.50,升级套餐包是 <mark>$10.50+</mark>!"
关键避坑指南与选型决策
在掌握基础语法后,还需要防范两个最容易在生产环境中引发线上 bug 的暗坑:
高频陷阱:全局标志
/g 导致的 lastIndex 有状态 bug
当正则表达式带有 g(全局匹配)修饰符时,其实例内部会保留一个 lastIndex 属性,记录下一次匹配的起始索引位置。
const pattern = /foo/g;
console.log(pattern.test("foobar")); // true (此时 pattern.lastIndex 变为 3)
console.log(pattern.test("foobar")); // false! (从索引 3 开始找,找不到 foo,重置为 0)
console.log(pattern.test("foobar")); // true! (又从 0 开始找,找到了)
避坑规则:如果是单次表单校验或布尔值判断(test()),切勿添加 g 修饰符。如果必须复用带有 g 的正则实例,请务必在每次执行 test() 或 exec() 前手动执行 pattern.lastIndex = 0; 进行状态复位。
技术选型决策总结
面对具体的业务需求,开发者应当如何选择创建方式并组合元字符?下图提供了清晰的决策逻辑:
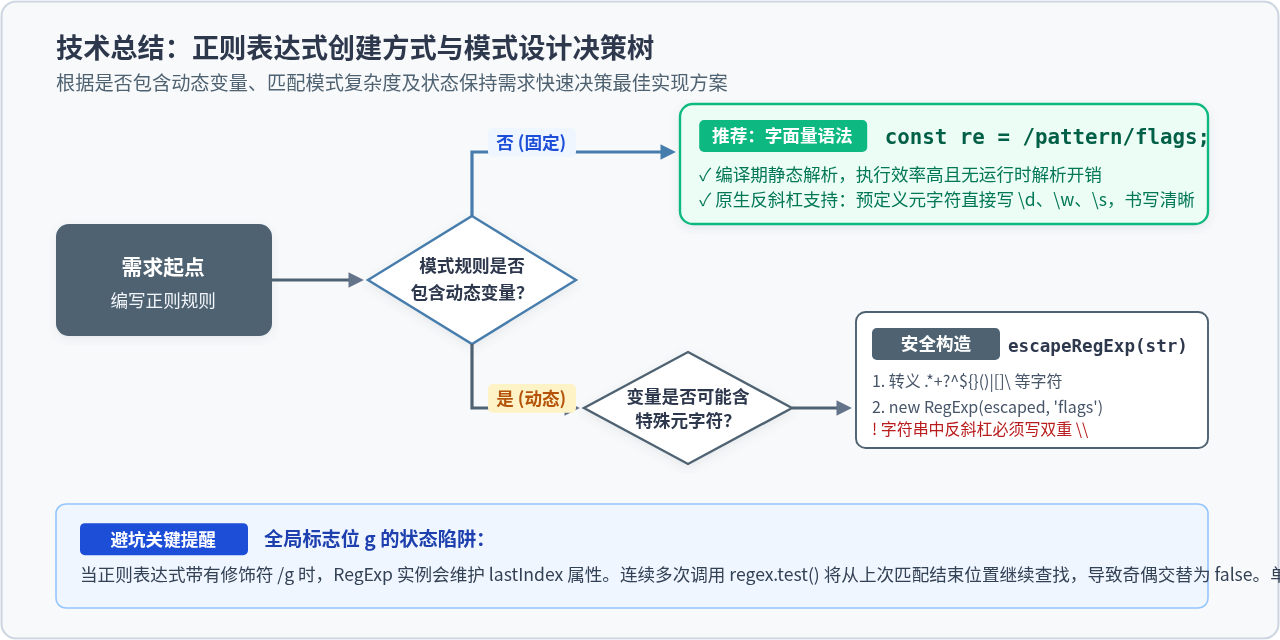
简而言之:凡是模式规则在编码期完全确定的,始终首选字面量语法,既能享受编译优化,又能免去多层反斜杠的阅读负担;凡是涉及动态参数或不可控外部输入的,采用 RegExp 构造函数 + escapeRegExp 安全转义的组合模式,并注意全局标志位的状态管理。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章