
在JavaScript环境中使用JSZip、fflate等工具解压Zip文件时,中文文件名乱码与报错(如Can't find end of central directory、Unsupported compression method等)是最常见的两类问题。本文系统解析Zip编码规范与底层原因,并提供完整的排查流程与可落地的代码修复方案。

当前位置:首页 > JavaScript 基础 > 正文
JS 解压出现乱码或报错怎么解决?
作者:纸飞机
时间:2026-11-05
浏览:746
文章目录

在前端浏览器或 Node.js 环境中通过 JavaScript 解压 Zip 压缩包时,“中文文件名/内容乱码”与“解压抛出异常报错”是开发者最常遭遇的两大痛点。出现乱码的核心原因在于 Windows 压缩包默认沿用 GBK/CP936 编码,而现代 JavaScript 解压库默认以 UTF-8 规则强行解析;而报错则多由网络二进制被误作字符串读取损坏、缺少结尾目录签名(EOCD)或遇到不支持的高级压缩算法引起。要彻底解决该问题,需从输入源二进制类型校验、Zip 规范标志位判定、自定义字符解码器注入以及流式内存保护四个环节协同处理。
一、排查路径:乱码与报错的分类诊断
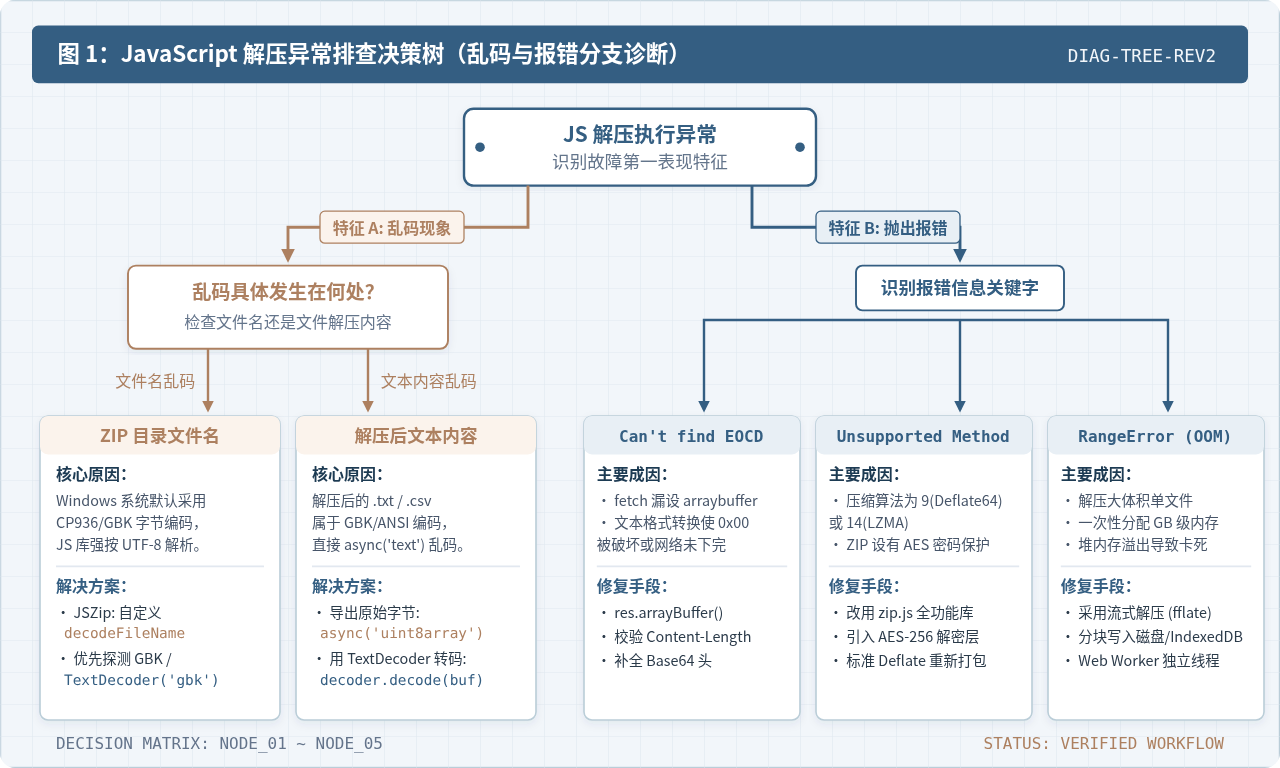
当解压逻辑未按预期工作时,盲目更换解压库往往无法根治问题。第一步应根据控制台报错信息或输出结果将故障归类为“乱码现象”或“报错中断”,并沿着确定的决策路径排查:
- 乱码表现:若解压正常完成,但目录列表中的中文名变成类似
��.txt、菱形问号或乱码拼音,属于文件名字符集未对齐;若解压出的.txt或.csv打开后内容错乱,则属于解压数据二次解码时字符集缺失。 - 报错表现:若代码执行直接抛出异常(例如
Can't find end of central directory、Unsupported compression method、RangeError: Array buffer allocation failed),说明文件物理二进制已损坏、参数类型不合法,或者压缩算法超出了解压引擎的能力边界。
排查要点
定位问题时,请优先打印输入源的 byteLength 与类型(是否为真正的 ArrayBuffer 或 Uint8Array)。许多所谓的“压缩包损坏报错”,实际上是在 fetch 或 axios 请求阶段误用了 text 响应格式导致多字节 0x00 丢失截断。
二、中文文件名乱码的根源与解码方案
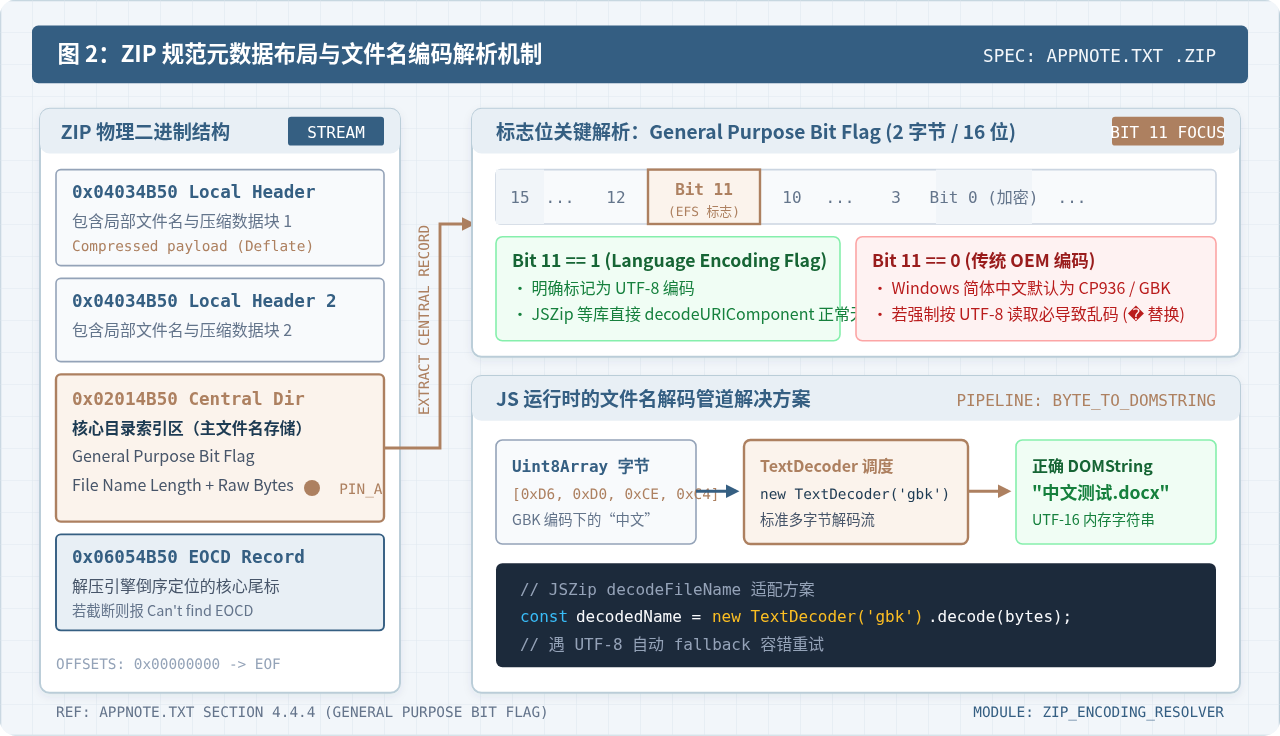
要解决乱码,首先需要理解 Zip 格式的文件名存储规范。在 PKWARE 发布的 Zip 标准中,每个文件条目的元数据包含一个 16 位的“通用位标志”(General Purpose Bit Flag)。其中第 11 位(Bit 11,Language Encoding Flag / EFS)起决定性作用:
- 当 Bit 11 为 1 时,标准强制规定文件名与注释必须使用 UTF-8 编码。
- 当 Bit 11 为 0 时,文件名遵循传统的本地 DOS/OEM 字符集。在简体中文版 Windows 系统下,7-Zip 或系统自带压缩工具默认会将其编码为 CP936(兼容 GBK/GB2312)。
如常用解压库 JSZip 默认一律按照 UTF-8 解码字节,当遭遇 Bit 11 为 0 的 GBK 压缩包时,两个字节的汉字编码被错误拆解为单字节或无法识别的 UTF-8 码位,从而全部被替换为 Unicode 替代字符 �。
1. JSZip 中解决中文文件名乱码
在较新版本的 JSZip(3.x 及以上)中,loadAsync 方法支持传入 decodeFileName 配置项。我们可以借助浏览器内置的 TextDecoder API,自动探测并执行 GBK 解码:
import JSZip from 'jszip';

// 注入支持 GBK 与 UTF-8 自动容错的文件名解码函数
async function loadZipWithEncodingFix(zipArrayBuffer) {
  const gbkDecoder = new TextDecoder('gbk');
  const utf8Decoder = new TextDecoder('utf-8', { fatal: true });

  const zip = new JSZip();
  const loadedZip = await zip.loadAsync(zipArrayBuffer, {
    decodeFileName: (bytes) => {
      try {
        // 优先尝试严格 UTF-8,若有非法码位则平滑降级到 GBK
        return utf8Decoder.decode(bytes);
      } catch (e) {
        return gbkDecoder.decode(bytes);
      }
    }
  });

  // 遍历输出确认解码后的文件名
  loadedZip.forEach((relativePath, fileEntry) => {
    console.log('已正确还原文件名:', relativePath);
  });

  return loadedZip;
}
注意事项:解压后文件文本内容乱码
解压出的若是文本文件(如 .txt、.csv),调用 fileEntry.async('text') 仍会默认按 UTF-8 读取。如果文件内部也是 GBK 保存的,应调用 fileEntry.async('uint8array') 获取原生字节,再使用 new TextDecoder('gbk').decode(buffer) 进行内容转码。
三、常见解压报错成因与具体修复方案
1. 报错:Can't find end of central directory (EOCD)
这是开发中最常遇到的报错。Zip 规范规定,解压引擎必须首先在文件末尾寻找到魔数为 0x06054B50 的 EOCD 记录,借此定位整个压缩包的核心目录区。如果在最后 65KB 范围内未能识别该标识,库就会抛出此异常。
根因排查与修复:
- 误用字符串加载:通过
fetch或axios下载二进制时,未设置响应类型,导致二进制字节流被当做 UTF-8 文本截断或转义(如
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章