
深入对比 JavaScript 中使用 startsWith、indexOf === 0 以及正则表达式判断字符串前缀的三种方案。从底层原理、语法差异、边界异常、动态转义及性能表现全方位解析,提供清晰的工程选型决策依据。

当前位置:首页 > JavaScript 基础 > 正文
JS 中 startsWith、indexOf 与正则判断字符串前缀的对比
作者:纸飞机
时间:2026-11-04
浏览:418
文章目录
JavaScript 字符串工程实践
适用标准:ECMAScript 5 / 6+
主题:前缀检索与核心 API 选型
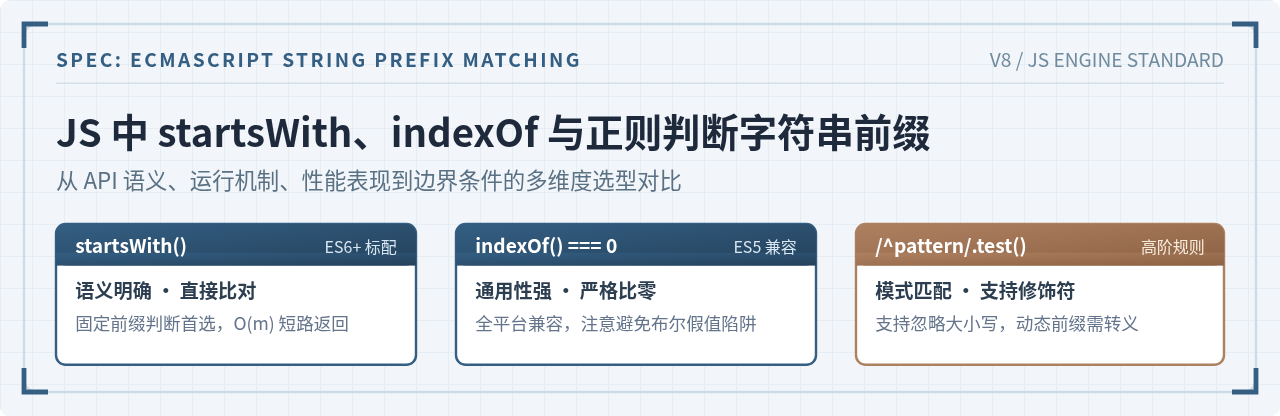
在 JavaScript 日常业务开发中,判断字符串是否以指定内容开头是高频基础需求,例如检验 URL 协议头、文件路径协议或命令前缀。现代标准优先推荐语义直观且具备短路特性的 String.prototype.startsWith();兼容老旧 ES5 环境时常借助 indexOf() === 0;若面对大小写忽略、通配规则等复杂模式,则需要依靠正则表达式 /^pattern/.test()。本文从语法细节、底层运行机制、边界条件与特殊输入、动态安全性以及综合性能五个维度展开全面对比,帮助开发者建立明确的选型依据。
一、三种判定前缀方案的核心语法与实现机制
虽然这三种方式都能得出“是否以前缀开头”的布尔结论,但底层设计思路与 API 契约存在本质区别。
1. String.prototype.startsWith()
startsWith() 由 ES2015 (ES6) 引入,专门用于前缀断言。其语法格式为 str.startsWith(searchString[, position])。它直接在底层根据 position(缺省为 0)定位索引,随后按 searchString 长度逐字符比对。若匹配则返回 true,一旦出现字符不匹配立即短路终止并返回 false,时间复杂度为严格的 O(m)(m 为前缀字符长度)。
const url = "https://example.com/api";

// 基础判断
console.log(url.startsWith("https")); // 输出: true
console.log(url.startsWith("http://")); // 输出: false

// 带有起始位置参数 (从索引 8 开始比对)
console.log(url.startsWith("example", 8)); // 输出: true
2. String.prototype.indexOf() === 0
indexOf() 是自 JavaScript 诞生之初就存在的全平台通用 API,语法为 str.indexOf(searchValue[, fromIndex])。它的设计定位是“全局子串定位检索器”,返回值是子串在源字符串中首次命中的起始下标(0 ~ n-1),未命中则返回 -1。因此,必须将返回值与数字 0 进行恒等比对(=== 0),才能准确表达“该子串恰好位于字符串开头”。
const path = "/usr/local/bin";

// 正确写法:严格比较是否位于首位 0
const isRoot = path.indexOf("/") === 0; // 输出: true

// 致命误用:切勿利用隐式布尔转换!
if (path.indexOf("/")) {
  // 当 path 确实以 "/" 开头时,返回值为 0,在条件表达式中 0 被评估为 false!
  // 这会导致业务逻辑发生严重颠倒!
}
3. 正则表达式 /^pattern/.test()
正则表达式利用字符 ^(脱字符)表达“从输入字符串的起始位置断言”。结合 RegExp.prototype.test(),底层会驱动正则有限状态机完成模式匹配。其优势在于支持量词、字符集、多选分支以及 i(忽略大小写)修饰符等高级匹配能力。
const filename = "ReadMe.MD";

// 使用 ^ 断言前缀,并附加 i 修饰符忽略大小写
const isReadme = /^readme/i.test(filename); // 输出: true

// 匹配多种可能协议前缀
const isSupportedProtocol = /^(https?|ftp):\/\/\/.test("https://domain.com"); // 输出: true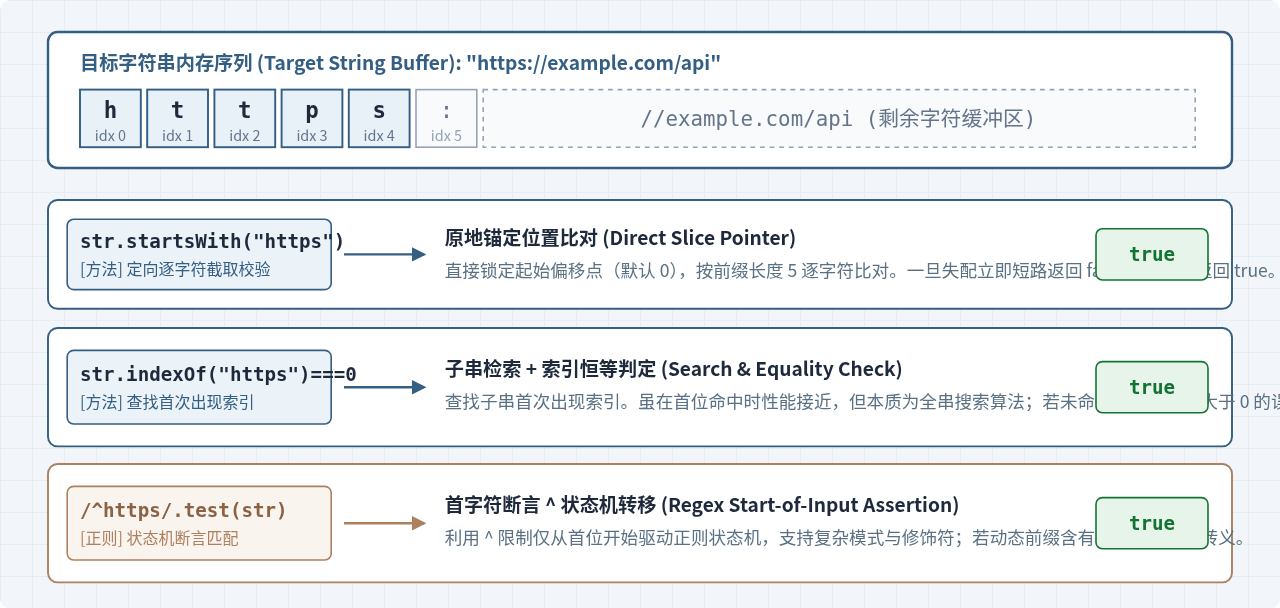
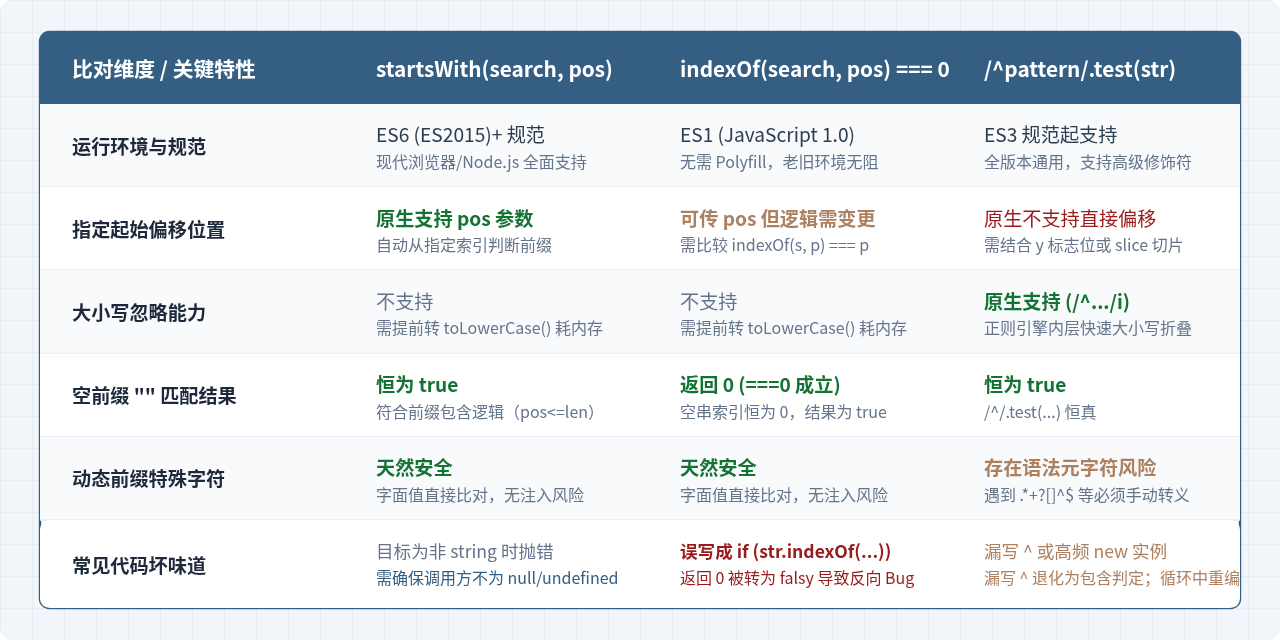
二、关键维度对比与边界行为剖析
在工程实践中,代码的健壮性高度取决于边界处理与特殊传参。以下深入分析各方案在具体开发场景下的行为差异。
| 比对维度 | startsWith(search, pos) | indexOf(search, pos) === 0 | /^pattern/.test(str) |
|---|---|---|---|
| 规范版本 | ECMAScript 2015 (ES6) | ECMAScript 1.0 (全平台) | ECMAScript 3.0 (全平台) |
| 代码语义直观度 | 极高(返回明确 boolean) | 中等(需转换为数值判 0) | 中高(依赖正则表达式认知) |
| 偏移位置检测 | 原生支持第二个参数 position |
需比对 indexOf(s, p) === p |
无原生参数,需 slice 或 y 标志位 |
| 忽略大小写 | 不支持(需先 toLowerCase()) |
不支持(需先 toLowerCase()) |
原生完美支持(修饰符 i) |
| 空字符串前缀 "" | 返回 true |
indexOf("") === 0 成立 |
/^/.test(...) 恒为 true |
| 动态前缀安全性 | 纯文本字面比对,天然安全 | 纯文本字面比对,天然安全 | 若包含正则元字符需手动转义 |
1. 空字符串与越界偏移
当传入的前缀是空字符串 "" 时,根据规范,任何字符串的起始处均存在空字符序列:
"hello".startsWith("")结果恒为true;若指定偏移"hello".startsWith("", 10),只要position <= length依然返回true。"hello".indexOf("")结果恒为0,与0严格相等故判定为true。/^/.test("hello")结果恒为true。
边界注意事项
如果业务逻辑不允许“空字符串算作有效前缀”,开发者应在入口层显式拦截空值检查(例如 if (!prefix) return false;),而不能直接依赖 API 的原生布尔返回值。
2. 非字符串参数的类型转换
当源对象或参数不是标准字符串时,三者的容错与类型转换规则如下:
- 若在
null或undefined上调用方法,str.startsWith()和str.indexOf()均会立即抛出TypeError: Cannot read properties of null/undefined。 - 若目标变量合法,但传入的前缀是数字或布尔值(如
123),startsWith和indexOf会将其强制转为字符串"123"进行比对。但注意:若传入正则对象给startsWith(如str.startsWith(/abc/)),规范会强制抛出TypeError。 RegExp.prototype.test(val)会将入参val自动调用String(val)转换后再匹配。
三、动态输入场景下的前缀检测流程与转义
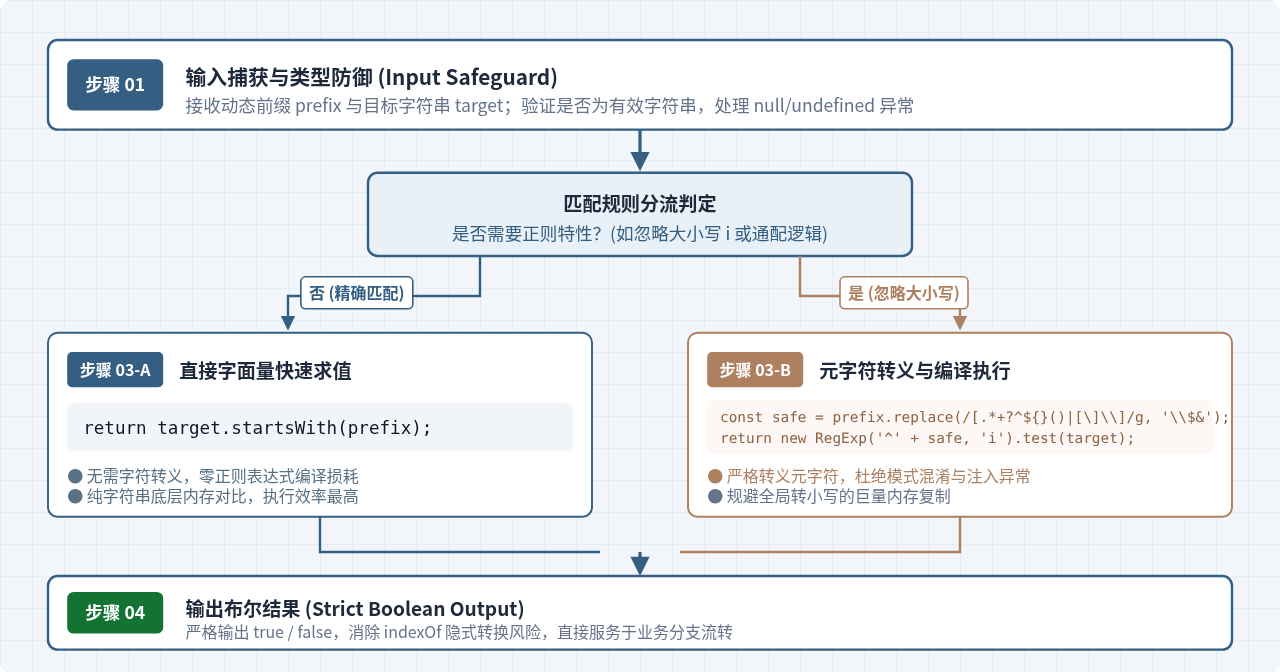
如果目标前缀不是硬编码的静态字符,而是来自外部配置、用户表单或输入框输入(如搜索框动态联想、通配协议校验),选择正则方案时存在显著的“元字符污染”风险。
在正则表达式中,字符 . * + ? ^ $ { } ( ) | [ ] \ 属于具有特殊语法的元字符。例如,若用户输入 "$100" 作为前缀,如果直接使用 new RegExp("^" + input) 构造,$ 会被当成行尾锚点,导致匹配逻辑完全失效或抛出语法异常。
动态正则前缀的安全工程实现
在确实需要正则表达式能力(如必须同时忽略大小写)且前缀为动态输入时,必须先进行转义:
/**
 * 安全的动态前缀检查工具函数(支持忽略大小写)
 * @param {string} target - 目标待检测字符串
 * @param {string} prefix - 用户输入的动态前缀
 * @param {boolean} ignoreCase - 是否忽略大小写
 * @returns {boolean}
 */
function safeStartsWith(target, prefix, ignoreCase = false) {
  if (typeof target !== "string" || typeof prefix !== "string") {
    return false;
  }
  if (prefix.length === 0) {
    return true;
  }

  // 1. 无需忽略大小写时,直接委托给原生的 startsWith(最优路径)
  if (!ignoreCase) {
    return target.startsWith(prefix);
  }

  // 2. 忽略大小写时,严密转义正则元字符,再行构建
  const escapedPrefix = prefix.replace(/[.*+?^${}()|[\]\\]/g, "\\$&");
  const regex = new RegExp("^" + escapedPrefix, "i");
  return regex.test(target);
}

// 验证示例
const content = "$100.00 is the final amount";
console.log(safeStartsWith(content, "$100")); // 输出: true
console.log(safeStartsWith(content, "$100", true)); // 输出: true
四、底层性能开销与运行效率深度对比
在绝大多数前端单次 UI 交互中,三种方法的耗时都在微秒级别以内,差异微乎其微。但在大规模文本过滤、海量日志流解析、高频数据网格排序等高负载场景下,底层机制的不同会带来可观的吞吐差异:
- 内存分配与对象创建:
startsWith()直接复用既有字符串内存指针;而new RegExp()每次在循环体内构建时都需要分配堆内存、初始化正则编译上下文与状态机,开销显著增加。因此如果使用正则,必须将编译好的静态正则表达式提出循环体外复用。 - 比对算法与短路优化:
startsWith()从第 0 位开始比对,字符失配立即退出。而indexOf()本质为全局搜索算法,若源字符串长达数兆且首位不匹配,虽然在首位立即命中的场景较快,但在失配场景下可能会检索整串;若仅需前缀判定,indexOf承担了多余的检索职责。 - 大小写转换损耗:若为了使用
startsWith或indexOf实现大小写无关比较,很多开发者会写出str.toLowerCase().startsWith(prefix.toLowerCase())。这种做法会在内存中完整复制两个新的字符串对象,对超长字符串而言是极大的垃圾回收(GC)负担。在此类场景下,/^pattern/i.test(str)依托内部原生大小写折叠算法,其综合内存效率反而超越频繁创建副本的toLowerCase()。
五、综合选型决策指南与代码实践
根据团队的技术规范与实际运行场景,推荐按以下树状路径进行快速选型:
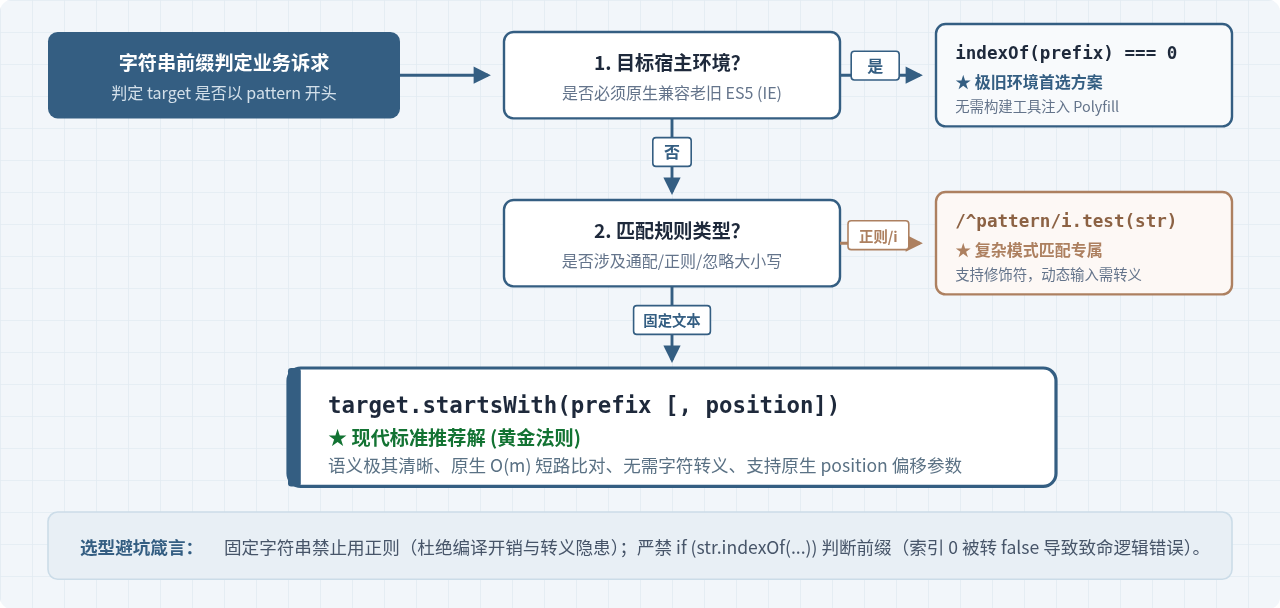
选型实践总结清单
- 首选方案(90% 业务场景):直接使用
str.startsWith(prefix)。代码语义极佳,一眼便知是在校验前缀;无需拼接语法,没有数字判零逻辑包裹,也不会受到正则特殊字符的破坏。 - 老旧浏览器/极简打包环境:若受限于打包体积或不支持 Polyfill 的旧版引擎,采用
str.indexOf(prefix) === 0。但必须时刻提醒团队成员绝对不可简写为if (str.indexOf(...))。 - 复杂模式前缀:当需求包含“前缀以 http 或 https 开头”、“忽略大小写”、“多字符分类通配”时,果断采用
/^pattern/正则方案。若前缀包含用户输入变量,切记预先完成元字符转义。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章