

在 JavaScript 场景下深入对比前端假分页与后端真分页的运行机制、优缺点与性能边界,提供包含代码示例、状态流转时序与五步选型决策流程的实用技术指南。
前端假分页还是后端真分页?JS场景下的选择策略
作者:极速慢跑
时间:2026-11-18
浏览:200
文章目录
在 JavaScript Web 业务开发中,选择前端假分页还是后端真分页,核心依据在于业务数据总量的增长上限与数据安全要求:当数据总量可预期且恒定在数百条以内(如角色权限列表、表单配置项、离线字典)时,前端假分页能提供零网络延迟的翻页与瞬时本地过滤体验;一旦数据规模可能突破千级、持续随时间增长,或涉及行级权限与敏感数据防护,则必须采用后端真分页,依靠数据库索引检索来保障首屏加载性能与客户端内存安全。
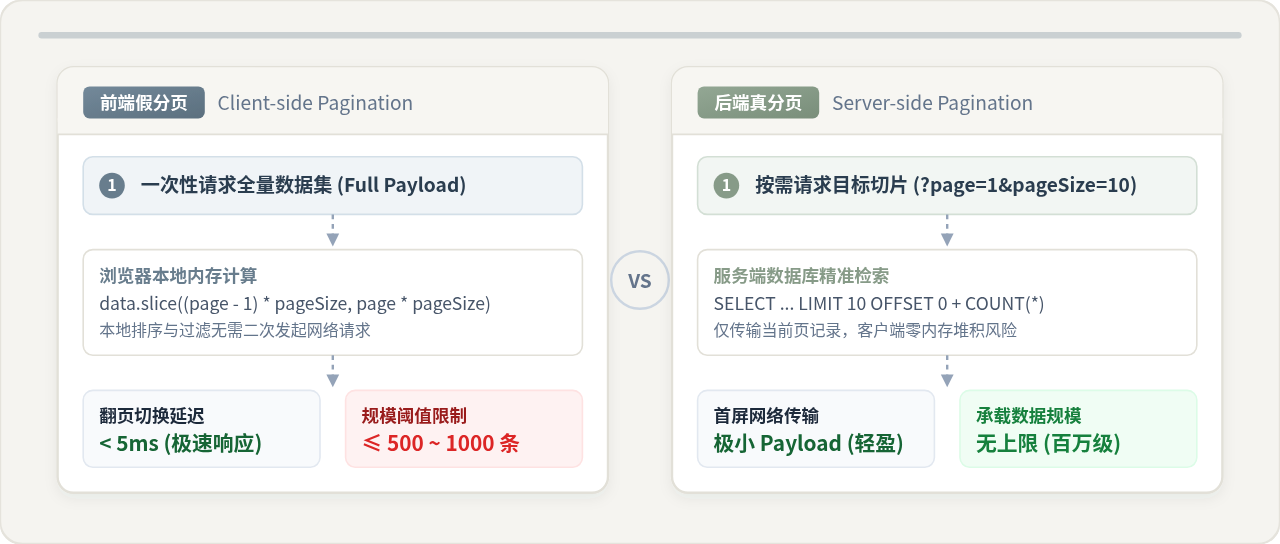 图 0:前端假分页与后端真分页核心架构与机制全景速览
一、两种分页模式的运作机制与根本差异
分页技术的本质,是为了解决海量数据无法在用户界面一次性高效呈现的问题。在前后端分离的架构中,根据数据切分执行的位置不同,形成了前端假分页与后端真分页两种典型模式。
前端假分页(Client-side Pagination),俗称“客户端分页”或“内存分页”。其核心工作流程为:前端在页面初次载入时,向服务端发起一次性数据请求,拉取整个业务数据集;前端将接收到的全量数组保存在内存中,当用户执行上一页、下一页、切换页码或调整每页条数时,前端直接利用 JavaScript 数组的 slice 方法从内存数组中截取目标区间的元素,仅将截取后的切片挂载到 DOM 树上进行渲染。
后端真分页(Server-side Pagination),即“服务端物理切片分页”。其核心流程为:前端只维护当前的查询状态(如当前页码 page 和每页展示数 pageSize),每次用户翻页或改变检索条件时,前端向后端 API 传递具体的分页参数;服务端接收到请求后,利用数据库的游标或分页语法(如 SQL 中的 LIMIT offset, size)只查询当前页所需的记录,并配合统计查询返回符合条件的总记录数 total;前端接收到切片数据后替换当前视图中的渲染列表。
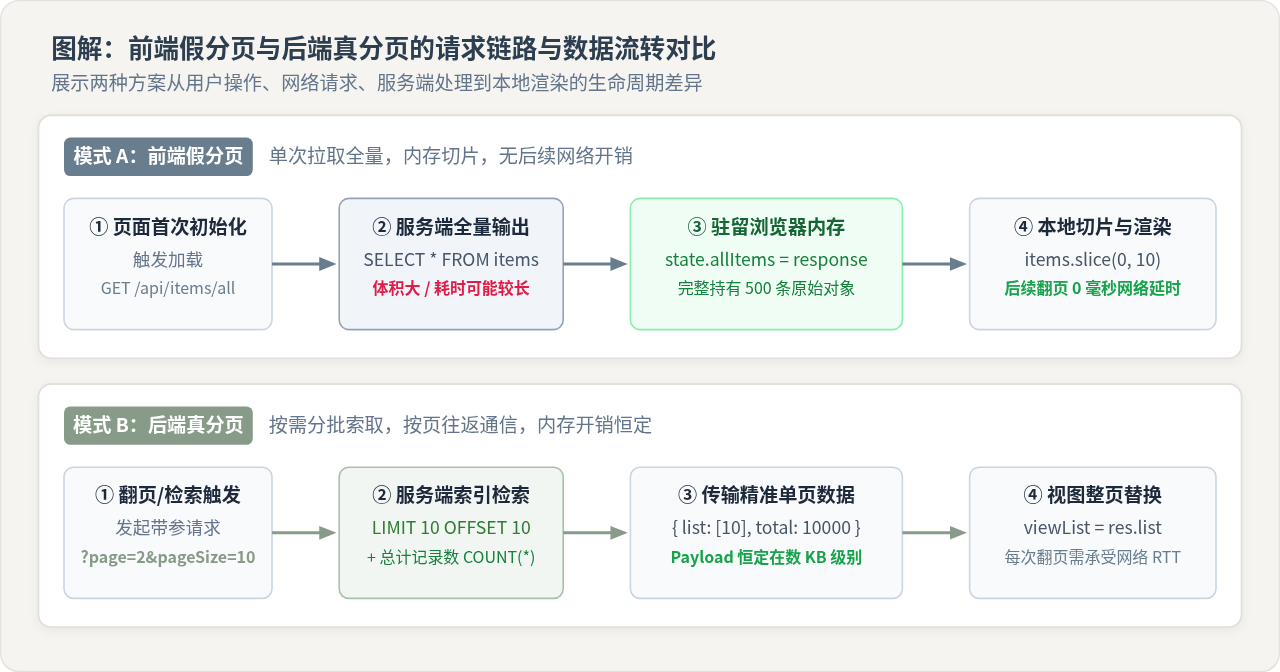 图 1:前端假分页与后端真分页在网络传输与渲染链路上的流转对比
二、前端假分页:实现范式、优势与性能边界
前端假分页将所有数据运算压力放在了用户的本地浏览器或移动端 WebView 中。为了让分页逻辑稳定可靠,必须建立清晰的状态流转模型,尤其是正确处理搜索、排序与切片之间的计算顺序。
1. 原生 JavaScript 假分页器标准实现
在编写前端假分页逻辑时,最容易出现逻辑错误的地方是计算顺序。正确的计算管线必须严格遵循“原始数组 → 条件过滤 → 多维排序 → 计算总页数 → 边界纠偏 → 数组切片”的顺序。如果在切片后再执行过滤或排序,会导致用户的搜索范围局限在当前页,丢失其他页中的匹配数据。
/**
* 客户端纯前端分页器 (ClientPaginator)
* 封装数据源、检索过滤、排序与局部切片
*/
class ClientPaginator {
constructor(data = [], pageSize = 10) {
this.rawList = Array.isArray(data) ? [...data] : [];
this.pageSize = Math.max(1, pageSize);
this.currentPage = 1;
this.filterPredicate = null;
this.sortComparator = null;
}
// 设置过滤谓词,过滤条件变动时自动重置为第 1 页
setFilter(predicate) {
this.filterPredicate = typeof predicate === 'function' ? predicate : null;
this.currentPage = 1;
}
// 设置排序规则,排序变动同样重置页码
setSorter(comparator) {
this.sortComparator = typeof comparator === 'function' ? comparator : null;
this.currentPage = 1;
}
// 设置目标页码,内置边界保护
setPage(page) {
const totalPages = this.getTotalPages();
this.currentPage = Math.max(1, Math.min(page, Math.max(1, totalPages)));
}
// 获取经过过滤和排序的中间数据集
getProcessedList() {
let result = this.rawList;
if (this.filterPredicate) {
result = result.filter(this.filterPredicate);
}
if (this.sortComparator) {
// 使用 slice 创建副本避免就地修改原始数组
result = result.slice().sort(this.sortComparator);
}
return result;
}
// 获取总页数
getTotalPages() {
const count = this.getProcessedList().length;
return Math.ceil(count / this.pageSize) || 1;
}
// 输出当前页视图切片与分页元数据
getPageData() {
const processed = this.getProcessedList();
const totalCount = processed.length;
const totalPages = Math.ceil(totalCount / this.pageSize) || 1;
// 页码越界自愈
if (this.currentPage > totalPages) {
this.currentPage = totalPages;
}
const startIndex = (this.currentPage - 1) * this.pageSize;
const endIndex = startIndex + this.pageSize;
const list = processed.slice(startIndex, endIndex);
return {
list,
currentPage: this.currentPage,
pageSize: this.pageSize,
totalCount,
totalPages,
hasNext: this.currentPage < totalPages,
hasPrev: this.currentPage > 1
};
}
}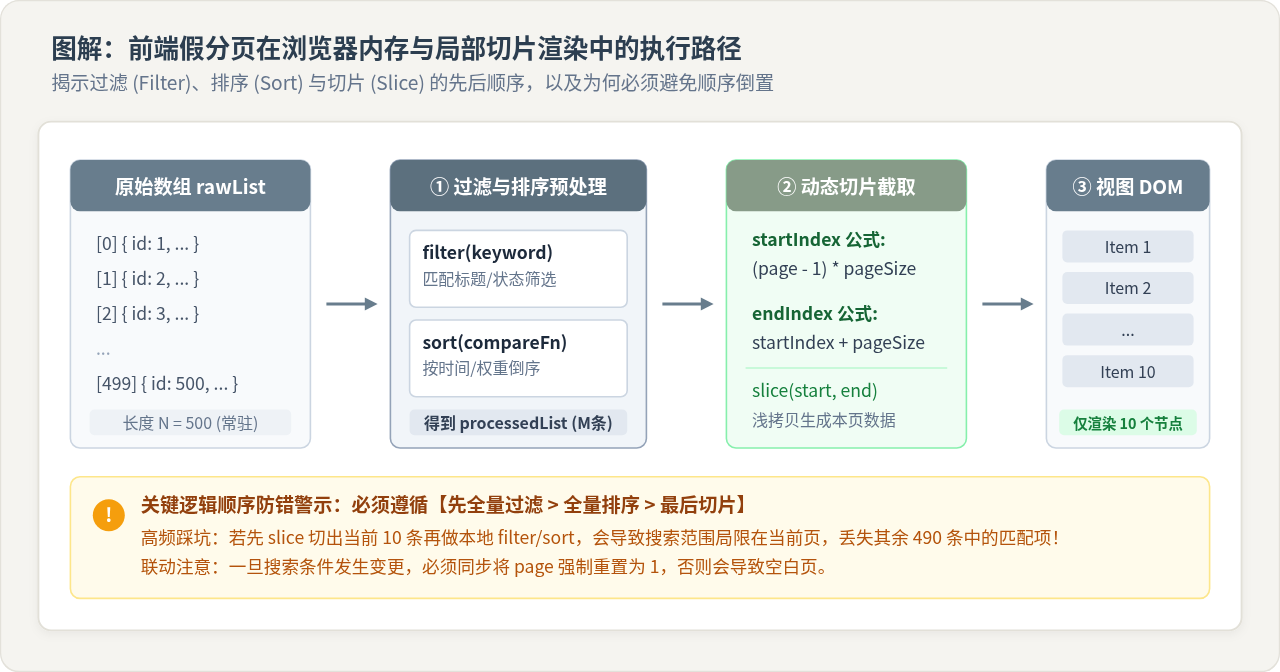 图 2:前端假分页在浏览器内存与局部切片渲染中的执行路径
2. 前端假分页的核心收益
- 翻页与交互零网络延迟:由于所有数据已经在内存中就绪,点击切换页码只需要经过一次微秒级的数组切片运算和 DOM 重新映射,交互响应时间通常在 5 毫秒以下,体验极其丝滑。
- 本地多字段组合即时搜索:用户在输入框中输入关键字时,前端可在
input事件中进行就地正则或字符串匹配,无需频繁向后端发送 HTTP 查询,彻底避免搜索防抖等待与网络开销。 - 减轻服务端并发读压力:在只读类配置表、产品规格字典等低频变动页面中,上千名用户频繁翻页查看,后端仅需支撑首次请求的开销,降低数据库查询并发度。
3. 前端假分页的致命瓶颈与适用红线
- 首屏 Payload 膨胀导致白屏:一次性传输大量数据直接增加网络传输时间与 JSON 反序列化解析耗时。如果数据包含 1000 条以上富文本或复杂嵌套对象,网络体积可能达到数兆字节,在弱网环境下会导致长时间白屏。
- 客户端内存泄漏风险:单页应用(SPA)中,若长生命周期的状态管理模块缓存了大量全量数据,并在路由切换时未及时销毁,容易导致浏览器内存占用持续攀升,低配移动设备甚至直接出现页面崩溃。
- 数据敏感性泄露与越权:假分页要求服务端把所有数据都下发到前端。即便前端在界面上通过权限过滤隐藏了部分字段或未授权行,用户只需打开浏览器 DevTools 开发者工具查看 Network 响应或内存变量,就能获取未脱敏的全量数据。
三、后端真分页:协议设计、实现模式与交互处理
当业务数据规模具备动态增长属性时,后端真分页是唯一的工业级标准解法。服务端承担了在海量数据中精准抽取特定范围记录的职责,前端则退化为轻量级的数据展示容器。
1. 两种主流的后端真分页形态
- 基于偏移量分页(Offset-based):参数通常为
page(或offset)与pageSize(或limit)。其优势在于天然支持直接跳转到任意指定页码,适用于 PC 端管理系统。但当偏移量极大(如第 1000 页,OFFSET 100000)时,数据库底层需要扫描前 100000 条记录再丢弃,查询性能会急剧衰减。 - 基于游标/标尺分页(Cursor-based / Keyset):客户端传递上一页最后一条记录的唯一标识符(如
last_id或timestamp)。数据库通过WHERE id < last_id ORDER BY id DESC LIMIT 10直接利用主键索引定位。该模式查询效率恒定,且在高频并发插入时不会发生数据重复或漏读,是移动端瀑布流与社交信息流的首选,但缺点是无法直接跳跃到任意第 N 页。
2. 前端与真分页接口对接时的竞态防范与状态封装
在开发真分页前端组件时,最常见的两个缺陷是:快速点击翻页导致网络响应后发先至(Race Condition 竞态错乱),以及搜索条件修改后未重置页码导致的“空页”假死现象。以下展示了利用原生 AbortController 消除网络竞态的完整异步请求函数:
/**
* 健壮的后端真分页请求执行器
* 支持动态取消过期请求、加载态控制与页码纠偏
*/
class ServerPaginationManager {
constructor(fetchApi, defaultPageSize = 10) {
this.fetchApi = fetchApi;
this.pageSize = defaultPageSize;
this.currentPage = 1;
this.filters = {};
this.currentAbortController = null;
this.isLoading = false;
}
// 更新检索条件:强制页码归零,重发请求
updateFilters(newFilters = {}) {
this.filters = { ...newFilters };
this.currentPage = 1;
return this.loadPage(this.currentPage);
}
// 切换页码请求
async loadPage(targetPage = 1) {
// 1. 若上一个未完成的网络请求还在进行,主动熔断,避免后发先至覆盖最新视图
if (this.currentAbortController) {
this.currentAbortController.abort();
}
this.currentAbortController = new AbortController();
this.isLoading = true;
try {
const queryParams = {
page: targetPage,
pageSize: this.pageSize,
...this.filters
};
const response = await this.fetchApi(queryParams, this.currentAbortController.signal);
this.currentPage = targetPage;
this.isLoading = false;
return {
success: true,
list: response.list || [],
total: response.total || 0,
page: this.currentPage,
pageSize: this.pageSize,
totalPages: Math.ceil((response.total || 0) / this.pageSize)
};
} catch (error) {
// 如果是被主动取消的请求,静默忽略
if (error.name === 'AbortError') {
return { success: false, aborted: true };
}
this.isLoading = false;
console.error('分页数据获取失败:', error);
throw error;
}
}
}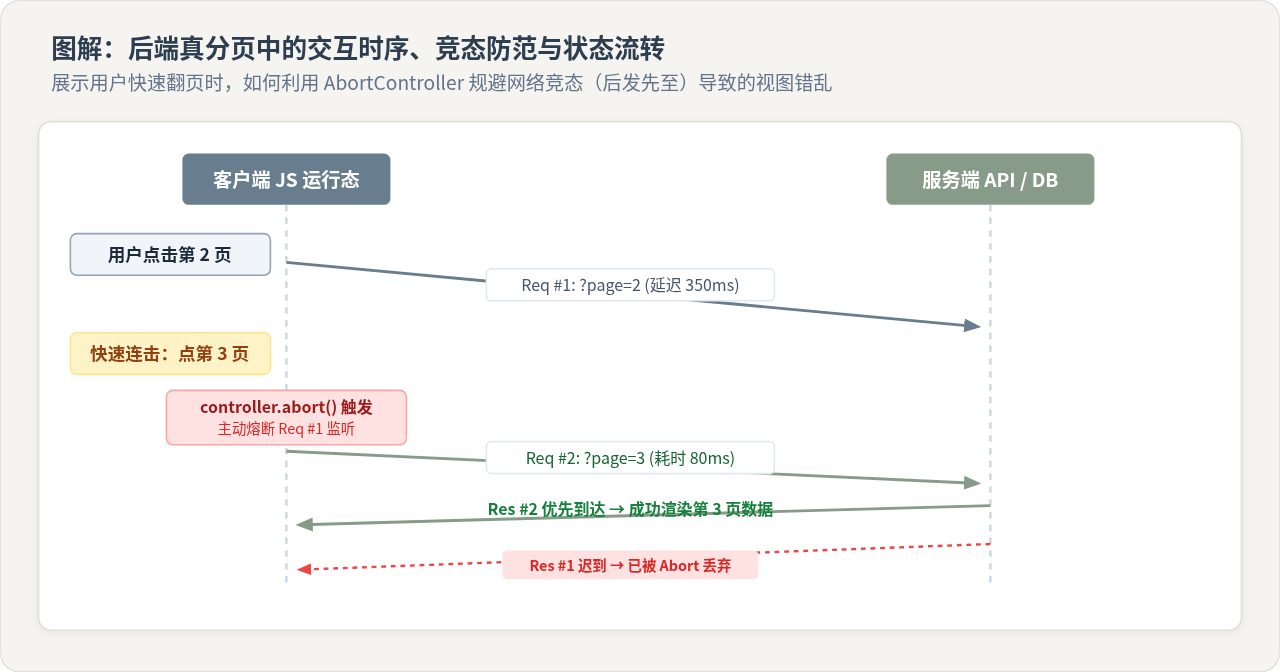 图 3:后端真分页在交互中的请求时序、竞态防范与状态流转
四、选型决策指南:JS 场景下的五步决策法
面对具体业务需求时,切忌凭经验盲目下结论。应当按照以下由强至弱的五个关键步骤逐级审查,得出确凿的技术选型结论。
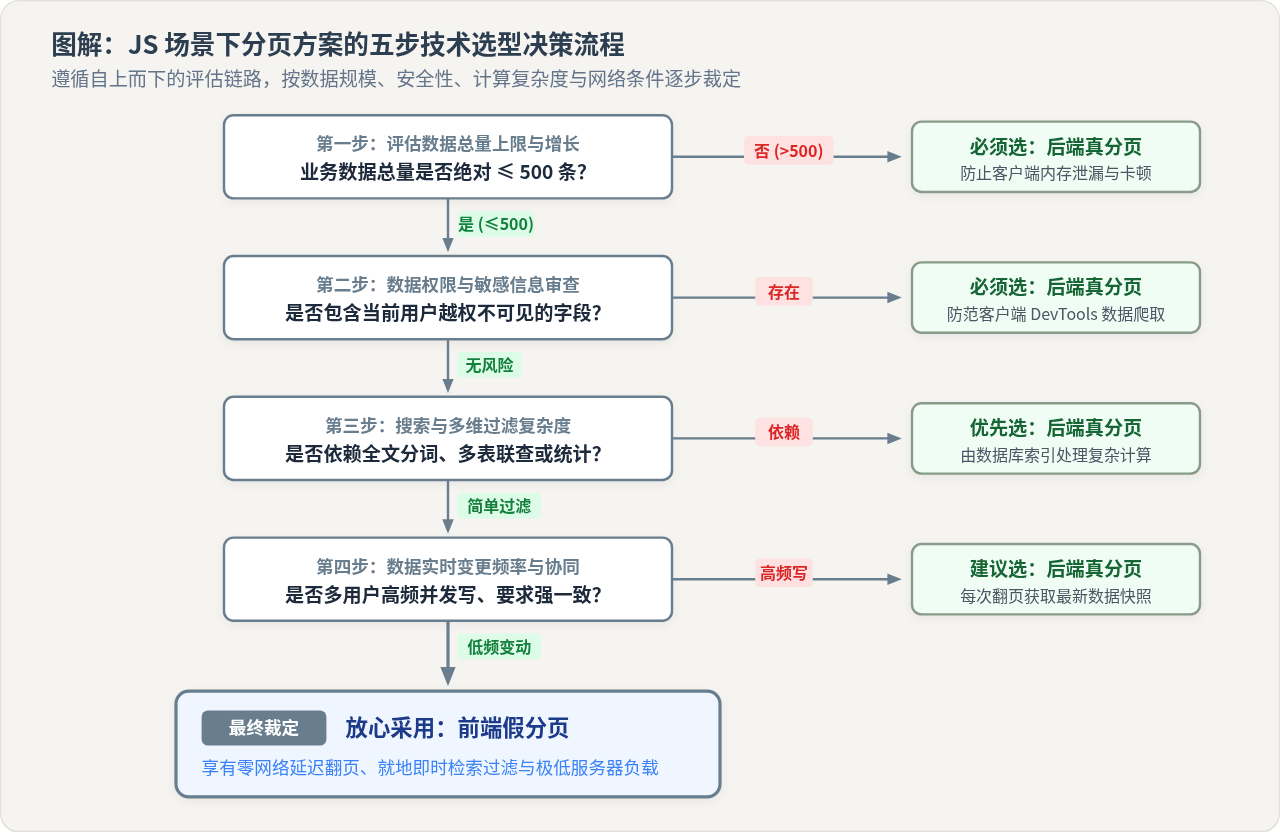 图 4:JS 场景下分页方案的五步技术选型决策流程图
第 1 步:核查数据规模的天花板与增长斜率
这是决定生死的第一道关卡。评估该数据集在未来 1~2 年内是否存在总量膨胀的可能:
- 如果业务实体本身是封闭的枚举或固定配置(如省市区行政区划、系统内置角色、菜单路由清单),总量明确稳定在 300 条以内,直接考虑前端假分页。
- 如果属于业务流水、操作审计日志、订单记录、用户动态等持续累积的数据实体,即使当前测试环境下只有 20 条,也必须从一开始就设计为后端真分页。
第 2 步:审查字段安全性与权限边界
评估下发的数据是否全部对当前登录用户合法可见:
- 前端假分页意味着整个原始数组都会暴漏在浏览器网络抓包和内存中。如果数据列表中包含未授权用户不得查看的金额字段、用户手机号、后台备注等敏感信息,必须使用后端真分页,由服务端只返回鉴权过滤后的当前页字段。
第 3 步:评估搜索与过滤的算力归属
分析用户在使用该界面时的查询行为习惯:
- 前端假分页擅长简单过滤:字符串
includes匹配、简单状态枚举过滤等,在几十条数据上耗时不到 1ms。 - 后端真分页擅长深度关联检索:若查询条件涉及跨表 JOIN 统计、ElasticSearch 全文分词、拼音模糊匹配、区间聚合等计算,前端根本无法在本地复刻这些索引结构,必须由服务端处理真分页。
第 4 步:权衡网络往返与多用户并发写入一致性
考察业务对“实时性”和“协作性”的敏感程度:
- 在多用户协作场景中,若其他用户在持续新增、删除或修改数据,前端假分页在一次加载后就成了“死数据”,用户即使翻到后几页也看不到最新的记录。后端真分页由于每次翻页都执行一次数据库实时快照查询,能够自然保证翻页时获取最新切片。
第 5 步:考虑终端设备性能与开发协作成本
如果是在资源受限的特定运行环境(如物联网扫码手持机、老旧嵌入式平板或弱网偏远地区终端),前端 JS 解析大 JSON 容易引发 UI 线程掉帧,应优先使用后端真分页分批索取。如果是内网局域网办公管理系统且数据量确定极少,采用假分页可以大幅削减后端接口的研发与维护成本。
五、高频踩坑指南与进阶混合架构
⚠️ 必查陷阱一:筛选条件变更时未重置页码
在前端假分页和真分页中,这是发生频率最高的用户体验 Bug。假设用户当前正处在第 5 页,此时在输入框搜索了一个非常狭窄的关键词,符合条件的记录总共只有 3 条(仅够排满 1 页)。如果开发者忘记在 onSearch 回调中将 page 重置为 1,代码依然会尝试截取第 5 页的记录,从而在界面上呈现一片空白,误导用户以为“没有搜索到任何结果”。
⚠️ 必查陷阱二:假分页中的对象深浅拷贝陷阱
JavaScript 数组的 slice() 方法执行的是浅拷贝(Shallow Copy)。如果页面允许用户就地行内编辑某个单元格并直接修改了列表项对象属性,该修改会直接作用于内存中底层的 rawList。如果用户随后点击“取消修改”,原始数据已经被污染。在需要行内编辑的假分页场景中,切片输出时建议利用结构化克隆(如 structuredClone)或解构赋值解耦状态。
进阶折中方案:混合分批缓冲分页(Chunked Buffer Pagination)
在部分既要求首屏加载可控、又希望翻页极为流畅的高要求场景下,可以采用混合分页架构:
后端每次以“大批次”(例如 bufferSize = 100)向前端返回数据,前端以此构建本地二级缓存;在前端界面上,以常规的 pageSize = 10 呈现给用户。当用户在第 1 页到第 10 页之间来回点击切换时,完全走前端假分页切片,享受 0 延迟体验;只有当用户翻到第 11 页超出缓存边界时,前端才触发下一批次网络请求。这种机制在保证弱网体验的同时,有效平衡了网络频率与内存压力。
六、全维度选型对照总结
为了便于在技术方案评审或日常开发中快速对齐共识,下表汇总了前端假分页与后端真分页在各核心工程维度的综合对比:
| 对比维度 | 前端假分页 (Client-side) | 后端真分页 (Server-side) |
|---|---|---|
| 数据量上限 | 严格限制在 500 ~ 1000 条以内 | 理论无上限,可承载百万乃至千万级数据 |
| 翻页响应延时 | < 5ms,纯本地内存切片,零卡顿 | 受网络 RTT 与 DB 查询制约(约 50~300ms) |
| 首屏 Payload 体积 | 较大,需一次性承载全量业务数据集 | 极小且恒定,每次只传输单页所需少量字节 |
| 服务器与数据库开销 | 极低,仅首次载入产生一次只读请求 | 持续产生,每次翻页均触发一次查询与计数 |
| 搜索与多维过滤 | 即输即显,无需防抖与二次网络交互 | 依赖后端索引引擎,前端需做防抖与竞态取消 |
| 数据隔离与安全性 | 较弱,全量数据暴露在客户端内存中 | 强,服务端可进行严格的行级与列级鉴权脱敏 |
| 多端数据实时一致性 | 较弱,容易产生陈旧快照(Stale Data) | 较强,每次翻页均获取当前时刻最新数据 |
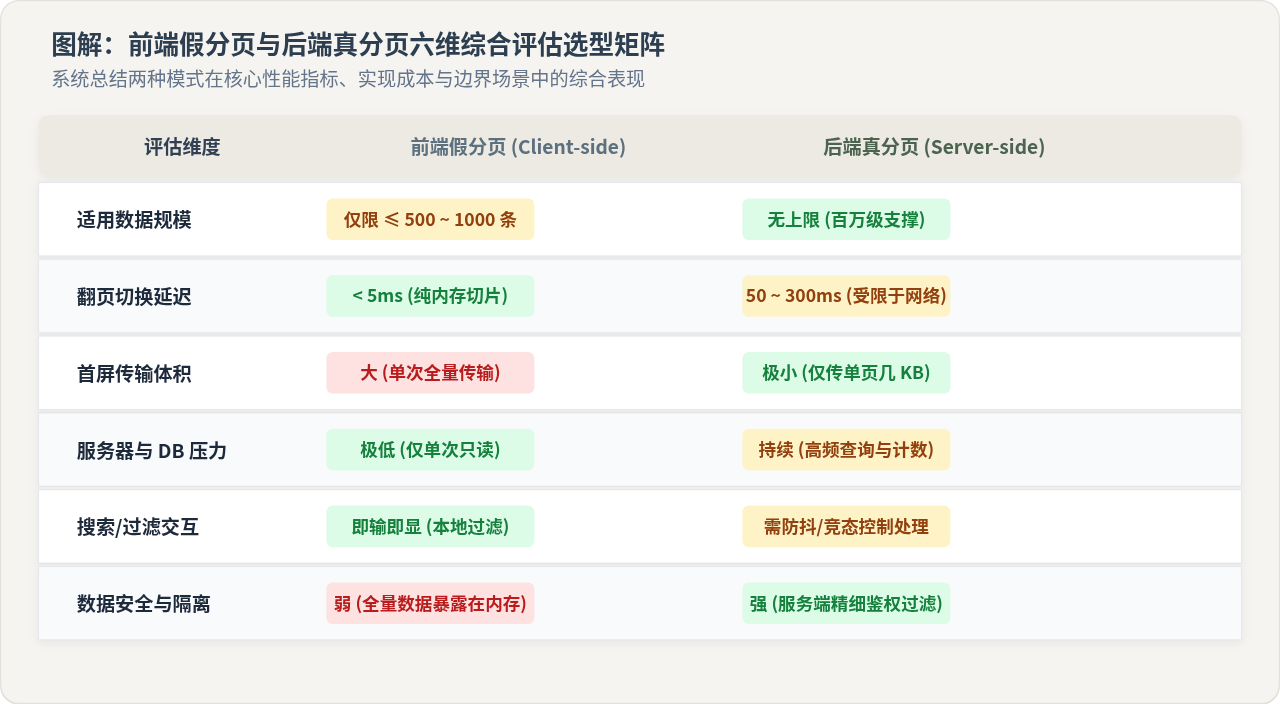 图 5:前端假分页与后端真分页六维综合评估选型矩阵
最终总结结论:前端假分页并非“不规范”的业余写法,而是一种以一次性网络开销与客户端少量内存为代价,换取极致流畅交互的特定优化手段。在明确知道数据量极小且无敏感字段的场景下,大胆使用前端假分页能显著提升用户体验并降低后端压力;但凡数据具备开放性增长可能,务必从第一天起就坚定选择后端真分页,守住系统性能与安全的生命线。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章