
深入讲解JavaScript中如何遍历并筛选符合特定条件的树形结构节点。通过自底向上的DFS后序遍历算法,详细剖析祖先路径保留、无效分支剪枝、不可变数据处理及生产环境常见边界问题。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS遍历树并筛选符合特定条件的子树节点
作者:拾光
时间:2026-11-18
浏览:521
文章目录
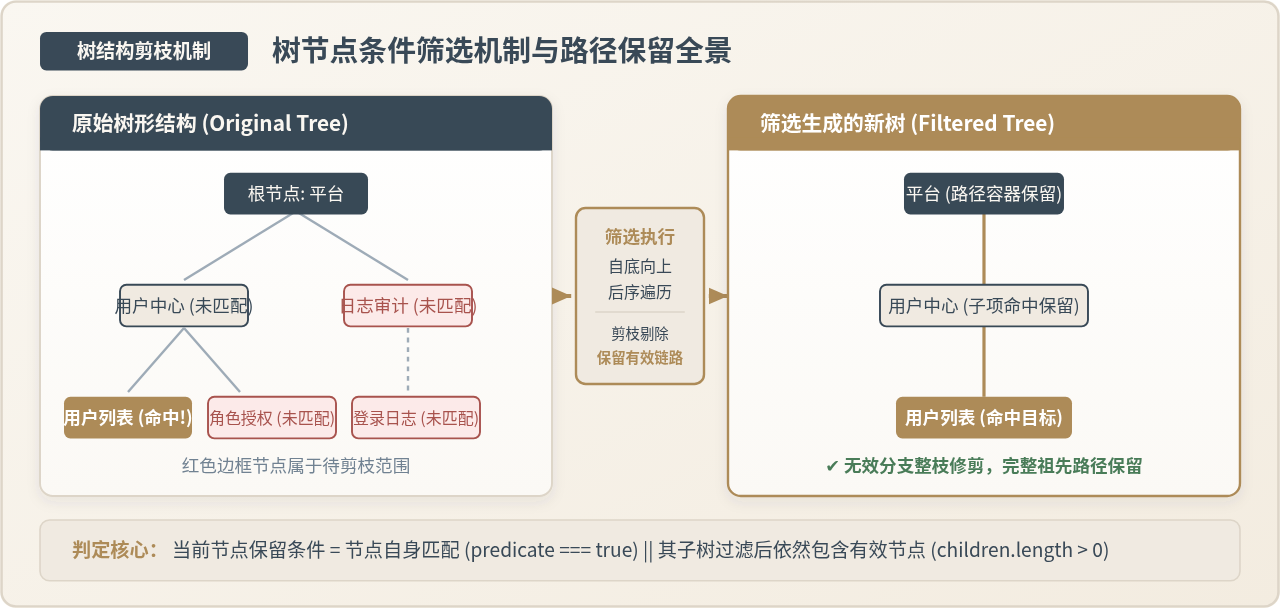
在 JavaScript 中筛选树形数据(如权限菜单、部门架构、分类层级)的核心目标在于维持合法的树形链路并剪除多余分支:只要深层子节点满足条件,其对应的所有祖先节点即使自身未匹配也必须作为“路径容器”保留;反之,若整棵子树均无符合条件的节点,则必须整体剔除。实现该功能最直接有效的方式是采用深度优先搜索(DFS)的后序遍历,自底向上递归处理子节点,通过判断“自身匹配”与“子集非空”来重构纯净的新树。
一、树结构筛选的核心诉求与难点
在日常业务开发中,我们经常遇到类似后台管理系统的菜单搜索、Element UI 或 Ant Design 中的树选择组件(TreeSelect)关键词高亮等场景。这类需求如果直接套用一维数组的 filter 方法,会打乱树形结构的上下级关系。
树形筛选之所以不能直接自顶向下删除,是因为它存在以下两个互相关联的约束条件:
- 祖先路径依赖(向上保留):如果第三层某个叶子节点命中了关键词,那么它的父节点(第二层)和根节点(第一层)即使完全不包含关键词,也必须保留在结果树中,否则该叶子节点将成为无源孤岛,无法在 UI 树形组件中正常展现。
- 无效分支剪除(向下清理):如果某个父节点下属的所有子孙节点均不满足条件,且该父节点自身也不满足条件,那么整棵子树都属于冗余数据,必须彻底剪除,不能在结果树中留下只有空外壳的无用节点。
常规的前序遍历在访问父节点时,由于尚未得知其深层子孙的匹配结果,无法直接裁定该父节点是否应该被保留。因此,最佳的解决路径是后序遍历(自底向上):先让子节点递归计算完成,父节点根据子节点的汇总结果再决定自身的存留。
二、核心算法设计与四步执行法
为确保函数具备良好的通用性和纯度,筛选算法应当设计为纯函数:接收原始树数组和谓词判断函数,返回一个全新构造的树结构,绝对不直接修改(Mutate)传入的原对象。
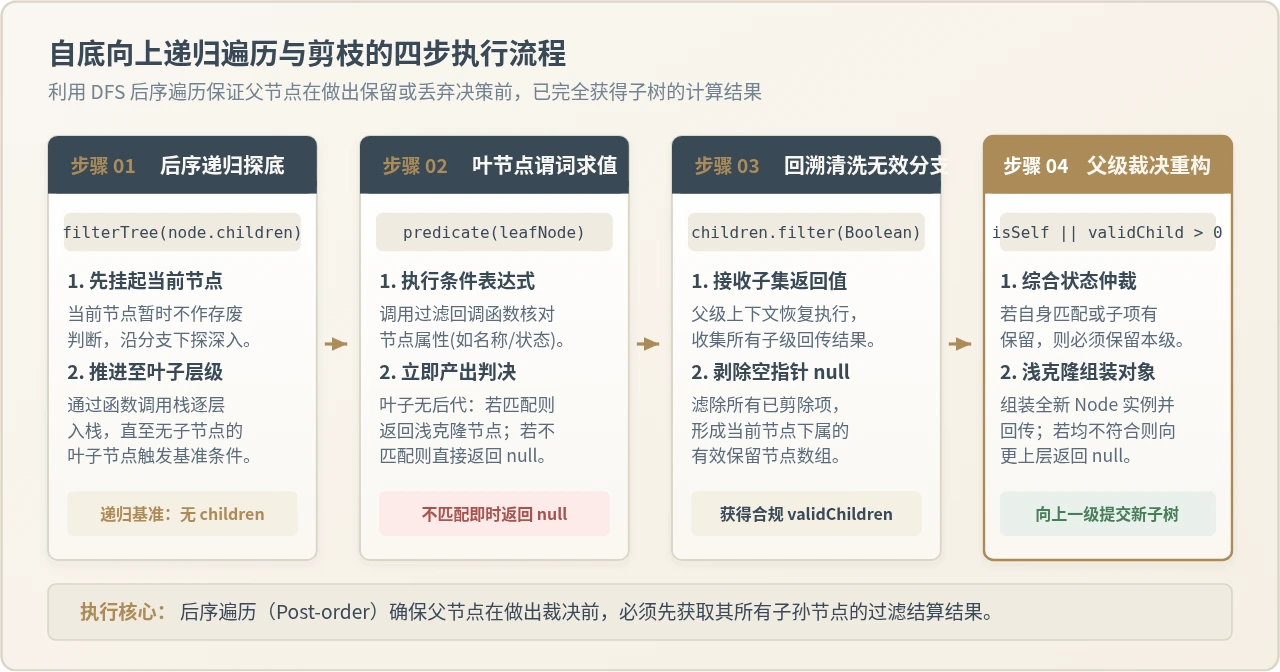
算法执行过程可以划分为清晰的四个阶段:
- 后序深度下探:遍历当前层级的每个节点,若节点具备子节点数组,暂不判断当前节点,而是先对
children递归调用自身,将执行权移交给更深层的子节点。 - 叶节点谓词求值:当下探到最底层的叶子节点时,执行传入的谓词判断条件
predicate(node)。若满足条件则返回克隆的新节点;若不满足则直接返回null。 - 回溯清洗无效分支:父级调用栈恢复执行,接收所有子节点返回的处理结果,并通过
.filter(Boolean)清洗掉所有返回null的无效分支,得到清洗后的有效子项集合。 - 父级决策与节点重构:父节点综合判定:若自身命中条件,或者清洗后的有效子项数量大于零,则通过浅克隆重构新节点,将过滤后的子节点挂载上去;若自身与子项均无匹配,则返回
null供上一层父级进一步剪除。
标准递归过滤代码实现
/**
 * 递归遍历并筛选树形结构(自底向上后序遍历)
 * @param {Array} tree 原始树数组
 * @param {Function} predicate 筛选条件函数,接收 node,返回布尔值
 * @param {string} [childKey='children'] 子节点属性键名
 * @returns {Array} 过滤后生成的新树数组
 */
function filterTree(tree, predicate, childKey = 'children') {
  if (!Array.isArray(tree) || tree.length === 0) {
    return [];
  }

  return tree
    .map(node => {
      // 1. 若存在子节点,先递归过滤子节点
      const hasChildren = Array.isArray(node[childKey]) && node[childKey].length > 0;
      const filteredChildren = hasChildren
        ? filterTree(node[childKey], predicate, childKey)
        : [];

      // 2. 检查当前节点自身是否满足条件
      const isSelfMatch = Boolean(predicate(node));

      // 3. 检查子树中是否存在保留项
      const hasMatchedChildren = filteredChildren.length > 0;

      // 4. 判定保留逻辑:自身命中 或 子树中存在有效匹配
      if (isSelfMatch || hasMatchedChildren) {
        // 创建新对象,避免污染原始节点引用
        const newNode = { ...node };

        if (hasMatchedChildren) {
          newNode[childKey] = filteredChildren;
        } else {
          // 若子节点均已被剪除,避免保留空数组引起 UI 组件异常展开
          delete newNode[childKey];
        }

        return newNode;
      }

      // 5. 自身未中且无有效子项,剪除当前节点
      return null;
    })
    .filter(Boolean);
}
测试数据与运行结果对比
我们准备一份包含三层嵌套结构的系统菜单数据,测试关键词为“列表”时的筛选效果:
// 模拟测试数据源
const menuTree = [
  {
    id: 1,
    name: '系统管理',
    children: [
      {
        id: 11,
        name: '用户管理',
        children: [
          { id: 111, name: '用户列表' },
          { id: 112, name: '角色分配' }
        ]
      },
      {
        id: 12,
        name: '系统监控',
        children: [
          { id: 121, name: '操作日志' },
          { id: 122, name: '在线用户' }
        ]
      }
    ]
  },
  {
    id: 2,
    name: '内容中心',
    children: [
      { id: 21, name: '文章发布' }
    ]
  }
];

// 执行筛选:找出所有包含“列表”字样的节点
const result = filterTree(menuTree, node => node.name.includes('列表'));
console.log(JSON.stringify(result, null, 2));
执行后的输出结果如下:
[
  {
    "id": 1,
    "name": "系统管理",
    "children": [
      {
        "id": 11,
        "name": "用户管理",
        "children": [
          {
            "id": 111,
            "name": "用户列表"
          }
        ]
      }
    ]
  }
]
从输出可以清楚看到:虽然根节点“系统管理”与二级节点“用户管理”的名字中都不包含“列表”,但为了保持完整的访问链路被成功保留;而未匹配的“角色分配”、“系统监控”分支以及“内容中心”根分支均被精准剪除。
三、业务中两种常见的保留策略对比
在实际项目需求中,“符合特定条件”在不同业务系统中有两种细分的交互诉求:
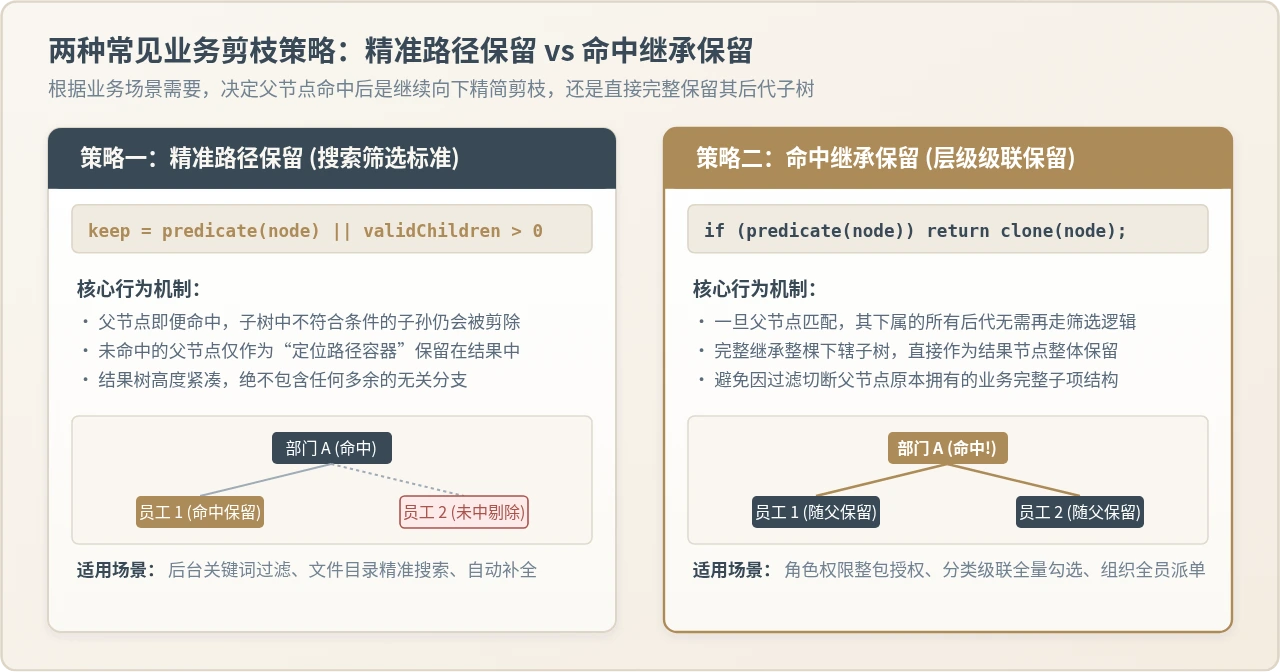
| 对比维度 | 策略一:精准路径保留(默认搜索模式) | 策略二:命中继承保留(全量子树模式) |
|---|---|---|
| 核心规则 | predicate(node) || children.length > 0 |
父级命中直接返回全量子树,不再深度剪枝 |
| 父节点命中时 | 继续下探过滤,剔除其子节点中未命中项 | 短路提前返回,其所有子孙节点原样全量保留 |
| 输出特征 | 层级紧凑,结果树中只含匹配项及纯链路节点 | 业务语义完整,便于对整个类别/部门进行批量操作 |
| 典型场景 | 树控件关键词高亮筛选、文件路径精确定位 | 权限管理模块整组勾选、部门组织全员级联查看 |
策略二(命中继承整棵子树)的实现方式
如果业务要求“只要父部门匹配,就展示该部门下的所有人;如果父部门不匹配,才按子部门继续检索”,我们只需在前置条件加入短路分支即可:
function filterTreeKeepDescendants(tree, predicate, childKey = 'children') {
  if (!Array.isArray(tree) || tree.length === 0) return [];

  return tree
    .map(node => {
      // 1. 若当前节点自身命中条件,直接保留该节点及其全部子孙
      if (predicate(node)) {
        return { ...node };
      }

      // 2. 自身未命中时,继续递归过滤子级
      const hasChildren = Array.isArray(node[childKey]) && node[childKey].length > 0;
      const filteredChildren = hasChildren
        ? filterTreeKeepDescendants(node[childKey], predicate, childKey)
        : [];

      // 3. 只有当子级中有保留项时,未命中的当前节点才作为父级容器保留
      if (filteredChildren.length > 0) {
        return {
          ...node,
          [childKey]: filteredChildren
        };
      }

      return null;
    })
    .filter(Boolean);
}
四、生产级工程边界与避坑指南
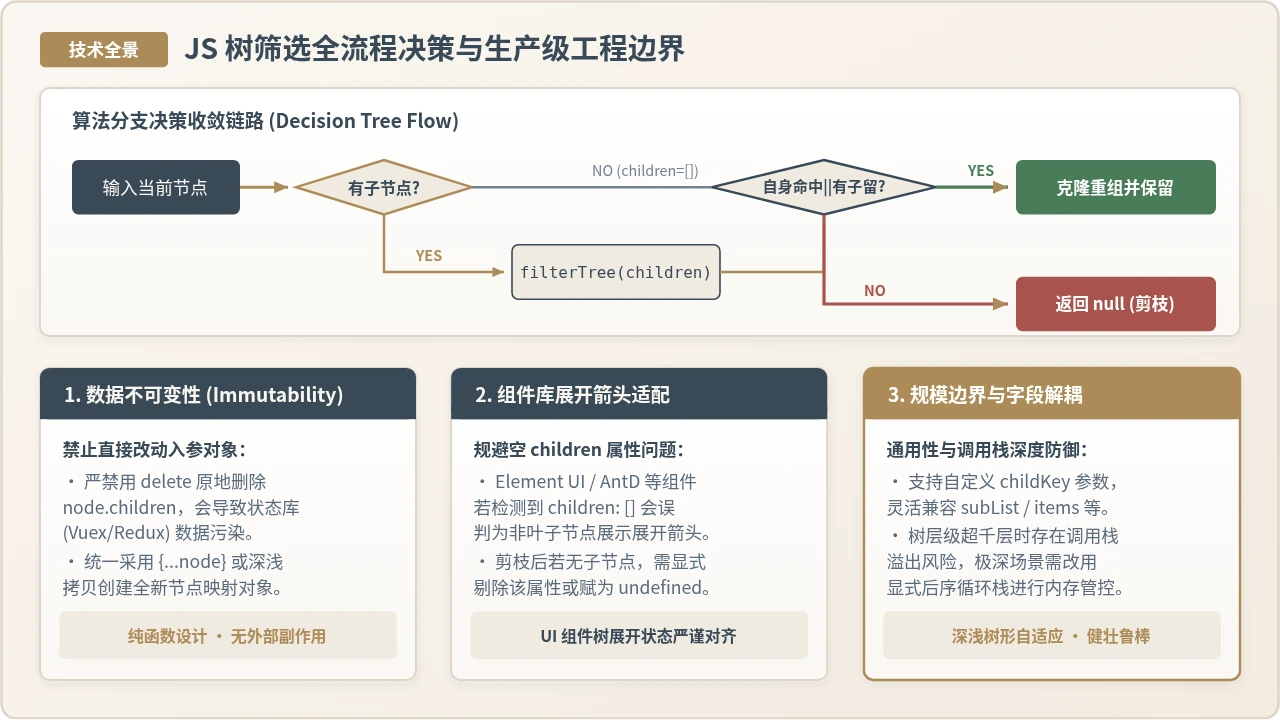
在将算法投入生产环境前,有几个极其容易引发隐藏 Bug 的工程细节需要专门处理。
1. 空 children 数组对 UI 组件渲染的影响
在许多主流前端 UI 组件库(例如 Element UI 的 el-tree 或 Ant Design 的 Tree)中,组件判断一个节点是否为叶子节点,默认规则往往是“是否存在 children 属性”。
避坑提醒:不要留下空数组 children: []
如果一个原本有子节点的父节点,其所有子节点在筛选后全部被剔除,而你在返回对象中依然保留了 children: [],UI 组件就会认为这是一个“未加载数据的非叶子节点”,从而在前面渲染出一个展开箭头,但点击后没有任何内容。因此,在子项为空时,应当使用 delete newNode.children 或赋为 undefined。
2. 对象不可变性(Immutability)与深浅拷贝
上面示例代码采用了对象展开运算符 { ...node },这是浅拷贝处理。它保证了我们增删 children 属性时不会影响原始数据。
但需要注意:如果筛选后的业务逻辑需要对节点内部的其他嵌套对象属性进行修改,浅拷贝会导致深层属性在原树和新树间共享引用。如果系统对不可变性有极高要求(如使用 Redux、Pinia 并开启状态冻结),建议在重构节点时采用 structuredClone(node) 进行安全深克隆。
3. 超深树结构的调用栈溢出(Stack Overflow)防范
JavaScript 引擎的调用栈深度通常在 10,000 层左右。对于前端常见的业务树(深度一般在 3 到 10 层),递归实现的性能和可读性都是最优的。
然而,如果你的数据来源于超大规模嵌套树(例如 AST 抽象语法树、超深文件系统索引),树深度可能达到数千层。此时递归会触发 Maximum call stack size exceeded。针对此类极端场景,可以改用显式栈模拟后序遍历的迭代解法,避免利用执行上下文调用栈。
五、全功能通用工具函数封装
综合考虑各种生产边界条件(自定义子节点字段、是否深拷贝、是否清理空子属性),下面给出一个生产开箱即用的通用树筛选工具函数:
/**
 * 生产级通用树节点筛选工具函数
 * @param {Array} tree 原始树数组
 * @param {Function} predicate 筛选断言函数
 * @param {Object} [options] 配置选项
 * @param {string} [options.childKey='children'] 子节点属性字段
 * @param {boolean} [options.keepAllWhenParentMatch=false] 父节点命中是否保留全部后代
 * @param {boolean} [options.deepClone=false] 是否对保留节点进行深克隆
 * @returns {Array} 过滤后的新树
 */
function advancedFilterTree(tree, predicate, options = {}) {
  const {
    childKey = 'children',
    keepAllWhenParentMatch = false,
    deepClone = false
  } = options;

  if (!Array.isArray(tree) || tree.length === 0) return [];

  function cloneNode(node) {
    if (deepClone && typeof structuredClone === 'function') {
      return structuredClone(node);
    }
    return { ...node };
  }

  return tree
    .map(node => {
      const isMatch = Boolean(predicate(node));

      // 命中继承模式:父节点命中则原样保留全部后代
      if (keepAllWhenParentMatch && isMatch) {
        return cloneNode(node);
      }

      // 递归处理子节点
      const rawChildren = node[childKey];
      const hasChildren = Array.isArray(rawChildren) && rawChildren.length > 0;
      const validChildren = hasChildren
        ? advancedFilterTree(rawChildren, predicate, options)
        : [];

      // 判定节点是否保留
      if (isMatch || validChildren.length > 0) {
        const copy = cloneNode(node);
        if (validChildren.length > 0) {
          copy[childKey] = validChildren;
        } else {
          delete copy[childKey];
        }
        return copy;
      }

      return null;
    })
    .filter(Boolean);
}
总结
在 JavaScript 中筛选树形结构子节点,核心逻辑在于明确后序遍历的执行时序:在遍历过程中优先求解子树的有效集合,再基于“自身是否命中”与“子集是否非空”做出当前节点的存废决策。结合业务对于“精准搜索”与“继承子树”的不同预期选择对应策略,并在输出时妥善处理空 children 属性与对象不可变性,即可写出健壮、高效且无副作用的树筛选代码。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章