
全面解析 JavaScript 中 push、unshift 与 concat 三个数组常用方法的核心差异、返回值机制、底层内存模型、时间复杂度与高频场景下的性能选型。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组push、unshift与concat的区别及性能对比
作者:函数茶馆
时间:2026-11-06
浏览:131
文章目录
JavaScript 原生方法对比
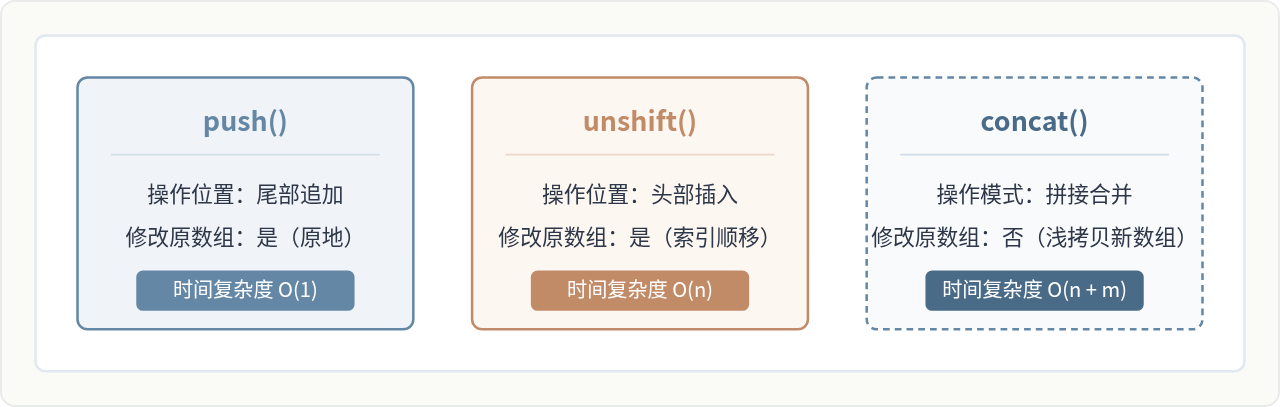
图 0:push、unshift 与 concat 的三大核心属性概览
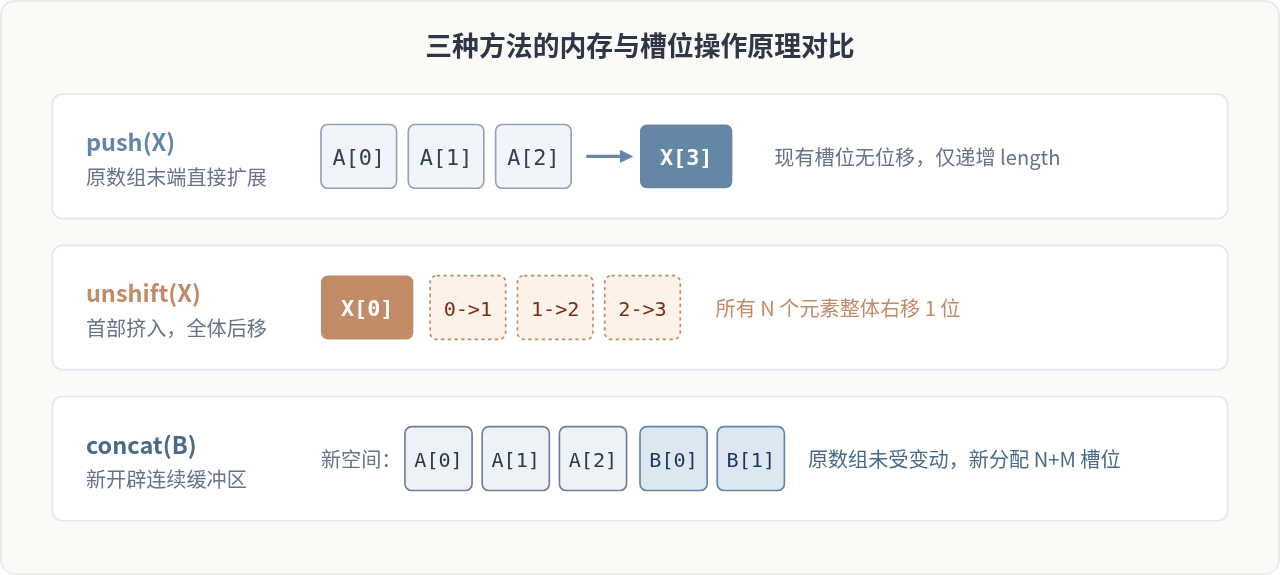
图 1:三种方法在内存与元素槽位上的操作逻辑差异
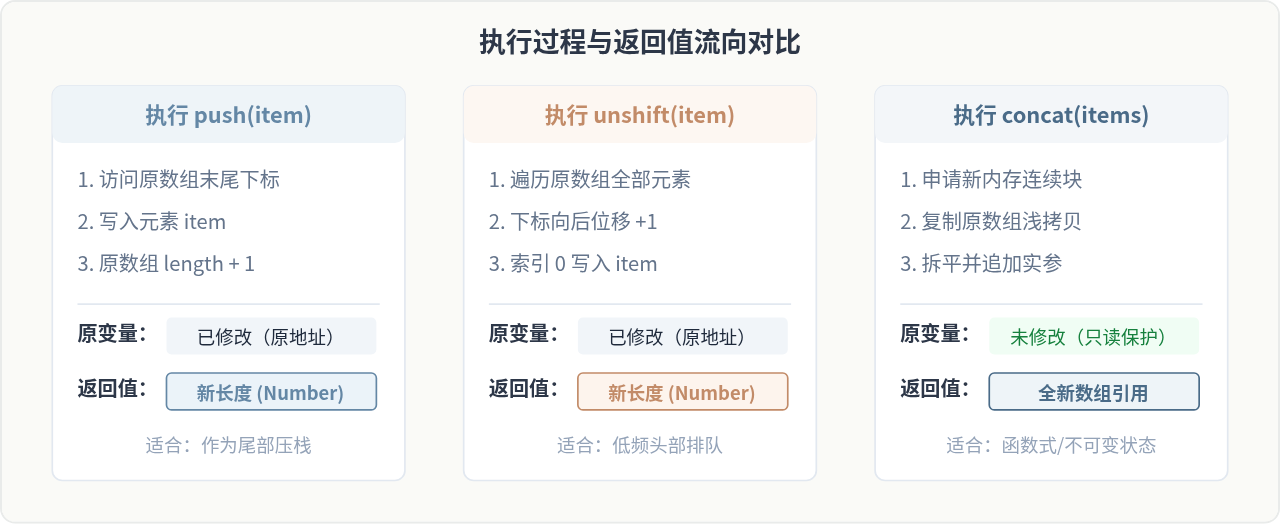
图 2:各方法的执行步骤、原数组引用变化与返回值类型走向
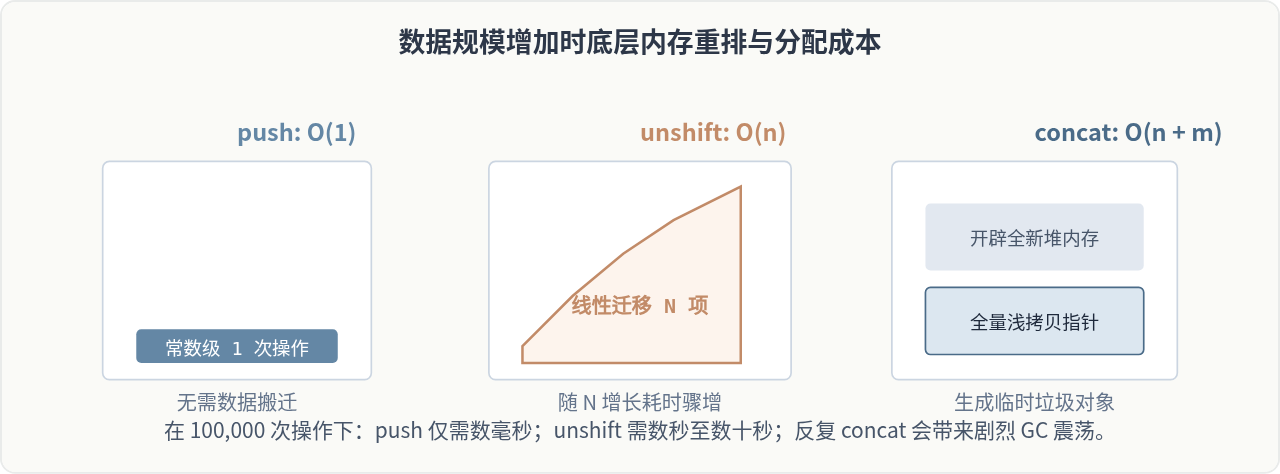
图 3:三种方法面对大体量数据时的开销模型与堆内存影响
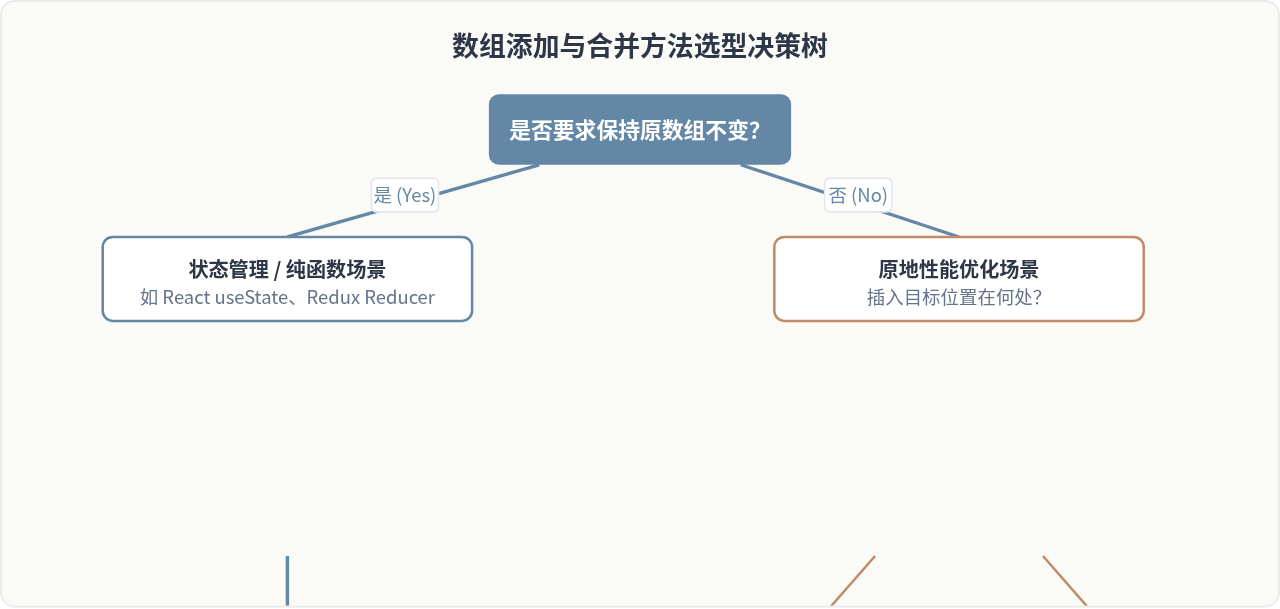
图 4:业务场景与数据量级下的方法选型决策指南
在 JavaScript 数组操作中,
push、unshift 与 concat 虽然都能向集合中添加数据,但行为机制截然不同:push 在原数组末尾追加元素并返回新长度;unshift 在原数组开头插入元素并依次后移现有成员;concat 则不改变原数组,而是分配新内存返回合并后的浅拷贝副本。理解它们在原数组可变性、返回值类型及底层索引重排机制上的差异,是写出高性能代码的关键。
一、核心机制与行为差异
区分这三个方法的最直接维度包含三个:是否修改调用它的原数组(原地变更 vs 纯函数)、方法调用的返回值是什么,以及接收参数时的展开逻辑。
| 方法名称 | 修改原数组 | 返回值 | 插入位置 | 参数为数组时的处理 |
|---|---|---|---|---|
push() |
是(原地修改) | 修改后的数组新长度(Number) | 末尾(尾部追加) | 整体作为一个元素压入(不自动打散) |
unshift() |
是(原地修改) | 修改后的数组新长度(Number) | 头部(首部插入) | 整体作为一个元素插入(不自动打散) |
concat() |
否(保持不可变) | 合并生成的新数组(Array) | 按参数顺序尾部拼接 | 默认展开第一层数组后拼接 |
为了直观展现三者对数组连续内存存储空间的影响,请参考下方内存操作示意图:
二、典型代码示例与执行逻辑
在实际编写业务逻辑时,很多开发者容易在两件事上犯错:一是误将 push 或 unshift 的返回值当作数组使用;二是混淆了参数为数组时的入参处理。
1. push():尾部追加与返回值
push 方法将一个或多个元素添加到数组的末尾,并返回修改后的新长度。该方法会直接修改原数组对象。
const list = ['apple', 'banana'];
const res = list.push('orange');

console.log(res);   // 示例输出: 3 (注意:返回的是数字,而非数组)
console.log(list);  // 示例输出: ['apple', 'banana', 'orange']

// 如果传入一个数组,push 会将其作为单一元素压入
list.push(['pear', 'grape']);
console.log(list.length); // 示例输出: 4
console.log(list[3]);     // 示例输出: ['pear', 'grape']
2. unshift():头部插入与多参数顺序
unshift 在数组开头插入元素,现有元素顺次后移。如果一次性传入多个参数,它们会作为一个批次整体插入头部,其内部相对顺序与参数列表一致。
const numbers = [3, 4];
const len = numbers.unshift(1, 2);

console.log(len);      // 示例输出: 4
console.log(numbers);  // 示例输出: [1, 2, 3, 4]
// 注意:unshift(1, 2) 与连续调用 unshift(1) 再 unshift(2) 结果不同:
// 连续调用会产生 [2, 1, 3, 4]
3. concat():纯函数特性与数组展开
concat 用于合并两个或多个数组/值。它不修改现有数组,而是返回一个新数组副本。当参数本身是数组时,concat 会默认解开第一层嵌套(展开一层)。
const base = [1, 2];
const extra = [3, 4];
const result = base.concat(extra, 5);

console.log(result); // 示例输出: [1, 2, 3, 4, 5] (自动展开了 extra 数组)
console.log(base);   // 示例输出: [1, 2] (原数组保持不变)

// 嵌套数组只展开第一层
const nested = base.concat([[99]]);
console.log(nested); // 示例输出: [1, 2, [99]]
注意事项:
concat 执行的是浅拷贝。如果合并的数组元素是对象引用,新数组中的对象与原数组引用同一内存地址,修改对象属性在两边都会生效。
下图详细展示了执行上述三种代码时,输入变量的指针与返回值走向:
三、性能对比与底层引擎机制
在数据量较小(几十到数百条)时,三者的耗时差异在现代 JavaScript 引擎(如 V8)中并不显著;但当数据量达到万级或十万级以上,或者在循环体内高频执行时,性能差距会呈指数级放大。
1. 时间复杂度对比
-
push() 为均摊 O(1):大部分情况下,引擎内部维护着连续的固定容量内存块。当尾部有空闲槽位时,直接写入对应下标并更新
length;只有在容量耗尽时才会触发一次扩容(分配新容量并将旧数据拷贝过去)。均摊到每次调用,耗时恒定。 -
unshift() 为 O(n):因为数组在 JavaScript 中保持由 0 起始的紧凑下标(Packed Elements),在头部插入元素意味着原有
n个元素的下标必须全部依次向后移动 1 位(从n-1到0逐一赋值迁移),数据规模越大,移动操作的开销越直接。 -
concat() 为 O(n + m):无论目标数组有多大,
concat都必须完整分配一个容量为n + m的全新底层数组,并将两个集合中的引用全部拷贝一遍。
2. 内存占用与垃圾回收(GC)压力
push 和 unshift 均在原对象内存空间中运作,除扩容时刻外,不会持续产生孤立内存;而 concat 每次调用都会创建新对象。若在长循环内频繁使用 arr = arr.concat(item),会在堆内存中遗留海量短暂存在的中介数组,极易频繁触发 V8 的垃圾回收(Minor GC / Major GC),造成主线程掉帧或卡顿。
四、工程选型与实践避坑指南
根据业务需求与数据量级,选择最适合的方法,可以避免潜在的性能隐患:
1. 批量追加与数组合并的高效替代
当需要将数组 B 的所有元素追加到数组 A 末尾时,很多人习惯写:
// 不推荐:大规模数据下创建了不必要的新数组,且未能修改原变量
let listA = [1, 2, 3];
const listB = [4, 5, 6];
listA = listA.concat(listB);
如果允许原地修改,利用 push 结合扩展运算符或循环追加更为高效:
// 推荐方式 A:利用 push + 扩展运算符(注意:若 listB 超过数十万项,可能超出调用栈上限)
listA.push(...listB);

// 推荐方式 B:超大集合(数万以上)使用传统循环最稳健
for (let i = 0; i < listB.length; i++) {
  listA.push(listB[i]);
}
2. 需要向头部追加大量元素时的优化手段
如果需要在一个空数组或现有列表中连续从头部入队大量数据,频繁调用 unshift 会导致严重的性能卡顿。此时可优先采用尾部 push 收集,最后调用一次 reverse() 的模式:
// 性能较差:循环内执行 unshift,复杂度达到 O(n^2)
const resultBad = [];
for (let i = 0; i < 50000; i++) {
  resultBad.unshift(i);
}

// 性能极高:全量 push (O(1)),最后整体翻转一次 (O(n))
const resultGood = [];
for (let i = 0; i < 50000; i++) {
  resultGood.push(i);
}
resultGood.reverse(); // 一次性 O(n) 完成头部顺序排列
3. 不可变数据流(React / Redux / Vue 3 计算属性)
在现代前端框架中,为了保证状态不可变(Immutable State)以便精确触发重渲染或时光旅行调试,不应使用会原地改变数组的 push 与 unshift。此时推荐使用 concat 或 ES6 数组展开语法:
// React 状态更新:必须生成新数组引用
setItems(prevItems => prevItems.concat(newItem));
// 或者等价展开式:
setItems(prevItems => [...prevItems, newItem]);总结
归纳来看,push 是 JavaScript 数组中兼具性能与简洁度的常规追加手段;unshift 适用在低频或小规模头部排队场景,高频调用时需警惕其线性移位开销;而 concat 则专注于保障不可变数据流与安全的浅拷贝合并。在工程开发中,遵循“只在需要不可变时复制,高频读写优先尾部追加”的原则,便能充分兼顾代码的可维护性与运行效率。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章