
全面讲解在JavaScript中安全删除数组中null与undefined空值的高效方案,剖析filter(Boolean)误删假值的隐患,详解不可变过滤、TypeScript类型守卫与原地修改双指针算法。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组怎么安全删除undefined和null空值
作者:拾光
时间:2026-11-03
浏览:501
文章目录
在 JavaScript 中,“安全”删除数组中
undefined 和 null 的核心准则是:在剔除无有效数据项的同时,绝不能误伤具有合法业务含义的假值(如数字 0、空字符串 ""、布尔值 false 与 NaN)。日常开发中最推荐的做法是不可变过滤 arr.filter(item => item != null),它利用语言底层宽松不等于规范同时排除了两类空值;若遇到不能分配新内存的高性能或大规模数据场景,则应采用双指针快慢移动的原地覆盖算法,避免正序循环 splice 带来的索引错位隐患。
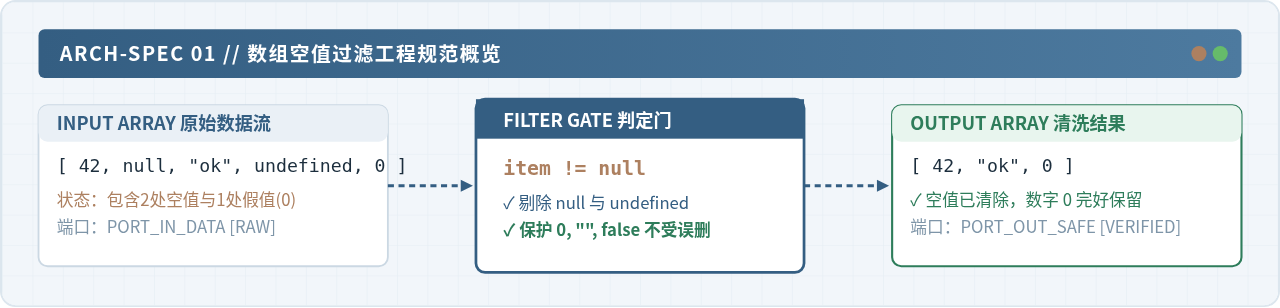
一、假值陷阱与精准判空判定原理
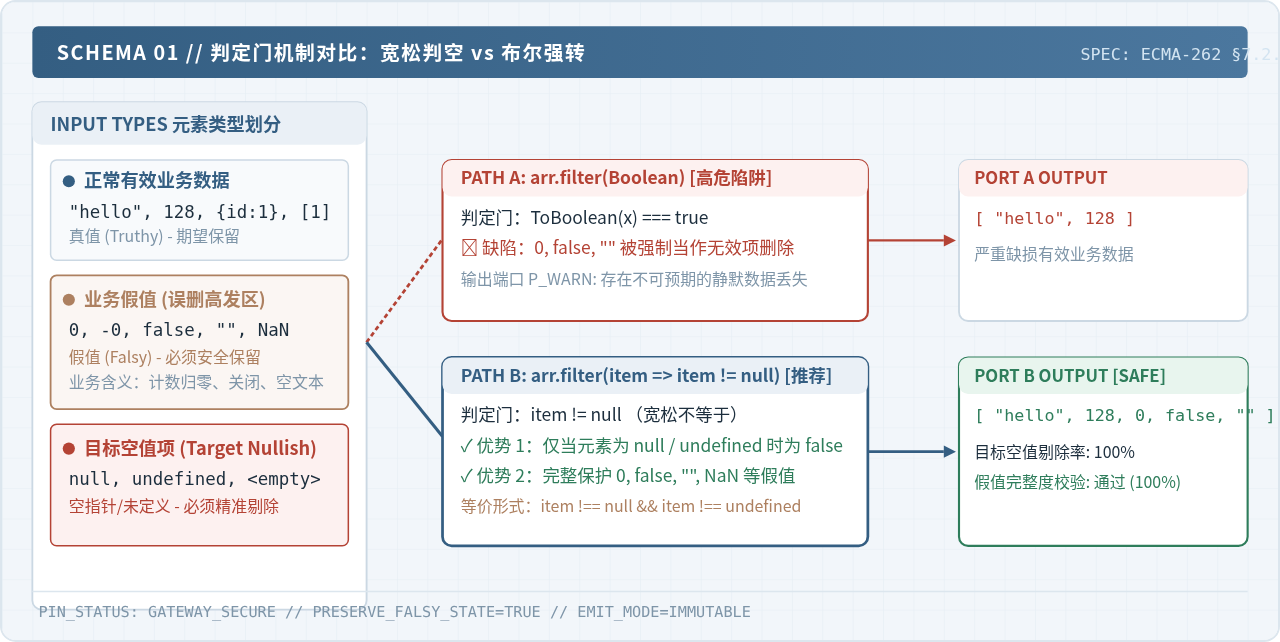
很多初学者在清理数组时,往往习惯直接调用 arr.filter(Boolean)。这种做法在数组仅包含常规对象或非零数字时似乎能正常工作,但在健壮的工程开发中却潜藏着巨大的数据损坏隐患。
在 JavaScript 的隐式类型转换规则中,除了 null 与 undefined 之外,0、-0、0n、""(空字符串)、false 以及 NaN 同样会被强制转换为布尔值 false。如果数组存储的是传感器读数、表单字段、状态开关或数值坐标,盲目使用布尔强转会导致有效业务数据被连带抹除。
// 危险示例:使用 Boolean 进行全量假值过滤
const rawScores = [100, null, 0, "合格", undefined, "", false];
const unsafeResult = rawScores.filter(Boolean);
console.log(unsafeResult);
示例输出:[ 100, "合格" ] // 错误:0分、空文本和 false 状态均被连带丢弃
要实现“仅删除 null 和 undefined”的目标,必须理解 ECMAScript 规范中的抽象相等比较规则(Abstract Equality Comparison)。在标准规则中,null == undefined 返回 true,且它们两个与任何其他值(包括 0、false、"")进行宽松比较时,结果均为 false。因此:
- 表达式
item != null严格等价于item !== null && item !== undefined。 - 同理,
item != undefined也能达成相同效果,但业界通行标准更倾向于使用!= null,书写更为简短。
二、不可变模式:filter 的标准实践与类型守卫
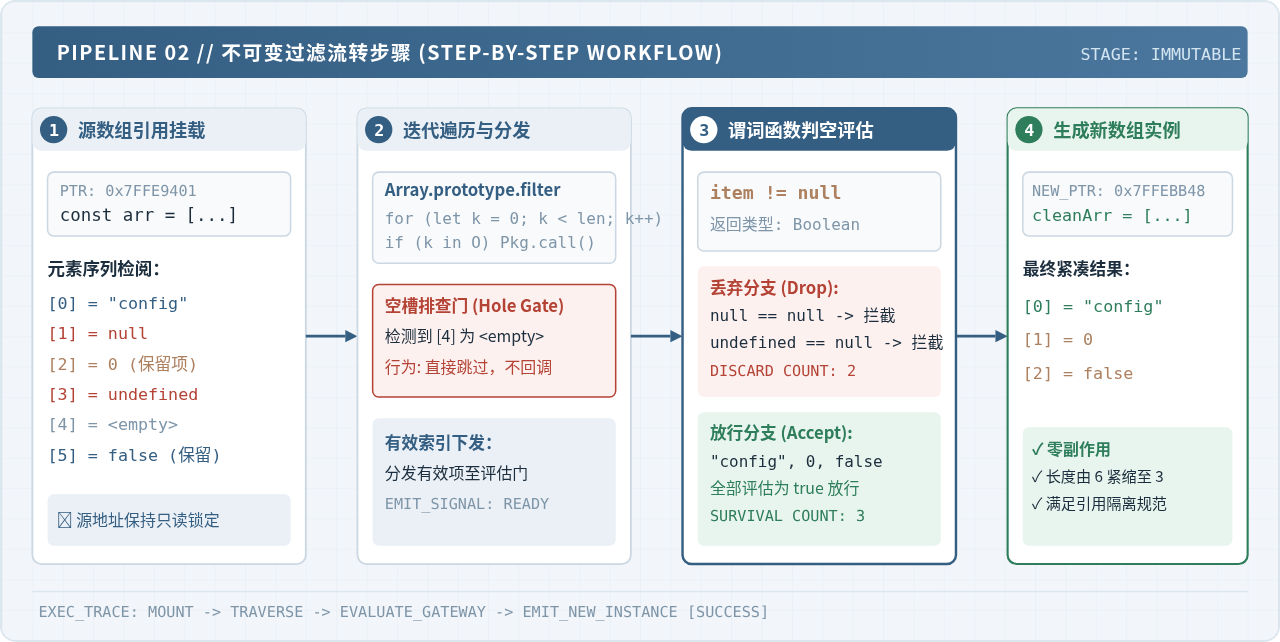
在现代前端开发(如 React、Vue 与 Redux 数据流)中,遵循不可变数据原则(Immutability)至关重要。过滤操作应当生成一个全新的数组引用,而不是直接修改输入数据,这样能确保视图响应式监听不失效,同时避免副作用穿透到其他模块。
1. 标准单行过滤(推荐语法)
利用 Array.prototype.filter 与 item != null,这是 JavaScript 清除双空值最简洁且符合规范的标准写法:
const list = ["apple", null, 0, undefined, false, "", "banana"];

// 安全清洗:保留 0、false、"",移除 null、undefined
const cleanList = list.filter(item => item != null);

console.log(cleanList);
console.log(list !== cleanList); // true,保持原数组未被修改
示例输出:[ "apple", 0, false, "", "banana" ]
代码规范注意:如果团队启用了极严格的 ESLint 规则(如禁止任何双等号与叹号等号的
两者的底层判定逻辑完全一致,仅在语法表现形式上遵循严格全等检查。
eqeqeq: ["error", "always"]),则可以直接使用全等语法改写为:
const cleanList = list.filter(item => item !== null && item !== undefined);
两者的底层判定逻辑完全一致,仅在语法表现形式上遵循严格全等检查。
2. 稀疏数组(空槽 Empty Slot)的天然处理能力
JavaScript 数组可能包含未赋值的“空槽”(例如通过 new Array(3) 或字面量 [1, , 3] 创建的稀疏数组)。空槽在读取时返回 undefined,但在底层哈希结构中并不存在索引键。Array.prototype.filter 在执行时遵循 ECMAScript 规范,会自动跳过这些未初始化的空槽(即内部的 HasProperty 检查为 false),因此该方法不仅能剔除显式的 null 与 undefined,还能顺带将稀疏数组压实为密集数组。
3. TypeScript 中的类型安全:自定义类型守卫(Type Guard)
在 TypeScript 项目中,如果直接执行 list.filter(x => x != null),编译器推导出的结果类型依然是 (string | number | boolean | null | undefined)[]。这是因为 TypeScript 无法从箭头函数体内直接推断出过滤收窄关系,导致后续使用必须频繁加上非空断言操作符 !。
彻底解决该问题的方案是提供一个类型谓词函数(Type Predicate):
// 定义通用的空值类型守卫
function isNonNullable<T>(val: T): val is NonNullable<T> {
  return val !== null && val !== undefined;
}

// 待清洗的混合数据源
const rawItems: (string | null | undefined | number)[] = ["Alpha", null, 2026, undefined];

// 经过守卫过滤后,safeItems 的类型被收窄为 (string | number)[]
const safeItems = rawItems.filter(isNonNullable);

safeItems.forEach(item => {
  // 此时 item 不存在 null / undefined 类型风险,无需可选链或非空断言
  console.log(item.toString());
});
示例输出:
"Alpha"
"2026"
"Alpha"
"2026"
三、原地修改:避免索引漂移的安全算法
虽然 filter 是最推荐的通用做法,但在以下特殊场景中,你可能必须就地修改(In-place Mutation)原数组:
- 内存极其严苛的环境:数组包含几十万个大型对象,重新分配一个等长新数组会触发垃圾回收抖动(GC Thrashing)或内存溢出。
- 保持原引用不变:外部多个模块持有了该数组的唯一引用,无法通过重新赋值更新指针。
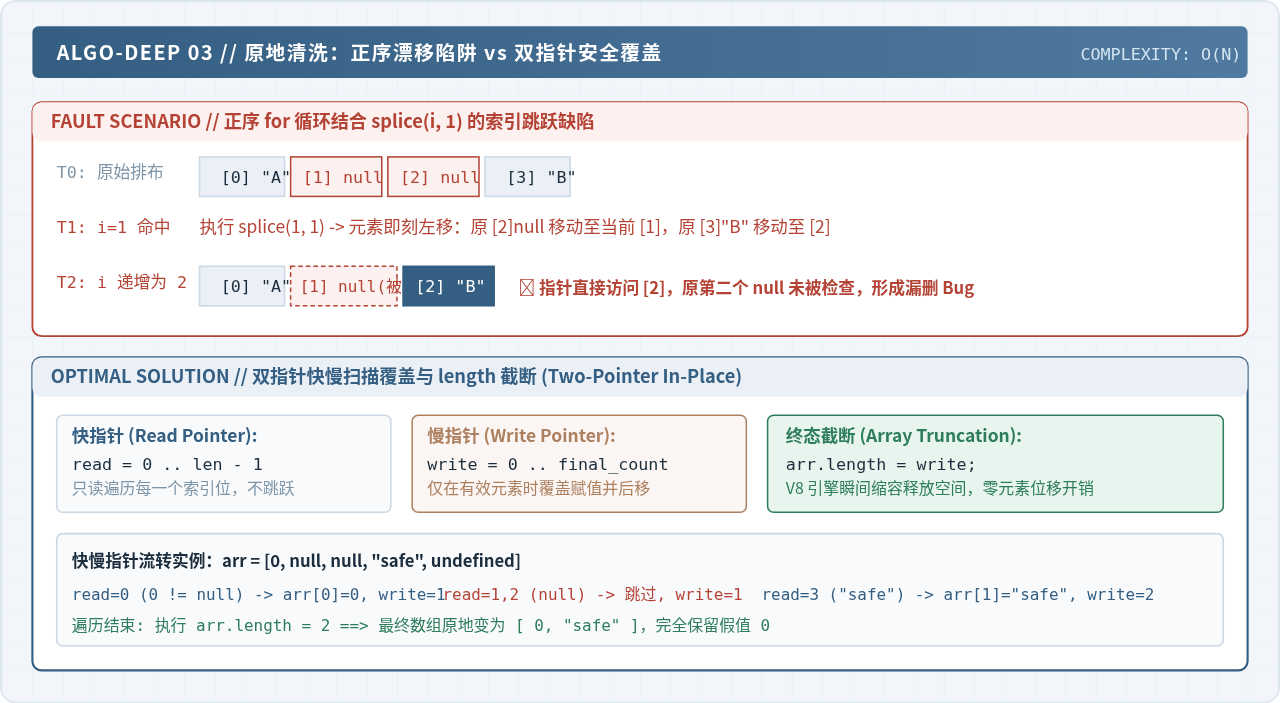
1. 正序 splice 的“索引漂移”灾难
很多开发者在尝试原地删除时,直觉性地写出如下代码:
// 错误示范:正序遍历 + splice
const badArray = ["A", null, null, "B"];

for (let i = 0; i < badArray.length; i++) {
  if (badArray[i] == null) {
    badArray.splice(i, 1);
  }
}
console.log(badArray);
示例输出:[ "A", null, "B" ] // 严重 Bug:连续的第二个 null 被意外漏掉了!
产生漏删的根本原因在于索引漂移(Index Shifting):当 i = 1 处的第一个 null 被删除后,后面的所有元素立刻向前补位。原先处于 i = 2 的第二个 null 瞬间滑动到了 i = 1 的位置。而紧接着 for 循环执行 i++,下一次检查的是 i = 2(即 "B"),刚刚向前补位的 null 直接逃脱了检查!
2. 简单修复:逆序循环(从后往前遍历)
若依然希望使用 splice,最直观的修复方式是将循环方向改为逆序。因为从数组尾部往前删除时,发生前移的只有已经被检查过的尾部元素,前方待检查元素的索引完全不受影响:
const data = ["A", null, null, "B", undefined, 0];

for (let i = data.length - 1; i >= 0; i--) {
  if (data[i] == null) {
    data.splice(i, 1);
  }
}

console.log(data);
示例输出:[ "A", "B", 0 ] // 连续空值全部被正确删除,且 0 完好保留
3. 高性能极致方案:双指针快慢移动与 length 截断
虽然逆序 splice 能解决漏删,但每次调用 splice 都会导致底层内存块向前搬移,如果数组元素有 10 万个且包含大量空值,其时间复杂度为 O(n²),耗时显著上升。
工业级高性能的原地清洗算法是双指针快慢覆盖法(Two-Pointer Invariant):
- 定义慢指针
write(写入位置)和快指针read(读取位置),均从0开始。 - 快指针
read遍历整个数组:若当前元素不是空值(arr[read] != null),则将其覆盖写入到慢指针write所在槽位,并将write加 1。 - 当快指针扫描完毕后,直接将
arr.length = write。JavaScript 引擎会高效地将多余的尾部空间瞬间截断丢弃。
// 高性能 O(n) 原地清洗算法
function compactInPlace(arr) {
  let write = 0;
  const len = arr.length;

  for (let read = 0; read < len; read++) {
    const val = arr[read];
    // 精准判空,保留 0, false, ""
    if (val != null) {
      arr[write] = val;
      write++;
    }
  }

  // 一步截断后续无效槽位
  arr.length = write;
  return arr;
}

const buffer = [0, null, null, "safe", undefined, false];
compactInPlace(buffer);
console.log(buffer);
示例输出:[ 0, "safe", false ] // 时间复杂度仅 O(n),空间复杂度 O(1),无重复内存分配
四、清洗策略选择与性能工程对比
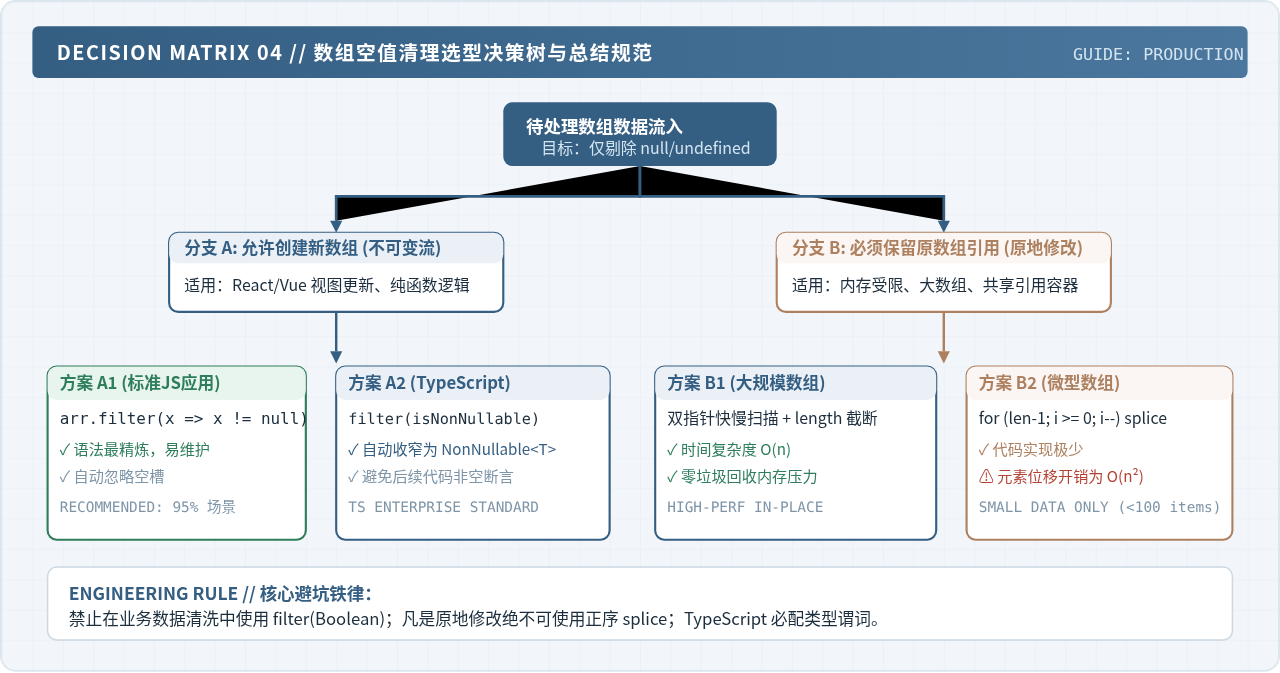
为了在具体业务开发中选择最恰当的方案,下面对常见的四种空值清理手段在功能特性、边界保护与执行效率方面做横向对比:
| 处理方式 | 是否修改原数组 | 保留假值(0/"") | 空槽处理能力 | 时间复杂度 | 空间复杂度 | 适用业务场景 |
|---|---|---|---|---|---|---|
| arr.filter(x => x != null) | 否 (不可变) | 完美保留 | 自动跳过 | O(n) | O(n) | 首选推荐:日常前端应用、React/Vue组件数据流 |
| TS 自定义类型守卫 | 否 (不可变) | 完美保留 | 自动跳过 | O(n) | O(n) | TypeScript 工程,需要准确类型收窄(去除非空断言) |
| 双指针快慢移动 + length | 是 (原地修改) | 完美保留 | 自动跳过 | O(n) | O(1) 零内存开销 | 超大规模数组(数十万级)、高频清洗、内存严苛场景 |
| 逆序 for 循环 + splice | 是 (原地修改) | 正确保留 | 正常检测 | O(n²) | O(1) | 小规模数组(几十项)、要求原地更新且代码量极小的场景 |
| arr.filter(Boolean) | 否 (不可变) | ❌ 全部误删 | 自动跳过 | O(n) | O(n) | 不推荐:仅适合明确要求去除全部假值的特定业务 |
五、边界处理与验证清单
在将清洗逻辑集成到生产环境前,建议按照以下清单对边缘场景进行回归验证:
- 假值完整度验证:确保测试用例包含
0、""(空字符串)、false和NaN,确认清洗后这些值依然存在,未被隐式转换误杀。 - 连续空值边界测试:针对原地修改逻辑,输入
[null, null, undefined, undefined]等连续空值,验证算法不会发生索引跳过。 - 稀疏数组压实:测试带有空槽的数组
[1, , 2],确认处理后的数组为连续紧凑结构,且length正确缩减。 - 深层嵌套对象处理:本文讨论的所有方法均针对一维数组。如果数组中存放的是对象,且需要清除对象属性中的
null或undefined,应配合map()进行深层键值过滤或递归清理,而非仅对顶层数组过滤。
总结而言,在 JavaScript 中安全删除 undefined 和 null 并不复杂,关键在于恪守精确匹配原则:常规业务直接使用 arr.filter(item => item != null),TypeScript 工程使用 isNonNullable 守卫,极端原地性能场景使用双指针快慢覆盖,即可彻底杜绝静默数据丢失与索引错位隐患。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章