
本文深入解析JavaScript数组浅拷贝与深拷贝的本质差异、实现方式与性能表现,并提供清晰的场景决策流程图与方法对比总结,帮助开发者在实际业务中准确选择最优拷贝策略。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组浅拷贝与深拷贝怎么选?场景与方法总结
作者:闭包旅人
时间:2026-11-05
浏览:310
文章目录
在 JavaScript 开发中,数组拷贝是日常高频操作。很多开发者都遇到过这样的情况:对拷贝出的新数组进行修改,原数组中的数据却被意外篡改;或者为了保险起见盲目使用深度克隆,导致性能下降。选择浅拷贝还是深拷贝,核心判断依据非常明确:数组中是否包含引用类型(如对象、子数组),以及后续业务是否需要独立修改这些嵌套数据。如果数组仅由基本类型组成,或者只需调整数组层级的排序、过滤和增删,浅拷贝是最高效且标准的选择;只有当数组内含有嵌套引用,且对副本的修改决不能波及原数据时,才必须使用深拷贝。
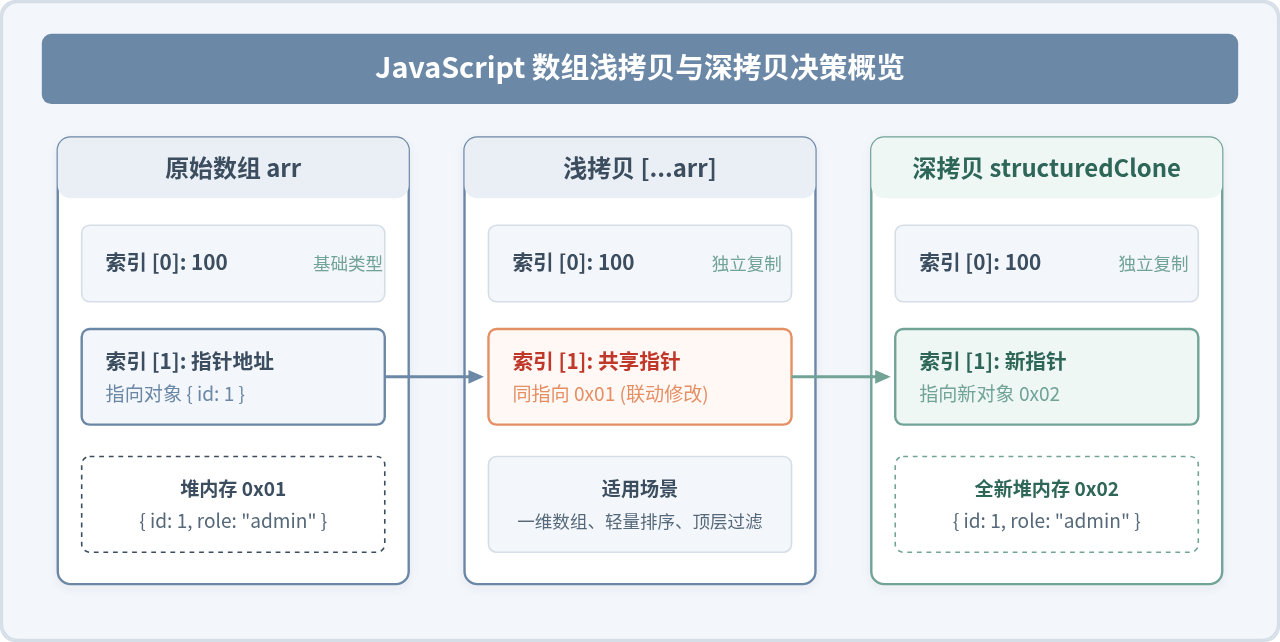
图 0:JavaScript 数组浅拷贝与深拷贝数据结构流向一览
一、底层原理:内存模型中的“传值”与“传址”
要彻底分清浅拷贝与深拷贝,首先要理解 JavaScript 运行时中的内存划分。基本数据类型(如 Number、String、Boolean、null、undefined 等)通常直接按值存放在栈内存(Stack)中;而引用类型(如 Object、Array、Date 等)的实际数据存储在堆内存(Heap)中,栈内存中只保存着指向堆内存真实地址的指针。
当数组作为容器存储不同类型数据时,浅拷贝与深拷贝的根本区别体现在对堆内存指针的处理机制上:
- 浅拷贝(Shallow Copy):只克隆数组的最外层结构。遇到基本类型元素时,直接复制其具体数值;遇到引用类型元素时,复制的是该对象的内存指针。因此,原数组与新数组中的引用元素仍然共享同一份堆内存数据,任意一方对内层对象属性的修改都会直接反映到另一方。
- 深拷贝(Deep Copy):沿树状层级递归访问数组的所有元素。不论嵌套了多少层对象或子数组,深拷贝都会在堆内存中为它们开辟全新的空间,并完整复制其属性结构。拷贝完成后,两份数据在内存中彻底解耦,互不干扰。
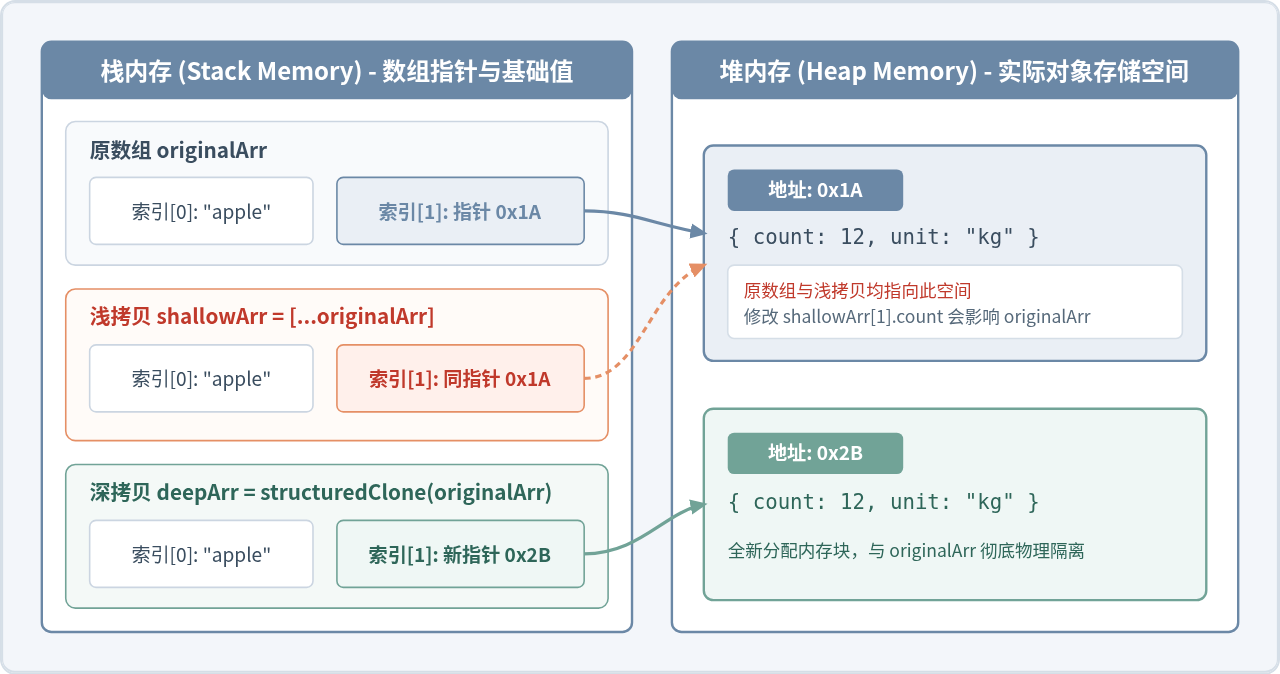
图 1:数组浅拷贝与深拷贝在栈与堆内存中的引用分配模型
二、数组浅拷贝:常用方法与适用场景
在日常业务中,绝大多数数组操作只需要使用浅拷贝。浅拷贝具有执行极快、无递归开销、内存占用小的优势。
1. 常用浅拷贝方法
在现代 JavaScript 中,实现数组浅拷贝有多种简单直观的语法:
// 原始示例数组(包含基本类型和对象)
const sourceList = [10, 20, { title: "JavaScript" }];

// 方法 1:扩展运算符(Spread Operator)- 最推荐与常用
const copy1 = [...sourceList];

// 方法 2:Array.prototype.slice() - 兼容性极强
const copy2 = sourceList.slice();

// 方法 3:Array.from() - 语义清晰,支持转换类数组
const copy3 = Array.from(sourceList);

// 方法 4:Array.prototype.concat() - 传统写法
const copy4 = sourceList.concat();
2. 浅拷贝的典型适用场景
- 一维纯基本类型数组:例如
[1, 2, 3, 4]或['apple', 'banana', 'orange']。由于数组内所有元素都是基础数据类型,浅拷贝即可达到完全独立的效果。 - 仅改变数组自身的顺序或结构:例如对商品列表进行倒序
arr.reverse()、按价格排序arr.sort(),或者过滤掉部分项arr.filter()。只要不需要修改内层对象的属性,浅拷贝就能提供安全的新数组容器。 - 前端框架中的不可变状态更新(Immutable Update):在 React、Vue 3 或 Redux 中,当我们需要在原数组末尾追加项时(例如
setItems([...items, newItem])),扩展运算符能够生成新数组引用,触发视图重渲染,且避免了无谓的深层性能损耗。
避坑提醒:如果数组中包含对象(如
[{ id: 1 }, { id: 2 }]),使用浅拷贝后执行 copy[0].id = 999,原数组中的 sourceList[0].id 也会被同步修改。如果业务后续需要编辑内层对象的字段,切忌使用浅拷贝。
三、数组深拷贝:核心方案与运行机制
当数组内部嵌套了复杂的对象、多维数组,且业务要求必须与原数据完全断开连接时,就需要采用深拷贝。深拷贝需要递归遍历子结构并识别对象类型。
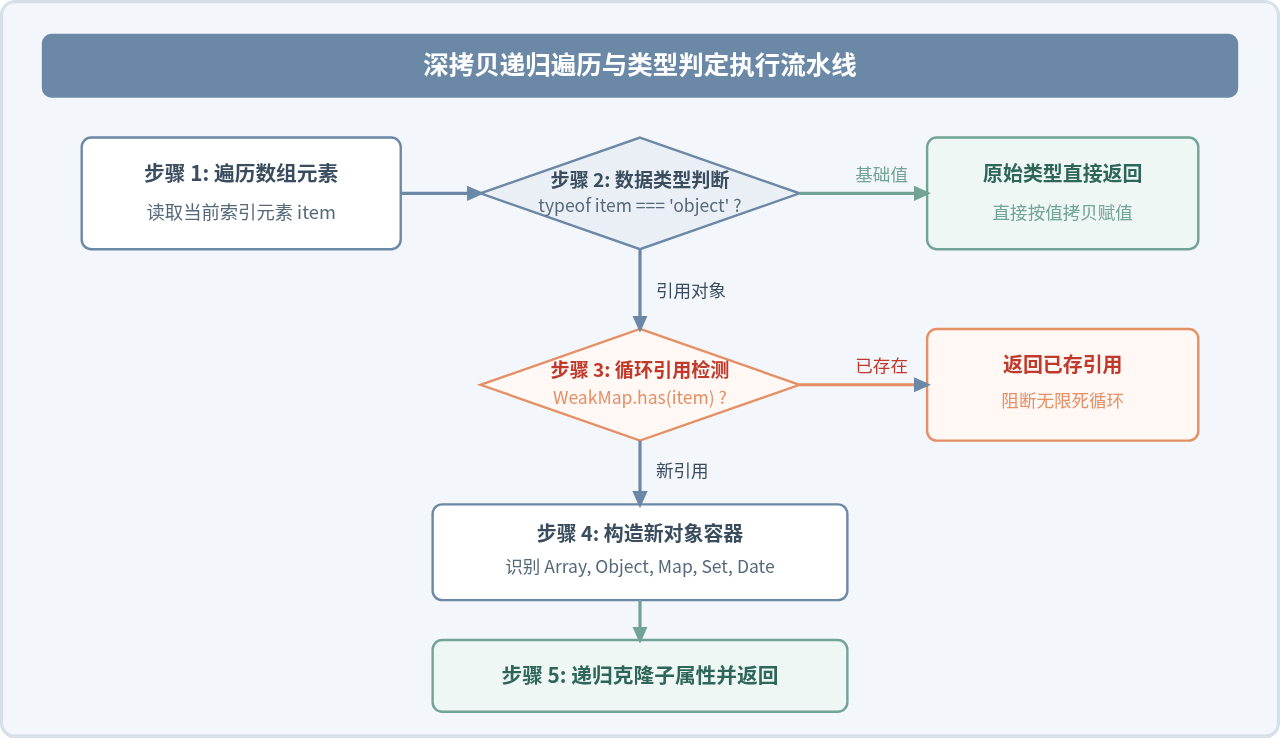
图 2:深拷贝算法的类型判定、缓存查询与递归处理流水线
1. 原生 API:structuredClone() —— 现代标准首选
HTML 规范和现代 JavaScript 运行环境(Chrome 98+、Node.js 17+ 等)现已原生内置 structuredClone() 方法。它底层采用结构化克隆算法(Structured Clone Algorithm),是进行深度克隆的官方标准方式。
// 嵌套多层对象的复杂数组
const complexArray = [
  { id: 1, tags: ['frontend', 'js'], created: new Date() },
  { id: 2, meta: new Map([['status', 'active']]) }
];

// 使用原生 API 进行深拷贝
const deepCloned = structuredClone(complexArray);

// 修改内层属性完全隔离
deepCloned[0].tags.push('vue');
console.log(complexArray[0].tags); // ['frontend', 'js'],不受丝毫影响
console.log(deepCloned[0].created instanceof Date); // true,保留真实 Date 类型特性优势:支持 Date、RegExp、Map、Set、ArrayBuffer 等复杂内建对象,并且天然支持循环引用。无需额外引入外部第三方库。
限制条件:不支持包含函数(Function)、DOM 节点以及原型的保留;如果遇到不可克隆的属性,会直接抛出 DataCloneError 异常。
2. 经典方案:JSON.parse(JSON.stringify(arr)) —— 轻量但缺陷明显
这是在 structuredClone 普及前最常用的取巧方式:
const simpleNested = [{ id: 1, name: "Alice" }, { id: 2, name: "Bob" }];
const clonedByJson = JSON.parse(JSON.stringify(simpleNested));
严重局限性清单:
Date对象会被序列化成 ISO 字符串,无法恢复为真正的 Date 实例。undefined、Symbol和函数在序列化时会被直接忽略或转为null。NaN和Infinity会被转换为null。- 致命缺陷:若数组对象存在循环引用,会直接抛出
TypeError: Converting circular structure to JSON异常。
3. 手动递归实现 / 工具库(如 Lodash cloneDeep)
当需要兼容旧版运行时环境,或数组对象内含有自定义方法、原型方法时,可以借助简易的手写递归函数(利用 WeakMap 处理循环引用)或成熟的工具库:
// 手写深拷贝核心逻辑(包含循环引用防御)
function deepClone(target, hash = new WeakMap()) {
  // 1. 基础类型与 null 直接返回
  if (target === null || typeof target !== 'object') {
    return target;
  }
  // 2. 特殊对象类型直接实例还原
  if (target instanceof Date) return new Date(target);
  if (target instanceof RegExp) return new RegExp(target);

  // 3. 循环引用直接从 WeakMap 获取
  if (hash.has(target)) {
    return hash.get(target);
  }

  // 4. 保持容器原型(区分普通对象与数组)
  const result = Array.isArray(target) ? [] : {};
  hash.set(target, result);

  // 5. 递归复制所有可枚举自有属性
  for (const key of Object.keys(target)) {
    result[key] = deepClone(target[key], hash);
  }
  return result;
}
四、实战选型指南:场景决策树
在工程实践中,盲目使用深拷贝会导致显著的性能和内存浪费。深拷贝的开销通常比浅拷贝高出数十至数百倍。面对具体的业务需求,建议按照以下决策逻辑快速定位最适合的方法。
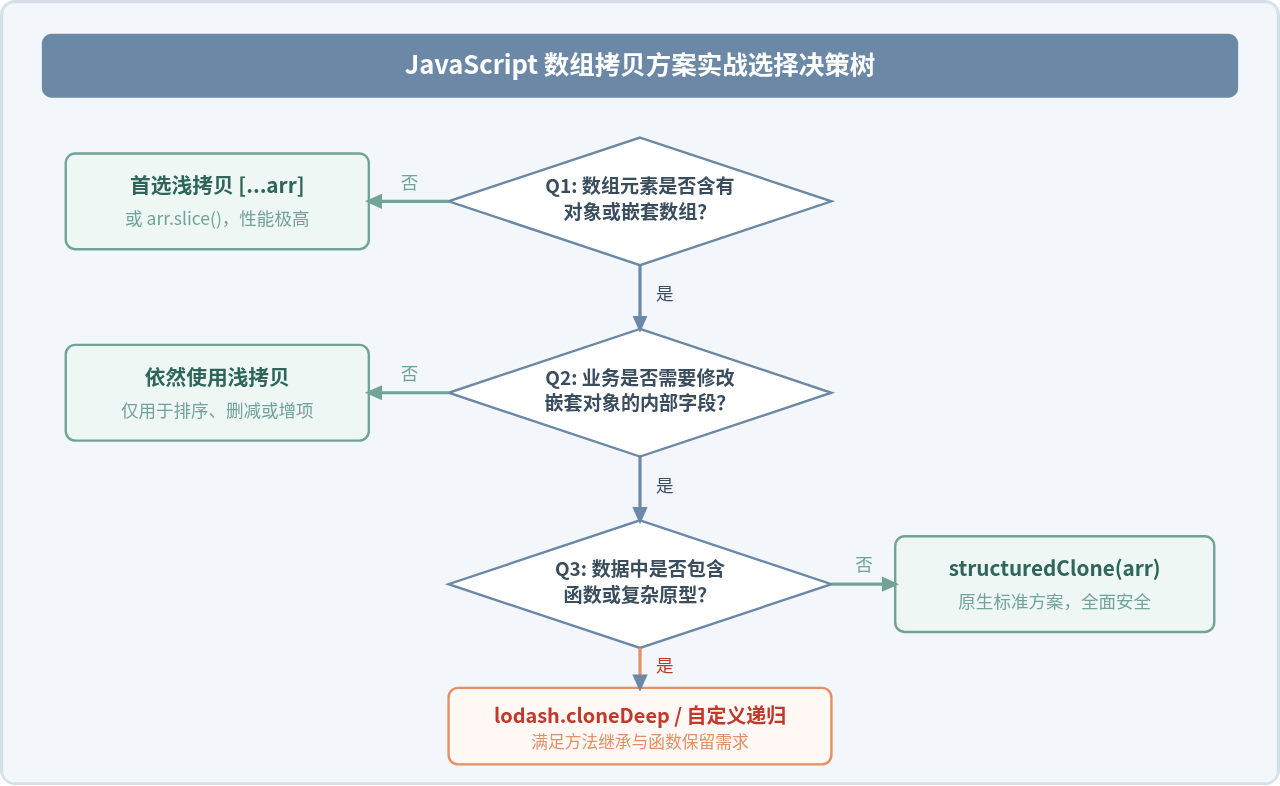
图 3:基于业务数据类型与修改诉求的决策路线图
五、主流方法横向对比与关键指标
为了在开发与技术评审中提供明确的参考标准,我们将开发中四种常见的数组拷贝方法在克隆深度、类型支持、性能表现及适用边界上进行横向对比:
| 方法名称 | 拷贝深度 | 特殊类型支持(Date/Map等) | 循环引用支持 | 性能开销 | 适用场景与推荐度 |
|---|---|---|---|---|---|
扩展运算符 [...arr] |
浅拷贝 (单层) | 不支持内层深层克隆 | 天然安全(不递归) | 极低(纳秒级) | 极度推荐:一维基础数组、框架不可变状态、纯列表排序与增删 |
structuredClone() |
深拷贝 (全层级) | 全面支持 Date, Map, Set, RegExp 等 | 完美支持 | 适中(原生 C++ 实现) | 极度推荐:现代浏览器/Node环境中的常规业务深拷贝首选 |
JSON.parse(stringify) |
深拷贝 (全层级) | 不支持(Date转String,丢失undefined) | 不支持(直接抛错) | 较低 | 谨慎使用:仅适合纯 JSON 格式数据且确定无循环引用的老旧项目 |
lodash.cloneDeep() |
深拷贝 (全层级) | 非常全面(包括函数包装与原型) | 完美支持 | 中等偏高(JS运行) | 按需选用:需克隆带方法对象或需兼容较旧运行时的复杂应用 |
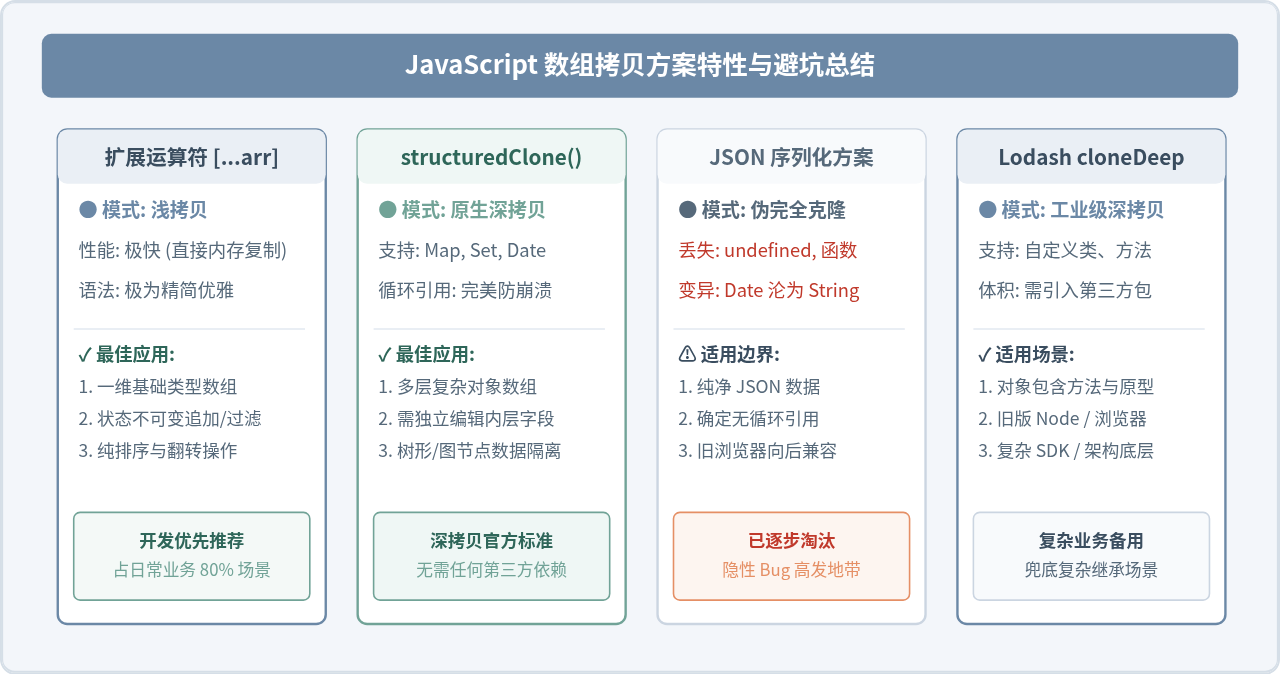
图 4:四种主流数组拷贝方式全景特性对比与选型备忘
六、总结与落地建议
在面对“数组拷贝怎么选”这个问题时,切忌陷入“只要是拷贝就一律深拷贝”的过度防御陷阱。遵循以下两条落地原则,可以在代码安全性与执行效率之间取得最佳平衡:
- 默认优先浅拷贝:对于 80% 以上的前端状态操作、列表排序、分页截取和单层数据组装,直接使用
[...arr]或arr.slice()。这样既保证了纯函数式的不可变性,又杜绝了不必要的内存分配与 CPU 消耗。 - 需要深度隔离时首选
structuredClone:一旦数组元素包含嵌套对象或多维结构,且后续需要修改内层字段(例如表单批量编辑中的数据快照还原、草稿箱回退),直接调用原生structuredClone(arr)。除非需要克隆函数或兼容极老旧环境,否则不再推荐手写易出 Bug 的JSON.parse(JSON.stringify())。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章