
深入剖析JavaScript递归编程中常见的四大陷阱:基线条件缺失导致的栈溢出、重复子问题的指数级性能损耗、闭包强引用的内存堆积以及异步递归的时序失控,并提供具体的防御方案与代码重构示例。

当前位置:首页 > JavaScript 函数与作用域 > 正文
JavaScript递归写法有哪些常见陷阱及避免方法
作者:闭包旅人
时间:2026-11-05
浏览:556
文章目录
技术专题:JavaScript核心算法与工程实践
阅读时长:约 12 分钟
代码规范:ES6+ 标准
在 JavaScript 开发中,递归是解决树形目录遍历、深拷贝、复杂状态计算和嵌套数据解析的优雅手段;然而,由于 JavaScript 单线程执行栈和独特的异步事件循环机制,递归也是运行时报错与性能崩溃的高发区。最常出现的四大陷阱为:基线条件缺失导致的栈溢出、重叠子问题引发的指数级计算停滞、深层闭包滞留引发的隐性内存泄漏,以及异步调度丢失 await 造成的并发失控。理解这些陷阱的底层诱因并掌握防御性编码规范,是写出健壮代码的关键。
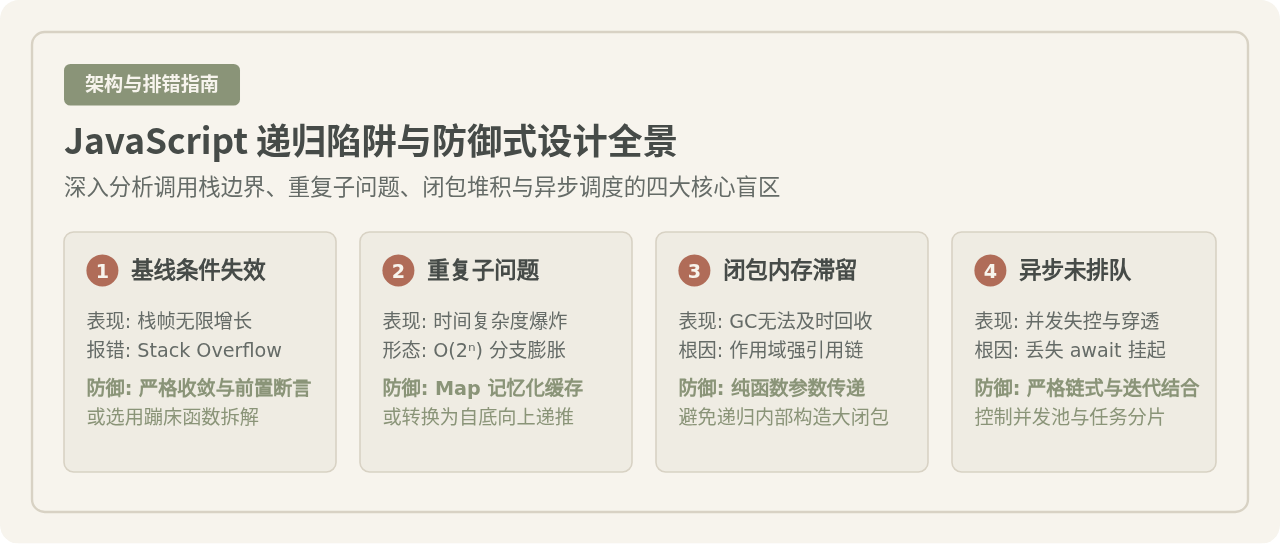
一、基线条件(Base Case)遗漏或失效导致调用栈溢出
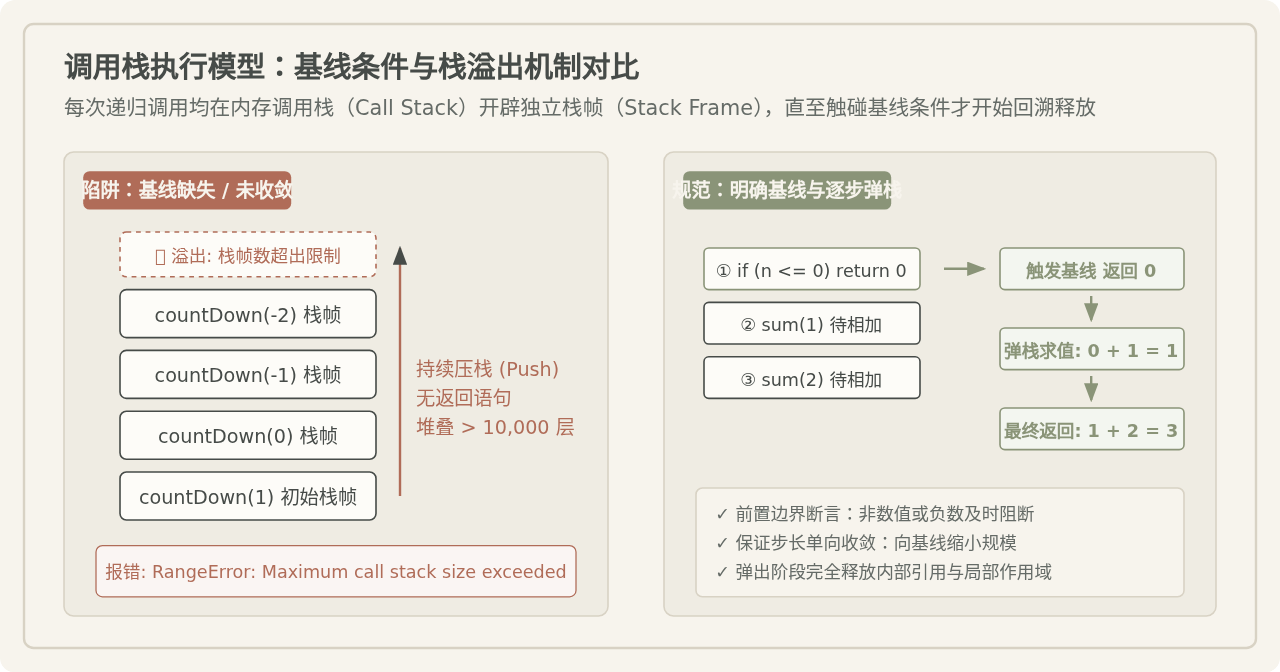
递归的本质是通过将问题分解为更小规模的同类子问题,并在达到不可再分的临界点时终止。这个临界点在算法中被称为基线条件(Base Case)。如果基线条件缺失、判定逻辑反向,或者入参在递归过程中没有严格朝向基线收敛,JavaScript 引擎的调用栈就会持续压栈,最终抛出致命错误:RangeError: Maximum call stack size exceeded。
1. 典型反例:方向错误与缺少防御性校验
很多开发者容易忽略“意外输入”对基线条件的破坏。例如下面的倒数打印函数,原本假设入参为正整数:
反例代码:脆弱的基线判断
// 脆弱写法:假定 n 一定会递减到 0
function countDown(n) {
  if (n === 0) {
    console.log("完成");
    return;
  }
  console.log(n);
  countDown(n - 1);
}

// 陷阱场景:当传入负数、浮点数或非数值类型时
countDown(-1);
// 结果:n 变为 -2, -3... 永远无法等于 0,瞬间触发栈溢出
在真实业务中,深层对象遍历(如根据 parentId 构建树形结构)也常发生此类问题。如果数据源存在“循环引用”(A 的父节点是 B,B 的父节点又是 A),递归将深陷死循环,调用栈在几十毫秒内被占满。
2. 防御方法:前置卫语句与循环引用检测
避免基线条件失效的标准策略包含两个动作:区间卫语句断言与路径记忆防环。
规范代码:严密的防御式递归
// 1. 数值类递归:采用范围判定取代全等判定
function safeCountDown(n) {
  // 卫语句:拦截非数字及非安全边界
  if (typeof n !== "number" || !Number.isFinite(n) || n <= 0) {
    console.log("完成或非法入参终止");
    return;
  }
  console.log(Math.floor(n));
  safeCountDown(Math.floor(n) - 1);
}

// 2. 对象树遍历:利用 WeakSet 追踪访问轨迹,阻断死循环
function deepTraverse(node, visited = new WeakSet()) {
  if (!node || typeof node !== "object") return;

  // 检测循环引用
  if (visited.has(node)) {
    console.warn("检测到循环引用,已跳过节点");
    return;
  }
  visited.add(node);

  console.log("正在处理节点:", node.name || "未命名");

  if (Array.isArray(node.children)) {
    for (const child of node.children) {
      deepTraverse(child, visited);
    }
  }
}
注意:在 V8 引擎(Chrome、Node.js)中,函数的最大调用栈深度通常在 10,000 层左右。对于层级极深(例如几万级链表)的场景,即使基线条件完全正确,依然会触发物理栈溢出。此时应选择迭代循环加显式数组栈,或使用文末介绍的蹦床函数。
二、重叠子问题引发的指数级计算性能爆炸
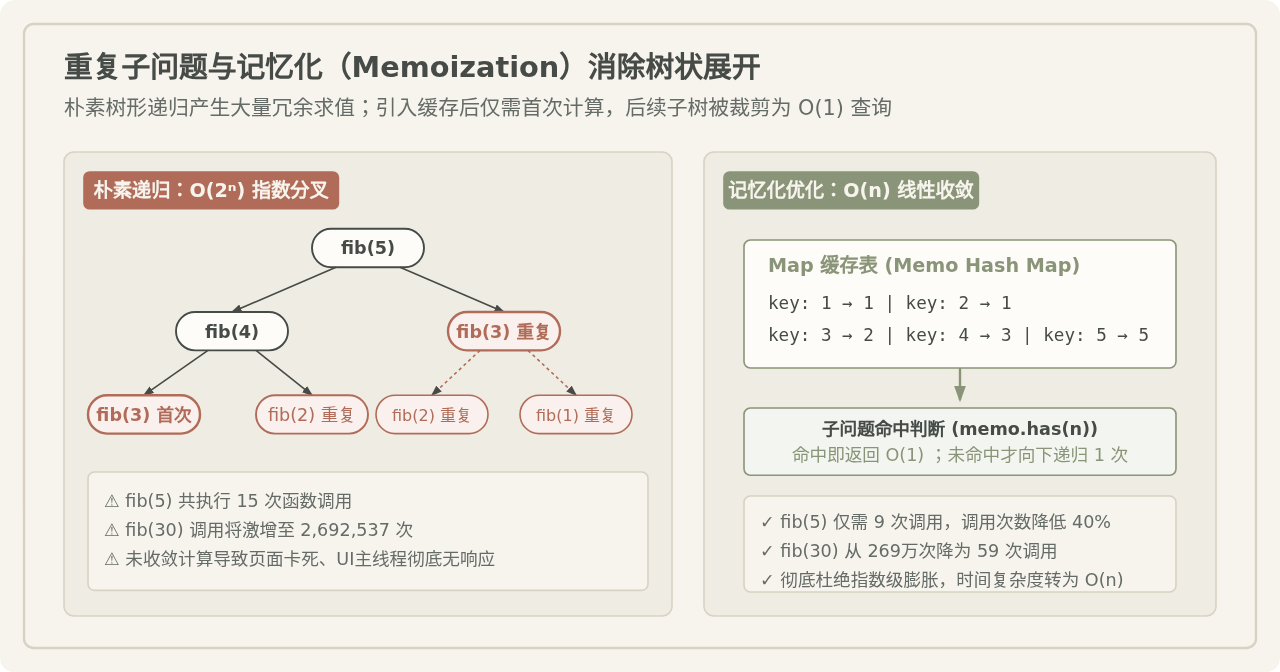
递归在处理分支结构(如分治法、树形拆解)时,极容易产生大量重叠子问题(Overlapping Subproblems)。若不对已计算的结果进行存储,相同的子树会被成千上万次重复执行,导致时间复杂度从线性 $O(n)$ 骤升至指数级 $O(2^n)$。
1. 典型反例:朴素斐波那契与树分支求值
斐波那契数列是展现重叠子问题最直观的例子。代码极其精炼,但运行开销呈几何倍数扩大:
反例代码:无缓存的分支递归
function fib(n) {
  if (n <= 0) return 0;
  if (n === 1) return 1;
  return fib(n - 1) + fib(n - 2);
}

console.time("fib(40)");
fib(40); // 浏览器主线程将直接卡死 1~3 秒,函数调用次数超过 3 亿次!
console.timeEnd("fib(40)");
在前端业务中,这种陷阱多发生在“多层联动权限过滤”、“商品属性全组合计算”或“动态表单校验链”中。当递归分支因子大于 1 时,输入稍微增加,CPU 利用率即被占满,界面失去响应。
2. 防御方法:记忆化搜索(Memoization)与自底向上递推
解决重叠子问题的标准方式是在递归外部挂载哈希缓存表(Map),确保每一个参数对应的结果在生命周期内只计算一次;或彻底将“自顶向下递归”重构为“自底向上循环递推”。
规范代码:Map 记忆化包装器
// 通用记忆化高阶函数
function memoize(fn) {
  const cache = new Map();
  return function (...args) {
    const key = JSON.stringify(args);
    if (cache.has(key)) {
      return cache.get(key);
    }
    const result = fn.apply(this, args);
    cache.set(key, result);
    return result;
  };
}

// 经过记忆化的斐波那契函数
const memoFib = memoize(function(n) {
  if (n <= 0) return 0;
  if (n === 1) return 1;
  return memoFib(n - 1) + memoFib(n - 2);
});

console.log(memoFib(40)); // 耗时不到 1 毫秒,计算次数仅 40 次左右
三、深层递归中的闭包强引用与内存滞留
许多开发者认为只要没有栈溢出,递归就是安全的。然而,如果在递归过程中不断创建局部高阶函数、事件监听器,或者把大型数据结构直接置于外层闭包被内层递归引用,整个递归链条上的全部栈帧上下文都将无法被 V8 垃圾回收器(Garbage Collector)回收。
1. 典型反例:内层闭包捕获与未清理的中间状态
在批量处理深层数据时,如果在递归函数内部反复定义闭包,或者把一个大数组挂在外层作用域并在每层递归中做拷贝,内存占用将随着递归深度线性累加:
反例代码:闭包捕获大对象与频繁浅拷贝
// 内存隐患写法
function processTreeNodes(node) {
  const heavyDataBuffer = new Array(10000).fill("payload"); // 模拟局部大内存

  function walk(current) {
    if (!current) return;

    // 闭包间接捕获了 heavyDataBuffer 的上下文
    console.log(current.id, heavyDataBuffer.length);

    if (current.children) {
      for (const child of current.children) {
        walk(child); // 在深层遍历完成前,所有上一级 heavyDataBuffer 都无法释放
      }
    }
  }

  walk(node);
}
2. 防御方法:纯函数传参与扁平化状态流动
编写递归时应遵循纯函数(Pure Function)原则,确保函数的所有依赖都通过显式参数传入,避免产生任何无意捕获外层变量的闭包。对超深层的大型树结构,推荐使用扁平化迭代器进行流式解耦处理。
规范代码:解耦上下文的纯粹迭代处理
// 使用纯函数参数传递,不产生隐性环境闭包
function transformNode(node, context) {
  if (!node) return null;

  // 业务转换逻辑
  const result = {
    id: node.id,
    title: node.name,
    depth: context.depth
  };

  if (Array.isArray(node.children)) {
    // 显式将结果向下收集,避免在作用域中挂载长生命周期缓冲
    result.children = node.children.map(child =>
      transformNode(child, { depth: context.depth + 1 })
    );
  }

  return result;
}
四、异步递归(Promise / async)中的时序穿透与失控
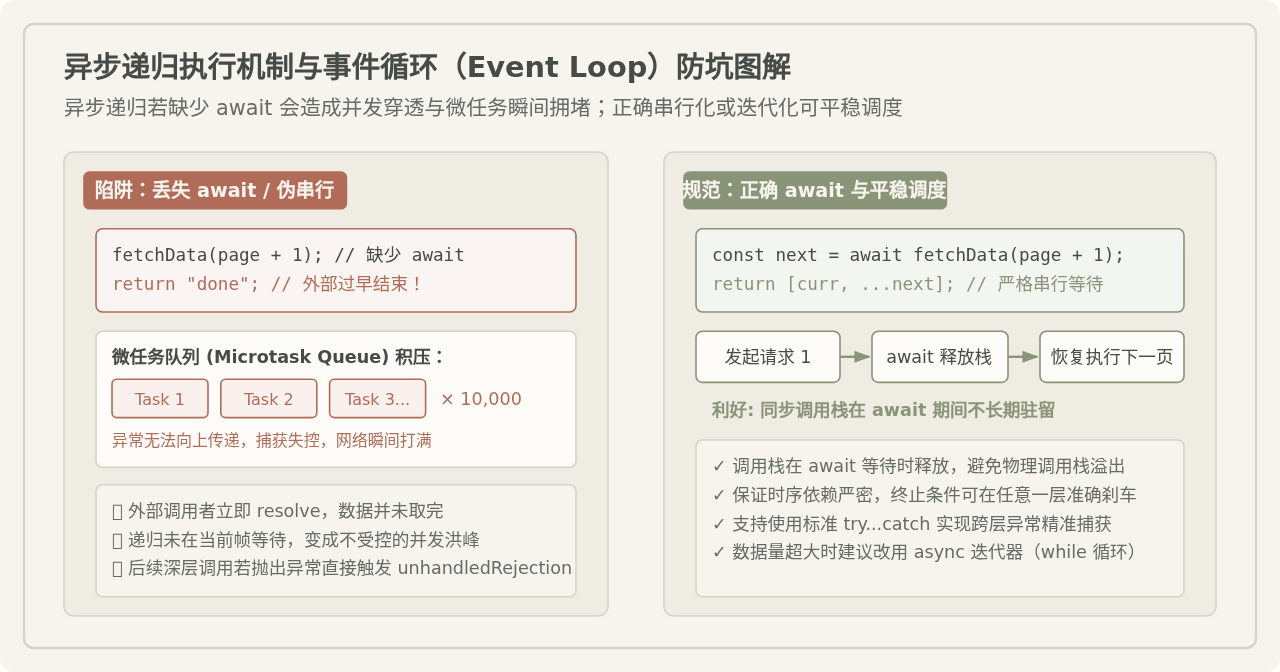
随着前后端全栈应用的发展,利用递归处理“分页拉取”、“轮询接口直至状态就绪”等异步任务变得极其普遍。但异步递归与同步递归在执行机制上有本质不同:如果在 async 函数中调用自身时遗漏了 await,递归将失去顺序等待约束,造成并发穿透。
1. 典型反例:丢失 await 导致的伪串行与微任务洪峰
反例代码:无控制的异步递归
// 常见错误:轮询或分页拉取
async function pollOrderStatus(orderId, attempt = 1) {
  const res = await mockApiCheck(orderId);

  if (res.status === "SUCCESS") {
    return res.data;
  }

  if (attempt > 5) {
    throw new Error("超时重试超限");
  }

  // 致命错误:递归调用自身时缺少 await
  pollOrderStatus(orderId, attempt + 1);

  // 外部调用者拿到的是 undefined,后续的错误也无法被外层 catch 捕获!
}
当缺少 await 时,外层函数在执行完当前微任务后立刻 resolve 退出,返回 undefined。而内层的后续递归依然在后台不可控地发起网络请求,一旦后续出现网络报错,将触发全局未捕获的 UnhandledPromiseRejection。
2. 防御方法:严格 await 串联与异步迭代替代
异步递归必须保证每一层返回的 Promise 都被上一层正确接入。对于高频或长周期轮询,更推荐使用 while(true) 搭配 await,从根本上杜绝递归层级过深的风险。
规范代码:严密串行的异步递归与循环替代
// 方案 A:正确的 async 递归链式传递
async function safePoll(orderId, attempt = 1, maxAttempts = 5) {
  if (attempt > maxAttempts) {
    throw new Error("超出最大重试次数");
  }

  const result = await mockApiCheck(orderId);
  if (result.status === "SUCCESS") {
    return result.data;
  }

  // 等待延迟
  await new Promise(resolve => setTimeout(resolve, 1000));

  // 必须严格 return await,确保 Promise 链完整且支持异常捕获
  return await safePoll(orderId, attempt + 1, maxAttempts);
}

// 方案 B(更推荐):用基于 while 的异步循环替代递归
async function pollWithLoop(orderId, maxAttempts = 5) {
  for (let attempt = 1; attempt <= maxAttempts; attempt++) {
    const res = await mockApiCheck(orderId);
    if (res.status === "SUCCESS") return res.data;

    if (attempt < maxAttempts) {
      await new Promise(r => setTimeout(r, 1000));
    }
  }
  throw new Error("轮询超时未就绪");
}
五、深度辨析:关于“尾递归优化”的认知误区
在许多函数式编程教程中,经常推荐一种说法:“只要把递归改写为尾递归(Tail Call Optimization, TCO),调用栈就不会溢出”。这个说法在理论上非常优雅,但在当下的 JavaScript 工程环境中,却是一个极易导致生产事故的认知陷阱。
现实情况:ECMAScript 2015 (ES6) 规范虽然在严格模式下定义了尾调用优化,但绝大多数主流 JavaScript 引擎(包括 Chrome/V8、Node.js、Firefox/SpiderMonkey)并未在生产环境中开启或保留此特性(仅 WebKit/Safari 实现了受限支持)。原因是引擎团队发现,静默消除栈帧会导致调试时堆栈信息(Stack Trace)丢失、错误定位困难,并且在特定内联优化下存在性能权衡。
因此,在生产环境中千万不能依赖“尾递归消除栈溢出”。如果你面临超深调用(深度 > 10,000),真正的工业级解决方案是:蹦床函数(Trampoline)或显式数组模拟调用栈。
工业级解法:蹦床模式彻底消除栈增长
// 蹦床工具函数:将递归拆解为单步函数执行,栈深始终保持为 1
function trampoline(fn) {
  return function (...args) {
    let result = fn(...args);
    while (typeof result === "function") {
      result = result();
    }
    return result;
  };
}

// 编写支持延迟执行的递归逻辑
function safeLargeSum(n, acc = 0) {
  if (n <= 0) return acc;
  // 不直接递归调用,而是返回一个闭包(Thunk),交由循环在单层栈中执行
  return () => safeLargeSum(n - 1, acc + n);
}

const sum = trampoline(safeLargeSum);

// 此时计算 1,000,000 次累加,完全不会发生栈溢出!
console.log(sum(1000000)); // 500000500000,平稳运行
六、工程落地:递归写法防御性设计检查清单
在实际编写或 Code Review 涉及递归的业务代码时,可按照以下决策流程表逐项核对,确保代码在任何边界条件下均具备自愈与阻断能力。
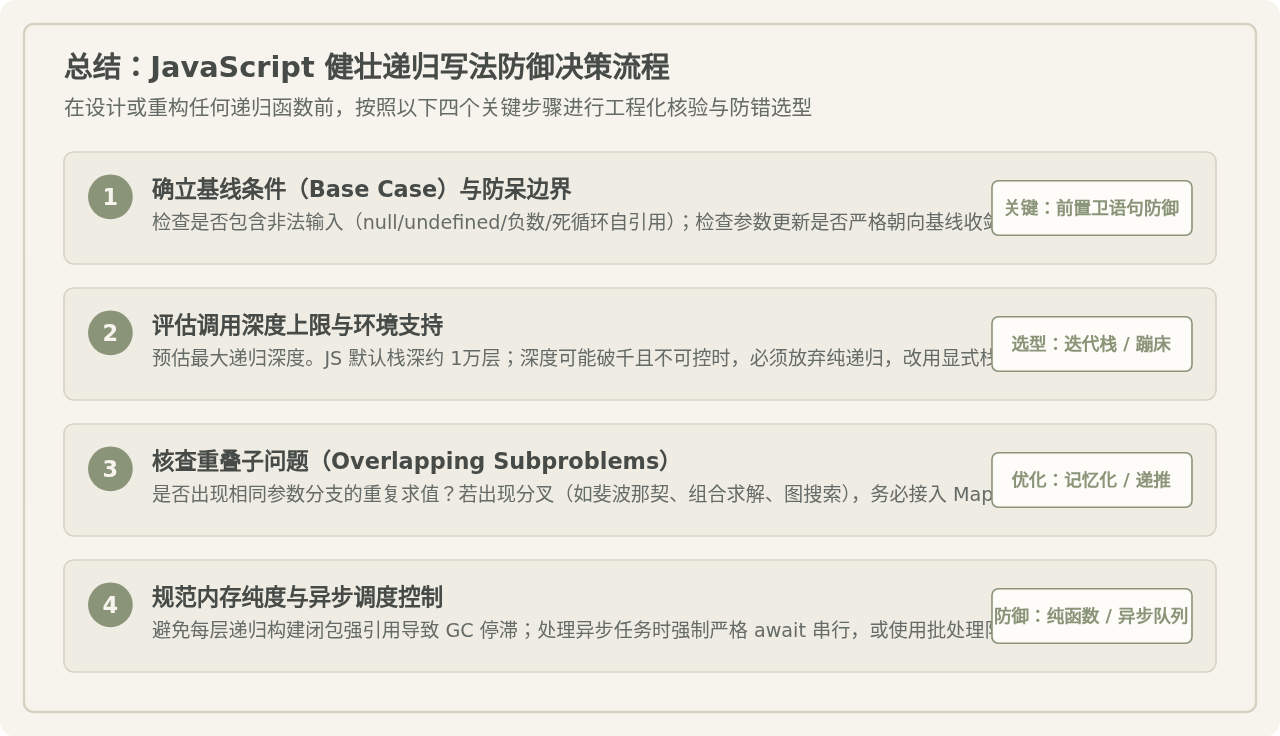
| 核对维度 | 高危特征 | 标准防御规范 |
|---|---|---|
| 1. 基线条件 | 全等判定(n === 0)、缺乏非空判断、对非法数据无前置兜底 |
采用不等式范围判定(n <= 0),函数开头统一采用卫语句阻断非法入参。 |
| 2. 递归深度 | 业务数据嵌套深度可能随用户操作无限增加(如无限极分类) | 评估层级。若可能突破 5,000 层,坚决放弃纯递归,改用循环迭代或蹦床函数。 |
| 3. 重复子问题 | 递归函数调用自身多次(如 f(n-1) + f(n-2)),存在分支交叉 |
引入 Map 记忆化缓存中间计算结果,或者转用自底向上的动态规划求解。 |
| 4. 引用与闭包 | 递归内部构建大对象,或捕获外层作用域中的重型数组/DOM 引用 | 保持纯函数传参,避免闭包长久驻留;对象图遍历使用 WeakSet 阻断环状引用。 |
| 5. 异步调用 | 递归调用 async 函数时没有 await 或没有 return |
必须书写 return await fn(),或者重构为 while 循环结合 await。 |
总结而言,递归并不是越深越好,也不是写法越简短越高级。在 JavaScript 的运行时生态中,理解底层的调用栈预算、垃圾回收周期与微任务执行队列,采取保守、严密的前置卫语句与缓存策略,才能充分发挥递归的抽象威力,同时保证系统在高并发、大数据集场景下的绝对稳定。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章