

深入讲解在JavaScript中利用DataView解析紧凑二进制协议与C语言内存结构体的方法,涵盖端序控制、非对齐内存访问、偏移量映射及通用解析器实现。
JS解析二进制协议:用DataView映射内存结构体
作者:拾光
时间:2026-11-18
浏览:540
文章目录
在 JavaScript 中解析紧凑的二进制网络协议或 C 语言内存结构体,核心路径是在底层的
ArrayBuffer 上建立 DataView 视图,通过显式指定字节偏移量(byteOffset)与大小端序(littleEndian),直接将一段物理内存映射为具有语义的结构化对象。本文将完整梳理其内在机理、偏移量计算规则以及工程级映射实现。
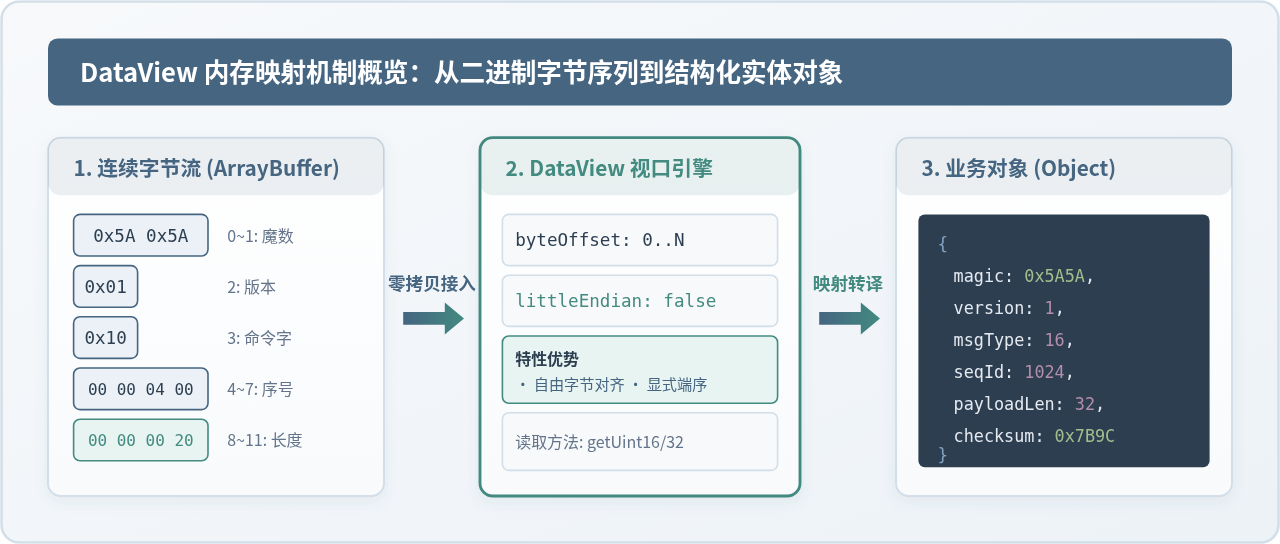
图 0:DataView 内存映射机制概览(从物理字节流到业务对象)
一、为什么必须使用 DataView 而非普通 TypedArray?
在 Node.js 服务端或浏览器 WebSocket/WebTransport 通信场景中,接收到底层的二进制数据形式通常是 ArrayBuffer 或 Uint8Array。很多初学者习惯直接借助 Uint32Array 或 Uint16Array 读取数值,但在面对工业级私有协议、嵌入式 IoT 通信或游戏二进制数据包时,这种方式往往会立即崩溃。其核心原因集中在以下三个层面:
1. 内存对齐(Alignment)硬性约束
在 ECMAScript 规范中,类型化数组(TypedArray)要求其视图的起始字节偏移量(byteOffset)必须是对应元素宽度的整数倍。例如,new Uint32Array(buffer, byteOffset) 中的 byteOffset 必须是 4 的整数倍;new Uint16Array(buffer, byteOffset) 必须是 2 的整数倍。
然而在网络传输协议中,为了追求极致带宽利用率,通常会使用类似于 C 语言 #pragma pack(1) 的单字节紧凑对齐格式。例如前 2 个字节是包头魔数,紧随其后的第 3 字节是命令字,而第 4 字节(偏移量为 3)便开始存放一个 4 字节的整数序列号。如果尝试在偏移量 3 处实例化 Uint32Array,JavaScript 引擎会直接抛出 RangeError: start offset of Uint32Array should be a multiple of 4 错误。而 DataView 专为未对齐内存设计,允许在任意字节偏移量执行读取,完全解除对齐限制。
2. 网络端序(Endianness)可控性
计算机硬件中多字节数值的存放顺序分为大端序(Big-Endian,高位字节排在低地址)与小端序(Little-Endian,低位字节排在低地址)。主流 PC 与移动端 CPU 均为小端架构,因此 TypedArray 默认强制使用宿主系统的原生字节序。
但是,绝大多数标准的网络协议以及 C 语言网络通信库,默认规定使用“网络字节序”(即大端序)。如果使用 TypedArray 直接读取网络大端数据,读出的数值将完全颠倒混乱。DataView 的每一个多字节读写方法(如 getUint16、getUint32、getFloat64 等)都显式提供了第二个布尔参数 littleEndian,传入 false 即可强制大端读取,传入 true 则为小端读取,这让协议解析拥有了绝对的确定性。
3. 异构字段混合解析能力
真实的二进制协议包头从来不是全为 32 位整数的单一数组,而是由单字节标志位、双字节枚举值、四字节长度、四字节浮点数等异构字段拼装而成的结构体。使用统一的 DataView 实例,开发者无需反复切片分配新的内存视图,便可在一个缓冲区内连续交替读取不同宽度的字段。
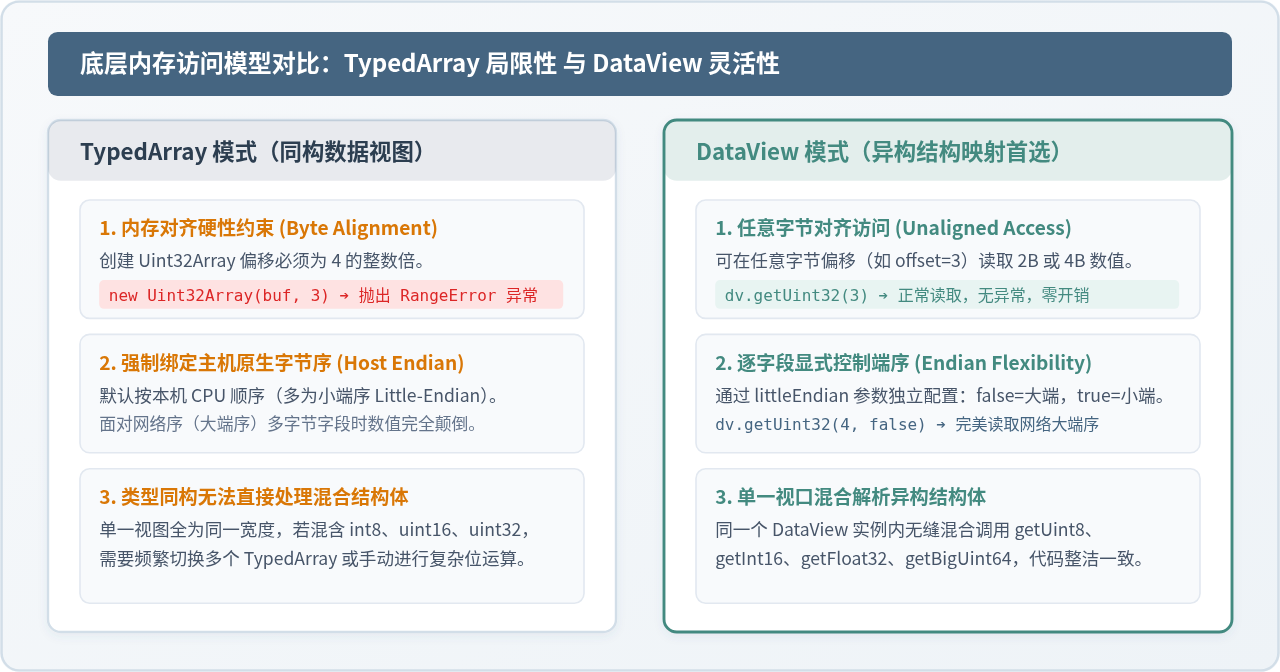
图 1:TypedArray 访问模型局限性与 DataView 异构解析优势对比
二、典型协议头结构体设计与内存偏移量计算
为了具体展示映射过程,我们定义一个在生产环境中极具代表性的 16 字节定长二进制协议头。在 C 语言通信服务端中,该结构体通常定义如下:
// C语言紧凑排列结构体示例
#pragma pack(push, 1)
struct PacketHeader {
    uint16_t magic;        // 2 字节:固定魔数 0x5A5A,用于校验包头合法性
    uint8_t  version;      // 1 字节:协议版本号,例如 1
    uint8_t  msg_type;     // 1 字节:命令字/业务类型,例如 0x10
    uint32_t seq_id;       // 4 字节:请求序列号,网络大端序
    uint32_t payload_len;  // 4 字节:后续数据体(Payload)的字节长度
    uint32_t checksum;     // 4 字节:整个数据包的 CRC32 校验和
}; // 总大小正好为 16 字节
#pragma pack(pop)
要在 JavaScript 中准确解析上述结构体,最关键的前提是推导出每一个字段在缓冲区中的精确起始偏移量(Byte Offset)。具体映射对应关系如下表所示:
| 字段名称 | C 数据类型 | 字节大小 | 起始偏移 (Offset) | DataView 读取方法 | 字节序 (Endian) |
|---|---|---|---|---|---|
magic |
uint16_t |
2 字节 | 0 (0x00) | view.getUint16(0, false) |
大端序 (false) |
version |
uint8_t |
1 字节 | 2 (0x02) | view.getUint8(2) |
单字节无端序 |
msg_type |
uint8_t |
1 字节 | 3 (0x03) | view.getUint8(3) |
单字节无端序 |
seq_id |
uint32_t |
4 字节 | 4 (0x04) | view.getUint32(4, false) |
大端序 (false) |
payload_len |
uint32_t |
4 字节 | 8 (0x08) | view.getUint32(8, false) |
大端序 (false) |
checksum |
uint32_t |
4 字节 | 12 (0x0C) | view.getUint32(12, false) |
大端序 (false) |
payload |
uint8_t[] |
变长 (N) | 16 (0x10) | new Uint8Array(buf, 16, len) |
连续二进制字节块 |
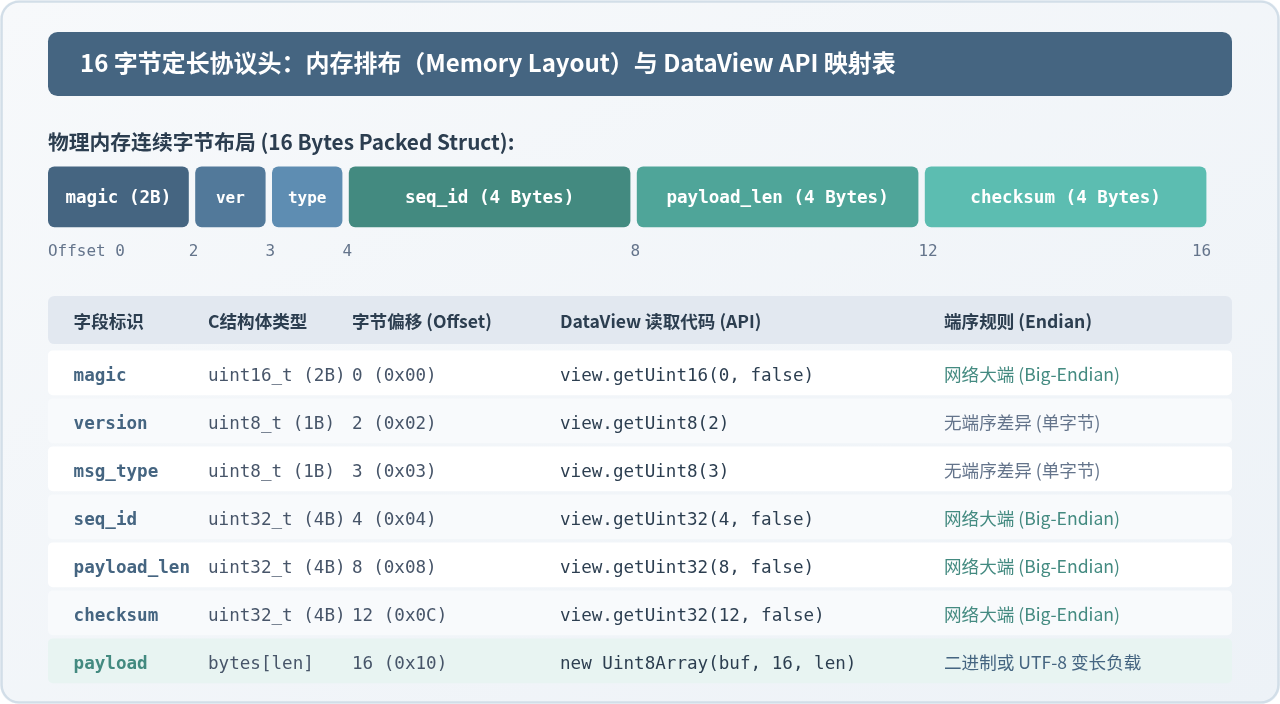
图 2:16 字节协议头物理排布与 DataView 偏移量映射示意
三、从二进制字节流到业务对象的完整解析步骤
将一段接收到的底层数据解析为 JavaScript 业务对象,通常分为五个不可遗漏的操作步骤。
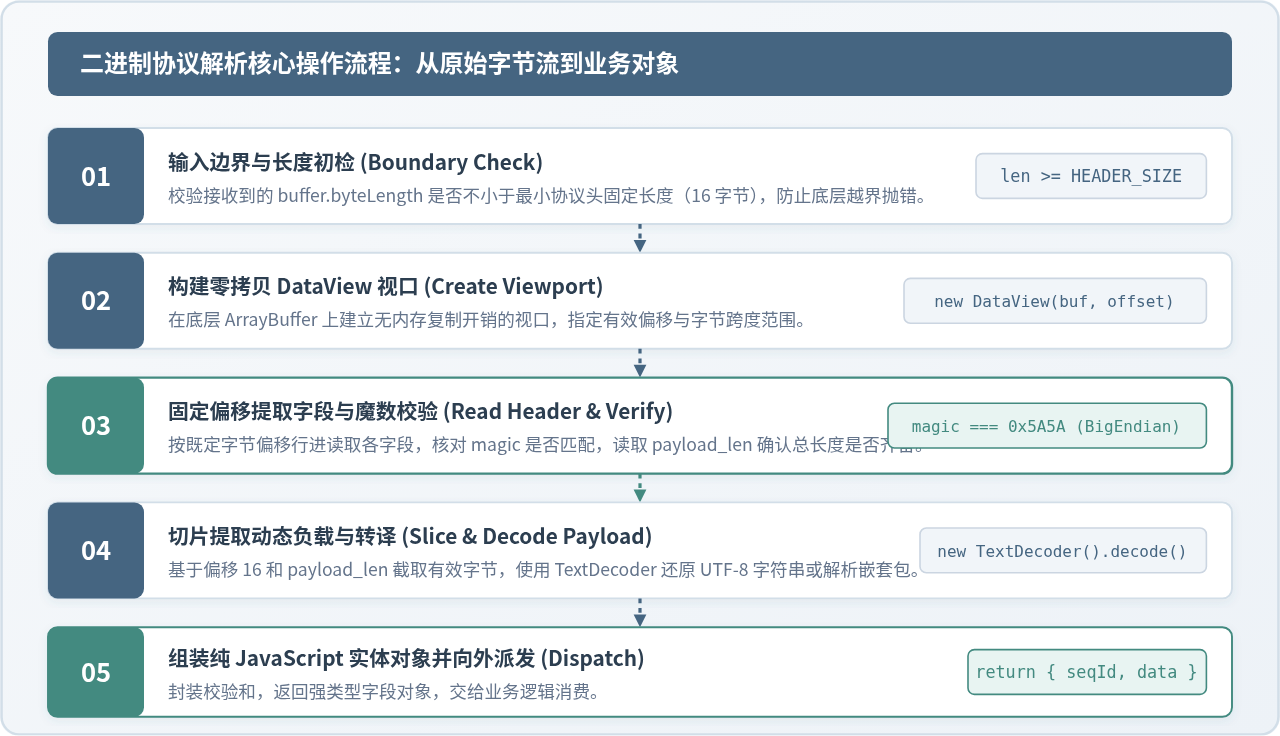
图 3:二进制协议解析核心操作流程图
第 1 步:输入边界检查与防截断保护
网络传输中极易出现 TCP 分包或未完全接收的情况。在开始任何读取操作前,必须首先校验缓冲区总长度是否达到协议头的最小尺寸(本文例中为 16 字节)。若长度不足,应保留当前缓冲区并等待后续分包到达,绝不能强行调用 getUint*,否则会抛出 RangeError: Offset is outside the bounds of the DataView。
第 2 步:创建轻量级 DataView 视口
通过 new DataView(buffer, byteOffset, byteLength) 建立视口。这一步纯粹是给现存内存创建了一个操作游标,完全是零拷贝的,不会产生额外的内存分配开销。在长连接高频通信中,这种零开销特性对 GC(垃圾回收)非常友好。
第 3 步:固定偏移读取包头与魔数核对
使用指定偏移读取魔数字段,与协议约定的常数(例如 0x5A5A)比对。如果魔数不符,表明遇到了协议失真或未知协议攻击,应立即阻断处理并关闭连接,避免后续无效解析浪费 CPU 资源。
第 4 步:动态切片与字符串/变长数据转译
根据包头中读取到的 payload_len,核实当前数据包是否已经完整包含了数据体。若完整,则使用 new Uint8Array(buffer, 16, payloadLen) 提取数据体切片,再通过现代浏览器和 Node.js 原生内置的 TextDecoder API,将二进制数据无缝还原为 UTF-8 字符串或 JSON 对象。
第 5 步:校验和校验与装配强类型对象
对提取出的字段和有效载荷进行校验和验证,确认无误后,组装成结构规范的 JavaScript 实体对象并向业务逻辑层分发。
四、工程实战代码:编写通用的结构体映射解析器
下面给出一套在浏览器和 Node.js 环境中均可直接运行的完整代码。代码包含手写直接映射函数、以及通过 ArrayBuffer 构建模拟二进制报文进行实测验证的流程。
// ==========================================
// 1. 结构体解析核心函数
// ==========================================
const HEADER_SIZE = 16;
const PROTOCOL_MAGIC = 0x5A5A;

/**
 * 解析二进制报文,将其映射为结构化业务对象
 * @param {ArrayBuffer} buffer - 接收到的二进制缓冲区
 * @param {number} byteOffset - 解析起始偏移,默认为 0
 * @returns {object} 结构体字段及业务载荷
 */
function parsePacket(buffer, byteOffset = 0) {
    const availableBytes = buffer.byteLength - byteOffset;
    if (availableBytes < HEADER_SIZE) {
        throw new Error(`缓冲区长度不足: 期待至少 ${HEADER_SIZE} 字节,实际仅 ${availableBytes} 字节`);
    }

    // 在指定内存段上创建 DataView 视图(零内存克隆)
    const view = new DataView(buffer, byteOffset, availableBytes);

    // 1. 读取 2 字节魔数 (大端序)
    const magic = view.getUint16(0, false);
    if (magic !== PROTOCOL_MAGIC) {
        throw new Error(`非法数据包: 魔数不匹配 (期待 0x${PROTOCOL_MAGIC.toString(16)}, 收到 0x${magic.toString(16)})`);
    }

    // 2. 读取单字节版本与命令字
    const version = view.getUint8(2);
    const msgType = view.getUint8(3);

    // 3. 读取 4 字节序列号与数据长度 (大端序)
    const seqId = view.getUint32(4, false);
    const payloadLen = view.getUint32(8, false);

    // 4. 读取 4 字节校验和 (大端序)
    const checksum = view.getUint32(12, false);

    // 5. 校验数据体是否完整
    const totalRequired = HEADER_SIZE + payloadLen;
    if (availableBytes < totalRequired) {
        throw new Error(`分包未齐备: 期待总包长 ${totalRequired} 字节,当前仅 ${availableBytes} 字节`);
    }

    // 6. 提取变长负载切片并解码为 UTF-8 字符串
    const payloadBytes = new Uint8Array(buffer, byteOffset + HEADER_SIZE, payloadLen);
    const decoder = new TextDecoder('utf-8');
    const payloadText = decoder.decode(payloadBytes);

    return {
        header: {
            magic: '0x' + magic.toString(16).toUpperCase(),
            version,
            msgType,
            seqId,
            payloadLen,
            checksum: '0x' + checksum.toString(16).toUpperCase()
        },
        payload: payloadText,
        totalBytes: totalRequired
    };
}

// ==========================================
// 2. 模拟二进制打包与运行验证
// ==========================================
function createSamplePacket() {
    const text = "Hello Binary Protocol!";
    const encoder = new TextEncoder();
    const payloadBytes = encoder.encode(text);
    const totalLength = HEADER_SIZE + payloadBytes.byteLength;

    // 分配连续物理内存
    const buffer = new ArrayBuffer(totalLength);
    const view = new DataView(buffer);

    // 写入结构体字段 (序列化)
    view.setUint16(0, 0x5A5A, false); // magic
    view.setUint8(2, 1);              // version = 1
    view.setUint8(3, 0x10);           // msgType = 16 (心跳/登录)
    view.setUint32(4, 10001, false);  // seqId = 10001
    view.setUint32(8, payloadBytes.byteLength, false); // payload_len
    view.setUint32(12, 0xABCD1234, false);            // 模拟校验和

    // 写入变长 Payload 字节
    const bodyView = new Uint8Array(buffer, HEADER_SIZE, payloadBytes.byteLength);
    bodyView.set(payloadBytes);

    return buffer;
}

// 执行测试
const packetBuffer = createSamplePacket();
const result = parsePacket(packetBuffer);
console.log("解析结果:", JSON.stringify(result, null, 2));
示例运行输出结果(Console Output 示例)
{
  "header": {
    "magic": "0x5A5A",
    "version": 1,
    "msgType": 16,
    "seqId": 10001,
    "payloadLen": 22,
    "checksum": "0xABCD1234"
  },
  "payload": "Hello Binary Protocol!",
  "totalBytes": 38
}
五、声明式 Schema 映射器:告别重复样板代码
当协议结构体包含几十个字段,或者协议版本频繁更迭时,手写大量的 view.getUint32(offset) 不仅容易将偏移量算错一位,而且维护成本极高。在大型工程中,推荐采用**声明式 Schema** 方式来定义内存结构:
// 声明式协议定义模式
const PacketSchema = [
    { name: 'magic',      type: 'Uint16',  endian: 'be' },
    { name: 'version',    type: 'Uint8'                 },
    { name: 'msgType',    type: 'Uint8'                 },
    { name: 'seqId',      type: 'Uint32',  endian: 'be' },
    { name: 'payloadLen', type: 'Uint32',  endian: 'be' },
    { name: 'checksum',   type: 'Uint32',  endian: 'be' }
];

// 类型大小查找字典
const TYPE_SIZES = {
    'Uint8': 1, 'Int8': 1,
    'Uint16': 2, 'Int16': 2,
    'Uint32': 4, 'Int32': 4, 'Float32': 4,
    'BigUint64': 8, 'BigInt64': 8, 'Float64': 8
};

function parseBySchema(schema, dataView, startOffset = 0) {
    const result = {};
    let currentOffset = startOffset;

    for (const field of schema) {
        const size = TYPE_SIZES[field.type];
        const isLittleEndian = field.endian === 'le';
        const methodName = `get${field.type}`;

        if (size > 1) {
            result[field.name] = dataView[methodName](currentOffset, isLittleEndian);
        } else {
            result[field.name] = dataView[methodName](currentOffset);
        }
        currentOffset += size;
    }

    return { data: result, nextOffset: currentOffset };
}
这种设计实现了结构定义与解析执行的解耦,只需调整 Schema 配置数组,即可无痛适配 C 语言结构体的增删字段。
六、工程落地与关键避坑指南
在实际使用 DataView 映射二进制结构体时,以下三个细节极易成为线上隐患,务必重点关注:
1. BigInt 64 位大整数的序列化限制
当协议包含 64 位时间戳或雪花算法 ID 时,必须使用 getBigUint64 或 getBigInt64。注意该方法返回的数据类型是原生 BigInt(例如 1700000000000n)。由于标准 JSON.stringify 默认不支持 BigInt,如果直接对解析后的对象执行序列化,会抛出 TypeError: Do not know how to serialize a BigInt。在存入业务对象前,建议将其转为字符串 val.toString() 或根据业务范围转为 Number。
2. 端序参数省略时的默认行为陷阱
在 ECMAScript 规范中,DataView.prototype.getUint32(offset, [littleEndian]) 的第二个参数如果省略,其默认值为 false(即默认使用大端序)。然而很多前端开发者直觉上习惯小端序,容易忘记显式传参导致读出错误数值。在团队开发中,强烈建议在代码中**始终显式写明** true 或 false,杜绝歧义。
3. 高频通信下的 GC 优化:复用 DataView 实例
在千万级消息吞吐的长连接网关中,如果每收到一个二进制数据包就执行一次 new DataView(...),将产生大量瞬时小对象,引发 V8 频繁触发垃圾回收(Minor GC),导致消息处理延迟抖动。优化方案是维护一个全局常驻的 DataView 实例,或者通过缓冲区池(Buffer Pool)机制,在同一块连续内存上仅调整 byteOffset 进行游标滑动读取。
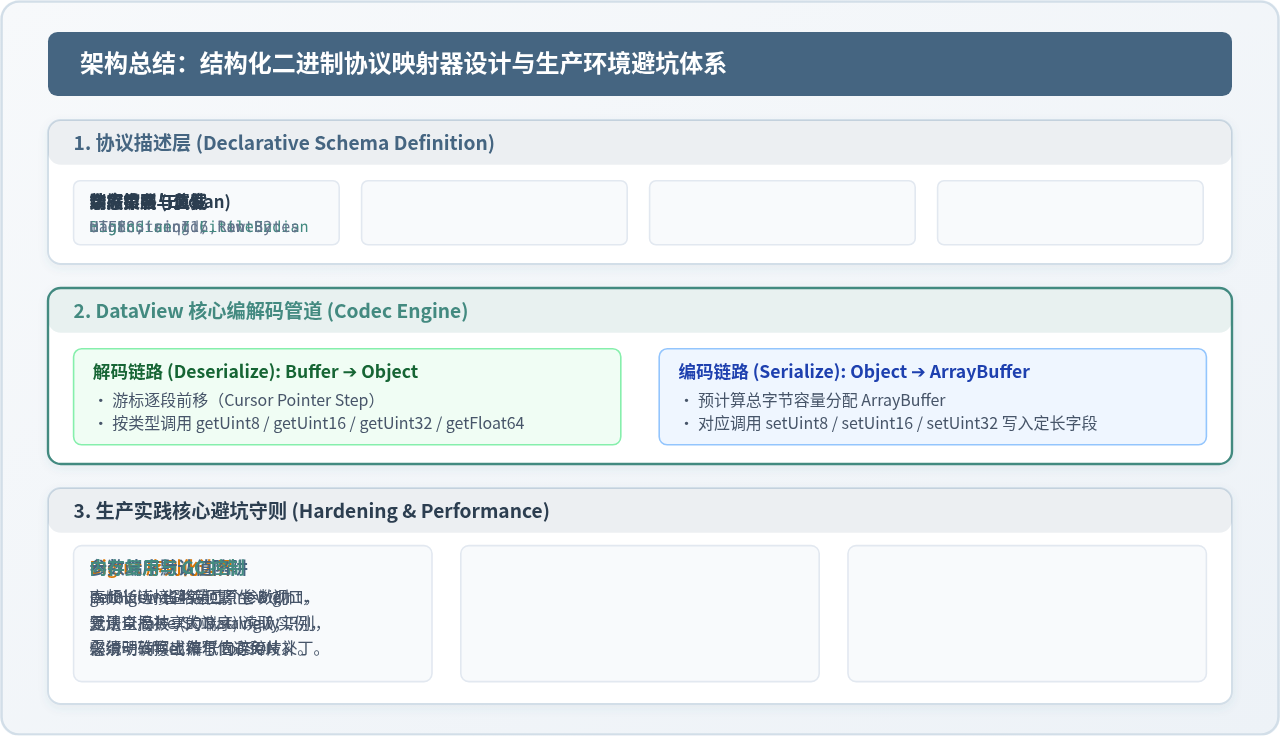
图 4:结构化二进制映射体系全景与生产优化守则
七、总结
DataView 是 JavaScript 运行时与原生二进制内存结构体之间最为安全、灵活的桥梁。它凭借**无对齐约束**、**多类型混读**以及**显式端序控制**三大核心特性,完美解决了 TypedArray 在处理 C 紧凑结构体时的致命缺陷。通过合理规划字段偏移量、结合 TextDecoder 处理变长数据,并在工程上抽象声明式 Schema,开发者可以编写出既高效健壮、又易于维护的二进制通信解析框架。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章