

深入讲解在 JavaScript 中使用 pako.js 解压 gzip 数据流的完整方案。涵盖 pako.Inflate 核心状态机机制、Fetch ReadableStream 与 WebSocket 分块推入实战、跨分块 UTF-8 字符解码及常见边界故障排查。
JS 怎么使用 pako.js 解压 gzip 数据流
作者:开源拾贝
时间:2026-11-05
浏览:90
文章目录
WEB API & BINARY DATA
在前端或 Node.js 环境中接收海量网络数据时,后端往往采用 gzip 压缩并以流式(Chunked Stream)分段发送。如果等待完整数据包下载完毕再解压,不仅会拉长首屏等待时间,还会使整块大文件瞬间挤占内存。使用 pako.js 提供的 pako.Inflate 状态机,结合 push(chunk, flag) 增量喂入分块,可以在数据到达的同时逐步解压出明文,实现高响应速度与低内存开销的数据流通。
一、核心认知:一次性解压与流式解压的差异
多数开发者初次接触 pako.js 时,习惯调用 pako.ungzip(buffer)。该方法是典型的“全量一次性”解压函数:它必须接收一个完整的、合法的 gzip 二进制包(包含头部头标、压缩数据体以及尾部 CRC 校验和),在内存中一次性分配足够的缓冲区来存放全部明文。
然而在以下场景中,一次性解压会遇到瓶颈甚至报错:
- 超大文件传输:例如几百兆的日志数据或高精度地图包,若整包下载并解压,需要同时持有压缩前与解压后的两份庞大内存,极易引发浏览器 Tab 页崩溃(Out of Memory)。
- 实时持续长流:例如 WebSocket 接收行情高频推送,或 HTTP Chunked 持续向客户端推送数据流。此时根本不存在所谓的“下载完毕时刻”,数据是持续涌现的。
- 首屏流式解析:例如获取大型 JSON 列表,前端希望收到前 100 条就立刻渲染表格,而不是等待完整 10 万条数据全部到达。
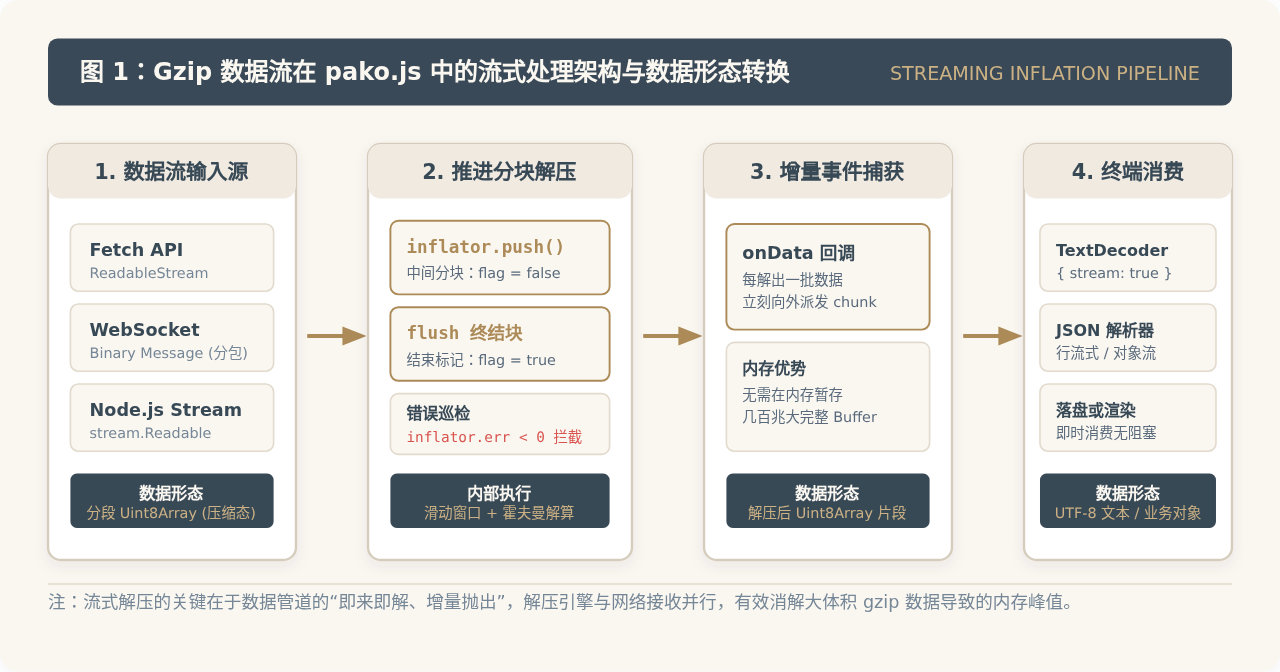
为了解决上述问题,必须使用 new pako.Inflate() 实例。它在内部维护了一个标准 zlib 滑动解压窗口,具备状态记忆能力。每当网络层抵达一个 Uint8Array 分片,便将其喂入解压机;解压机吐出当前分片产出的明文,随后释放临时输入缓存,使内存占用始终恒定在极小区间。
二、pako.Inflate 的流式 API 设计与生命周期
pako.Inflate 的流式解压完全建立在“推入模式(Push Model)”与“回调通知(Event Notification)”之上。掌握以下三个核心配置与方法,即可完成完整的流式接入:
1. 实例化与事件绑定
创建 pako.Inflate 实例时,建议通过 onData 监听每一批解压出的二进制片段:
JavaScript
import pako from 'pako';

// 初始化解压实例
const inflator = new pako.Inflate();

// 每次内部窗口有解压明文产出时,立即触发 onData
inflator.onData = (decompressedChunk) => {
  // decompressedChunk 是一个 Uint8Array
  console.log('解压出增量分块,字节长度:', decompressedChunk.length);
};

// 整个数据流完全解析并刷新结束时触发
inflator.onEnd = (status) => {
  console.log('解压状态机终结,状态码:', status); // 0 代表 Z_OK
};
为什么推荐让 onData 接收原始 Uint8Array,而不是配置 { to: 'string' }?
在纯英文字符场景下,配置 { to: 'string' } 虽能自动转成字符串,但 gzip 压缩流的分块边界是根据网络传输 MTU(通常 1.5KB 左右)或 TCP 窗口随机切断的。如果一个 3 字节的 UTF-8 中文字符恰好被切在分块边界,内部按单块转字符串就会产生 乱码。因此,更稳妥的做法是让 onData 派发 Uint8Array,配合原生 TextDecoder({ stream: true }) 进行流式字符拼装。
2. push 方法与 Flush 标志位
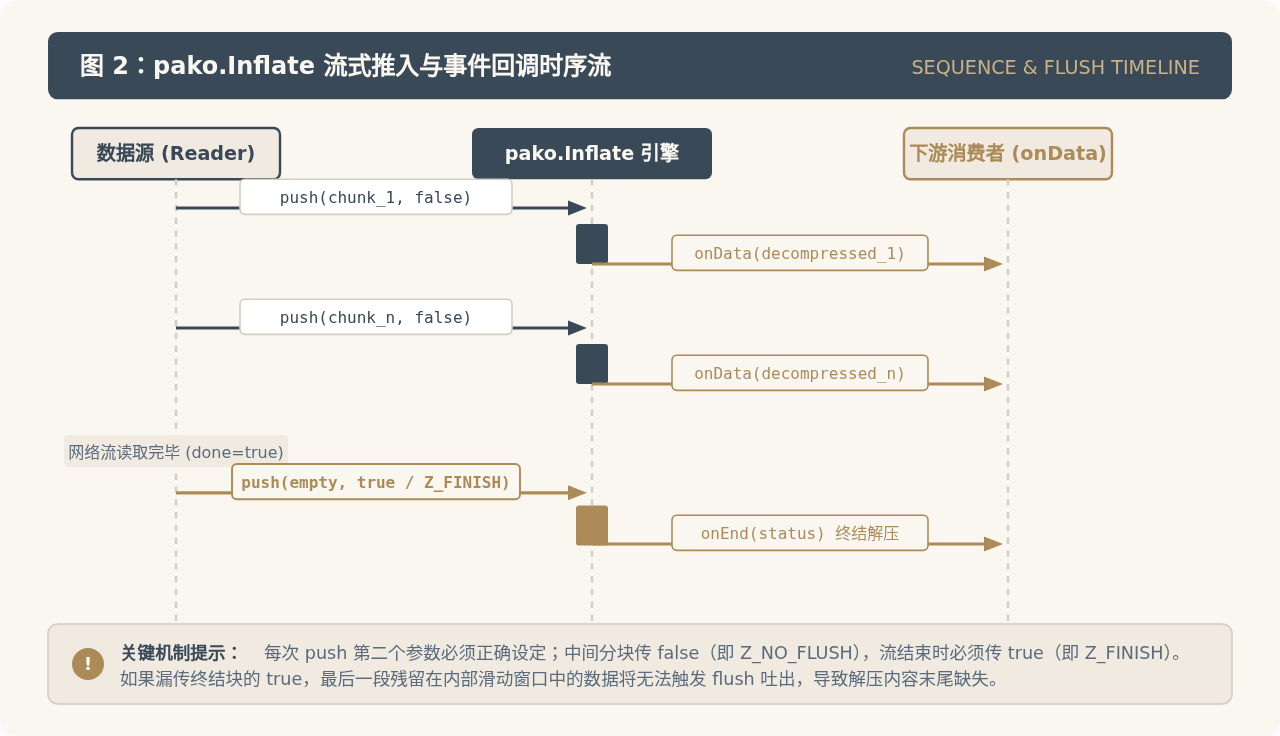
流式推进的关键是调用 inflator.push(chunk, flushMode)。第二个参数必须格外注意:
- 推入中间分块时:传入
false(对应底层宏pako.Z_NO_FLUSH或数值0)。此时解压机仅处理当前可用数据,如果末尾字节不足以构成一个完整的哈夫曼编码树符号,会暂存在滑动窗口中,等待后续数据。 - 数据流结束时:传入
true(对应底层宏pako.Z_FINISH或数值4)。通知解压机当前已是全流终点,必须将滑动窗口及缓冲区内所有剩余明文强行刷新吐出,并校验 CRC 尾部。
三、浏览器端实战:对接 Fetch ReadableStream
现代浏览器的 fetch API 返回的 response.body 是一个标准的 ReadableStream。如果后端响应头声明了非自动解压的 gzip 流(例如数据管道通过 application/octet-stream 传输被 gzip 压缩的超大 JSON/日志),前端可以通过 getReader() 循环读取分块,实现真正的边收边解。
JavaScript 完整实战代码
import pako from 'pako';

async function fetchAndDecompressGzipStream(url, onChunkReceived) {
  const response = await fetch(url);

  if (!response.ok) {
    throw new Error(`HTTP 异常: ${response.status} ${response.statusText}`);
  }

  // 1. 获取底层流读取器
  const reader = response.body.getReader();

  // 2. 构造流式解压引擎与 UTF-8 流解码器
  const inflator = new pako.Inflate();
  const textDecoder = new TextDecoder('utf-8');

  // 3. 订阅解压数据吐出事件
  inflator.onData = (chunk) => {
    // 注意:设置 stream: true,以保留分块截断处的 UTF-8 多字节字符状态
    const textSnippet = textDecoder.decode(chunk, { stream: true });
    onChunkReceived(textSnippet);
  };

  // 4. 循环读取网络分块并推入 pako
  try {
    while (true) {
      const { done, value } = await reader.read();

      if (done) {
        // 流已关闭,推入空分块并附带 true 标志位(Z_FINISH),冲刷末尾缓冲区
        inflator.push(new Uint8Array(0), true);

        // 刷新 TextDecoder 内部残留的最后一个多字节字符
        const finalSnippet = textDecoder.decode();
        if (finalSnippet) {
          onChunkReceived(finalSnippet);
        }
        break;
      }

      // value 为网络层抵达的 Uint8Array 片段
      inflator.push(value, false);

      // 实时检测解压机内部是否有错误标志
      if (inflator.err) {
        throw new Error(`pako 解压故障: [代码 ${inflator.err}] ${inflator.msg}`);
      }
    }
  } finally {
    reader.releaseLock();
  }
}

// 使用示例:边解压边打印
fetchAndDecompressGzipStream('/api/large-logs.gz', (textPiece) => {
  // 每一小段文本到达时触发,可以直接追加到 DOM 或行解析器
  process.stdout ? process.stdout.write(textPiece) : console.log(textPiece);
}).catch(console.error);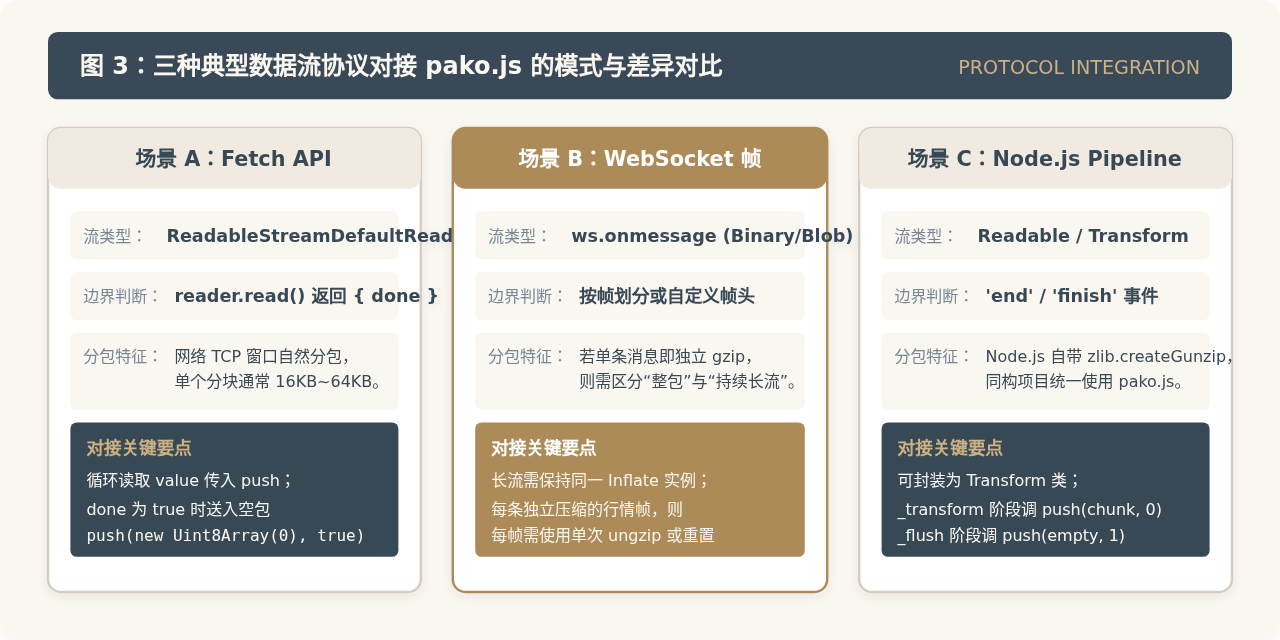
四、典型协议场景适配:WebSocket 与 Node.js
不同通信协议的分包语义存在本质区别,接入 pako.js 时必须采用对应的分包策略:
1. WebSocket 场景下的两种模式
- 模式 A(每帧独立压缩):多数金融实时行情 WebSocket 采用此方案。服务端将每条独立的 JSON 消息单独做 gzip,随后作为二进制帧推给客户端。此时不能共用同一个长期处于流式状态的
Inflate实例,而应针对每个MessageEvent使用pako.ungzip(event.data),或者在处理完毕后调用inflator.reset()。 - 模式 B(跨帧连续压缩长流):服务端建立 Deflate/Gzip 压缩流,在长连接生存期内持续向连接写入压缩数据,WebSocket 仅作为传输承载。此时客户端必须在连接开启时创建一个全局
inflator实例,每次onmessage时调用inflator.push(new Uint8Array(event.data), false),并在连接断开时推入true终结。
2. Node.js Stream 管道集成
在同构库或特定工具链中,如果需要在 Node.js 中将 pako.Inflate 包装成标准的 Transform 流,可以通过简单类封装实现与 pipeline() 的无缝对接:
JavaScript (Node.js Transform Adapter)
import { Transform } from 'stream';
import pako from 'pako';

export class PakoInflateStream extends Transform {
  constructor(options) {
    super(options);
    this.inflator = new pako.Inflate();

    // 当 pako 产出解压块时,通过 push 送入下游管道
    this.inflator.onData = (chunk) => {
      this.push(chunk);
    };
  }

  _transform(chunk, encoding, callback) {
    this.inflator.push(chunk, false);
    if (this.inflator.err) {
      return callback(new Error(`Pako error: ${this.inflator.msg}`));
    }
    callback();
  }

  _flush(callback) {
    // 管道结束,冲刷尾部
    this.inflator.push(new Uint8Array(0), true);
    if (this.inflator.err) {
      return callback(new Error(`Pako flush error: ${this.inflator.msg}`));
    }
    callback();
  }
}
五、生产环境高发故障与排查清单
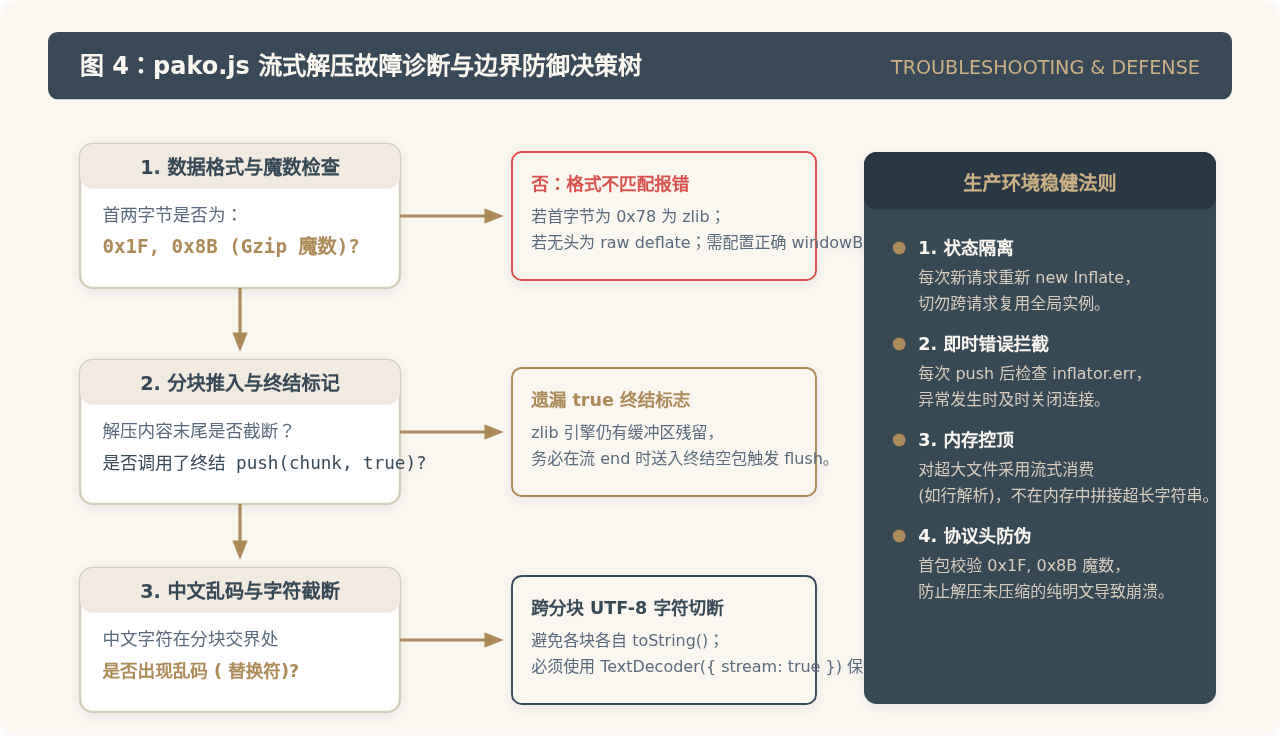
在使用 pako.js 进行流式解压的过程中,常见的问题多由格式混淆、生命周期遗漏及多字节字符截断引起。以下是关键的排查与防护措施:
1. 格式魔数不匹配:0x1F, 0x8B 校验
标准 gzip 格式的文件头前两字节固定为 0x1F, 0x8B。在收到第一个网络分块时,推荐先做快速校验:
JavaScript
function isGzipHeader(chunk) {
  if (!chunk || chunk.length < 2) return false;
  return chunk[0] === 0x1F && chunk[1] === 0x8B;
}
如果魔数是 0x78, 0x9C 或 0x78, 0x01,说明服务端采用的是 zlib 封装而不是 gzip;如果是没有头部的 raw deflate 数据,pako.Inflate 初始化时必须指定 { windowBits: -15 },否则会抛出 unknown compression method 错误。
2. 解压内容尾部缺失或卡死
表现为:大部分数据正常解出,但结尾总少了一两句话或半截 JSON。原因几乎都是因为流结束时未传入 true(Z_FINISH)。解压算法为了执行效率,会在内存中保留数十至数百字节的滑动窗口。只有收到 Z_FINISH 指令,引擎才会释放最后一段待处理数据。
3. 中文交界处乱码( 符号)
如前文强调,绝不要在 onData 回调中直接使用 Buffer.from(chunk).toString() 或简单字符串拼接。每个分块的交界点可能将一个 3 字节 UTF-8 中文切为 1 字节和 2 字节。请务必使用带状态保留的 TextDecoder('utf-8', { stream: true })。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章