

深入对比JavaScript中escape、encodeURI和encodeURIComponent对空格的处理机制,澄清空格转%20与加号+的常见误区,剖析URL传输全链路的解析原理与工程实践指南。
JavaScript中escape、encodeURI和encodeURIComponent对空格的处理差异
作者:代码拾荒
时间:2026-11-05
浏览:152
文章目录
JavaScript 核心规范解析
主题:URI 编码规范 · 空格与加号冲突 · 字符集作用域
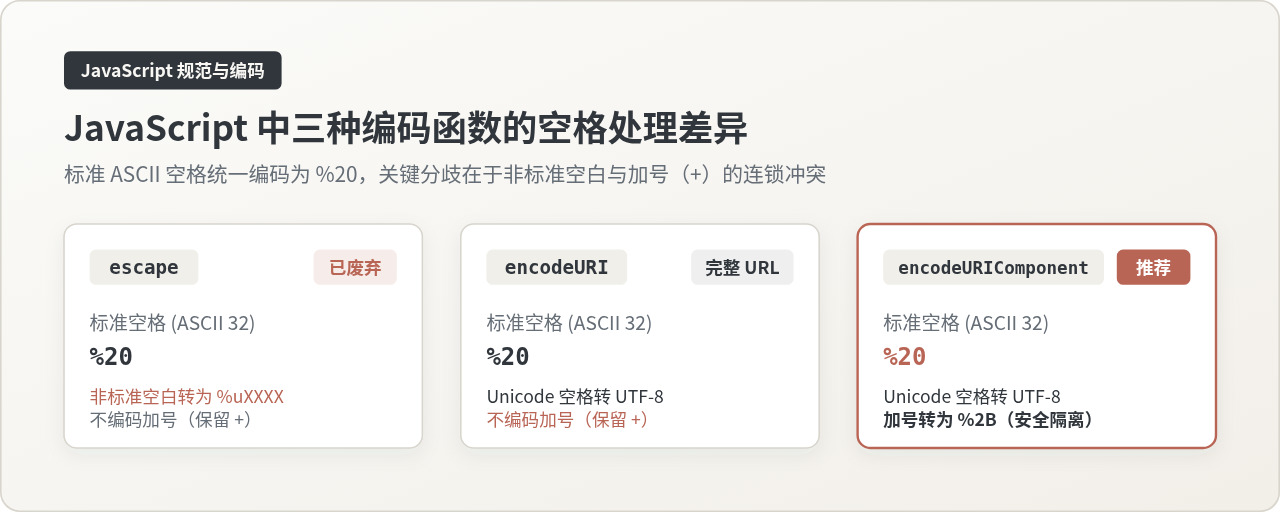
在 JavaScript 开发者日常排查网络请求或参数拼接问题时,一个极其普遍的困惑是“到底哪一个函数会把空格转成加号(+),哪一个会转成 %20”。事实给出的答案非常确定:在对标准 ASCII 空格(U+0020)的处理上,escape()、encodeURI() 和 encodeURIComponent() 三者完全一致,全部将其编码为 %20,没有任何一个函数会将其转为 +。三者真正的核心差异体现在:非标准空白字符(如全角空格与不间断空格)的编码格式分化、加号(+)是否被转义引发的服务端解码连锁反应,以及各自设计定位与字符保留白名单的范围层级。
一、直接验证:三种函数对 ASCII 空格的编码行为
我们首先用最直观的代码来消除关于“空格是否转为加号”的常见误解。在浏览器控制台或 Node.js 环境中执行如下测试代码:
// 针对标准 ASCII 空格字符(U+0020)的编码测试
const rawSpace = " ";

console.log("escape:", escape(rawSpace));
console.log("encodeURI:", encodeURI(rawSpace));
console.log("encodeURIComponent:", encodeURIComponent(rawSpace));

// 复合字符串测试
const phrase = "hello world";
console.log("phrase with escape:", escape(phrase));
console.log("phrase with encodeURI:", encodeURI(phrase));
console.log("phrase with encodeURIComponent:", encodeURIComponent(phrase));
示例运行结果输出
escape: %20encodeURI: %20
encodeURIComponent: %20
phrase with escape: hello%20world
phrase with encodeURI: hello%20world
phrase with encodeURIComponent: hello%20world
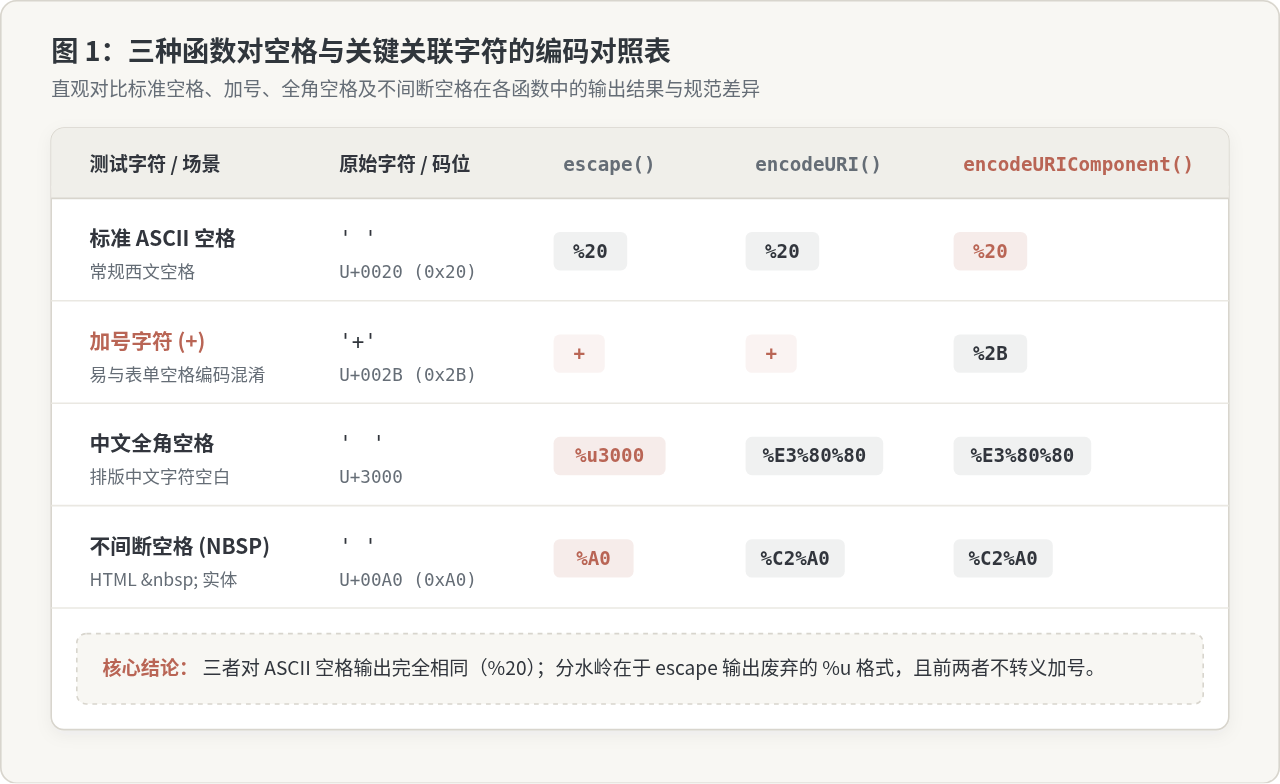
从输出可以看出,对于标准西文空格 " ",三者输出的结果无一例外都是百分号编码 %20。原因在于:
- ASCII 32:空格在 ASCII 编码表中的十进制值为 32,对应十六进制为
0x20。 - 非保留字排除:在 RFC 3986 规范中,空格既不属于“非保留字符”(Unreserved Characters),也不属于“保留字符”(Reserved Characters)。作为 URI 语法中禁止直接裸露出现的字符,必须转义为十六进制表示。
- 三者统一策略:无论是历史产物
escape,还是现代标准的encodeURI和encodeURIComponent,都把 ASCII 空格明确列为必须转义的字符,因此输出均为%20。
二、差异实质之一:非 ASCII 空白字符与编码规范分流
一旦离开纯 ASCII 码位范围,遇到排版中的特殊空白(如中文全角空格 或 HTML 常见的无断行空格 ),三者的行为立即产生了本质分化。
1. 全角空格(U+3000)与非标准格式陷阱
在中文输入法下偶然键入的全角空格,其 Unicode 码位是 U+3000。在处理该字符时:
escape(' ')输出%u3000。这种格式是 ECMAScript 早期的非标准扩展,它直接输出 16 位的十六进制 Unicode 编码。这种%uXXXX格式完全违反 RFC 3986 统一资源标识符规范。现代 Web 服务器(如 Nginx、Apache、Tomcat 或各类 API 网关)接收到%u3000时,通常无法识别或直接报 400 Bad Request 错误。encodeURI(' ')和encodeURIComponent(' ')输出%E3%80%80。它们严格按照 RFC 3986 与 UTF-8 规范,先将字符转换为 UTF-8 字节序列(0xE3 0x80 0x80),再对每个字节逐一进行百分号编码。
2. 不间断空格(NBSP,U+00A0)
对于网页复制内容中常见的 实体(码位 0x00A0):
escape(' ')仅检查低字节,输出单字节的%A0(Latin-1 视图)。encodeURI(' ')和encodeURIComponent(' ')输出 UTF-8 双字节序列%C2%A0。
因此,“对空格的处理差异”在非标准空白字符上是生死攸关的标准合规差异:escape 输出的是现代网络通信无法消费的废弃伪格式,而 encodeURI / encodeURIComponent 具备完全一致的、符合互联网标准的 UTF-8 序列化能力。
三、差异实质之二:URL 语义与“空格 vs 加号(+)”的连锁影响
既然三者对标准空格都输出 %20,为什么业界会长期流传“某些函数会把空格转成加号”的误解?这是因为空格的传输并不是孤立的,它与加号(+)在 URL 传输全生命周期中存在强烈的混淆耦合。
1. 加号代表空格的源头:application/x-www-form-urlencoded
在 HTML 历史标准中,通过表单提交数据(Content-Type 为 application/x-www-form-urlencoded)时,规范规定空格必须替换为加号 +。
现代浏览器的标准 API URLSearchParams 正是基于表单规范实现的:
// URLSearchParams 是依据表单编码规范设计的
const params = new URLSearchParams({ keyword: "hello world" });
console.log(params.toString());
// 输出:keyword=hello+world (这里才真正出现了加号!)
2. 服务端的解码行为:双重兼容带来的风险
绝大多数后端语言与框架(包括 Java Servlet 的 request.getParameter()、PHP 的 $_GET、Python 的 urllib.parse.parse_qs)在解析 URL Query String 时,默认遵循 application/x-www-form-urlencoded 规则:
后端统一解析规则
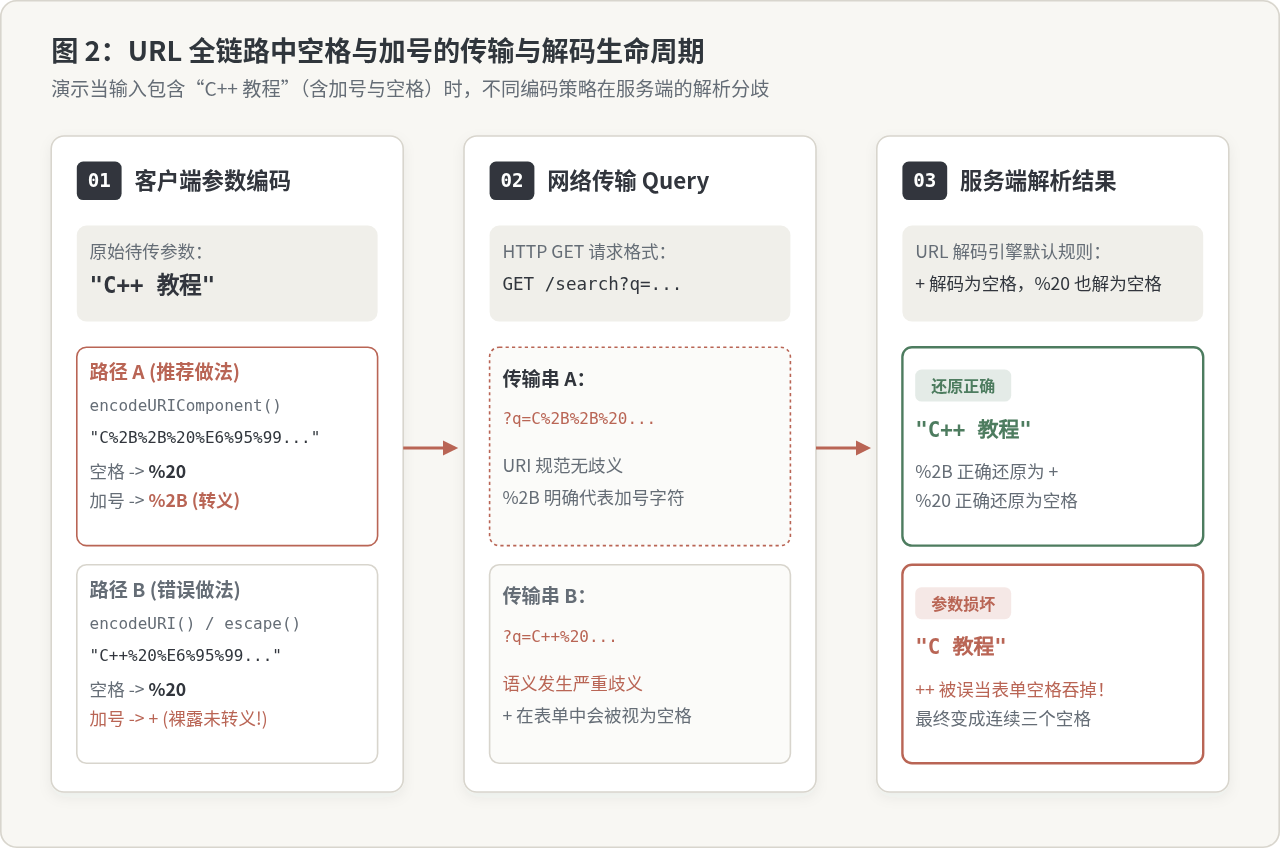
服务端在接收查询字符串时,会把 + 还原为空格,同时也会把 %20 还原为空格。
3. 致命盲区:对加号(+)自身处理的差异
正因为服务端会把 + 无条件当成空格解码,如果用户的实际参数中本身就包含真正的加号(例如搜索 "C++ 教程" 或电话号码 "+8613800"),问题就爆发了:
- 使用
escape("C++ 教程"):输出"C++%20%u6559%u7A0B"。由于escape不对加号编码,+裸露发送;服务端将其当成空格解码,最终得到"C 教程",参数严重损坏! - 使用
encodeURI("C++ 教程"):输出"C++%20%E6%95%99%E7%A8%8B"。因为+在 URI 语法中属于保留字(Reserved Character),encodeURI的使命是保留 URI 语法,因此同样不转义+!传输到后端后,+同样被服务端当成空格吞掉,得到"C 教程"! - 使用
encodeURIComponent("C++ 教程"):输出"C%2B%2B%20%E6%95%99%E7%A8%8B"。它将真正的加号安全编码为%2B,空格编码为%20。服务端收到%2B时能明确识别这是字面量加号,收到%20时还原为空格,最终正确还原出"C++ 教程"。
四、根源剖析:三者保留字符集设计定位与作用域差异
要从底层彻底掌握这三个函数,必须理解它们被创造时的历史定位与各自的不编码白名单(保留集)。
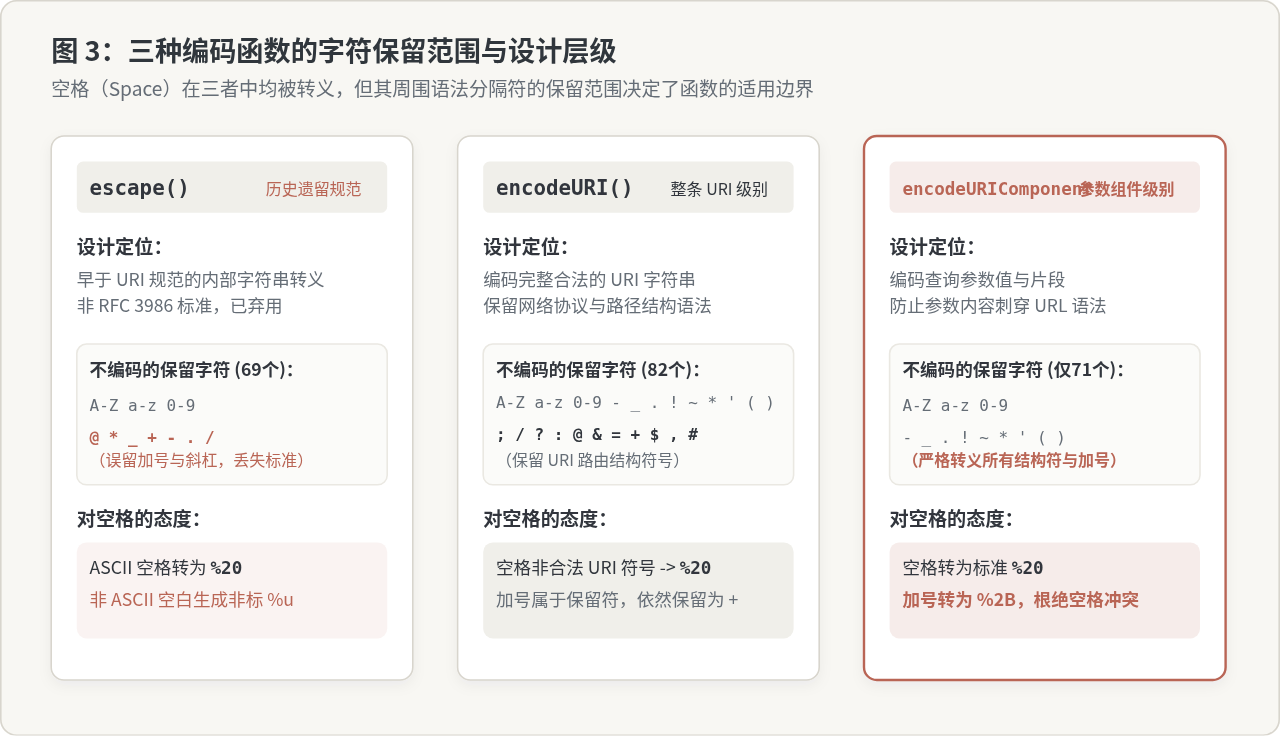
| 函数名称 | 标准状态 | 设计初衷与定位 | 不转义字符(保留集合) | 空格编码 | 加号(+)编码 |
|---|---|---|---|---|---|
escape |
已废弃 (Annex B) | 早期的简单字符转义,不符合任何 URI 协议规范 | 69个:字母数字以及 @ * _ + - . / |
%20 |
+ (不转义) |
encodeURI |
现代标准 (RFC 3986) | 编码整条完整 URL,保留协议、域名及路径路由骨架 | 82个:字母数字、标点及保留字 ;/?:@&=+$,# |
%20 |
+ (保留不转义) |
encodeURIComponent |
现代标准 (RFC 3986) | 编码单个查询参数值或片段,确保其内容不破坏 URL 结构 | 仅71个非保留字:字母数字及 - _ . ! ~ * ' ( ) |
%20 |
%2B (强制转义) |
从表中可以清晰看出:
- 为什么空格在三者中都被编码? 因为无论是整条 URI 还是单个参数,裸露的空格在 HTTP 协议行中都会直接打断请求解析(HTTP 报文行正是以空格分隔方法名、路径与协议版本的),所以三者都把空格划入必须编码的集合。
- 为什么只有
encodeURIComponent适合处理含空格的参数? 因为在实际开发中,参数文本不仅包含空格,还经常伴随&、=、+、/等字符。encodeURI为了保护 URL 整体结构不被破坏,选择不编码这些结构符;但把这一套规则套在参数值内部时,不仅会导致+被误解为空格,还会导致&将一个参数撕裂成两个参数。
五、工程实践与解决方案:如何正确处理 Web 中的空格
理解了机制与原理后,在实际前端工程开发中,应遵循以下具体编码实践:
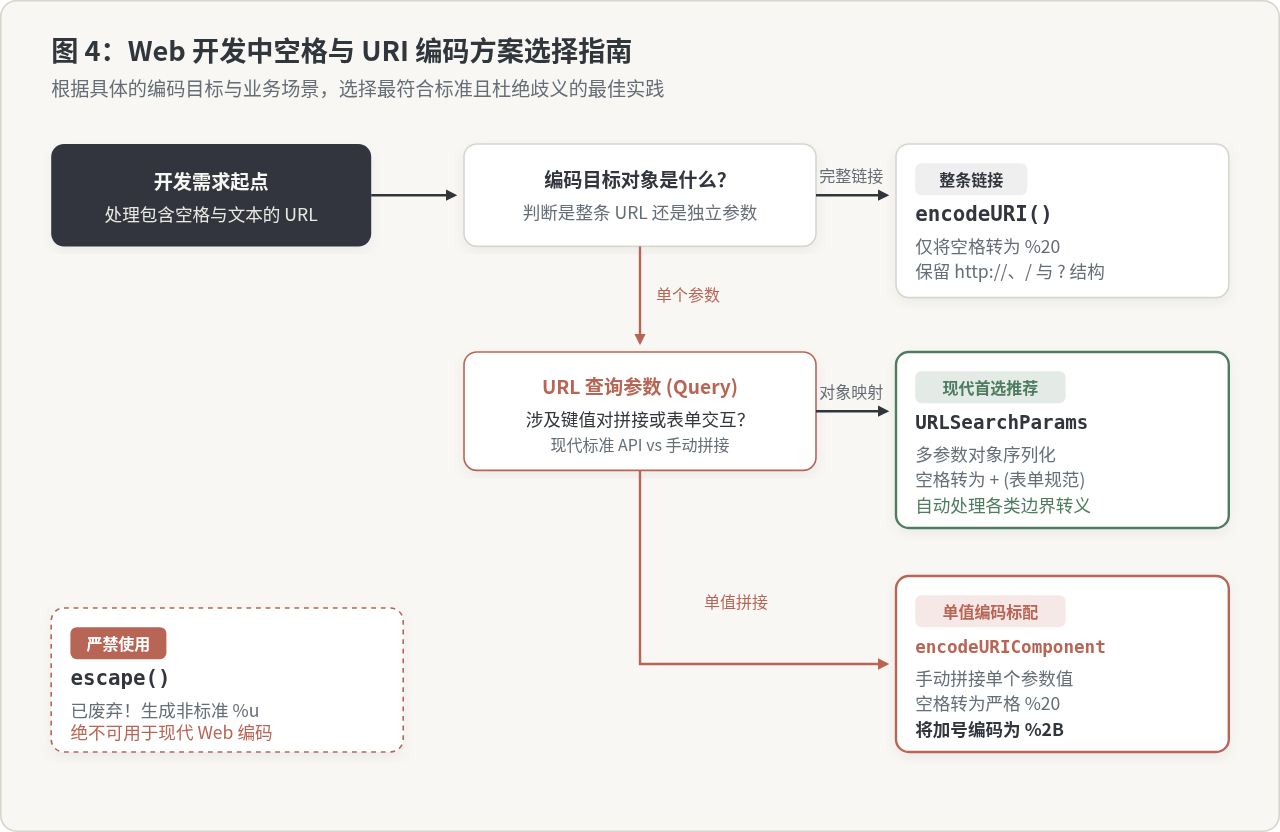
1. 场景 A:构造包含复杂键值的查询参数(首选方案)
在现代浏览器与 Node.js 18+ 环境中,推荐优先使用 URLSearchParams 或直接借助 URL 构造器。它不仅免去了手动转义空格的繁琐,还能全自动处理所有保留字冲突:
// 构造 URL 实例与查询参数
const url = new URL("https://api.example.com/search");

// 即使参数中同时含有加号、空格与特殊符号,也能稳妥处理
url.searchParams.set("query", "C++ 核心 编程");
url.searchParams.set("page", "1");

console.log(url.toString());
// 示例输出:https://api.example.com/search?query=C%2B%2B+%E6%A0%B8%E5%BF%83+%E7%BC%96%E7%A8%8B&page=1
2. 场景 B:单个参数的手动字符串拼接
如果你需要手动拼接单个动态值到 URL 路径或 Query 中,必须使用 encodeURIComponent(),切不可使用 encodeURI() 或 escape():
const userInput = "user name with spaces & +";
const safeTarget = `https://api.example.com/profile?name=${encodeURIComponent(userInput)}`;

console.log(safeTarget);
// 示例输出:https://api.example.com/profile?name=user%20name%20with%20spaces%20%26%20%2B
3. 场景 C:整条含有非编码字符的链接修正
当你从第三方接口或者用户输入中拿到了一整条已经包含协议与路径的原始 URL,但其中偶尔包含了用户未编码的中文或空格,此时使用 encodeURI():
const rawUrl = "https://example.com/docs/快速 上手.html";
const validUrl = encodeURI(rawUrl);

console.log(validUrl);
// 示例输出:https://example.com/docs/%E5%BF%AB%E9%80%9F%20%E4%B8%8A%E6%89%8B.html
// 协议 https:// 与斜杠 / 保持原样,空格转为 %20,中文转为 UTF-8 百分号编码
4. 场景 D:关于解码端的对应处理
在客户端解析包含空格的查询字符串时,若使用 decodeURIComponent,需要注意它不会主动将 + 变回空格:
const queryValue = "hello+world%20test";

// 单纯 decodeURIComponent:保留加号
console.log(decodeURIComponent(queryValue));
// 输出:hello+world test

// 若该字符串来自表单或遵循 x-www-form-urlencoded,需先将 + 替换为空格
console.log(decodeURIComponent(queryValue.replace(/\+/g, " ")));
// 输出:hello world test
总结与快速排查清单
梳理 JavaScript 中处理空格的关键结论:
- 标准空格一致性:对 ASCII 32 空格,
escape、encodeURI与encodeURIComponent全部生成%20。 - 加号不是空格的 JavaScript 原生编码:加号是表单规范(
application/x-www-form-urlencoded)下的产物,在 JS 中只有URLSearchParams会将空格格式化为+。 - 真正致命的差异是加号逃逸:
encodeURI和escape不转义+,导致参数内的字面量加号在服务端被误解析为空格;只有encodeURIComponent会将加号转为%2B。 - 全面弃用
escape:由于其在 Unicode 空格与多字节字符上生成非标准的%uXXXX格式,现代 Web 开发中应彻底禁止使用escape()。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章