

详细讲解在前端使用 JavaScript 解析 URL 参数时,中文出现乱码、特殊字符(如 +、&、#、%)丢失或解析异常的根本原因,并给出基于 URLSearchParams 的标准处理方案与安全解码工程实践。
JS解析URL参数时怎么处理中文乱码和特殊字符
作者:竹影
时间:2026-11-05
浏览:151
文章目录
在 JavaScript 中解析 URL 参数时,遇到中文乱码或特殊字符异常,核心原因在于 URL 传输遵循百分号编码(Percent-Encoding)规范,而不同场景下的编码字符集不匹配、特殊符号转义不彻底或解码方式选择错误会导致信息失真。解决这一问题的最有效路径是:优先使用现代浏览器原生的
URLSearchParams 接口进行自动规范化解析;对于需要手动切分或自定义处理的场景,采用带有 try...catch 容错的 decodeURIComponent,并在编码阶段确保中文转为标准的 UTF-8 字节序列、特殊符号(如 +、&、#、%)显式转义。
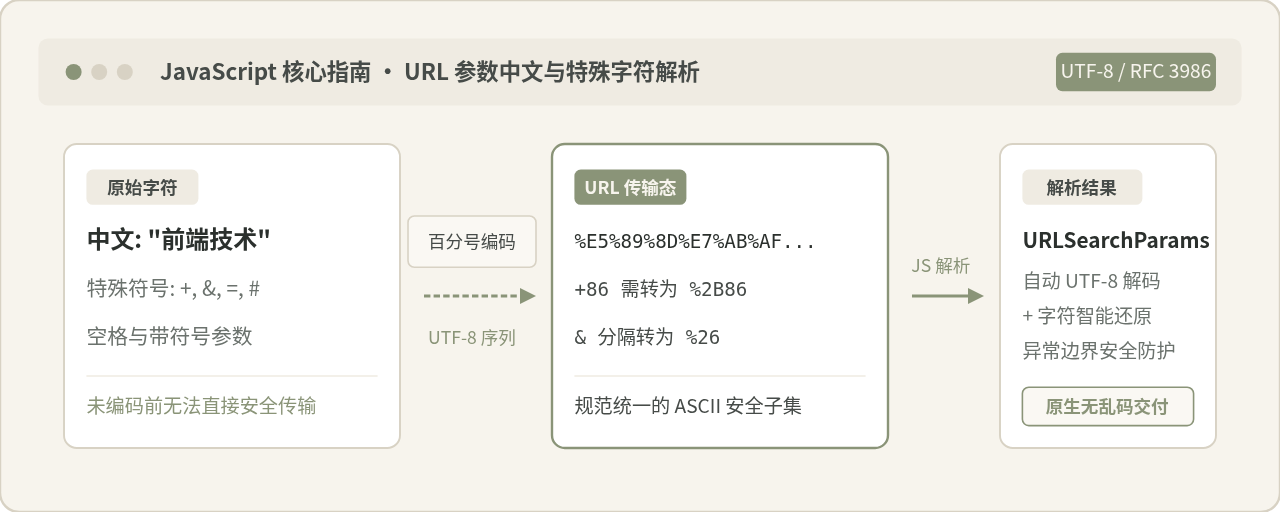
URL 参数处理全景:原始字符输入、百分号安全传输态与 JavaScript 标准解析
一、URL 参数中的中文与特殊字符为何会“变形”
要彻底解决解析时的乱码与丢失问题,首先需要理解 URL 在传输网络中的底层规范。根据互联网通用标准 RFC 3986 规定,URL 中只允许包含一小部分安全的 ASCII 字符(如英文大小写字母、数字及少量未保留符号 - _ . ~)。所有非 ASCII 字符(例如中文汉字)以及具有控制意义的保留字符,都必须经过百分号编码(Percent-Encoding)转换为合规格式。
中文出现乱码通常由以下两个环节的偏差引起:
- 编码字符集不一致:现代前端普遍基于 UTF-8 编码,一个常用汉字会被转换为 3 个字节的十六进制形式(例如“中”对应
%E4%B8%AD)。如果发送端(例如旧版后端系统或特定导出接口)使用了 GBK 编码进行字节转义,而前端 JavaScript 强制使用 UTF-8 规则进行解码,字节序列无法对齐,就会产生形如çÃ...的乱码。 - 未执行解码或多次重复编码:有些系统在拼接链接时调用了多次
encodeURIComponent,前端只进行了一次解析,页面显示出来的依然是%E6%B1%89...;反之,若完全遗漏了解码步骤,也会让原本的中文停留在原始传输态。
除了汉字本身,URL 的保留特殊字符(如 &、=、#、+)也会引发严重的逻辑截断:
- 结构混淆:若参数的值本身包含
&或=(例如?title=前端&后端),若不进行转义,浏览器会将&后端识别为一个新的无值参数,导致原始参数被强行掐断。 - 哈希截断:若参数值中包含
#(例如颜色值#ff0000),未转义的#会被浏览器直接识别为页面的锚点哈希(Hash Fragment),其后的所有参数都不会被计入location.search中,引发数据丢失。 - 加号与空格歧义:在标准的
application/x-www-form-urlencoded表单提交规范中,空格会被自动转换为加号+;但在通用的 RFC 3986 规范中,空格应编码为%20,而+本身是合法保留字符。这种标准重叠经常导致解析时加号莫名其妙变成了空格。
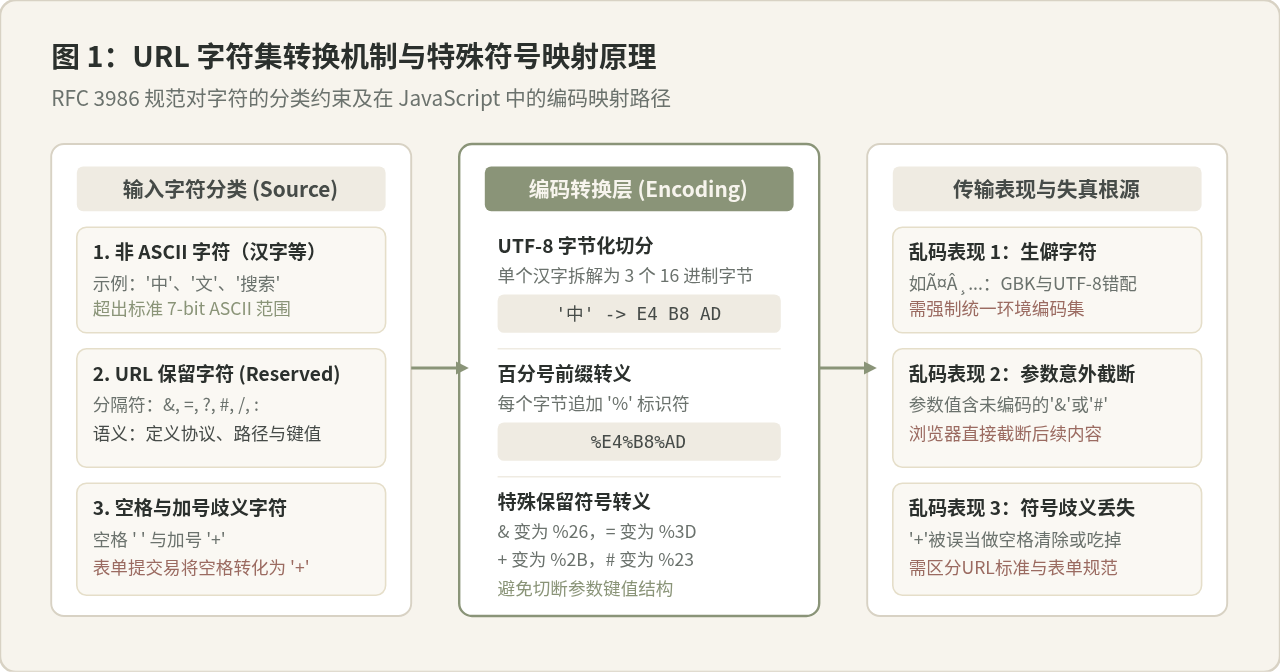
图 1:URL 字符集转换机制与特殊符号映射原理
二、现代标准方案:利用 URLSearchParams 原生解析
在现代 Web 开发中,解析 URL Query 参数无需再自行手写繁琐的正则表达式或 split('&') 逻辑。浏览器原生的 URLSearchParams 接口是处理中文和特殊字符的首选标准工具。
URLSearchParams 能够原生识别标准的百分号编码,并且在调用 .get() 方法时会自动执行 UTF-8 解码,同时正确处理 application/x-www-form-urlencoded 中的加号转换规则。
1. 基础读取与自动解码示例
假设当前页面地址为:https://example.com/search?keyword=%E5%89%8D%E7%AB%AF%E6%8A%80%E6%9C%AF&category=web%20dev。
// 示例:使用 URLSearchParams 直接读取并解析
const searchParams = new URLSearchParams(window.location.search);

// 读取中文参数:自动解码为 "前端技术",无需手动调用 decode
const keyword = searchParams.get('keyword');
console.log(keyword); // 输出: 前端技术

// 读取包含空格的参数:自动处理为 "web dev"
const category = searchParams.get('category');
console.log(category); // 输出: web dev

// 判断参数是否存在
if (searchParams.has('keyword')) {
  console.log('关键词已设置');
}
2. 将全部参数转换为常规 JavaScript 对象
如果需要将 URL 中的所有参数整体转换为键值对对象供业务逻辑使用,可以配合 Object.fromEntries() 快速完成:
function getUrlQueryParams(queryString = window.location.search) {
  const params = new URLSearchParams(queryString);
  return Object.fromEntries(params.entries());
}

// 示例输出结果(明确标为示例):
// {
//   keyword: "前端技术",
//   category: "web dev"
// }
单页应用 Hash 路由注意事项:
在 Vue Router 或 Hash 模式的路由中,URL 常见形如
解决办法是传入实际包含 query 的字符串:
在 Vue Router 或 Hash 模式的路由中,URL 常见形如
https://example.com/#/list?keyword=%E4%B8%AD%E6%96%87。此时 window.location.search 可能是空的,因为 ? 紧跟在 # 后面,被归类到了 window.location.hash 中。解决办法是传入实际包含 query 的字符串:
new URLSearchParams(window.location.hash.split('?')[1] || '')。
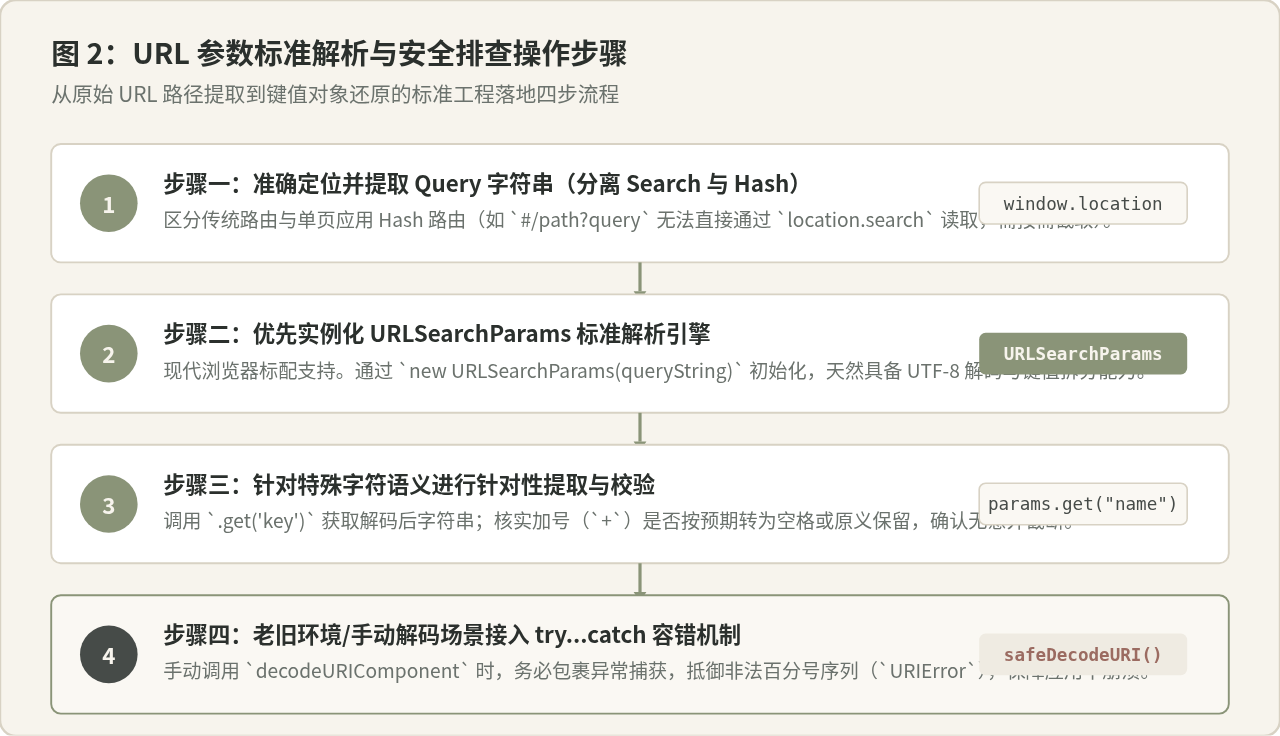
图 2:URL 参数标准解析与安全排查操作步骤
三、手动解析场景与 decodeURIComponent 的关键陷阱
在某些需要手动切分字符串、兼容极旧环境或自定义解析管道的场景下,开发者通常会使用内置的 decodeURIComponent。但在直接使用时,必须特别防范以下三大陷阱。
陷阱一:切忌混淆 decodeURI 与 decodeURIComponent
JavaScript 提供了两个同属全局的解码方法,但它们的职权范围截然不同:
decodeURI:设计用于解码完整的 URL 链接。为了保证 URL 本身的骨架不崩塌,它不会解码 URL 的保留字符(包括;,/?:@&=+$#)。如果你试图用它去解码一个包含特殊字符的参数值,这些符号将保持百分号状态或无法还原。decodeURIComponent:设计用于解码URL 中的某个独立组成部分(如特定的 query 键或值)。它会将所有合法的百分号转义字节全量还原,是解析参数值必须使用的方法。
陷阱二:畸形编码引发致命 URIError 异常
decodeURIComponent 是极其严格的。一旦待解码的字符串中出现了不符合 UTF-8 编码格式的百分号序列(例如用户直接在 URL 输入了搜索词 50%off,此时 %of 并非有效的十六进制字符;或者由于网络截断导致末尾只剩下一个孤立的 %),decodeURIComponent 会直接抛出运行时错误:
// 错误示例:遇到非法百分号字符直接崩溃
decodeURIComponent("discount=50%off");
// 抛出异常: Uncaught URIError: URI malformed
如果未在代码中进行防御性捕获,整个页面的 JavaScript 执行流程将被中断,导致组件白屏。为此,在工程实践中应当使用健壮的安全包装函数:
/**
 * 安全解码函数:防范 URIError 导致页面异常
 * @param {string} str - 待解码字符串
 * @returns {string} - 解码后字符串或降级容错串
 */
function safeDecodeURIComponent(str) {
  if (typeof str !== 'string') return '';
  try {
    return decodeURIComponent(str);
  } catch (e) {
    // 降级策略 1:尝试修复孤立的百分号后再解码
    try {
      return decodeURIComponent(str.replace(/%(?![0-9a-fA-F]{2})/g, '%25'));
    } catch (err) {
      // 降级策略 2:无法挽救时返回原串或使用 unescape 容错
      return str;
    }
  }
}
陷阱三:加号(+)与空格的处理细节
与 URLSearchParams 不同,decodeURIComponent 不会把 + 替换为空格。
- 如果该参数是按表单规范提交的,其中的
+代表空格,那么在使用decodeURIComponent之前,需要先执行.replace(/\+/g, ' ')。 - 如果该参数原本就是数学符号或电话区号(例如
+86),在生成 URL 时必须确保发送端使用encodeURIComponent('+86')转换为%2B86。这样无论接收端采用哪种解析机制,都能完整无误地取回+86,而不是丢失变为86。
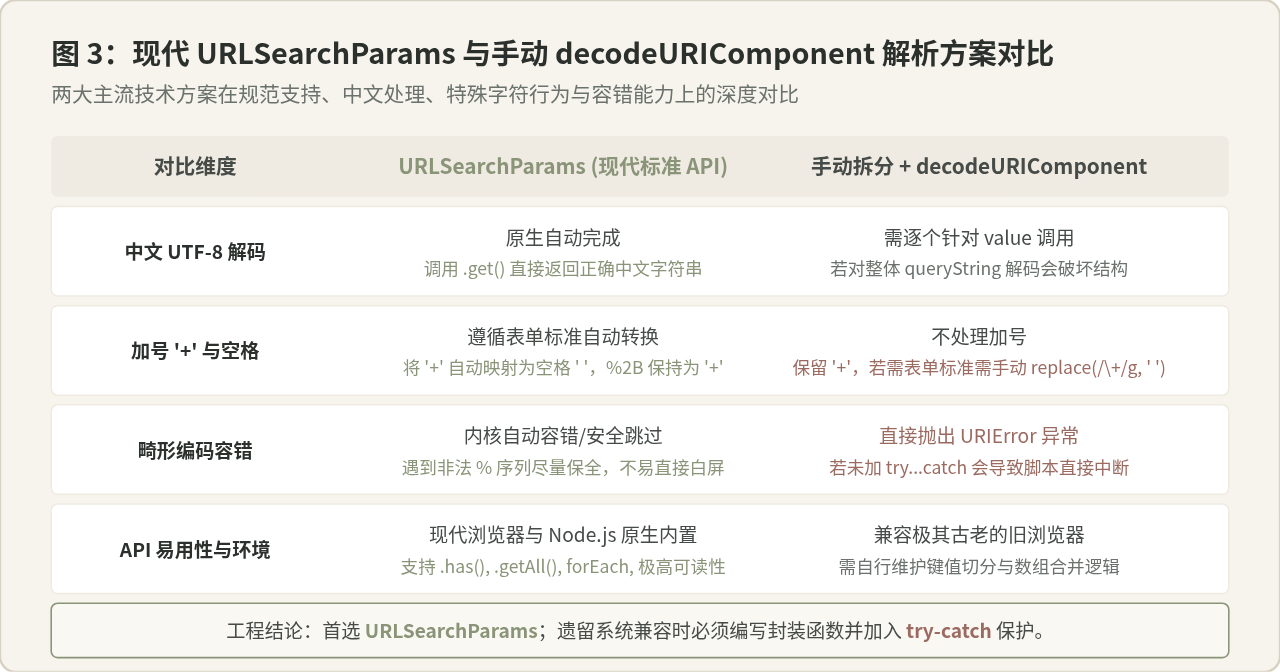
图 3:现代 URLSearchParams 与手动 decodeURIComponent 解析方案对比
四、容易混淆的说法辨析与实践修正
在日常开发和网络资料中,关于 URL 参数乱码存在一些流传广泛的经验做法。理解其背后的合理性与适用局限,能帮助我们在项目中做出更清晰的判断。
辨析一:“前端遇到乱码,调用两次 decodeURIComponent 就好了”
为什么看似合理:在早期的 Web 架构中,某些旧版本的代理服务器、网关或应用服务器(如早期的 Tomcat/JSP)会在请求到达业务层之前,自动默认执行一次解码操作。如果 URL 参数中包含中文,第一次自动解码可能按容器默认的 ISO-8859-1 处理,导致乱码。为了绕过这个自动解码环节,当时流行的做法是在前端发送端主动进行两次编码:encodeURIComponent(encodeURIComponent('中文'))。这样中文字符被包裹在纯 ASCII 的百分号中,第一次自动解码只剥除外层编码,后端或前端再次调用一次 decodeURIComponent 就能恢复中文。
哪里需要修正:在现代开发标准下,前后端普遍已经统一采用 UTF-8 编码传输。如果发送端并没有进行两次编码,而前端盲目“无脑解码两次”,会带来隐藏隐患。例如,如果用户的真实搜索内容本身就包含字符 %25(即百分号本身),第一次解码会正确还原为 %,而第二次解码会误将后续字符与该 % 拼装,导致程序报错崩溃或内容被错误篡改。规范的解决方式是确保发送方与接收方的编解码流程 1:1 对等,不要依靠多重解码来碰运气。
辨析二:“用 escape() 也可以用来处理 URL 编码”
为什么需要废弃:escape() 和 unescape() 是 ECMAScript 第一代规范遗留下来的方法,已在现代标准中被正式标记为废弃(Deprecated)。escape() 对非 ASCII 字符的编码格式是 %uXXXX(例如 %u4E2D),这种格式完全不符合标准的 RFC 3986 规范,HTTP 服务器和标准解析库均无法识别。处理 URL 参数时必须始终使用 encodeURIComponent 和 decodeURIComponent。
五、中文乱码与异常排查全景指南
当在项目中遇到 URL 参数获取异常时,可对照以下决策模型迅速定位故障源头:
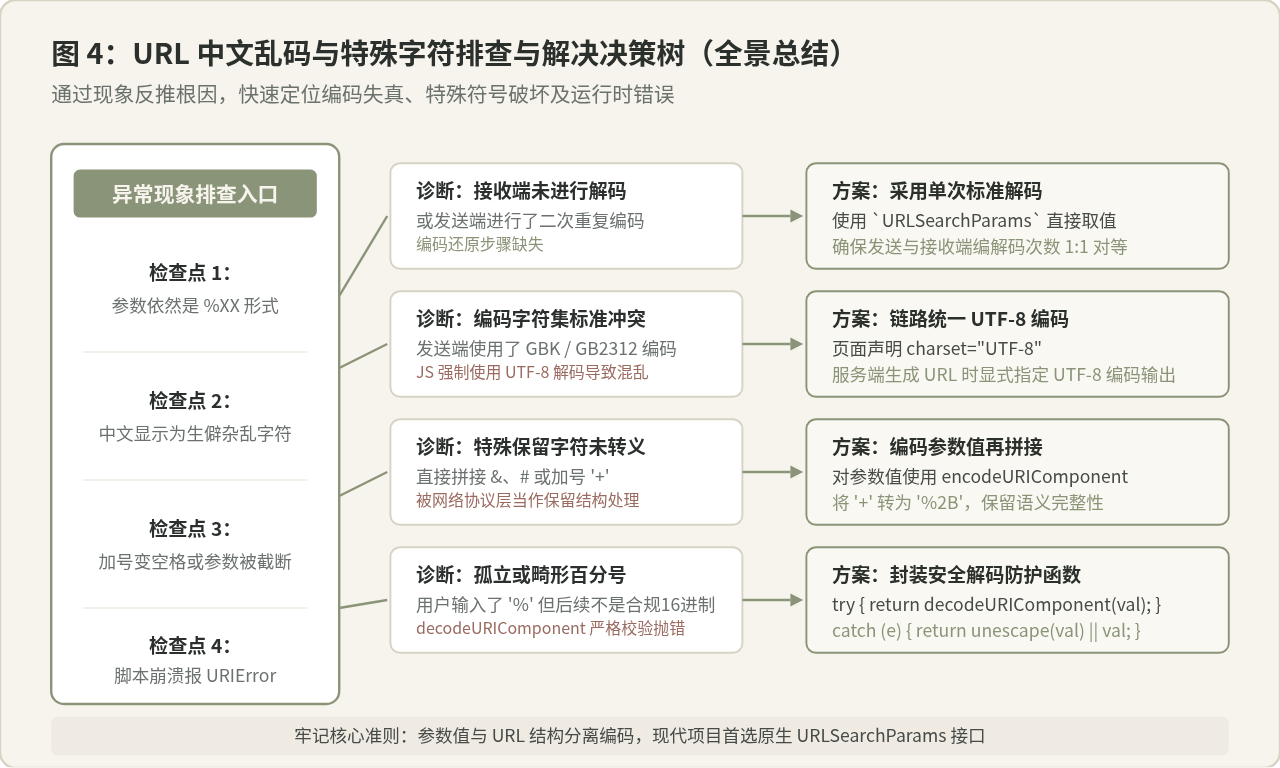
图 4:URL 中文与特殊字符异常排查决策树(全景总结)
| 异常现象 | 根本原因 | 标准修复方案 |
|---|---|---|
参数值显示为未解码的 %E4%BD%A0... |
接收端未调用解码,或发送端进行了多次重复编码 | 使用 URLSearchParams.get() 直接取值,或核对前后端编码调用次数。 |
参数值显示为不可读乱码(如 çÃ...) |
发送端与接收端编码字符集不统一(如 GBK 与 UTF-8 错配) | 在 HTTP 响应头或 HTML 页面显式声明 charset=UTF-8,统一全链路编码。 |
参数中包含的 + 号变为空格 |
+ 被误当做表单空格字符解析 |
发送端拼接前使用 encodeURIComponent() 将 + 显式转义为 %2B。 |
参数在遇到 & 或 # 之后内容全部丢失 |
保留字符未做转义,破坏了 URL 整体结构 | 严禁直接通过模板字符串裸拼参数值,必须对每个参数值分别执行 encodeURIComponent 后再拼接。 |
运行时报错 URIError: URI malformed |
参数中存在不合规的独立 % 或非法 UTF-8 字节 |
在解码环节加入 try...catch 防御包裹,并利用正则预清洗孤立百分号。 |
总结而言,处理 JavaScript 中的 URL 中文与特殊字符,核心原则在于“拼接前精细化转义,解析时标准化承接”。在参数生成端,对每个独立键值运用 encodeURIComponent;在参数消费端,优先调用原生的 URLSearchParams API,并对潜在的异常输入做好降级防御,即可保障各类复杂字符在全链路传输中的安全与准确。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章