

全面对比JavaScript中Array、Set与Map的底层存储模型、索引与键值特性、核心操作时间复杂度及实际业务场景中的选型决策与避坑指南。
JS中Array、Set与Map的区别及应用场景选择
作者:寒星
时间:2026-11-05
浏览:340
文章目录
JavaScript 基础与进阶
标准参考:ECMAScript 6+ / ES2024
阅读时长:约 10 分钟
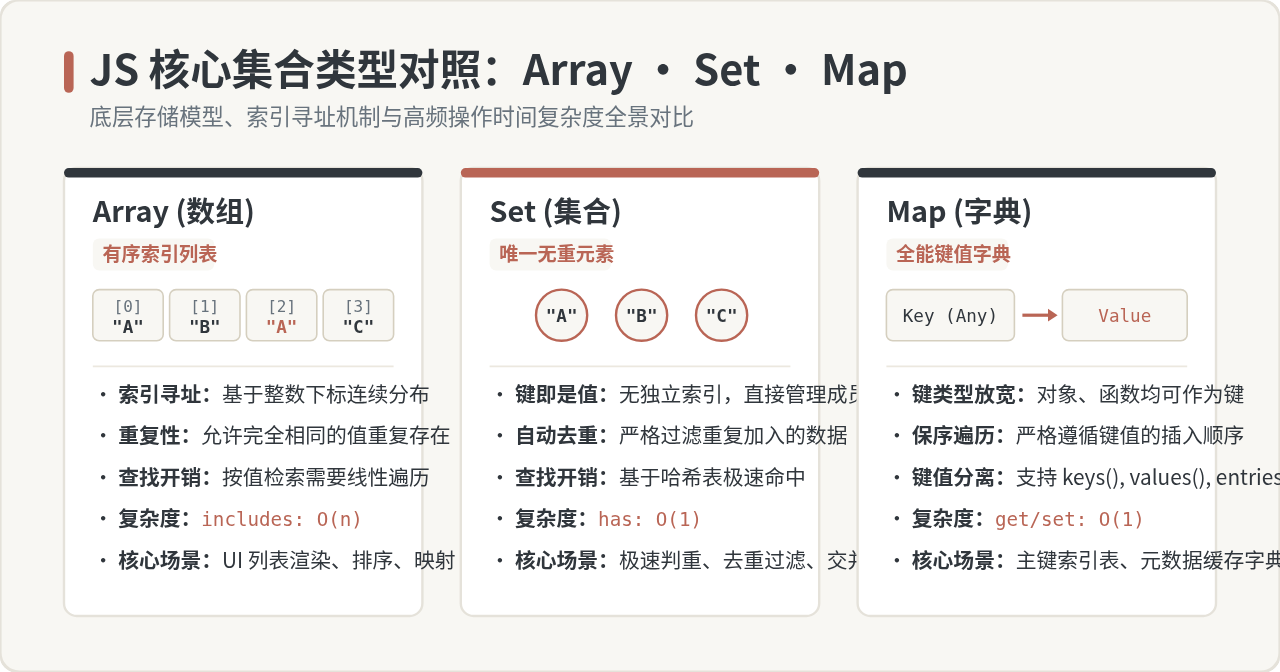
在 JavaScript 开发中,Array、Set 与 Map 构成了最基础且高频的数据集合体系。简而言之:Array 是支持重复项与随机下标访问的线性列表,适合保序渲染与函数式变换;Set 是基于哈希实现的无重复值集合,核心优势在于常数级 \(O(1)\) 的成员存在性判定与自动去重;Map 则是真正的全类型键值对字典,不仅允许任意对象作为键,更在频繁增删和键值映射场景中展现出优于普通对象的性能与确定性插入顺序。理解三者的底层机制与性能拐点,是写出健壮、高效前端与服务端代码的关键。
一、底层数据模型与组织机制差异
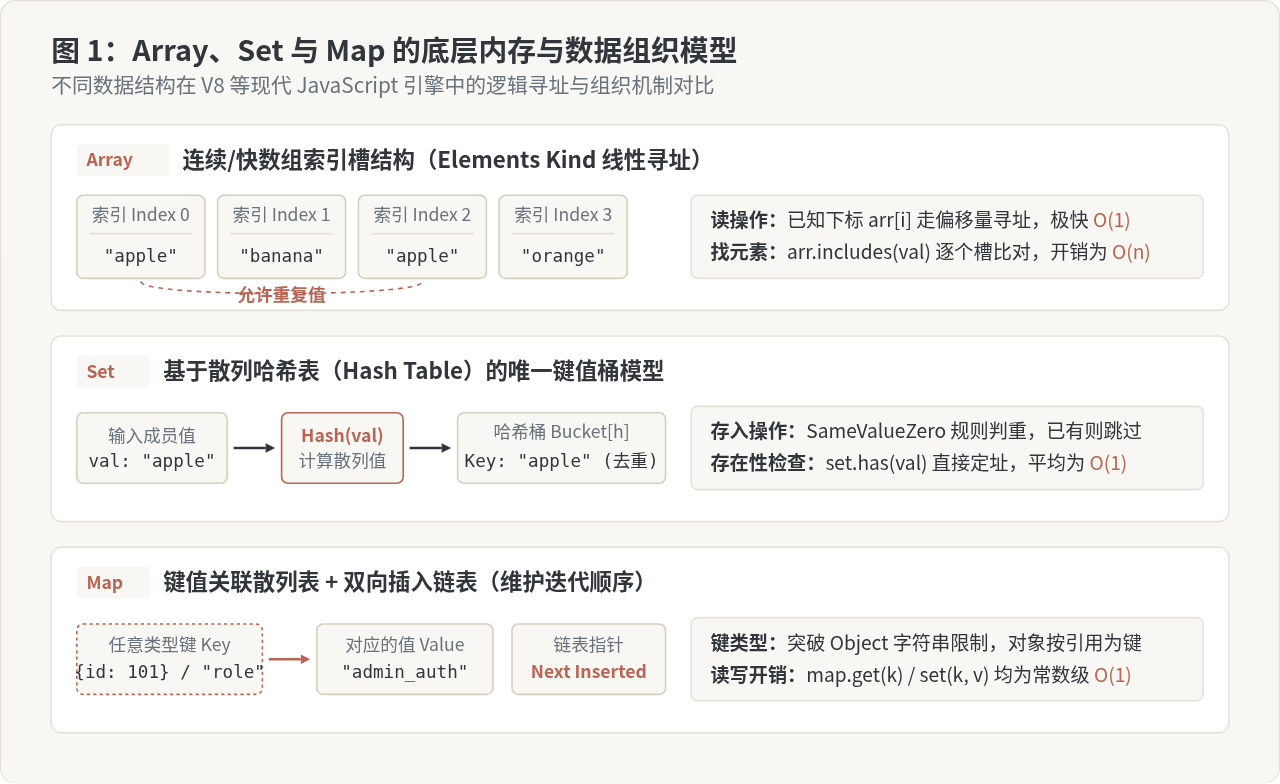
JavaScript 引擎(如 Google V8、JavaScriptCore)对这三种数据结构采用了截然不同的底层实现方式,决定了它们在内存占用、引用判定以及遍历行为上的根本差异。
1. Array:连续内存槽与可变长度的线性表
Array 本质上是带数字键的原型链对象,但在引擎内部会依据元素类型与稠密程度被优化为“快数组”(连续内存存储,快速根据内存偏移寻址)或“慢数组”(退化为字典模式哈希表)。Array 维护着一个随元素动态伸缩的 length 属性,允许存在完全相同的元素,并保留严格的数值下标顺序。其读取特定下标 arr[i] 是 \(O(1)\) 操作,但若通过 arr.includes(value) 或 arr.indexOf(value) 在数组中查找具体值,引擎必须从头到尾执行线性扫描,耗时随元素量线性增长(\(O(n)\))。
2. Set:基于散列机制的单值哈希集合
Set 是一组无重复值的集合。虽然在 ECMAScript 规范中要求 Set 能够记录元素的插入顺序,但它的底层检索依赖散列(Hash)分桶实现。向 Set 添加元素时,引擎先计算值的哈希指纹,快速定位到对应存储槽位。若槽位中已存在符合 SameValueZero 比较规则的等价值(NaN 与 NaN 判定为相等,+0 与 -0 判定为相等),则自动忽略本次写入。因此,无论是增添(add)、移除(delete)还是核查存在性(has),其时间复杂度平均都是 \(O(1)\)。
3. Map:双向插入链表驱动的全类型键值字典
在 ES6 出现前,开发者通常将普通 Object 当作字典使用,但 Object 存在两个硬伤:键只能是字符串或 Symbol;且由于原型链(如 Object.prototype)的存在,容易发生键名污染。Map 则是专门为“键值对映射”设计的数据结构。它的键可以是任意 JavaScript 数据类型,包括函数、DOM 节点、普通对象或原始值。在内部,Map 维护了一个哈希映射表与一条贯穿所有键值对的双向链表,既保证了以 \(O(1)\) 的复杂度根据键定位值,又严格保留了用户写入键值对的插入顺序。
二、核心 API、时间复杂度与关键行为对比
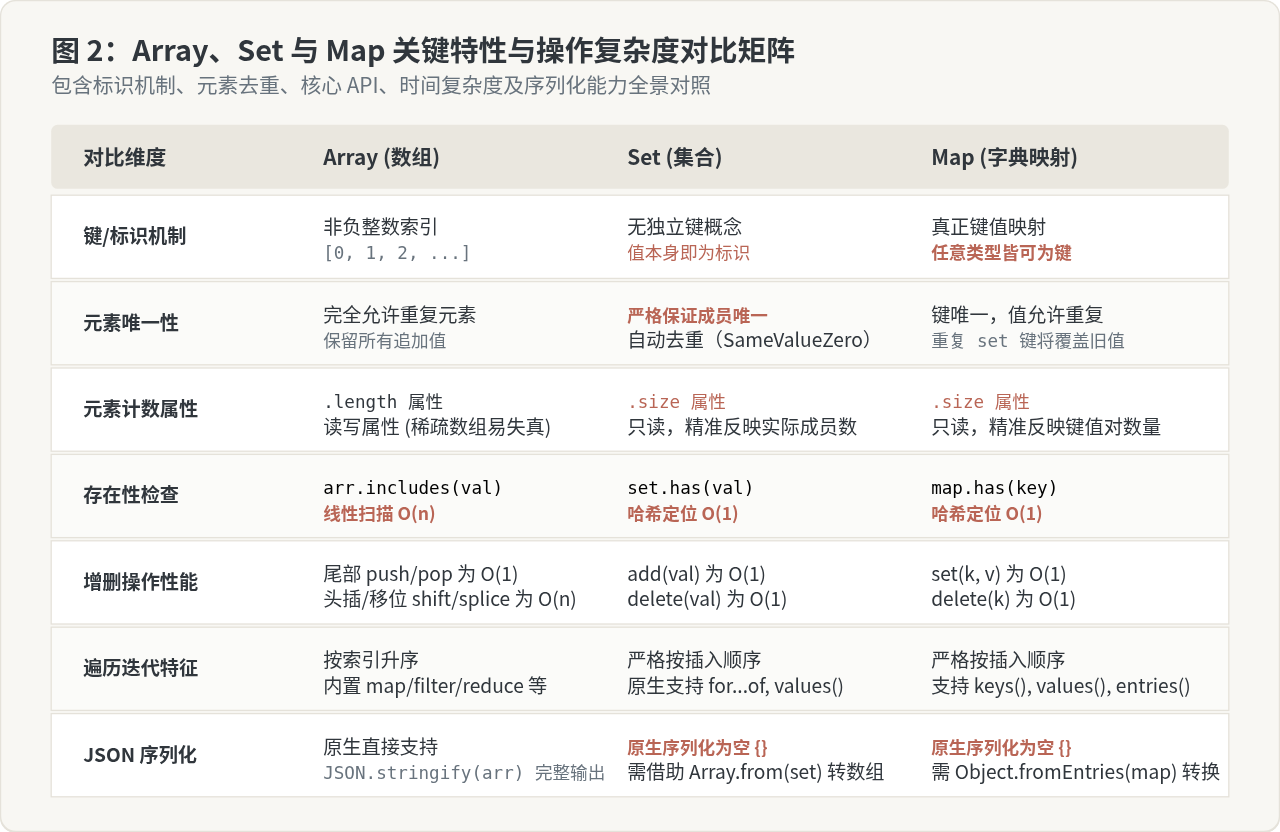
为了更清晰地量化三者在日常编码中的差异,以下从标识机制、唯一性、增删查改复杂度、遍历能力及序列化支持五个核心维度进行深入对照。
1. 元素标识与键类型限制
Array 的标识仅为连续非负整数(0, 1, 2...),虽然 JavaScript 允许在数组实例上添加字符串属性,但这属于对象的常规属性挂载,并不计入数组长度。Set 没有独立键的概念,值即是键本身。而 Map 彻底放宽了限制,以下代码清晰地展示了这一点:
// Map 支持以引用对象作为 Key
const userSession = new Map();
const userObj = { id: 1001, name: "Alice" };

userSession.set(userObj, { lastLogin: Date.now(), roles: ["admin"] });

// 准确读取
console.log(userSession.get(userObj).roles); // 输出: ["admin"]

// 若为普通 Object,对象键会被自动强转为 "[object Object]" 字符串
const plainObj = {};
plainObj[userObj] = "data1";
console.log(Object.keys(plainObj)); // 输出: ["[object Object]"]
2. 长度统计:length 与 size 的本质不同
Array.prototype.length 是一个可读写的数字属性,其值等于“最大数字索引 + 1”。如果构建了一个稀疏数组(如 const a = []; a[100] = 'ok';),a.length 会直接跳至 101,但这并不意味着数组中真实存有 101 个有效成员。相比之下,Set.prototype.size 与 Map.prototype.size 均为只读属性,它们由引擎直接维护,精准反映集合中真实有效成员(或键值对)的实际数量,不存在稀疏空洞的情况。
3. 时间复杂度在实际数据规模下的分水岭
在数据量小于数十项的极小规模下,Array 与 Set/Map 的执行耗时差异可以忽略不计;但当数据规模上升到数千乃至数万时,算法复杂度(\(O(n)\) 对比 \(O(1)\))的差距将放大数百倍。
- 存在性查找:在包含 100,000 个元素的列表中频繁检查某项是否存在。使用
arr.includes()需要执行线性遍历,最坏情况下遍历 100,000 次;而使用set.has()或map.has()只需计算一次散列,耗时恒定在微秒级。 - 头部元素变更:在
Array头部使用shift()或unshift()会导致后续所有元素的索引全部向后或向前位移,耗时为 \(O(n)\);但在Set和Map中删除与写入任意位置的项均是 \(O(1)\)。
三、实战典型代码模式与流水线协作
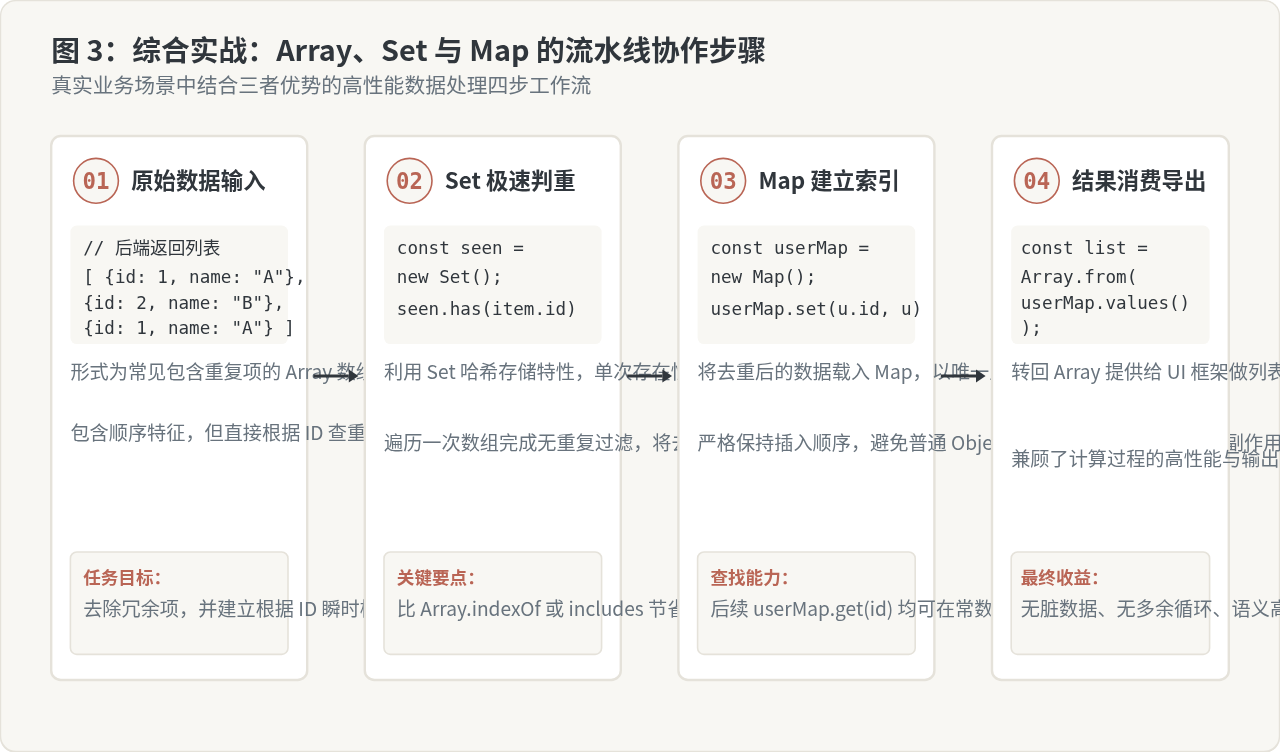
在实际工程中,Array、Set 和 Map 并非彼此排斥,而往往形成一条高效的处理流水线。以下是四种最经典的组合实践模式。
1. 集合去重与高性能集合运算
对于原始类型值(字符串、数字、布尔值)的数组,利用 Set 进行单行去重是当前 JavaScript 的标准范式。在现代浏览器及 Node.js 22+ 中,还可以直接调用 ECMAScript 新增的原生集合运算方法(intersection、union、difference):
// 基础原始值去重
const rawTags = ["js", "react", "js", "vue", "react"];
const uniqueTags = [...new Set(rawTags)];
console.log(uniqueTags); // 示例输出: ["js", "react", "vue"]

// 数组交集的高效计算(通过 Set 加速 includes 校验)
const listA = [1, 2, 3, 4, 5];
const listB = [3, 4, 5, 6, 7];

const setB = new Set(listB);
// 单次 filter 内走 O(1) 的 setB.has(),整体复杂度保持在 O(n)
const intersection = listA.filter((item) => setB.has(item));
console.log(intersection); // 示例输出: [3, 4, 5]
2. 建立实体主键字典与 O(1) 关联查询
从后端接口接收到列表数据后,若页面中需要依据 ID 频繁查询详情,将数组转换为 Map 索引表是避免嵌套循环的经典解法:
interface User { id: number; name: string; deptId: number; }

const rawUsers = [
  { id: 101, name: "张三", deptId: 1 },
  { id: 102, name: "李四", deptId: 2 },
  { id: 103, name: "王五", deptId: 1 }
];

// 1. 构建 O(1) 检索字典
const userMap = new Map(rawUsers.map((u) => [u.id, u]));

// 2. 高频瞬时访问
function getUserSummary(userId) {
  const user = userMap.get(userId);
  return user ? `${user.name} (部门:${user.deptId})` : "未找到用户";
}

console.log(getUserSummary(102)); // 示例输出: 李四 (部门:2)
四、技术选型决策树与高频避坑指南
在实际项目架构中,选择哪种数据结构应当取决于业务对数据的访问模式与生命周期特征。
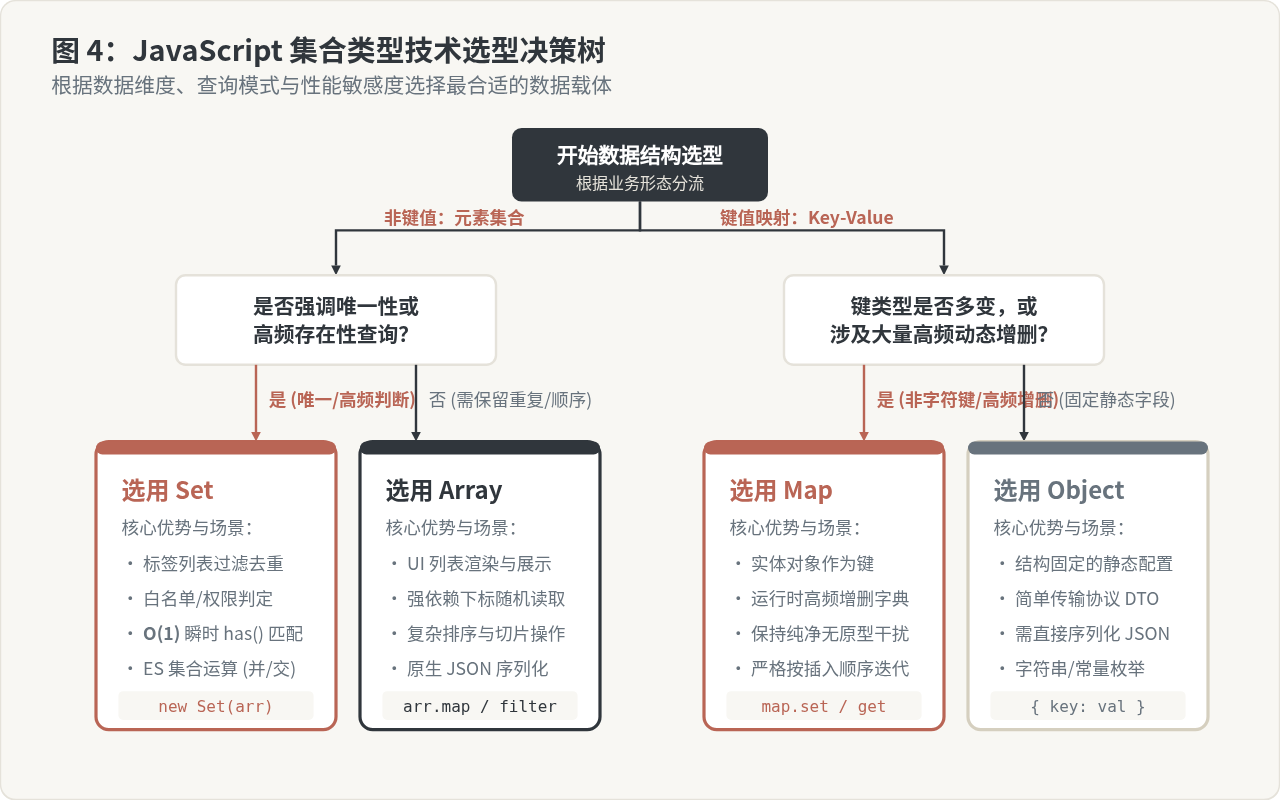
1. 选型判断速查矩阵
| 业务特征与操作需求 | 推荐结构 | 选择理由与核心优势 |
|---|---|---|
UI 列表组件循环渲染、需要按条件排序(sort)、切片(slice) |
Array | 框架对数组监听支持完善,原生具备丰富的迭代与高阶函数变换 API。 |
| 高频成员白名单校验、权限判重、多集合数学运算(交集/并集/差集) | Set | 通过 .has() 获得稳定 \(O(1)\) 复杂度,自动维护元素唯一性约束。 |
| 键值映射字典、键类型为非字符串(对象、数字、DOM)、键值频繁增删 | Map | 无原型键名碰撞风险,删除键性能优于 delete obj.key,严格保序。 |
| 前后端网络传输 DTO、固定字段的静态系统配置、纯 JSON 存储实体 | Object | 语法最精简,与 JSON.stringify 无缝集成,无任何转换开销。 |
⚠️ 避坑提醒:对象引用的“同一性”陷阱
在 Set 和 Map 中,对象是按照内存引用地址进行比对的,而非字面量内容相等。如果直接传入两个结构相同的匿名对象字面量,Set 会将其视为两个完全不同的元素,Map 也会建立两个独立的键:
const s = new Set();
s.add({ id: 1 });
s.add({ id: 1 });
console.log(s.size); // 输出: 2(因为两个对象指向不同堆内存!)

// 正确做法:对业务对象去重时,应以稳定唯一属性(如 ID)作为 Set 收集键
const seenIds = new Set();
const uniqueList = list.filter(item => {
  if (seenIds.has(item.id)) return false;
  seenIds.add(item.id);
  return true;
});
⚠️ 避坑提醒:JSON 序列化丢失数据问题
JSON.stringify() 规范原生仅支持对标准 Array 和普通 Object 进行序列化。直接对 Set 或 Map 执行 JSON.stringify() 会得到空对象 {}。在进行网络传输或持久化前,必须手动转换:
const mySet = new Set(["a", "b"]);
const myMap = new Map([["k1", "v1"], ["k2", "v2"]]);

// 错误做法
console.log(JSON.stringify(mySet)); // 输出: {}
console.log(JSON.stringify(myMap)); // 输出: {}

// 正确做法:转换后序列化
const setJson = JSON.stringify(Array.from(mySet)); // 输出: ["a","b"]
const mapJson = JSON.stringify(Object.fromEntries(myMap)); // 输出: {"k1":"v1","k2":"v2"}
⚠️ 避坑提醒:长期引用与内存泄漏(WeakSet / WeakMap)
常规的 Set 和 Map 会对其持有的键和值保持强引用(Strong Reference)。如果将一个 DOM 节点或庞大的业务对象存入 Map 作为键,即使该 DOM 节点已被从页面移除,只要 Map 实例仍然存活,垃圾回收器(GC)就无法回收对应内存。若只需要将临时元数据与对象生命周期绑定,务必选用 WeakMap 或 WeakSet,其键为弱引用,当目标对象失去其他外部引用时,GC 会自动清理对应存储,杜绝内存泄漏。
五、全文总结
在现代 JavaScript 体系中,数据结构的选择直接映射到代码的表达力与运行效率:
- 当你面对的是线性展示、排序和具有序数含义的数据流时,毫无疑问首选
Array; - 当你需要确保集合成员唯一性,或者需要以极低成本(常数级)频繁判断元素是否存在时,坚决选用
Set; - 当你的核心任务是建立健壮、纯净的键值对应关系,特别是键为复杂对象、键值对在运行时高频增删变动时,应当果断选用
Map替代普通对象。
熟练将 Array 的高阶函数与 Set、Map 的哈希检索特性相结合,不仅能简化业务逻辑,更能从根本上消除代码中的不必要循环,提升应用的整体响应性能。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章