

深入解析 D3.js 在处理数万至百万级海量数据点时的性能瓶颈与优化方案。通过 Canvas 混合渲染、Quadtree 空间拾取、LTTB 降采样及视口虚拟化技术,彻底解决卡顿与内存崩溃问题。
D3.js 处理大规模数据点的性能优化策略
作者:像素漫游
时间:2026-11-05
浏览:334
文章目录
前端可视化与工程架构
核心概述:在 D3.js 传统开发模式中,当离散数据点突破数千甚至数万级别时,原生 SVG 的 DOM 树结构会引发巨大的重排重绘延迟与内存消耗。要彻底解决大规模数据下的性能卡顿,核心路径在于“解耦与治理”:将渲染层切换为 Canvas/WebGL 混合架构、采用 D3-Quadtree 实现 O(log N) 的高效空间事件拾取、配合 LTTB 与视口裁剪进行多尺度数据规约。本文将逐层拆解这些优化策略的具体落地方法与完整实现规范。
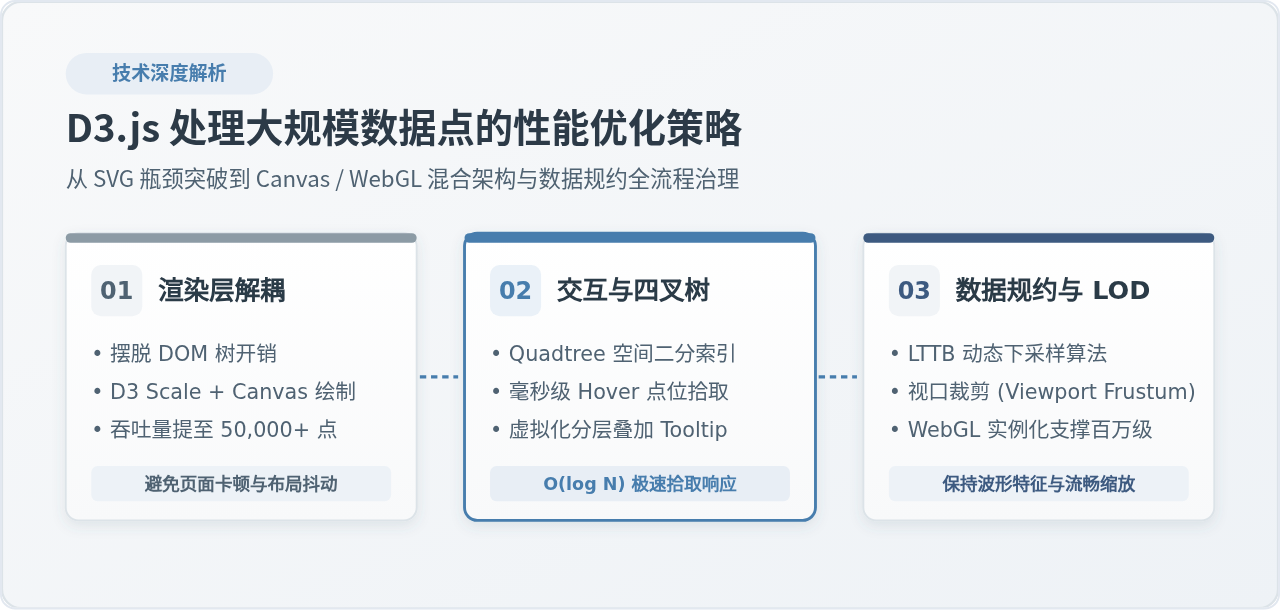
图 0:D3.js 海量数据可视化性能治理全貌与核心优化阶梯
一、SVG 渲染瓶颈剖析与渲染层解耦
在默认使用 D3.js 构建散点图或折线图时,开发者通常习惯使用 d3.selectAll('circle').data(data).enter().append('circle') 的模式。对于 1,000 个以内的点位,SVG 具有天然的矢量清晰度与便捷的事件绑定能力;然而,当数据量达到 10,000 到 50,000 点时,页面的交互帧率往往会骤降到 15 帧以下甚至直接假死崩溃。
造成这一现象的根本原因并非 D3.js 本身计算效率低,而是浏览器渲染引擎对 大量独立 DOM 节点 的管理机制所决定的:
- 内存开销倍增:在主流现代浏览器中,每一个 SVG
<circle>都是一个完整的 C++ DOM 实体对象,挂载了完整的事件监听接口、样式计算表和层叠上下文属性。5 万个 SVG 节点仅仅是 DOM 结构本身就会常驻上百兆内存。 - 排版重排树(Render Tree)过载:一旦触发平移缩放(Zoom / Pan),浏览器必须遍历每一个 DOM 节点重新计算边界盒(Bounding Box)、布局与视口交叉状态,导致主线程长时间被 JavaScript 和 Reflow 占用。
最佳的解决思路是:保留 D3.js 的核心价值——数据处理、比例尺转换(Scales)与数学几何计算,而将底层的图形输出从 SVG DOM 替换为 HTML5 Canvas。Canvas 作为一个单纯的像素光栅化容器,在 DOM 树中始终只有一个 <canvas> 节点,从物理根源上消除了 DOM 节点膨胀问题。
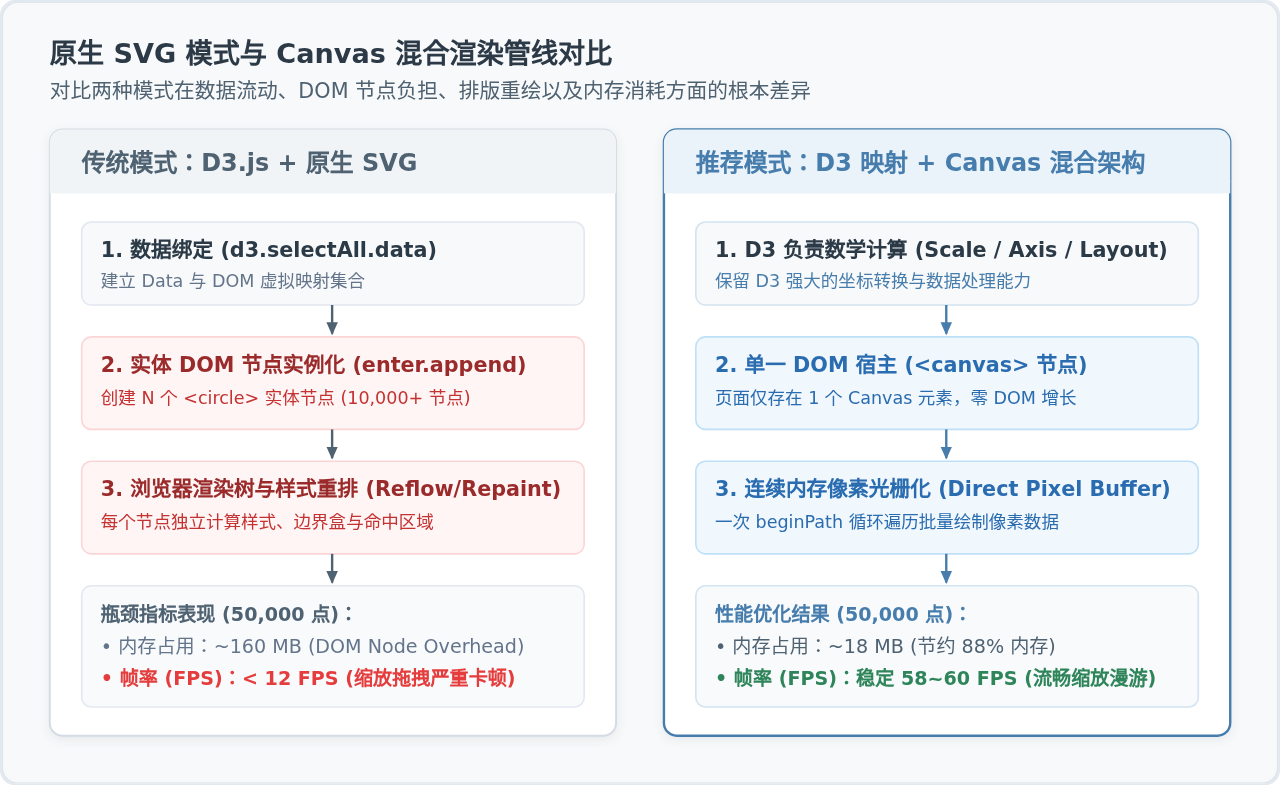
图 1:原生 D3.js SVG 模式与 Canvas 混合渲染管线与内存开销对比
D3 + Canvas 混合架构实现代码
在实际工程中,推荐采用“双层叠合”的容器设计:在底层放置用于高性能渲染散点的 <canvas>,在顶层放置只包含坐标轴和图例的极轻量 <svg>。以下是批量渲染的标准实现:
// 1. 初始化容器与画布
const width = 800;
const height = 500;
const margin = { top: 20, right: 30, bottom: 40, left: 50 };

const container = d3.select('#chart-container')
  .style('position', 'relative')
  .style('width', `${width}px`)
  .style('height', `${height}px`);

// 底层绘制海量数据点
const canvas = container.append('canvas')
  .attr('width', width * window.devicePixelRatio)
  .attr('height', height * window.devicePixelRatio)
  .style('width', `${width}px`)
  .style('height', `${height}px`)
  .style('position', 'absolute');

const ctx = canvas.node().getContext('2d');
ctx.scale(window.devicePixelRatio, window.devicePixelRatio);

// 顶层只用于渲染坐标轴与边框(DOM 节点极少)
const svg = container.append('svg')
  .attr('width', width)
  .attr('height', height)
  .style('position', 'absolute')
  .style('pointer-events', 'none'); // 让交互事件穿透到底层或统一捕获

// 2. 使用 D3 构建比例尺
const xScale = d3.scaleLinear()
  .domain([0, 100])
  .range([margin.left, width - margin.right]);

const yScale = d3.scaleLinear()
  .domain([0, 100])
  .range([height - margin.bottom, margin.top]);

// 3. Canvas 批量绘制函数(关键优化:单次 beginPath)
function drawCanvasPoints(data) {
  ctx.clearRect(0, 0, width, height);
  ctx.fillStyle = '#477DAD';

  // 关键:在循环外统一 beginPath,在循环内只移动绘制指令
  ctx.beginPath();
  for (let i = 0; i < data.length; i++) {
    const cx = xScale(data[i].x);
    const cy = yScale(data[i].y);
    ctx.moveTo(cx + 3, cy);
    ctx.arc(cx, cy, 3, 0, Math.PI * 2);
  }
  ctx.fill(); // 统一一次性提交 GPU 光栅化
}
⚠️ 性能避坑要点:避免在循环体内高频切换 Canvas 状态机
很多开发者在迁移至 Canvas 时,习惯在 for 循环内部每次都调用 ctx.beginPath()、重新赋值 ctx.fillStyle 并调用 ctx.fill()。这样会强制浏览器频繁提交绘图指令。正确的做法是将相同样式的元素合并到一个批次中,仅执行一次 ctx.fill(),性能会有 5 到 10 倍的提升。
二、Canvas 绘制下的交互拾取与空间四叉树
将渲染层切换为 Canvas 后,最直观的损失就是 失去了每个数据点的 DOM 事件监听能力。在 Canvas 画布上,鼠标移动只能获得当前的 (clientX, clientY) 物理坐标,无法直接获知鼠标停留在哪一个数据点上。
如果使用简单的数组遍历(暴力比较欧氏距离),单次鼠标移动就需要执行 $O(N)$ 次浮点数计算。当数据规模达到 50,000 点时,每一次 mousemove 都会造成明显的事件循环阻塞与微卡顿。为此,D3 官方生态提供了专用的空间索引模块——d3-quadtree。
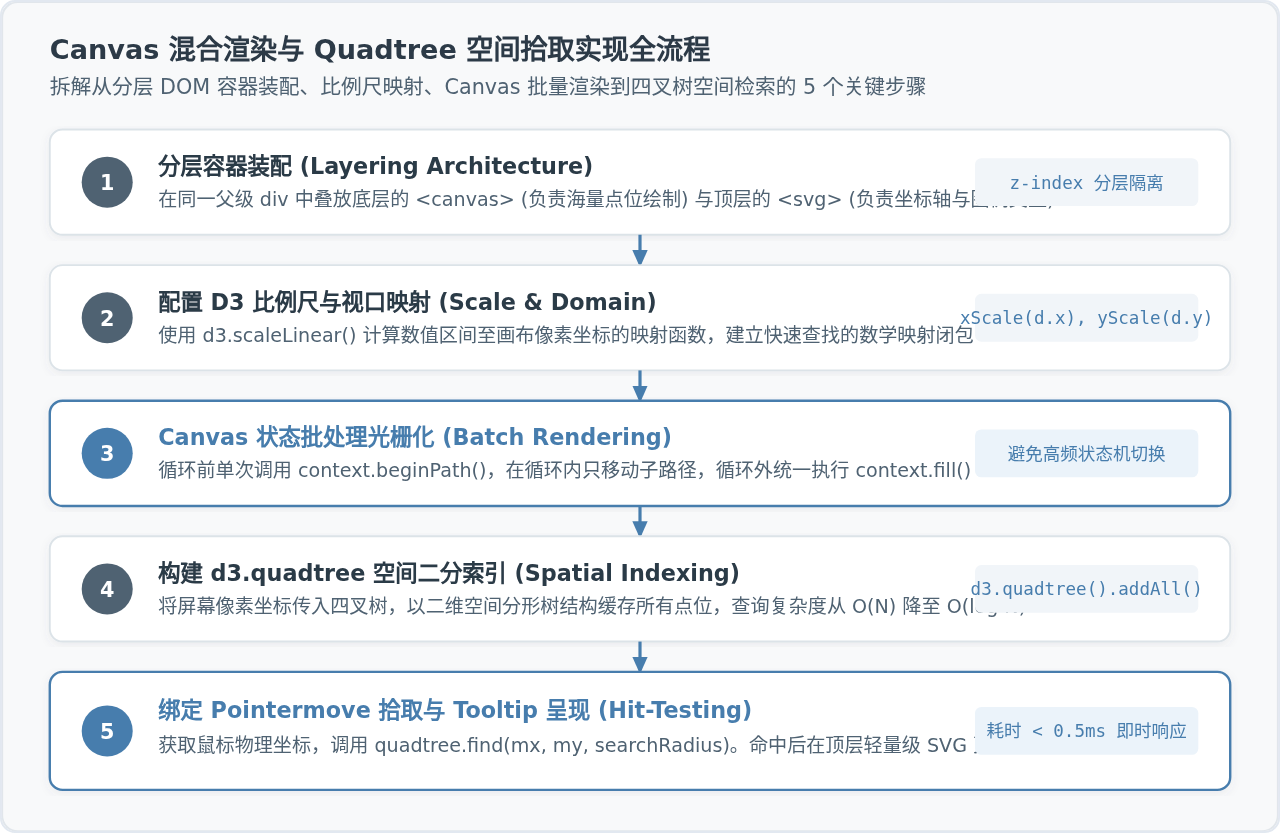
图 2:Canvas 混合渲染与 Quadtree 空间拾取事件绑定流程
空间索引与拾取实现步骤
- 构建空间四叉树:在完成数据映射后,将二维坐标点集合直接注入
d3.quadtree(),建立分层空间二分索引,构建耗时通常在 20ms 以内。 - 毫秒级空间检索:在 Canvas 容器上监听
pointermove事件,通过quadtree.find(mx, my, maxRadius)检索在指定像素半径范围内的最近邻数据点,查询时间复杂度降至 $O(\log N)$(平均耗时小于 0.2ms)。 - 动态悬浮高亮:在命中目标点后,利用顶层的轻量 SVG 容器绘制一个单点的动态环形指示器和 Tooltip 悬浮层,既保留了精准交互,又不会对主画布带来重绘扰动。
// 1. 构建四叉树索引(基于屏幕像素坐标)
const quadtree = d3.quadtree()
  .x(d => xScale(d.x))
  .y(d => yScale(d.y))
  .addAll(pointsData);

// 2. 监听顶层捕获容器的鼠标移动事件
const interactionLayer = container.append('div')
  .style('position', 'absolute')
  .style('width', `${width}px`)
  .style('height', `${height}px`)
  .style('cursor', 'crosshair');

interactionLayer.on('pointermove', function(event) {
  const [mx, my] = d3.pointer(event);

  // 查找鼠标周围 12 像素范围内的最近邻点位
  const searchRadius = 12;
  const closestPoint = quadtree.find(mx, my, searchRadius);

  if (closestPoint) {
    // 命中目标,在顶层 SVG 快速呈现单个高亮圈与 Tooltip
    updateHighlight(xScale(closestPoint.x), yScale(closestPoint.y), closestPoint);
  } else {
    clearHighlight();
  }
});
三、数据降采样与多尺度聚合(LTTB 与视口裁剪)
在屏幕物理显示场景中,普遍显示器的横向有效图表像素通常只有 1,000 到 2,000 像素左右。如果在一个 1,000 像素宽的区域内绘制 500,000 个时序点,意味着单列像素上堆叠了数百个数据点。这种堆叠不仅肉眼无法辨识,还浪费了 99% 的光栅化计算资源。
因此,对于十万级以上的工业时序与散点场景,必须在 数据输入端 进行规约:
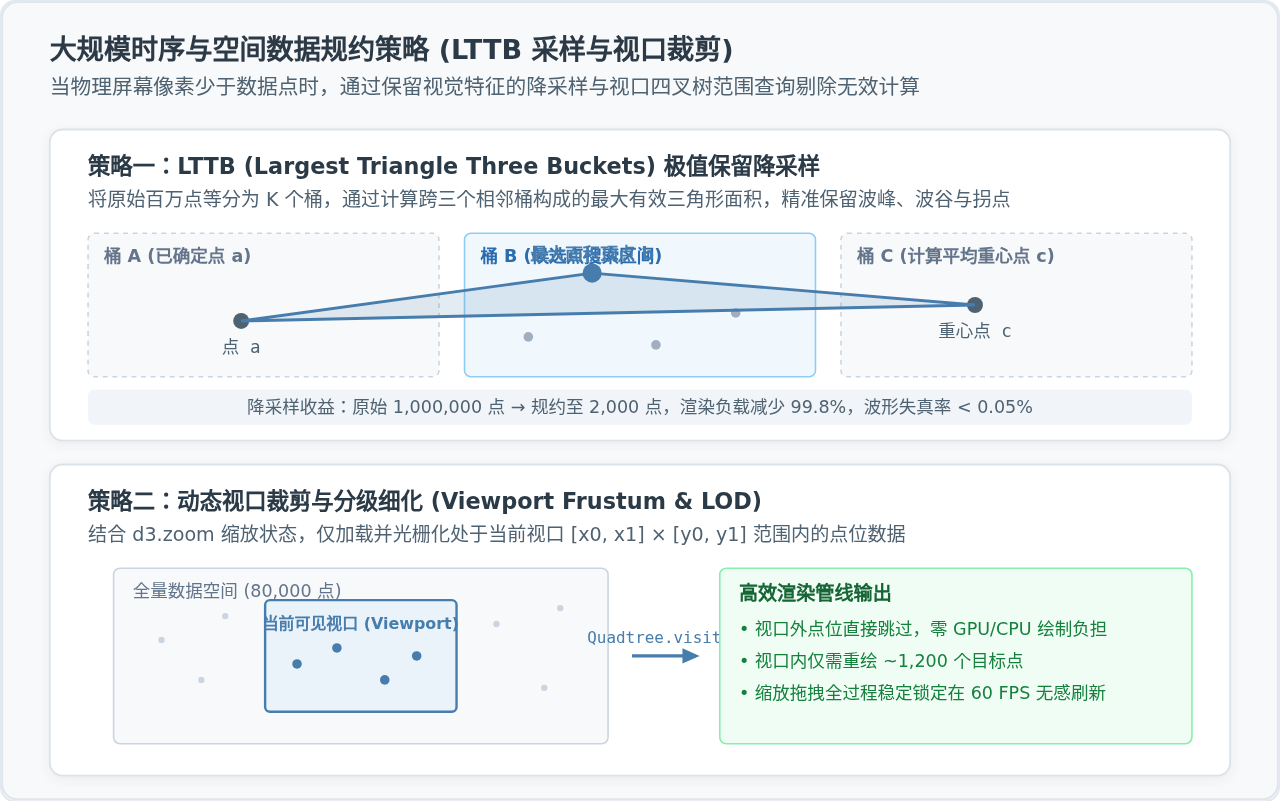
图 3:大规模时序与空间数据规约策略(LTTB 采样与视口裁剪)
1. LTTB (Largest Triangle Three Buckets) 算法
普通的均值下采样(Every Nth Point 或固定间隔平均)会直接削平数据的异常峰值与谷值,导致可视化结果产生严重的视觉失真。LTTB 算法通过构建三桶滑动窗口,以“最大三角形有效面积”为判定指标,在极大减少数据量的同时,数学上严格保留了波形的局部极值与趋势特征。
- 将原始点划分为 $K$ 个等宽区间(例如将 50 万点规约到与画布宽度等同的 1,500 点);
- 在桶与桶之间寻找使面积 $rac12|(x_A - x_C)(y_B - y_A) - (x_A - x_B)(y_C - y_A)|$ 最大的点位作为桶内保留点;
- 实践证明,规约后不仅绘制性能提升数百倍,而且波形外观与全量数据几乎完全一致。
2. 基于视口范围的动态裁剪与细化(LOD)
当结合 d3.zoom 进行拖拽缩放时,大多数数据点事实上处于当前视口之外。利用视口变换矩阵(d3.zoomTransform),在重绘之前首先过滤数据:
function getVisiblePoints(transform, allPoints) {
  // 根据缩放反推当前的实际数据 Domain 区间
  const currentXDomain = transform.rescaleX(xScale).domain();
  const currentYDomain = transform.rescaleY(yScale).domain();

  const [xMin, xMax] = currentXDomain;
  const [yMin, yMax] = currentYDomain;

  // 利用已建立的 Quadtree 快速范围裁剪,或者进行快速数值区间过滤
  return allPoints.filter(d =>
    d.x >= xMin && d.x <= xMax &&
    d.y >= yMin && d.y <= yMax
  );
}
四、极端数据规模下的 WebGL 与 Web Worker 协同
当离散点位数量进一步飙升至 20 万至 100 万级 时,即使是 Canvas 2D 的主线程绘制与纯 JS 循环也会触及浏览器的单帧绘制瓶颈(16.6ms 内无法完成全部光栅化)。此时必须引入更加底层的图形与多线程优化手段:
1. 离屏绘制与 Web Worker 数据预处理
如果数据流是实时推送或计算密集型的,应当将数据解析、清洗、比例尺映射甚至四叉树构造全部委托给 Web Worker,避免主线程在数据到来时发生假死。配合 HTML5 的 OffscreenCanvas,可以直接将画布控制权通过 canvas.transferControlToOffscreen() 转移给子线程,实现完全不依赖主线程的后台异步渲染。
2. WebGL 实例化着色(Instanced Rendering)
对于百万级点位散点图,基于 WebGL 绘制是终极方案。借助 D3 计算出归一化坐标后,直接将顶点数据写入 WebGL 的 Float32Array 缓冲。GPU 能够通过单次 Draw Call(如 gl.drawArraysInstanced)以极高的并行度一次性光栅化所有点位,且支持硬件级抗锯齿与半透明混合处理。
五、技术选型决策与性能治理矩阵
面对不同的业务场景与数据量级,并不存在唯一的最优解。过度设计引入 WebGL 会带来较高的调试维护成本,而墨守成规使用原生 SVG 则无法承载业务扩展。以下是工程实践中的分级决策指南:
| 数据规模 | 推荐渲染架构 | 交互拾取方案 | 核心优势与适用场景 |
|---|---|---|---|
| < 3,000 点 | D3.js + 原生 SVG | 原生 DOM 事件 | 开发效率最高,开箱支持 CSS 动效与矢量无损缩放。 |
| 3,000 ~ 50,000 点 | D3 比例尺 + Canvas 2D | d3-quadtree 空间检索 | 内存降低 85% 以上,维持 60 FPS 流畅拖拽,性价比最高。 |
| 50,000 ~ 200,000 点 | Canvas + LTTB 规约 + 视口裁剪 | 四叉树视口过滤 + 邻域拾取 | 根据屏幕物理分辨率智能降采样,消除无效绘制开销。 |
| > 200,000 点 | D3 逻辑 + WebGL 硬件加速 | GPU 颜色缓冲区拾取 / Worker | 彻底发挥 GPU 并行管线能力,百万级点位实时平移漫游。 |
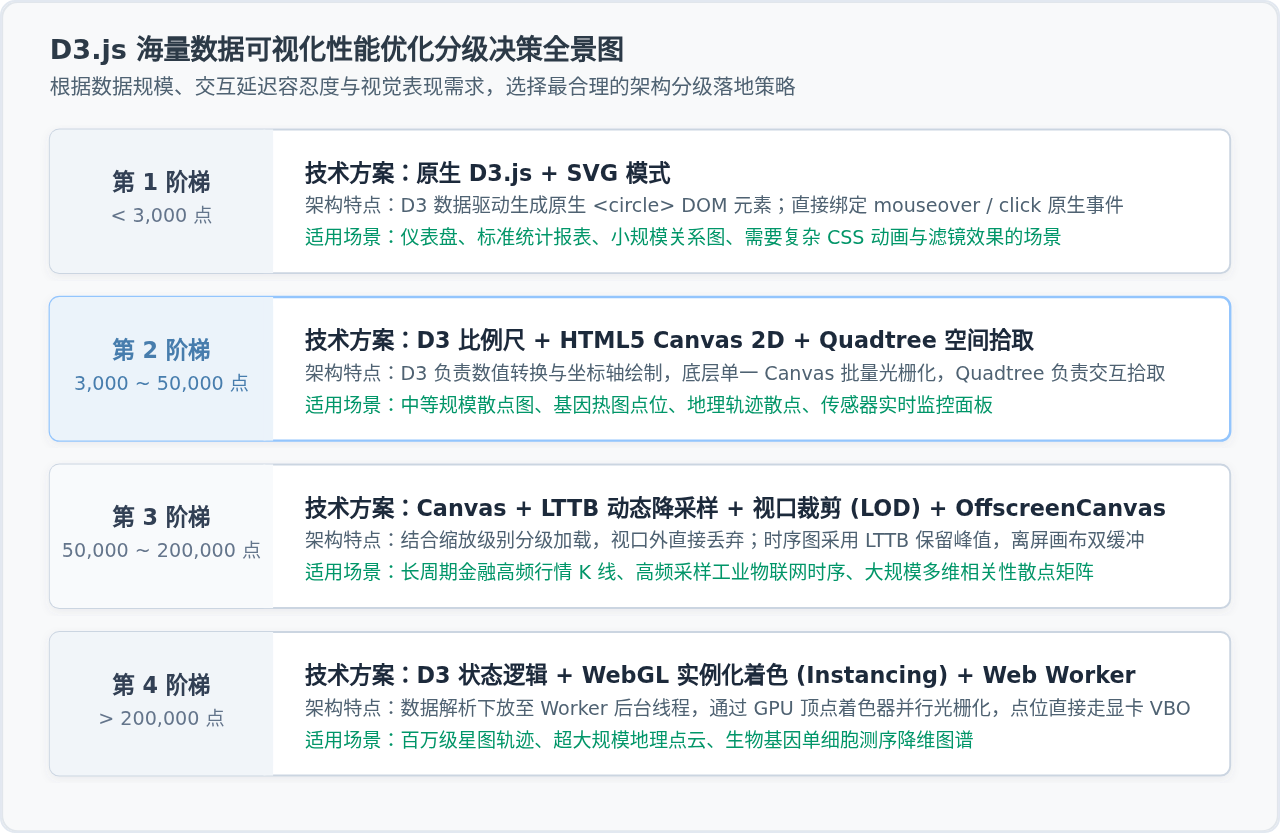
图 4:D3.js 海量数据可视化性能优化分级决策全景图
关键优化 checklist 总结
- 结构层:优先采用 Canvas 替代海量 SVG 图元,仅在顶层保留必要坐标轴。
- 循环层:杜绝在渲染循环中新建对象、闭包或触发频繁的样式更改。
- 交互层:空间索引四叉树只在数据更新时构建一次,查询时直接复用。
- 采样层:物理像素有限时,前置执行 LTTB 极值采样,坚决不绘制不可见像素。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章