

OpenCode 2.3.2 同时修正了两类冗余:webfetch 结果不再重复调用参数,GPT-6.2 的系统提示则改用可缓存的前置消息发送。前者属于工具输出整理,后者针对相关 Responses 路由的多步输入成本,两项变化的作用范围不同。
OpenCode 2.3.2 的 webfetch 输出和 GPT-6.2 缓存分别改了什么?
作者:极速慢跑
时间:2026-11-18
浏览:540
文章目录
webfetch 省略的是参数副本
本次说明明确列出,webfetch 结构化输出不再重复 url 和 format。这两个字段原本就是调用时传入的值。变化没有宣称抓取到的网页正文变少,也没有宣称网络访问更快或能够绕过网站权限限制。
因此理解工具结果时,需要区分调用上下文与返回内容。字段副本的消失只是输出结构变化,不适合用来证明网页提取质量提升。
缓存为什么与消息位置有关?
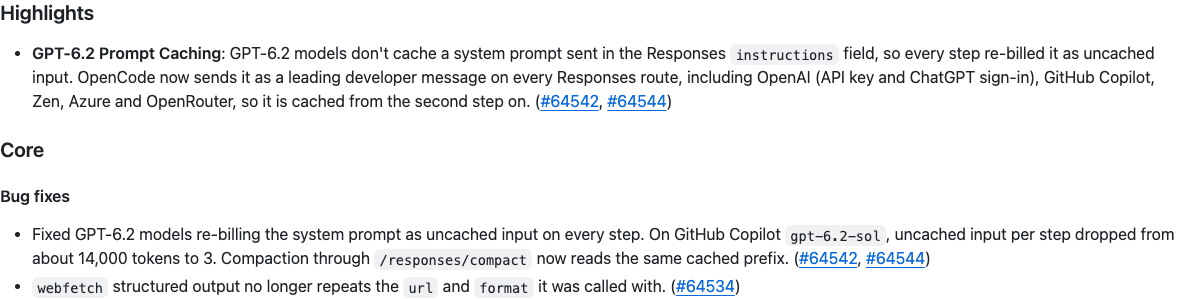
官方指出,GPT-6.2 不缓存通过 Responses instructions 字段提供的系统提示,导致多步任务每一步都重新按未缓存输入处理它。OpenCode 2.3.2 把提示调整为开头的 developer 消息,使相同前缀从第二步起可被缓存。
修复涵盖 OpenAI 的 API 密钥和 ChatGPT 登录,以及 GitHub Copilot、Zen、Azure、OpenRouter 的相关 Responses 路由。这里指的是这些路由上的对应行为,不能扩大为所有接口或所有模型的性能保证。
令牌下降案例有哪些前提?
发布说明中的数据来自 GitHub Copilot gpt-6.2-sol:每步未缓存输入约从 14,000 个令牌降至 3 个。这一官方案例它也不是总输入、输出或最终账单的通用下降比例。首步仍需要建立前缀,后续动态消息的内容也会影响实际输入。
此外,/responses/compact 现在读取相同缓存前缀。压缩流程与普通多步请求都涉及前缀复用,但不应把压缩本身与所有输入完全免费画等号。
版本范围应怎样理解?
这些内容属于正式版本 2.3.2 的发布说明。页面上的分发资产与开发分支的后续提交是不同对象,后续提交不会因为显示在同一页面就自动进入当前安装包。使用其他模型或非对应路由时,官方没有给出相同效果承诺,应以实际提供方用量记录为准。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章