
在不支持ES6模板字符串的旧版浏览器环境中,系统讲解使用加号操作符、Array.join()数组拼接以及replace()正则占位符三种传统JavaScript变量拼接方法,深入剖析类型转换机制、内存垃圾回收优化与DOM安全转义。

当前位置:首页 > JavaScript 基础 > 正文
旧版浏览器怎么用JS传统方法拼接变量
作者:极速慢跑
时间:2026-11-18
浏览:544
文章目录
在不支持 ES6 模板字符串(即反引号 `hello ${name}` 语法)的旧版浏览器环境(例如 IE6 至 IE11、老版本移动端内置 Webview 或早期标准浏览器)中,JavaScript 拼接变量主要依靠三种传统解法:使用加号运算符(+ 和 +=)进行行内求值、借助数组的 Array.prototype.join() 方法做批量缓冲合并,以及基于 String.prototype.replace() 正则编写自定义占位符函数。针对这三种经典方案,不仅要掌握基本的语法调用,还需要理清隐式类型转换、垃圾回收机制以及输入字符转义等边界细节,才能在老旧终端中写出既高效又没有逻辑漏洞的稳定代码。
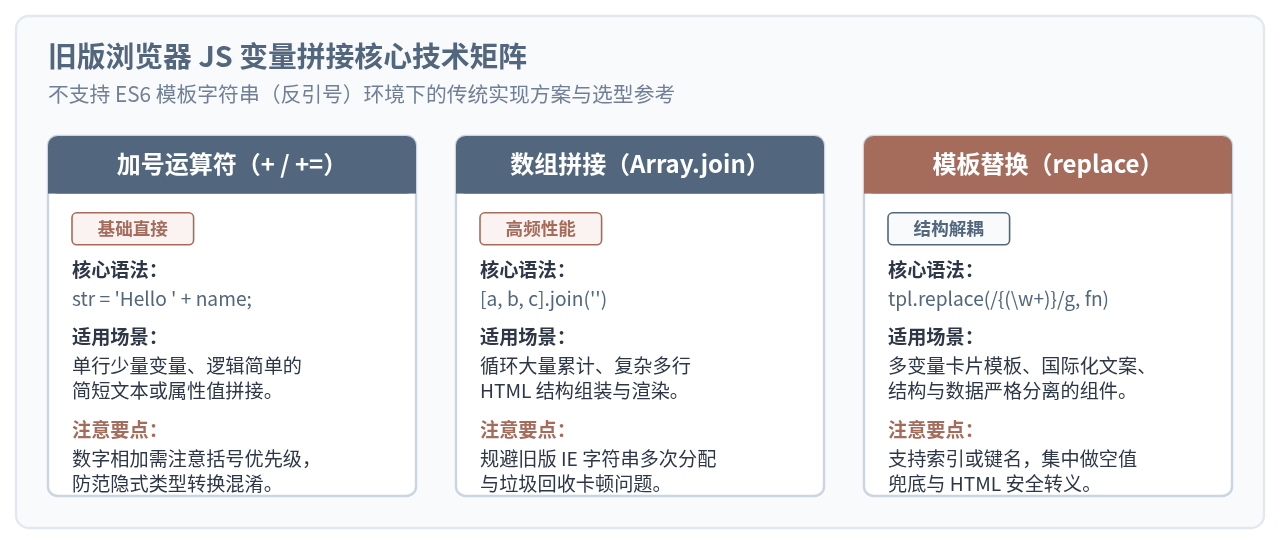
一、加号运算符(+ / +=):基础语法与隐式类型转换陷阱
使用加号运算符拼接字符串是 JavaScript 中历史最悠久、也最符合直觉的手段。当两端只要有一方是字符串时,加号就会放弃算术加法语义,转而将另一方强制转换为字符串,并把两段文本首尾相连。日常处理 1 到 2 个局部变量的简短提示或参数组合时,这种写法最简单直接。
// 基础加号拼接示例
var userName = "张三";
var loginCount = 3;

var message = "欢迎用户 " + userName + ",您今天已登录 " + loginCount + " 次。";
// 输出:"欢迎用户 张三,您今天已登录 3 次。"
不过,直接用加号拼接极易在数值相加与类型转换上栽跟头。JavaScript 中加号操作符是严格从左到右(Left-to-Right)进行结合求值的。如果在字符串出现之前先遇到了两个数值,它会先执行算术累加;反之,如果字符串出现在最左侧,后续所有数值都将被逐一降级为字符串字面量。
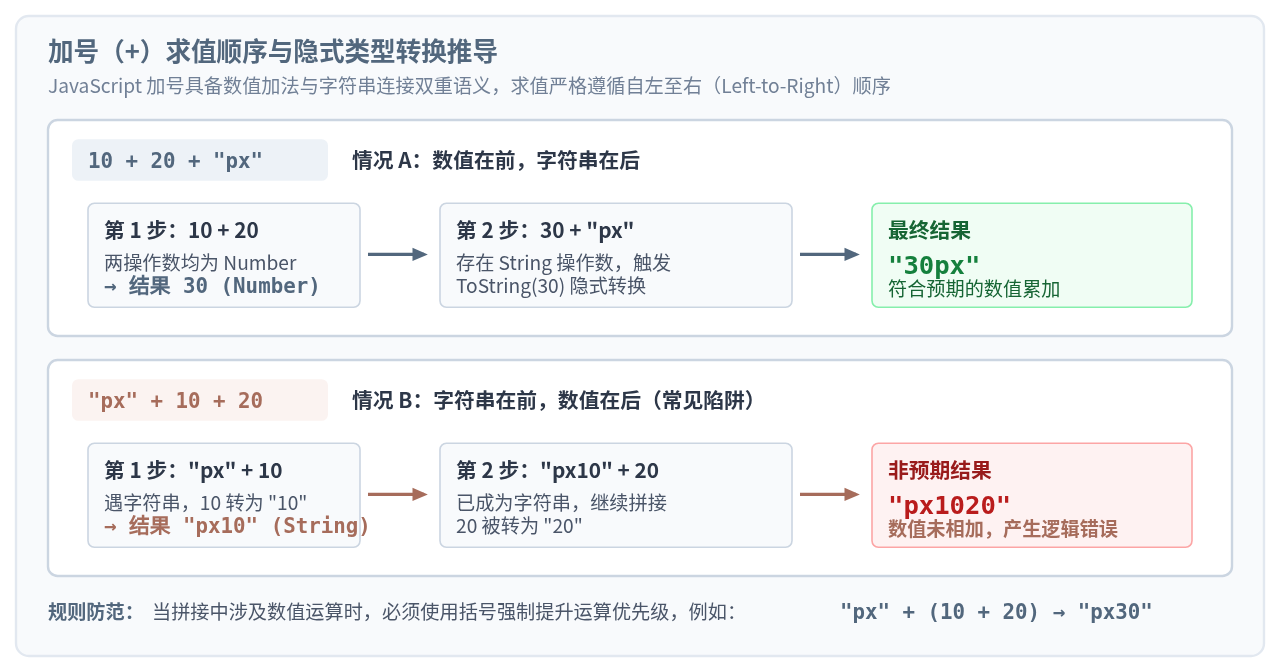
观察图 1 可以清楚看到差异:表达式 10 + 20 + "px" 会先计算 10 + 20 = 30,随后得到预期结果 "30px";但若是写成 "宽度: " + 10 + 20 + "px",左侧的字符串会导致后面的 10 和 20 全部被转为纯文本,最终拼接出非预期的 "宽度: 1020px"。在旧版项目中,只要拼接包含数值计算的变量,必须强制使用小括号提升优先级:
// 错误示例:运算顺序混淆
var widthStr = "px" + itemWidth + paddingWidth; // 得到 "px10020"

// 正确示例:显式使用括号保障算术优先
var correctWidth = "px" + (itemWidth + paddingWidth); // 得到 "px120"
警惕 null 与 undefined 的强转污染
在 ES3 与 ES5 规范中,当对 null 或 undefined 执行加号拼接时,它们并不会静默变为空白,而是被强制调用内置 ToString 规则,转化为字面量字符串 "null" 或 "undefined"。例如 "姓名: " + user.name 在变量未赋值时会直接渲染为 "姓名: undefined"。因此在拼接入库字段或用户展示时,应主动写成 (user.name || "") 或三元判断进行兜底。
二、批量与循环拼接:Array.join() 的内存优势与实现
很多开发者在旧版项目中需要动态组装表格行、商品列表或几十行 HTML 片段时,习惯顺手在 for 循环中使用 html += "<tr><td>" + data[i] + "</td></tr>"。在现代 V8 引擎中这或许已被大幅优化,但在旧版 IE(尤其是 IE6、IE7 和 IE8 的 JScript 引擎)中,这种写法会成为页面假死与性能雪崩的直接罪魁祸首。
这是由 JavaScript 字符串的“不可变性”(Immutability)决定的。在内存底层,字符串一旦创建就不能在原空间尾部追加扩容。每次执行 +=,旧版引擎必须先计算新长度,在堆内存中重新申请一块新空间,将旧字符串内容与新字符逐一复制进去,然后再将旧字符串标记为废弃。循环 1000 次,就会在堆内存中遗留 1000 个无用垃圾碎片,直接把脆弱的标记-清除垃圾回收器推向频繁 Stop-The-World 的停顿状态。
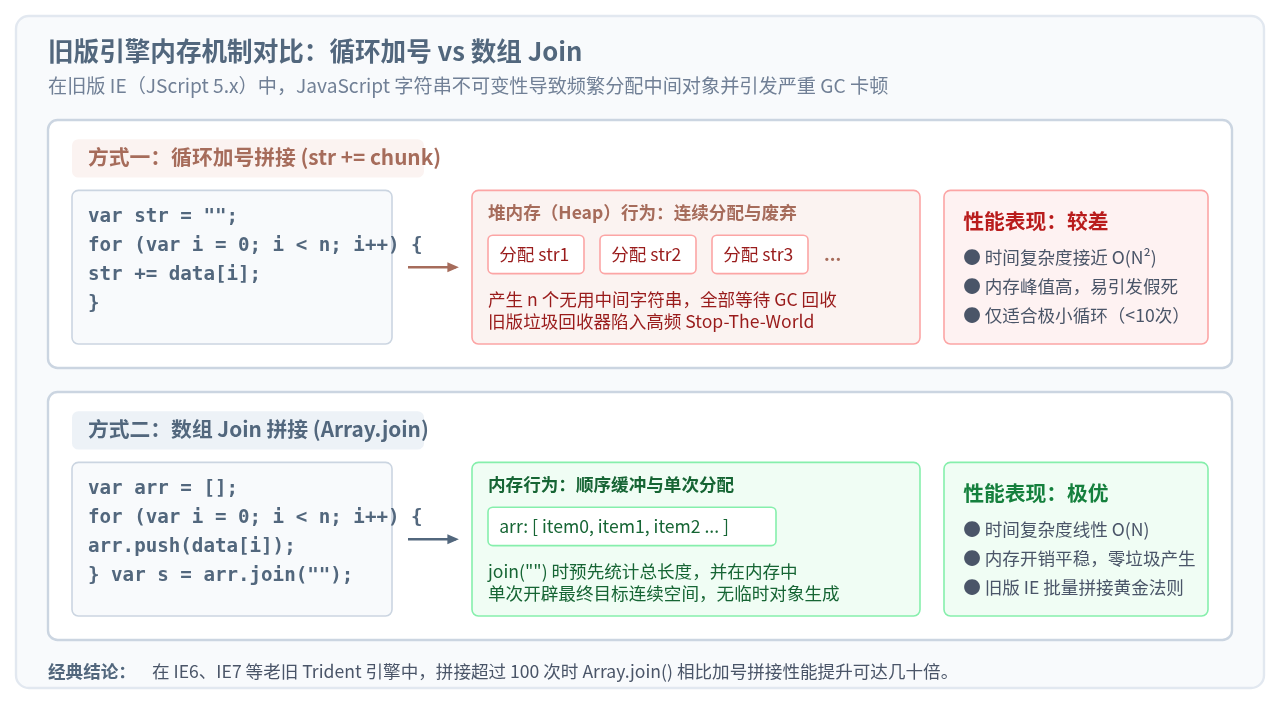
为了攻克这个性能顽疾,在旧版前端工程中普遍采用数组连接法:先声明一个空数组 var parts = [],在循环中只通过 parts.push() 将各个变量与片段推入数组;等到最后需要结果时,统一调用一次 parts.join("")。因为数组只保存元素的指针引用,不需要生成任何中间垃圾字符串;执行 join("") 时,引擎可以预先核算总体字符数,单次完成内存分配,耗时从二次方级别直降为线性复杂度。
// 传统旧版浏览器高效组装 HTML 的标准规范
function buildUserTable(userList) {
  var parts = [];
  parts.push('<table class="data-table">');
  parts.push('  <thead><tr><th>ID</th><th>用户名</th><th>状态</th></tr></thead>');
  parts.push('  <tbody>');

  for (var i = 0; i < userList.length; i++) {
    var user = userList[i];
    parts.push('    <tr>');
    parts.push('      <td>' + user.id + '</td>');
    parts.push('      <td>' + (user.name || '') + '</td>');
    parts.push('      <td>' + (user.active ? '在线' : '离线') + '</td>');
    parts.push('    </tr>');
  }

  parts.push('  </tbody>');
  parts.push('</table>');

  return parts.join('');
}
在旧版 IE 环境下测试,组装几千行表格时,使用 Array.join('') 比反复使用 str += ... 快上数十倍甚至上百倍。除了性能优势,把每行标签分拆在 push() 中还规避了旧版 JS 不支持多行字符串导致的断行语法报错。
三、模拟模板字符串:基于 replace() 的占位符替换函数
当变量交织在长段说明文案或复杂 UI 结构中时,连续的引号、加号以及转义符会让代码的可读性变得极差,后期修改一段 HTML 属性时极易丢失单引号导致语法报错。在缺乏 ES6 模板标签能力的旧版环境中,业界最推崇的做法是编写一段兼容全部 ES3 浏览器的占位符替换工具函数。
String.prototype.replace() 在 ES3 规范中就已经支持正则表达式与匹配回调函数。我们可以约定 {0}、{1} 这样的数字索引,也可以约定 {name} 这样的语义化键名,让模板结构与动态数据彻底解耦。
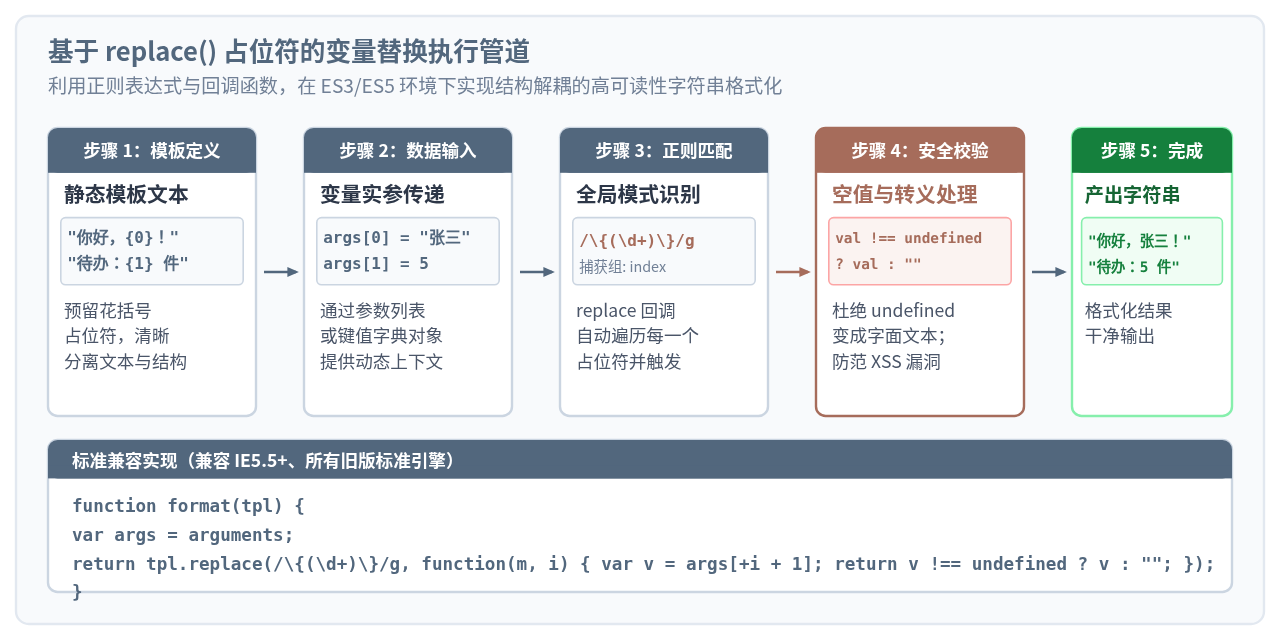
基于数字索引占位符的格式化函数实现非常精简,仅需几行代码即可向下兼容至 IE5.5:
// 基于 arguments 索引的格式化函数(兼容所有旧版浏览器)
function formatString(template) {
  var args = arguments;
  return template.replace(/\{(\d+)\}/g, function(match, index) {
    var paramIndex = parseInt(index, 10) + 1;
    var value = args[paramIndex];
    return (value !== undefined && value !== null) ? value : "";
  });
}

// 使用示例:
var tpl = "尊敬的 {0},您的订单 {1} 已发货,预计 {2} 天内送达。";
var notice = formatString(tpl, "李经理", "SO-20261117", 2);
// 输出:"尊敬的 李经理,您的订单 SO-20261117 已发货,预计 2 天内送达。"
如果希望在组件化开发中按对象属性进行填充,可以扩展为基于键名替换的字典渲染器:
// 基于对象键值的轻量渲染函数
function renderTemplate(template, data) {
  return template.replace(/\{([a-zA-Z0-9_]+)\}/g, function(match, key) {
    if (data.hasOwnProperty(key)) {
      var val = data[key];
      return (val !== undefined && val !== null) ? val : "";
    }
    return "";
  });
}

// 使用示例:
var cardTpl = '<div class="badge">项目:{title} | 负责人:{owner}</div>';
var rendered = renderTemplate(cardTpl, { title: "旧系统兼容改造", owner: "技术组" });
这种做法的最大价值在于“将模板当做纯文本对待”。前端开发人员甚至可以将模板写在页面内联的 <script type="text/template" id="myTpl"> 标签内,运行时通过 document.getElementById('myTpl').innerHTML 读取,免去了在 JavaScript 脚本中手动拼装成百上千个引号的繁重劳动。
四、防范 XSS 漏洞与多行代码书写防错
无论采用上述哪种拼接手段,一旦拼接后的字符串需要赋值给 DOM 节点的 innerHTML,就必须时刻警惕跨站脚本(XSS)风险。现代框架(如 React、Vue)通常具备模板自动转义机制,而在使用传统方法维护旧版浏览器系统时,所有转义责任都落在开发者手中。
例如,若用户输入的昵称是 <script>alert(1)</script> 或包含非闭合双引号的属性截断符,未做转义直接拼入 HTML,就会在浏览器解析时执行恶意脚本。在 ES3 环境下,应当封装标准且高效的 HTML 实体转义方法:
// 旧版通用 HTML 实体转义函数
function escapeHtml(str) {
if (str === null || str === undefined) return "";
return String(str)
.replace(/&/g, "&")
.replace(/</g, "<")
.replace(/>/g, ">")
.replace(/"/g, """)
.replace(/'/g, "'");
}
// 安全拼接示例
var rawInput = '<img src="x" onerror="alert(1)">';
var safeHtml = '<span title="' + escapeHtml(rawInput) + '">' + escapeHtml(rawInput) + '</span>';另一个容易引发语法崩溃的细节是多行字符串书写。在旧版 JS 中,字符串常量绝对不允许直接跨行换行,否则会抛出 SyntaxError: unterminated string literal。虽然可以通过在行尾添加反斜杠 \ 来做续行,但在旧版 IE 下,如果反斜杠后面不小心混入了一个不可见的空格或制表符,续行功能会立刻失效并报语法错误。因此,多行文本最稳妥的书写方式仍然是使用数组按行分割,或者在每行末尾显式闭合单引号并加上 + 号。
五、方法选型决策与关键规范总结
在面对旧版浏览器的业务维护或兼容性开发时,可以根据下表对三种主要方案的特性做出清晰判定:
| 拼接方式 | 语法复杂度 | 旧版执行性能 | 代码维护性 | 最佳适用场景 |
|---|---|---|---|---|
| 加号运算符 (+) | 极低(内置支持) | 单次极快,大循环较差 | 多变量时可读性差 | 单行少量变量、URL 参数、短属性值 |
| Array.join('') | 较低(需维护数组) | 大循环与长字符串最优 | 结构清晰,无折行问题 | 循环列表构建、复杂表格、多行 HTML |
| replace() 模板函数 | 中等(需封装工具函数) | 正则耗时微小,整体平稳 | 最高,数据与模板完全分离 | 卡片结构、多语言国际化文案、消息提示 |
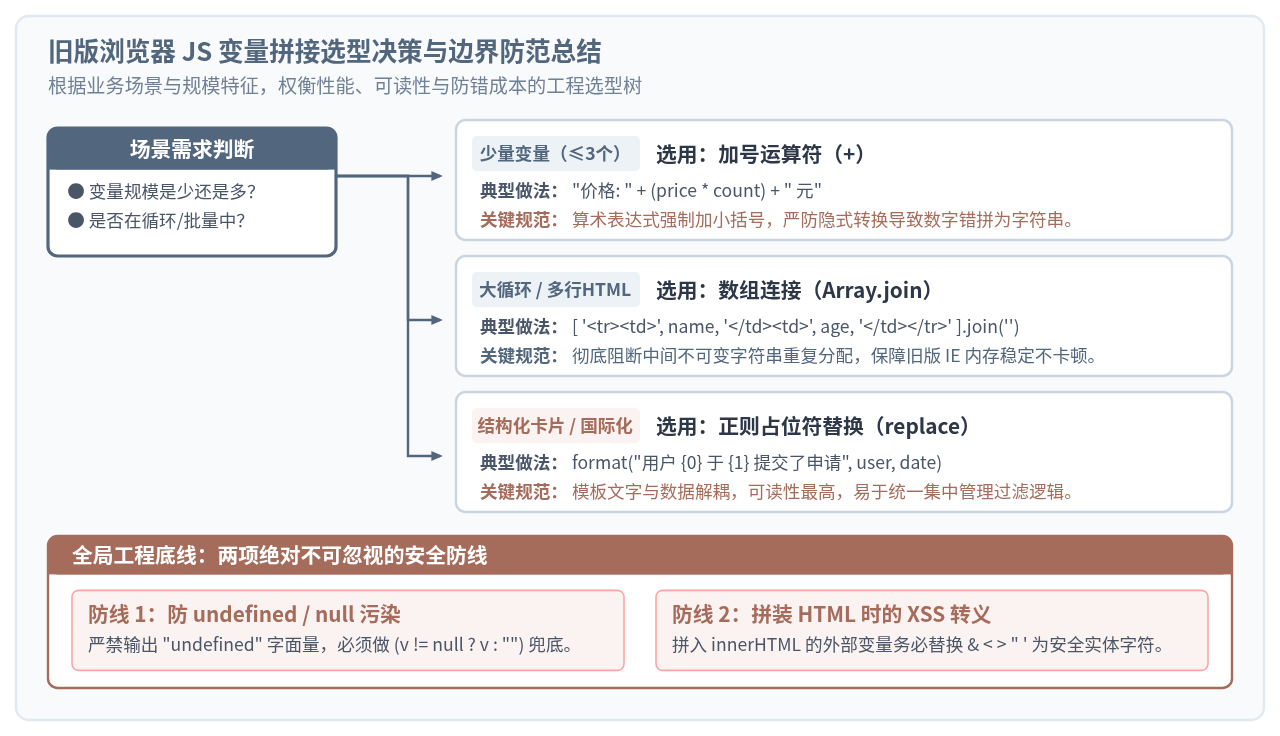
总体而言,在缺乏现代化编译工具链(如 Babel)与现代运行时的旧版浏览器环境中,并不存在唯一的最优解,而是需要根据业务场景精准对齐:对于少于 3 个变量的单行拼接,使用加号搭配小括号是最轻量化的选择;对于涉及大量循环、表格渲染与多行文档的场景,必须严格采用 Array.join('') 以规避旧版 JScript 引擎的垃圾回收停顿;而在处理复合 UI 卡片或国际化消息时,编写基于 replace() 的格式化函数则是提升工程可维护性的首选。守住防 null/undefined 污染与严格转义 XSS 两道底线,就能在旧版浏览器中稳定、高效地完成所有变量拼接任务。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章