

深入讲解JavaScript中安全解析不可信JSON数据的完整方案,涵盖语法异常隔离、原型污染防御、大整数精度保真、深层嵌套防护以及Schema白名单契约校验。
JS中怎么安全解析不可信的JSON数据
作者:慢半拍
时间:2026-11-21
浏览:472
文章目录
前端与Node.js安全实践
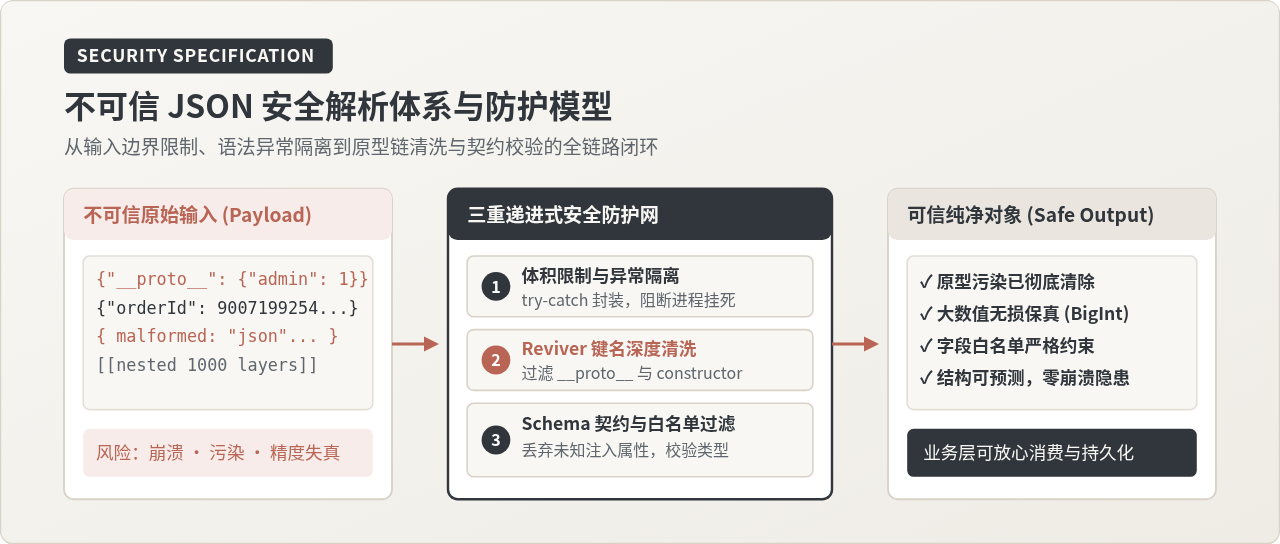
图 0:不可信 JSON 安全解析体系与纵深防护模型
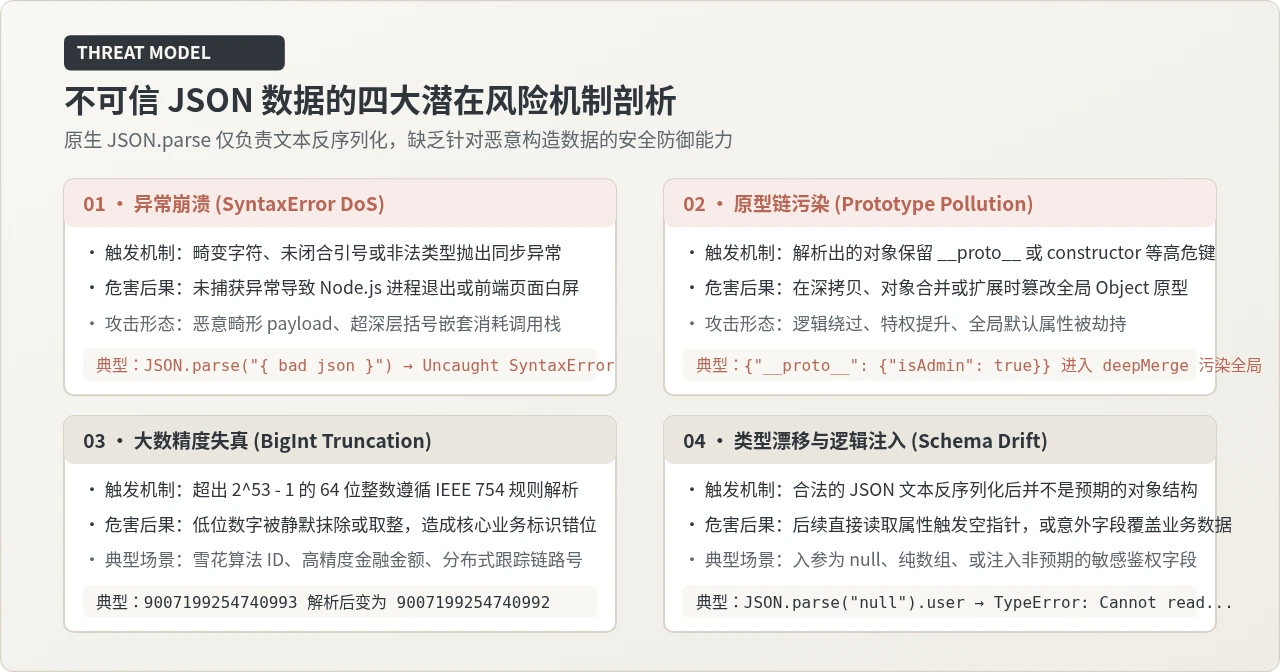
图 1:不可信 JSON 数据的四大潜在风险机制剖析
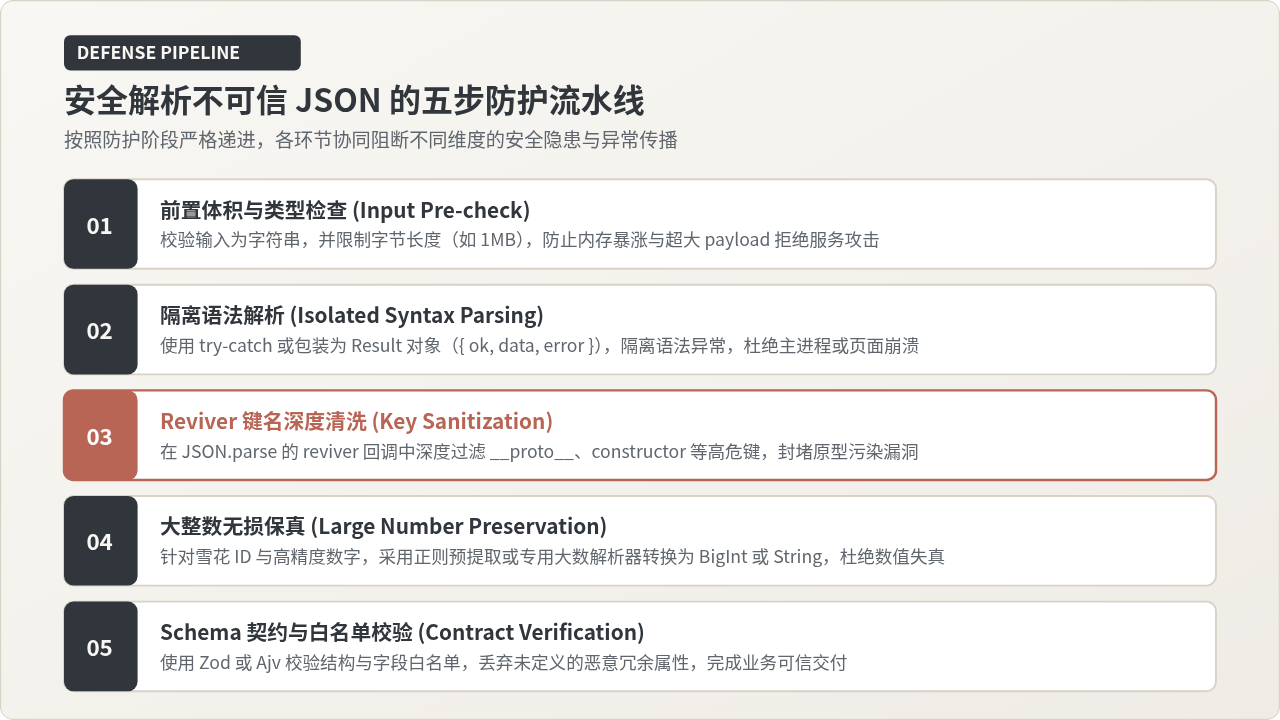
图 2:安全解析不可信 JSON 的五步防护流水线
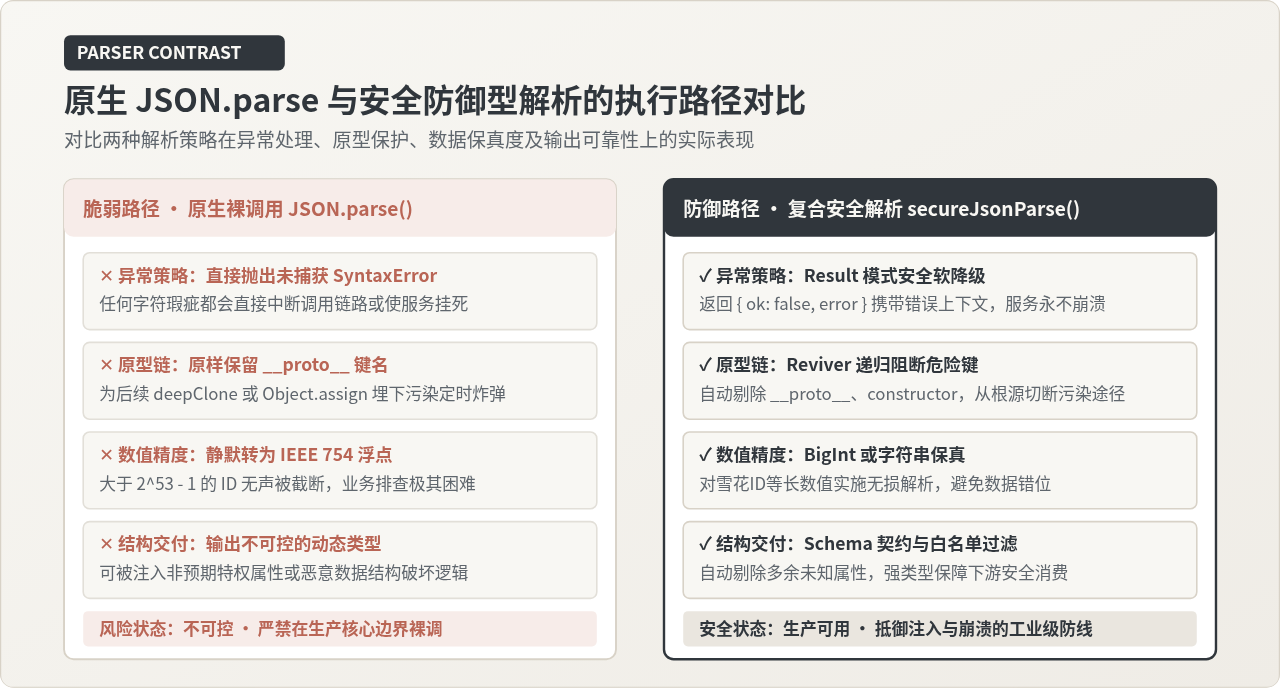
图 3:原生 JSON.parse 与防御型解析的执行路径对比
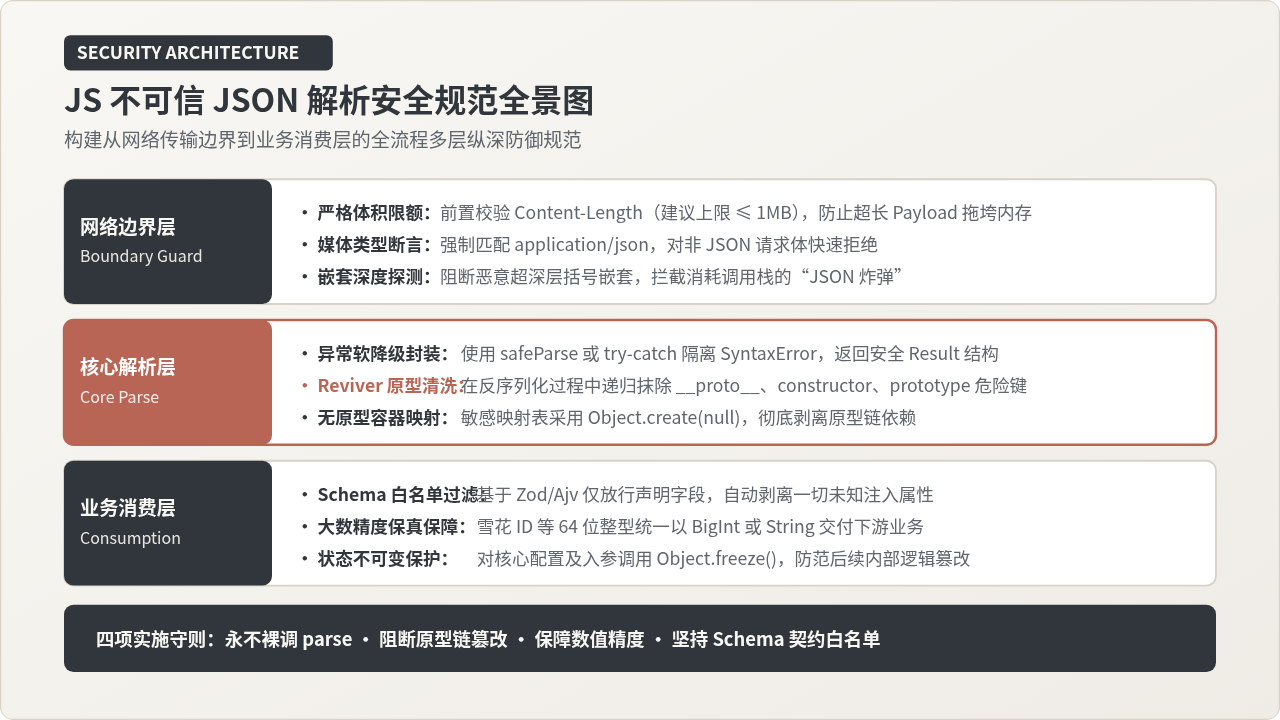
图 4:JS 不可信 JSON 解析安全规范全景图
在 JavaScript 环境中解析外部接口、用户上传或第三方 Webhook 等不可信 JSON 字符串时,直接调用原生 JSON.parse 存在未捕获异常导致进程崩溃、原型污染注入(Prototype Pollution)、超长数字精度截断以及结构漂移等严重安全隐患。实现安全解析的核心路径包括四个必经步骤:前置体积与深度守卫、异常隔离捕获、自定义 reviver 过滤危险原型属性,以及在反序列化后通过 Schema 校验器实施白名单清洗。
一、原生 JSON.parse 面对不可信数据时的四类核心风险
许多开发者误以为只要放弃危险的 eval()、全面拥抱标准的 JSON.parse(),数据反序列化就是绝对安全的。实际上,JSON.parse 的设计初衷是快速进行格式还原,并未内置防御恶意构造数据的业务级沙箱机制。当处理源自网络公共边界、用户输入或未经签名的第三方数据时,直接解析会面临以下四种确定性的风险:
- 格式畸变导致的异常崩溃(SyntaxError DoS):
JSON.parse一旦遇到单引号、末尾多余逗号、非法转义符或未闭合括号,会立即抛出同步的SyntaxError异常。若调用处未作严密的异常捕获,在 Node.js 服务端会导致整个事件循环挂起或工作进程退出,在浏览器端则直接中断后续脚本执行导致页面白屏。 - 隐式原型污染(Prototype Pollution): JSON 规范允许键名为
"__proto__"或"constructor"。虽然原生JSON.parse自身只生成普通属性,但如果下游代码对解析结果执行浅拷贝(如Object.assign)、深合并(deepMerge)或递归扩展操作,该恶意属性就会直接注入全局Object.prototype,导致全局属性被劫持或越权访问。 - 超大数字的精度静默截断(BigInt Precision Loss): JavaScript 原生采用 IEEE 754 双精度 64 位浮点数表示所有数字,其能够安全表达的最大连续整数为
Number.MAX_SAFE_INTEGER(即 253 - 1,9007199254740991)。一旦不可信数据中包含雪花算法生成的 64 位分布式 ID、交易订单号或高精度哈希值,超出部分将被静默舍入,导致严重的数据错位与越权风险。 - 结构漂移与非法数据类型注入(Schema Drift): 合法的 JSON 文本不仅可以是对象,还可以是裸数字、纯字符串、布尔值甚至是
null(例如JSON.parse("null")返回null)。若业务逻辑默认期望对象并直接执行data.user.role,将立刻触发致命的TypeError: Cannot read properties of null。此外,恶意攻击者还可以注入超出预期的特权属性(如isAdmin: true)。
二、基础防线:输入前置约束与语法异常隔离
保障安全的第一步不是立即开始解析,而是在网络入口与函数边界对输入源进行物理维度的限额拦截。未经验证就允许解析几十兆字节的文本,容易造成高 CPU 消耗与 V8 堆内存溢出(OOM)。
1. 限制输入体积与原始类型
在 Node.js 服务端处理 HTTP 请求时,应当严格在反向代理(如 Nginx)或中间件层配置 limit 上限(常规业务建议不超过 1MB)。在本地函数内部解析字符串时,务必首先确认入参是合法的字符串类型,并断言其长度:
function assertInputString(rawInput, maxByteLength = 1024 * 1024) {
  if (typeof rawInput !== 'string') {
    throw new TypeError('JSON 输入必须是字符串类型');
  }
  // 按照 UTF-8 字节长度或字符长度建立硬防线
  if (rawInput.length > maxByteLength) {
    throw new RangeError(`JSON 文本体积超限,最大允许 ${maxByteLength} 字符`);
  }
}
2. 封装结构化的安全解析器(Result 模式)
为了彻底消除因疏忽遗漏 try...catch 导致的未捕获异常中断,工程实践中应当采用类似 Rust 或 Go 的 Result 模式封装解析调用,将异常转化为可预测的对象返回:
/**
 * 基础安全语法解析包装器
 * @param {string} text - 待解析的 JSON 字符串
 * @returns {{ ok: true, data: unknown } | { ok: false, error: Error }}
 */
function safeJsonParse(text) {
  try {
    assertInputString(text);
    const data = JSON.parse(text);
    return { ok: true, data };
  } catch (err) {
    return {
      ok: false,
      error: err instanceof Error ? err : new Error(String(err))
    };
  }
}
通过将异常转化为数据值,调用方被迫在使用前通过 if (!result.ok) 检查解析状态,不仅避免了服务崩溃,还能保留详细的错误堆栈便于安全审计。
三、阻断原型污染:利用 Reviver 函数深度清洗恶意键
原型污染(Prototype Pollution)是 JavaScript 对象模型特有的高危漏洞。许多团队认为只要不在服务端执行 eval 就万无一失,然而一旦攻击者传入形如 {"__proto__": {"polluted": true}} 的载荷,并在下游被深度合并类工具处理,整个应用运行时的所有对象都会继承该恶意属性。
1. Reviver 转换函数的介入机制
JSON.parse 原生支持第二个参数 reviver 函数。该函数会在每个键值对被还原时自底向上递归执行。如果 reviver 返回 undefined,该属性就会从最终生成的对象中被直接抹除。
需要特别警惕的键包括:__proto__、constructor 以及 prototype。我们可以编写一个安全清洗转换器:
/**
 * 原型污染防护 Reviver 函数
 * 当检测到高危原型键时直接剔除,阻止其潜入下游
 */
function secureReviver(key, value) {
  // 拦截原型链关键标识符
  if (key === '__proto__' || key === 'constructor' || key === 'prototype') {
    // 在生产环境可以记录安全告警日志
    console.warn(`[Security Alert] 拦截到潜在原型污染键: "${key}"`);
    return undefined; // 返回 undefined 代表剔除该属性
  }
  return value;
}

// 使用方式:
const untrustedPayload = '{"user": "guest", "__proto__": {"isAdmin": true}}';
const cleaned = JSON.parse(untrustedPayload, secureReviver);

console.log(cleaned); // 输出: { user: 'guest' }
console.log(Object.prototype.isAdmin); // 输出: undefined,全局原型安全无虞
⚠️ 注意事项与边界情况
在旧版 Node.js 或某些非标准 JavaScript 引擎实现中,当 "__proto__" 作为顶层键时,reviver 行为可能存在边缘差异。因此,除了在 reviver 中剔除外,在业务存储时还可以将容器对象声明为 Object.create(null),使字典本身不具备任何原型链。
四、高精度保真与执行路径对比:大整数与深层嵌套处理
除了格式与原型链问题,生产环境中由数值精度引发的业务灾难同样频繁。例如微服务架构中广泛采用的 64 位雪花算法 ID(如 18446744073709551615),经由默认的 JSON.parse 转化后会直接丢失最低几位数字,导致查询到错误的用户数据或错误的订单状态。
1. 超大整数的保真方案
由于原生 JSON.parse 在将数字传递给 reviver 之前就已经将其转换为了 Number 浮点数,单纯在 reviver 中执行 BigInt(value) 已经无法挽回截断失真。解决该问题通常有两种可行策略:
- 协议层规范化(最推荐): 在服务端序列化时,强制要求分布式 ID 与大金额统一以 String 字符串格式输出(如
{"orderId": "9007199254740993"}),杜绝在传输层触发浮点数转换。 - 前置正则替换或无损解析库: 若无法修改外部不可信数据源,可在传入
JSON.parse前使用精确正则将超出安全范围的数字字面量包裹为字符串,或者采用成熟的json-bigint、lossless-json专用解析库。
/**
 * 针对长整型的轻量级预转换函数
 * 将超过 15 位的连续纯数字字面量替换为字符串形式
 */
function protectLargeIntegers(jsonString) {
  // 匹配未被引号包裹的 16 位以上长整数
  return jsonString.replace(/([:\[,]\s*)([0-9]{16,})(\s*[,\}\]])/g, '$1"$2"$3');
}
2. 嵌套深度检测与“JSON 炸弹”拦截
攻击者构造的超深层嵌套结构(如数千层括号 [[[[...]]]])虽然可能只有几十 KB,但解析时会在 V8 引擎内部消耗极大的调用栈,引发 RangeError: Maximum call stack size exceeded。可以在解析前进行低成本的单次字符扫描,验证括号嵌套深度:
function assertMaxNestingDepth(jsonString, maxDepth = 50) {
  let depth = 0;
  for (let i = 0; i < jsonString.length; i++) {
    const char = jsonString[i];
    if (char === '{' || char === '[') {
      depth++;
      if (depth > maxDepth) {
        throw new Error(`JSON 嵌套层级超出安全阈值: ${maxDepth}`);
      }
    } else if (char === '}' || char === ']') {
      depth--;
    }
  }
}
五、终极安全交付:结合 Schema 实施白名单契约校验
解析得到一个没有原型的 JavaScript 对象并不代表数据已经安全。如果接口只需要 name 和 age,攻击者传入的 role: "admin" 或 discount: 0 可能会直接污染后续的数据库更新逻辑(Mass Assignment 批量赋值漏洞)。
因此,安全解析不可信数据的最后一步,必须是强类型契约校验与未知字段剥离。现代工程中普遍采用 Zod 或 Ajv(基于 JSON Schema 标准)实现这一目标。
1. 基于 Zod 构建安全解析闭环示例
import { z } from 'zod';

// 1. 定义严格的业务数据契约模型
const UserProfileSchema = z.object({
  id: z.string().min(1),
  nickname: z.string().max(32),
  age: z.number().int().min(0).max(150),
  tags: z.array(z.string()).default([])
}).strict(); // strict() 模式会自动拒绝任何未声明的冗余字段!

/**
 * 工业级不可信 JSON 安全解析全流程函数
 */
function parseUntrustedJson(rawString, schema) {
  // 步骤 1:体积与前置深度检查
  assertInputString(rawString, 1024 * 512); // 限制 512KB
  assertMaxNestingDepth(rawString, 30);      // 限制 30 层嵌套

  // 步骤 2 & 3:隔离解析与原型键清洗
  let rawParsed;
  try {
    rawParsed = JSON.parse(rawString, secureReviver);
  } catch (err) {
    return { ok: false, error: new Error(`语法格式非法: ${err.message}`) };
  }

  // 步骤 4:类型收敛断言(排除 null 与非对象)
  if (typeof rawParsed !== 'object' || rawParsed === null) {
    return { ok: false, error: new Error('JSON 解析结果必须为非空结构体') };
  }

  // 步骤 5:基于 Schema 强校验业务契约
  const validationResult = schema.safeParse(rawParsed);
  if (!validationResult.success) {
    return {
      ok: false,
      error: new Error(`数据契约违规: ${validationResult.error.message}`)
    };
  }

  // 安全返回校验后的清洗纯净数据
  return { ok: true, data: validationResult.data };
}
六、生产环境实施清单与高频疑问解答
| 防护维度 | 标准推荐措施 | 防范的主要安全隐患 |
|---|---|---|
| 输入入口 | 严格限制 Content-Length 上限(≤ 1MB)及字符串类型 | 大包内存膨胀、OOM 拒绝服务 |
| 调用隔离 | 全量使用 try...catch 或 Result 模式包装 | SyntaxError 导致服务进程挂死或页面白屏 |
| 原型链防范 | 配置 secureReviver 剔除 __proto__ 与 constructor |
深合并/拷贝引发的全局原型污染 |
| 数值精度 | 网络传输层使用字符串传输 ID,或引入大数无损解析库 | 64 位长整数低位截断导致的串号与错单 |
| 消费交付 | 集成 Zod/Ajv 进行白名单过滤与结构契约强断言 | 类型漂移、参数篡改与 Mass Assignment 漏洞 |
常见疑问澄清
问:浏览器端使用 fetch() 的 res.json() 是否天然安全?
答:res.json() 底层调用的正是浏览器的原生 JSON 反序列化引擎。如果接口返回格式畸变,它会返回一个 Rejected 的 Promise;但它不会过滤 __proto__,也不会阻止 64 位大整数截断,更不会校验返回的数据是否符合前端预期。因此,即使是 res.json(),在处理不受信的第三方 API 时,依然需要在获取数据后通过 Schema 校验器进行清洗。
问:给 reviver 增加检查是否会严重降低解析性能?
答:基准测试表明,在处理常规体积(几十 KB 以内)的业务报文时,reviver 带来的微秒级额外耗时相比于网络 I/O 完全可以忽略不计。只有在极端高频的流式日志或大数据网关中,才需要考虑基于 C++ 原生扩展的预编译 Schema 解析器(如 Fastify 内置的 secure-json-parse 方案)。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章