
详细讲解如何在前端和Node.js项目中批量检测并将JS文件统一转换为无BOM的标准UTF-8编码,涵盖Node.js跨平台脚本、Linux/macOS终端管道、Windows PowerShell原生脚本及转码后的验收与工程化防范。

当前位置:首页 > JavaScript 代码规范与重构 > 正文
怎么批量将项目中的JS文件编码统一转换为UTF-8
作者:慢半拍
时间:2026-11-20
浏览:574
文章目录
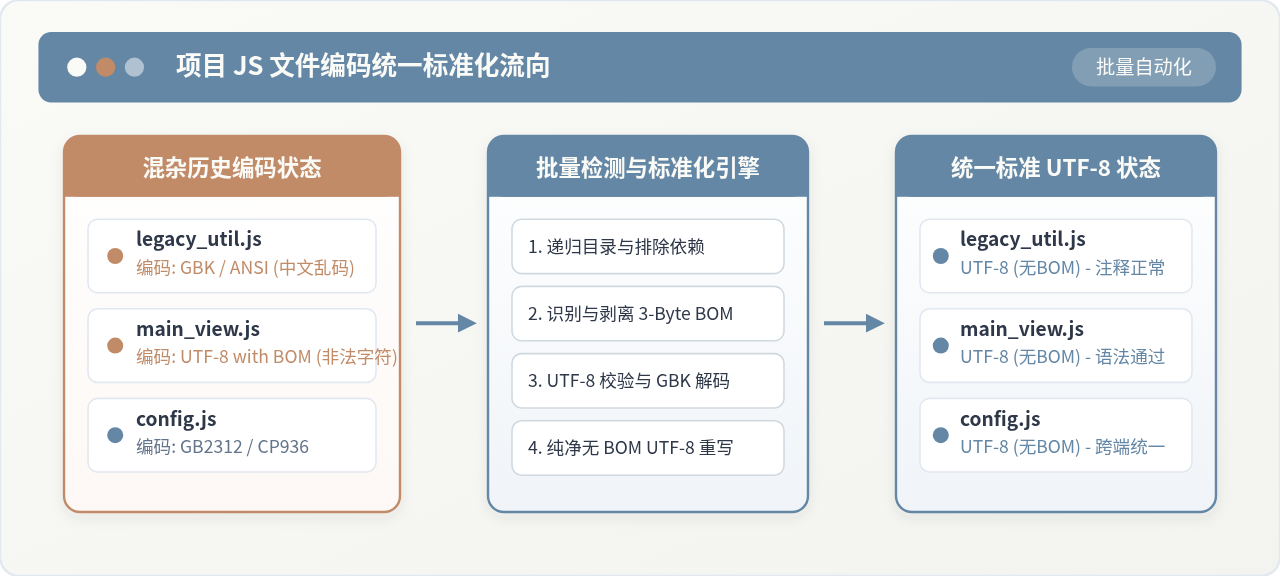
在长期维护或团队协作的前端项目中,因不同历史时期开发工具的默认设置(如早期 Windows 下的 GBK/ANSI、记事本自动附加的 UTF-8 BOM),常会导致 JS 源码文件编码混杂,在现代构建工具(Vite、Webpack、ESBuild)打包或跨操作系统协作时引发中文注释乱码甚至语法报错。批量将项目中的 JS 文件统一转换为标准无 BOM UTF-8 的核心流程是:先建立版本控制备份锁定现有代码,再通过脚本递归遍历目录排除
node_modules 等依赖,在内存中精准识别 BOM 标记与非 UTF-8 字节序列,最后通过转码流安全重写为标准 UTF-8。
一、批量转换前的核心认知与转码判定原理
许多开发者在遇到中文注释乱码时,第一反应是直接使用全量命令强制把所有文件从 GBK 转为 UTF-8。这种盲目转换是极度危险的操作:如果一个文件本身已经是 UTF-8 编码,再次使用 GBK 强行解码并重写为 UTF-8,会导致文件内的双字节字符(如所有中文注释、多语言文案)发生二次损坏,变成彻底无法还原的乱码。
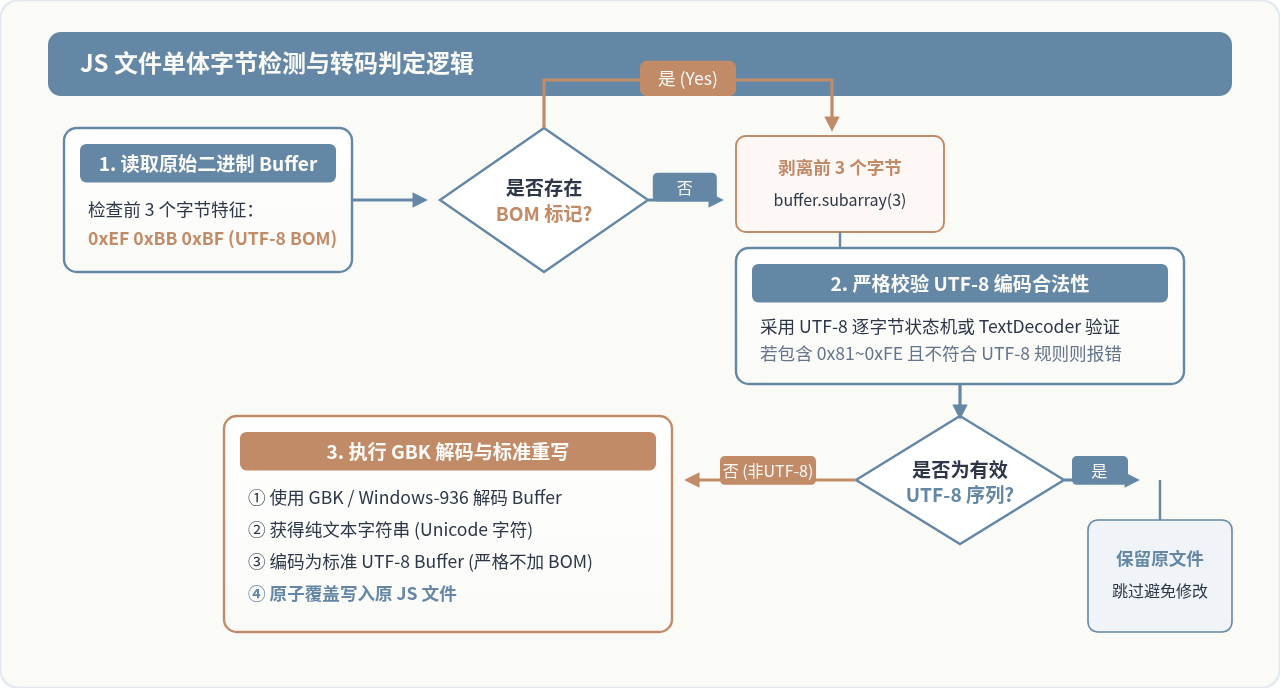
因此,安全可靠的批量转换逻辑必须遵循“先判定、后按需转换”的机制。在计算机底层,不同的文本编码在字节流上有明确的特征:
- UTF-8 BOM 头(Byte Order Mark):文件前 3 个字节为
0xEF 0xBB 0xBF。在早期 Windows 记事本中创建的 UTF-8 文件通常带有该标记。虽然在 HTML 中可能不影响显示,但在 Node.js 运行时或打包工具解析时,会将这 3 个字节误认为是源码开头的非法标识符(报错Unexpected token \ufeff)。批量处理时必须直接截断剥离这 3 个字节。 - UTF-8 多字节序列校验:标准 UTF-8 具有非常严格的变长字节规则。ASCII 字符占用 1 字节(最高位为 0);双字节字符首字节为
110xxxxx,后跟10xxxxxx;三字节(常见中文字符)首字节为1110xxxx,后跟两个10xxxxxx。如果一个文件的二进制 Buffer 完全符合上述校验状态机,说明该文件已是合法 UTF-8,应当跳过处理,避免修改文件时间戳与 Git 跟踪记录。 - GBK / GB2312 编码序列:中文字符由双字节组成,首字节范围通常在
0x81~0xFE,尾字节在0x40~0xFE。当文件被判定为非有效 UTF-8 时,才读取其原始 Buffer,按照 GBK 字符集解码为 Unicode 纯文本字符串,再将其以标准无 BOM UTF-8 重新编码写回。
安全准备提示:在执行任何批量转码操作前,请务必执行
git status 确保工作区干净,或使用 git commit 提交一个独立快照分支。批量重写文件是不可逆的文件系统操作,版本库快照是排查与随时撤销的唯一保障。
二、操作方案一:使用 Node.js 跨平台脚本(最推荐的前端工程化方案)
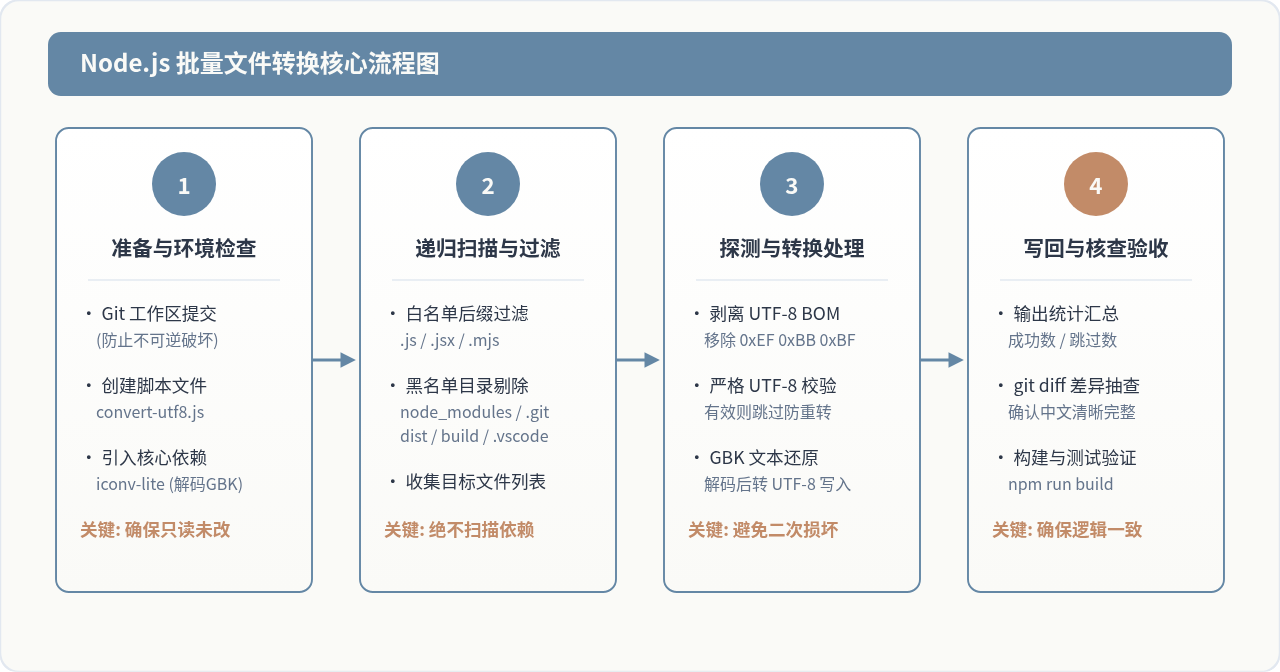
对于前端与全栈工程而言,团队成员通常使用不同的操作系统(Windows、macOS 或 Linux),且开发机上均已具备 Node.js 环境。使用 Node.js 编写自动化转换脚本不仅无需安装第三方系统级软件包,还能无缝集成到项目的 npm scripts 中,具备最佳的跨平台一致性与容错能力。
1. 安装转码核心依赖
Node.js 原生 Buffer 仅直接支持 utf-8、ascii、base64 等,原生不支持直接解码 GBK 字符集。我们需要在项目根目录下临时安装工业级跨平台编码库 iconv-lite:
npm install iconv-lite --save-dev2. 编写批量转换脚本
在项目根目录创建一个专用的批量转换脚本文件,命名为 convert-utf8.js。该脚本通过目录递归扫描,精准过滤目标扩展名,排除第三方依赖目录,并执行“BOM 剥离 + 严格 UTF-8 校验 + GBK 解码回写”全套流程。
// convert-utf8.js - 项目 JS 文件批量统一转换为 UTF-8(无 BOM)
const fs = require('fs');
const path = require('path');
const iconv = require('iconv-lite');

// 配置目标路径与过滤规则
const TARGET_DIR = path.resolve(__dirname, './'); // 默认为当前项目根目录
const TARGET_EXTENSIONS = new Set(['.js', '.jsx', '.mjs', '.cjs']);
const IGNORED_DIRS = new Set([
  'node_modules',
  '.git',
  '.svn',
  '.vscode',
  '.idea',
  'dist',
  'build',
  'coverage'
]);

// 统计计数器
const stats = {
  scanned: 0,
  convertedGbk: 0,
  strippedBom: 0,
  alreadyUtf8: 0,
  errors: 0
};

/**
 * 校验 Buffer 是否为合法的无 BOM UTF-8 字节序列
 * 利用 TextDecoder fatal 模式进行严格状态机验证
 */
function isValidUtf8(buffer) {
  try {
    const decoder = new TextDecoder('utf-8', { fatal: true });
    decoder.decode(buffer);
    return true;
  } catch (e) {
    return false;
  }
}

/**
 * 处理单个文件
 */
function processFile(filePath) {
  stats.scanned++;
  let buffer;

  try {
    buffer = fs.readFileSync(filePath);
  } catch (err) {
    console.error(`[读取失败] ${filePath}: ${err.message}`);
    stats.errors++;
    return;
  }

  let modified = false;

  // 1. 检查并剥离 UTF-8 BOM 头 (0xEF 0xBB 0xBF)
  if (buffer.length >= 3 && buffer[0] === 0xEF && buffer[1] === 0xBB && buffer[2] === 0xBF) {
    buffer = buffer.subarray(3);
    modified = true;
    stats.strippedBom++;
    console.log(`[剥离 BOM] ${filePath}`);
  }

  // 2. 严格校验是否为有效 UTF-8
  if (isValidUtf8(buffer)) {
    if (modified) {
      // 如果仅剥离了 BOM,重新写回干净的无 BOM 文件
      fs.writeFileSync(filePath, buffer);
    } else {
      stats.alreadyUtf8++;
    }
    return;
  }

  // 3. 非合法 UTF-8,尝试按 GBK / CP936 进行解码并转为标准 UTF-8
  try {
    const decodedText = iconv.decode(buffer, 'gbk');
    const newUtf8Buffer = Buffer.from(decodedText, 'utf-8');
    fs.writeFileSync(filePath, newUtf8Buffer);
    stats.convertedGbk++;
    console.log(`[GBK -> UTF-8 成功] ${filePath}`);
  } catch (err) {{
    console.error(`[转码失败] ${filePath}: ${err.message}`);
    stats.errors++;
  }}
}

/**
 * 递归遍历目录
 */
function traverseDirectory(dirPath) {
  const entries = fs.readdirSync(dirPath, { withFileTypes: true });

  for (const entry of entries) {
    const fullPath = path.join(dirPath, entry.name);

    if (entry.isDirectory()) {
      if (!IGNORED_DIRS.has(entry.name)) {
        traverseDirectory(fullPath);
      }
    } else if (entry.isFile()) {
      const ext = path.extname(entry.name).toLowerCase();
      if (TARGET_EXTENSIONS.has(ext)) {
        processFile(fullPath);
      }
    }
  }
}

// 执行主程序
console.log(`开始扫描并标准化文件编码: ${TARGET_DIR}`);
const startTime = Date.now();
traverseDirectory(TARGET_DIR);
const duration = ((Date.now() - startTime) / 1000).toFixed(2);

console.log('\n========== 转换结果统计 ==========');
console.log(`扫描文件总计: ${stats.scanned} 个`);
console.log(`原本即为 UTF-8: ${stats.alreadyUtf8} 个`);
console.log(`剥离 BOM 头: ${stats.strippedBom} 个`);
console.log(`GBK 转换为 UTF-8: ${stats.convertedGbk} 个`);
console.log(`错误计数: ${stats.errors} 个`);
console.log(`总耗时: ${duration} 秒`);
console.log('==================================');
3. 执行脚本与输出验证
在终端中直接运行该脚本:
node convert-utf8.js
开始扫描并标准化文件编码: /Users/project/my-webapp
[GBK -> UTF-8 成功] /Users/project/my-webapp/src/legacy/calculate.js
[剥离 BOM] /Users/project/my-webapp/src/components/Header.jsx
[GBK -> UTF-8 成功] /Users/project/my-webapp/src/utils/gbk_helper.js
========== 转换结果统计 ==========
扫描文件总计: 148 个
原本即为 UTF-8: 145 个
剥离 BOM 头: 1 个
GBK 转换为 UTF-8: 2 个
错误计数: 0 个
总耗时: 0.18 秒
==================================
三、操作方案二:Linux 与 macOS 命令行批量转换(iconv / uchardet)
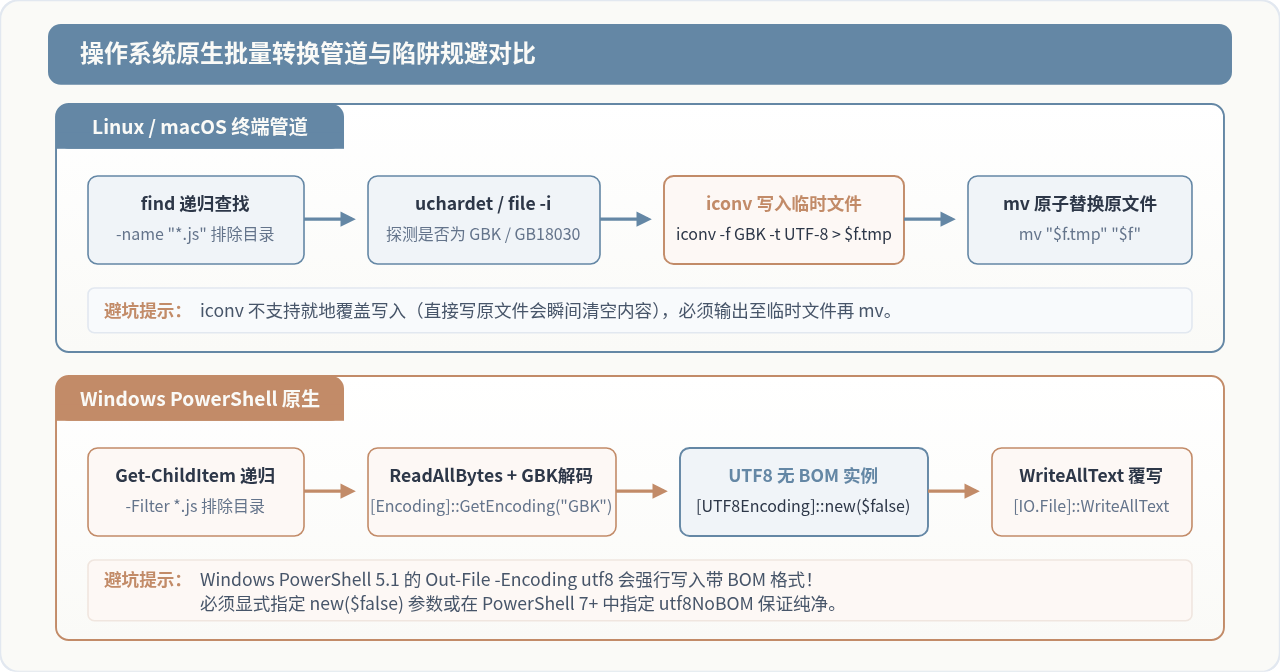
如果你在 Linux 服务器、macOS 或 WSL 终端中工作,且不希望为临时转码在项目中引入 Node.js 脚本,可以使用 Unix 原生命令组合 find、uchardet 与 iconv 进行处理。
1. 安装编码探测工具
标准 file -i 在某些系统上对中文字符集的探测可能不够准确(常泛指为 charset=unknown-8bit)。推荐使用 Mozilla 字符集探测算法包装的 uchardet 工具:
# Ubuntu / Debian
sudo apt-get install uchardet iconv

# macOS (Homebrew)
brew install uchardet
2. 编写批量转换 Shell 管道
特别注意:iconv 不能进行就地(in-place)写入。如果直接运行 iconv -f GBK -t UTF-8 "$file" > "$file",shell 的重定向操作符 > 会在 iconv 读取之前瞬间将原文件截断清空为 0 字节,导致源码被彻底销毁。必须先将输出写入 .tmp 临时文件,校验成功后再用 mv 原子覆盖。
#!/usr/bin/env bash
# batch-convert-unix.sh
# 排除 node_modules、.git 等目录,递归处理 .js 文件

find . -type d \( -name "node_modules" -o -name ".git" -o -name "dist" \) -prune -o -type f -name "*.js" -print | while read -r file; do
  # 探测当前文件编码
  encoding=$(uchardet "$file" 2>/dev/null)

  if [[ "$encoding" == "GB18030" || "$encoding" == "GBK" || "$encoding" == "GB2312" || "$encoding" == "WINDOWS-936" ]]; then
    echo "检测到 $encoding 文件: $file,正在转换为 UTF-8..."
    # 转换至临时文件
    iconv -f "$encoding" -t UTF-8 "$file" > "${file}.tmp"
    if [ $? -eq 0 ]; then
      mv "${file}.tmp" "$file"
      echo "已更新: $file"
    else
      echo "转码失败,保留原文件: $file"
      rm -f "${file}.tmp"
    fi
  fi
done
四、操作方案三:Windows 原生 PowerShell 脚本批量处理
在纯 Windows 环境下,如果没有安装 Node.js 或 Git Bash,可以直接使用 Windows 自带的 PowerShell。
PowerShell 编码陷阱:在 Windows PowerShell 5.1 中,如果使用
Out-File -Encoding utf8 或 Set-Content -Encoding UTF8,微软默认会在文件头部强行插入 3 个字节的 UTF-8 BOM 头。为了获得标准的无 BOM UTF-8,必须直接调用 .NET 的 System.Text.UTF8Encoding($false) 构造函数。
打开 PowerShell 窗口,进入项目根目录,运行以下脚本代码:
# convert-utf8.ps1 - Windows 原生无 BOM UTF-8 批量转换
$targetDir = Get-Location
$utf8NoBom = New-Object System.Text.UTF8Encoding($false)
$gbkEncoding = [System.Text.Encoding]::GetEncoding("GBK")

# 递归查找所有 .js 文件,排除 node_modules 和 .git 路径
$jsFiles = Get-ChildItem -Path $targetDir -Filter "*.js" -Recurse | Where-Object {
    $_.FullName -notmatch '\\(node_modules|\.git|dist|build)\\'
}

Write-Host "共找到 $($jsFiles.Count) 个 JS 文件,正在检查编码..." -ForegroundColor Cyan

foreach ($file in $jsFiles) {
    $bytes = [System.IO.File]::ReadAllBytes($file.FullName)

    # 1. 检查是否存在 UTF-8 BOM (0xEF, 0xBB, 0xBF)
    if ($bytes.Length -ge 3 -and $bytes[0] -eq 0xEF -and $bytes[1] -eq 0xBB -and $bytes[2] -eq 0xBF) {
        # 截断前 3 个字节写回
        $cleanBytes = $bytes[3..($bytes.Length - 1)]
        [System.IO.File]::WriteAllBytes($file.FullName, $cleanBytes)
        Write-Host "剥离 BOM: $($file.Name)" -ForegroundColor Yellow
        continue
    }

    # 2. 尝试利用严格 UTF-8 解码检测
    $isUtf8 = $true
    try {
        $strictUtf8 = New-Object System.Text.UTF8Encoding($false, $true)
        $strictUtf8.GetString($bytes) | Out-Null
    } catch {
        $isUtf8 = $false
    }

    # 3. 如果不是有效 UTF-8,按 GBK 解码后以无 BOM UTF-8 保存
    if (-not $isUtf8) {
        $content = $gbkEncoding.GetString($bytes)
        [System.IO.File]::WriteAllText($file.FullName, $content, $utf8NoBom)
        Write-Host "GBK 转 UTF-8 成功: $($file.Name)" -ForegroundColor Green
    }
}

Write-Host "批量处理完成!" -ForegroundColor Cyan
五、转换后的四步验证流程与避坑指南
批量转码完成后,切忌立即提交或推送到远端仓库。必须按照以下 4 步标准流程核查修改结果,确保代码不仅编码统一,且内部语义完好无损。
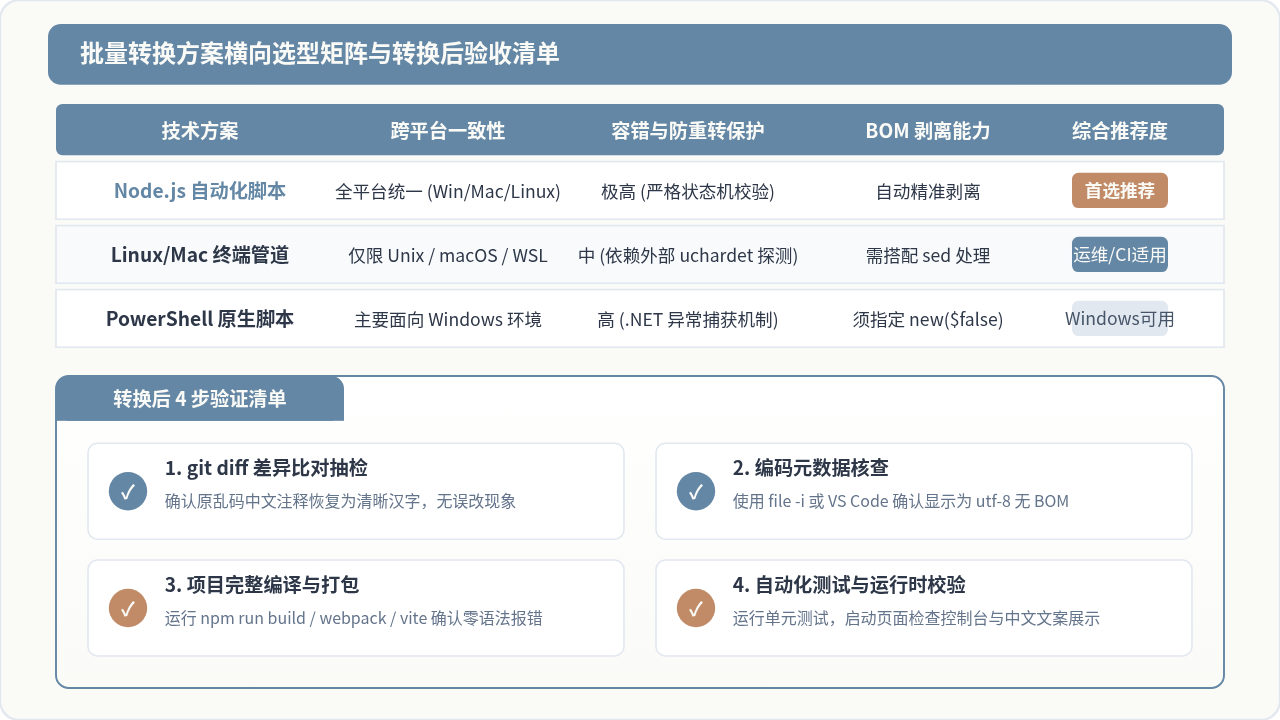
-
执行
git diff抽检中文与特殊符号:
运行git diff,挑选数个被转换的文件查看差异。在终端或代码比对工具中,原来如果存在中文注释或汉字字符串,在差异比对中应清晰显示为可读中文,而不是转义序列或乱码乱字符。 -
编码元数据核查:
在 Linux / macOS 终端中使用file -i src/legacy/my_file.js,或者在 VS Code 右下角状态栏中查看,应统一显示为utf-8,且不能出现utf-8 with BOM。 -
构建与打包工具全量测试:
在项目根目录运行npm run build(或vite build、webpack)。由于所有文件已被标准化为纯净 UTF-8,构建工具的词法分析器不会再抛出Invalid or unexpected token等 BOM 导致的解析异常。 -
启动应用进行运行时校验:
运行单元测试(npm test)并启动本地开发服务器,检查浏览器控制台是否有编码异常报错,页面上的中文提示文本是否展示正常。
六、方案横向选型建议与工程化防范
在实际开发中,应根据当前团队与技术栈现状选择最适宜的方案:
- 前端与全栈工程团队:推荐首选方案一(Node.js 自动化脚本)。它不依赖外部系统二进制,且能够利用统一的 JavaScript 运行时处理跨平台差异,安全可靠。
- 服务器维护与 DevOps 流水线:如果是在 Docker 镜像或 CI 环境中对存量源码做一次性规整,选用方案二(Linux 命令行管道)轻量快捷。
- 纯 Windows 单机开发:选用方案三(PowerShell 脚本)无需安装额外工具即可迅速完成。
为了防止未来团队成员在各自的编辑器中再次保存出非 UTF-8 编码的文件,建议在项目根目录下配置或完善 .editorconfig 文件,显式约束编码规范:
# .editorconfig
root = true

[*]
charset = utf-8
end_of_line = lf
indent_style = space
indent_size = 2
insert_final_newline = true
trim_trailing_whitespace = true
现代主流编辑器(如 VS Code、WebStorm 等)在安装 EditorConfig 插件后,会自动遵循该配置,在每次新建或保存文件时默认采用无 BOM 的标准 UTF-8 格式,从源头上彻底根绝编码混杂的问题。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章