
针对JavaScript遗留代码中常见的比较参数坏味道,系统讲解排序比较器缺陷、arguments伪数组依赖、宽松隐式转换及深度递归比对的重构方法与工程化实践。

当前位置:首页 > JavaScript 代码规范与重构 > 正文
JavaScript比较参数旧代码怎么重构
作者:半夏
时间:2026-11-07
浏览:72
文章目录
代码重构与质量保障
适用范围:ES5/ES6+ 遗留项目重构 · 纯前端与 Node.js 服务端通用
缩略图:从遗留隐式参数比对向现代类型安全架构演进
重构遗留 JavaScript 中的“比较参数”代码,核心在于解决两类问题:一是在排序与筛选回调中,比较参数
(a, b) 存在暴力的数值相减和未防卫的隐式转换,导致排序不稳定或出现 NaN 乱序;二是在函数调用与变更检测逻辑中,过度依赖 arguments 伪数组遍历、宽松双等号 == 以及手写无保护的深层递归比对。解决这一问题的标准路径是:先补充极端边界单测以固化既有行为,随后将排序比较器提取为独立的纯函数并使用 Intl.Collator 与显式三元分支;对于入参校验与等值比对,则将位置参数升级为对象解构与 Rest 参数,并采用 Object.is 与受控的浅比对策略彻底消除隐患。
一、遗留代码中参数比较的四类典型坏味道
在长期迭代的老旧项目中,参数比较逻辑往往分散在各类排序回调、缓存记忆函数(Memoize)、数据联动更新以及表单配置校验中。由于早期语言规范不健全或开发者图省事,代码往往留下了显著的质量与运行稳定性隐患。
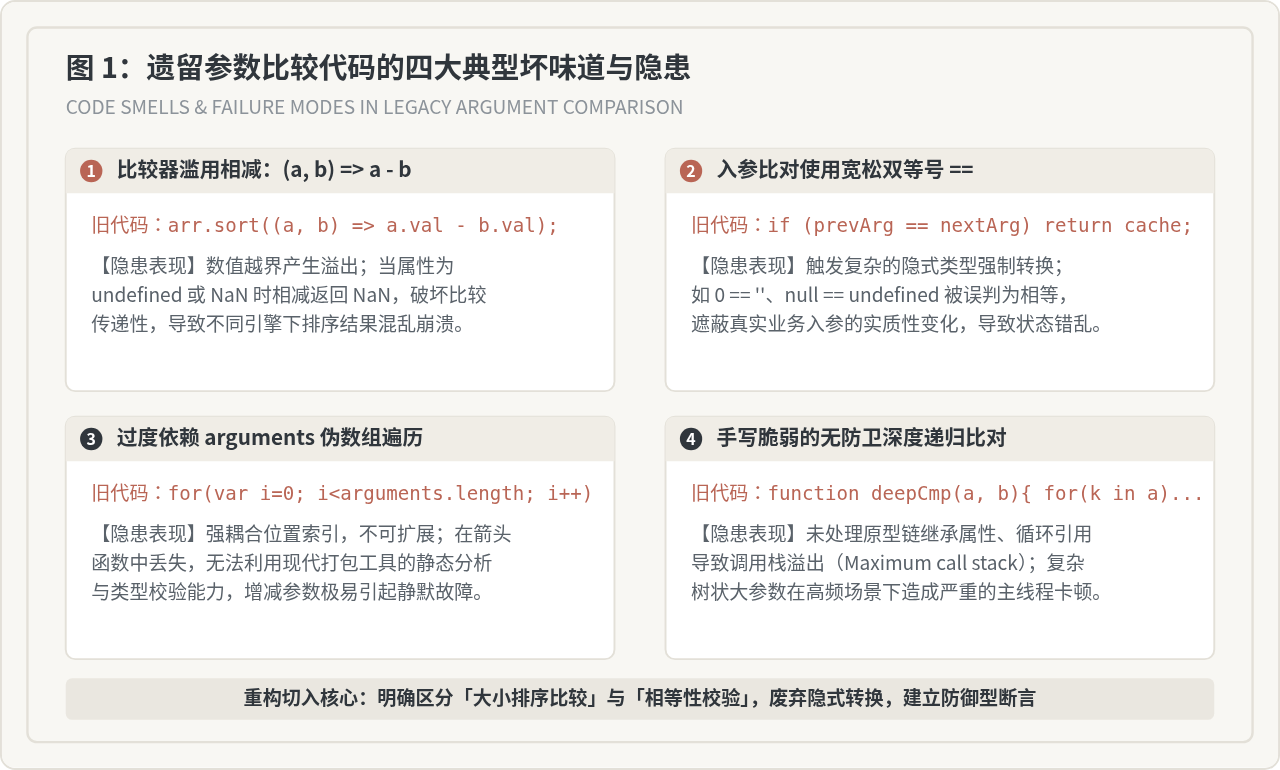
图 1:遗留参数比较代码的四大典型坏味道与隐患分析
1. 比较器中使用暴力减法 (a, b) => a - b
在处理数组排序时,最普遍的旧写法是直接将两个对象的字段相减。当比较字段均为普通正整数且非空时,该写法能够工作;但只要任意参数的值为 undefined、null、非数字字符串或超出安全数值范围,运算结果即为 NaN。根据 ECMAScript 规范,任何包含 NaN 的比较均返回 false,导致排序算法丧失传递性,不同 JavaScript 引擎甚至会在同一次排序中给出完全矛盾的排列。
2. 入参校验使用宽松相等 ==
在比对旧入参与新入参是否发生变更时,使用双等号会引发意想不到的隐式类型转换。例如 0 == '' 为 true,false == '0' 为 true,null == undefined 也为 true。当函数入参从空字符变为数字 0 时,双等号判定两者无差别,从而阻止了必要的渲染或数据刷新。
3. 强依赖 arguments 伪数组与位置索引
许多老旧工具库通过遍历 arguments 对传入的所有参数进行逐一对比或类型核对。这种写法的致命弱点在于参数顺序强绑定:一旦函数未来需要插入新参数或重命名参数,所有基于位置的比较就会发生错位。此外,arguments 在箭头函数中不可用,且会阻止 JavaScript 虚拟机的特定参数优化。
4. 手写脆弱的无防卫深度递归比对
为了对比两个复杂入参对象是否相等,老代码常自行编写类似 deepCompare(a, b) 的递归函数。这类实现通常忽略了对象的原型链属性污染(未做 hasOwnProperty 过滤)、未处理循环引用导致栈溢出,且每次入参变动都要承受全树遍历的 CPU 开销。
二、参数比较旧代码的标准重构流程
重构比较逻辑切忌盲目替换代码。比较逻辑处于函数逻辑的最上游,一旦语义发生偏移,下游计算将全盘失准。必须按照以下四个循序渐进的阶段执行。
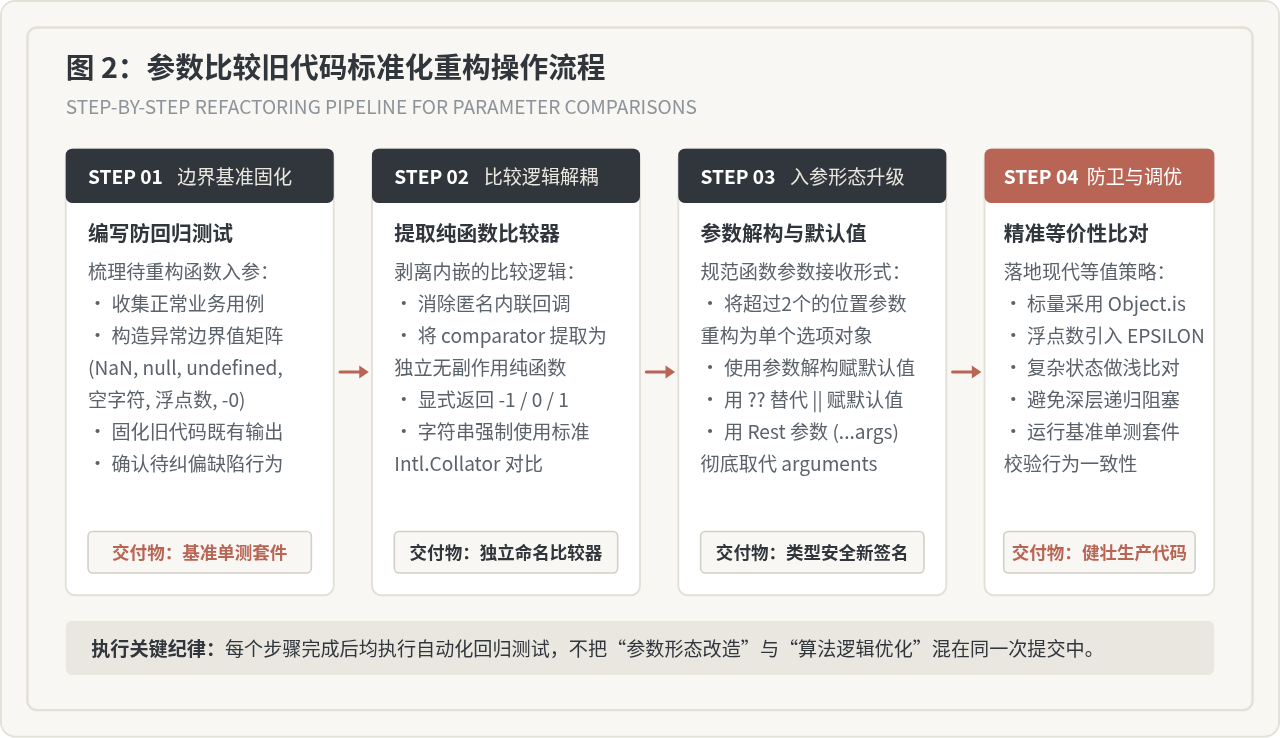
图 2:参数比较旧代码标准化重构操作流程
第 1 步:用例补齐与基准加固(建立安全网)
在改动任何生产代码之前,必须针对待重构函数补充一组能够覆盖所有边界情况的单元测试。测试矩阵必须至少包含以下五类关键参数用例:
- 空值与未定义:
null与undefined的各种组合,验证是否会抛出TypeError。 - 数值边界:
NaN、+0、-0、Infinity、-Infinity以及浮点数精度截断。 - 空容器:空字符串
""、空数组[]、空对象{}。 - 文本字符集:包含中文字符、英文字母大小写、重音字符的字符串比较。
- 引用一致性:相同引用的对象入参比对,以及不同引用但结构相同的对象比对。
第 2 步:比较逻辑解耦与独立提取
将散落在业务逻辑或 Array.prototype.sort 内部的匿名内联回调彻底剥离出来,声明为独立的纯函数。一个标准、严谨的比较器必须满足数学上的严格弱序(Strict Weak Ordering):
- 自反性:
compare(a, a) === 0; - 反对称性:若
compare(a, b) > 0,则compare(b, a) < 0; - 传递性:若
compare(a, b) > 0且compare(b, c) > 0,则compare(a, c) > 0。
第 3 步:参数签名升级与解构默认值
如果原函数使用了多个平铺参数并在函数体内部进行交织比较,将其重构为接收单一命名配置对象(Options Object)。通过 ES6 属性解构赋值与空值合并运算符 ??,将参数的默认值填充、类型规范化与比对逻辑解耦开来。对于变长参数函数,使用现代 Rest 语法 (...args) 全面替代 arguments。
第 4 步:显式比对实现与性能调优
摒弃双等号与模糊的三元嵌套。根据比对目标选择现代标准 API:标量使用 Object.is(),文本排序使用配置好的 Intl.Collator 实例,对象等值则采用确定性的浅层比较(Shallow Equality)来替换低效的全局深层递归。
三、核心场景重构代码演进实操
场景 1:数组排序中的双参数比较器((a, b) => ...)
以下是老旧电商项目商品列表按价格和名称排序的常见代码。旧代码中直接使用减法,在价格缺失时会导致排序错乱;字符串大小比较则直接使用 >,无法正确处理中文拼音或本地化规则。
旧代码实现(存在隐患)
直接相减易触发 NaN 漏洞;字符串仅按 Unicode 码点比较,无法正确处理多语言。
// ❌ 遗留旧代码:脆弱的参数比较器
function sortProductsLegacy(products) {
  return products.sort(function(a, b) {
    // 隐患 1:当 price 为 undefined 时,相减为 NaN,破坏排序
    if (a.price !== b.price) {
      return a.price - b.price;
    }
    // 隐患 2:直接使用 > 和 <,中文按编码排序不符合业务习惯
    if (a.name > b.name) return 1;
    if (a.name < b.name) return -1;
    return 0;
  });
}
重构做法是:首先将排序比较逻辑拆解为独立的比较器纯函数,引入 Number.isFinite 对数值参数做防御,利用显式三元分支返回 -1 | 0 | 1;对于名称字段,复用预编译的 Intl.Collator 实例。
重构后实现(安全、显式、类型自洽)
提供严格边界防御,支持特定区域语言排序规则,保证算法传递性。
//  现代重构代码:纯函数比较器与防御型判定
const nameCollator = new Intl.Collator('zh-CN', {
  numeric: true,
  sensitivity: 'base'
});

function compareNumbers(a, b) {
  const numA = Number.isFinite(a) ? a : Number.MAX_SAFE_INTEGER;
  const numB = Number.isFinite(b) ? b : Number.MAX_SAFE_INTEGER;
  if (numA === numB) return 0;
  return numA < numB ? -1 : 1;
}

function compareProducts(a, b) {
  // 1. 优先比较数值型参数(价格)
  const priceDiff = compareNumbers(a?.price, b?.price);
  if (priceDiff !== 0) return priceDiff;

  // 2. 价格相同时,比较文本型参数(商品名)
  const nameA = a?.name ?? '';
  const nameB = b?.name ?? '';
  return nameCollator.compare(nameA, nameB);
}

function sortProducts(products) {
  // 保护原数组不被原地修改,采用 toSorted 或解构浅拷贝
  return [...products].sort(compareProducts);
}
场景 2:函数缓存与变更检测中的前后参数比对
在自定义记忆化函数(Memoization)或 UI 组件的入参变更检测中,老代码常手写循环遍历 arguments。当参数类型包含 NaN 时,老旧的 === 会误判两者不相等,导致缓存完全失效并造成重复计算。
旧代码实现(存在隐患)
使用 arguments 伪数组与 ===,无法正确对比 NaN,也无法在现代严格模式下保持良好扩展性。
// ❌ 遗留旧代码:手写 arguments 比较
function memoizeLegacy(fn) {
  var lastArgs = null;
  var lastResult = null;

  return function() {
    var currentArgs = arguments;
    var isSame = true;

    if (!lastArgs || lastArgs.length !== currentArgs.length) {
      isSame = false;
    } else {
      for (var i = 0; i < currentArgs.length; i++) {
        // 隐患:NaN === NaN 返回 false,导致包含 NaN 的参数永远无法命中缓存
        if (lastArgs[i] !== currentArgs[i]) {
          isSame = false;
          break;
        }
      }
    }

    if (!isSame) {
      lastArgs = currentArgs;
      lastResult = fn.apply(this, currentArgs);
    }
    return lastResult;
  };
}
重构的核心是:将 arguments 替换为 Rest 形参 ...currentArgs;比对标量相等性时采用 Object.is(),从而精准识别 NaN 与 +0/-0;比对结构时使用清晰的浅比对抽象。
重构后实现(安全缓存与精准判等)
采用 Rest 参数与 Object.is 判定,确保语义与 ECMAScript 现代标准完全对齐。
//  现代重构代码:类型清晰的浅比对缓存器
function areArgsEqual(prevArgs, nextArgs) {
  if (prevArgs === nextArgs) return true;
  if (prevArgs.length !== nextArgs.length) return false;

  for (let i = 0; i < prevArgs.length; i++) {
    // Object.is 精确处理 NaN 与负零
    if (!Object.is(prevArgs[i], nextArgs[i])) {
      return false;
    }
  }
  return true;
}

function memoizeOne(fn) {
  let lastArgs = null;
  let lastResult = null;
  let hasCalled = false;

  return function(...currentArgs) {
    if (hasCalled && lastArgs && areArgsEqual(lastArgs, currentArgs)) {
      return lastResult;
    }

    lastResult = fn.apply(this, currentArgs);
    lastArgs = currentArgs;
    hasCalled = true;
    return lastResult;
  };
}
四、现代参数比对策略选型决策树
在重构各类参数比较逻辑时,不必过度设计,也不能一刀切。根据参数的数据结构类型和具体的业务比对目的,选择最简洁且确定性最高的技术手段:
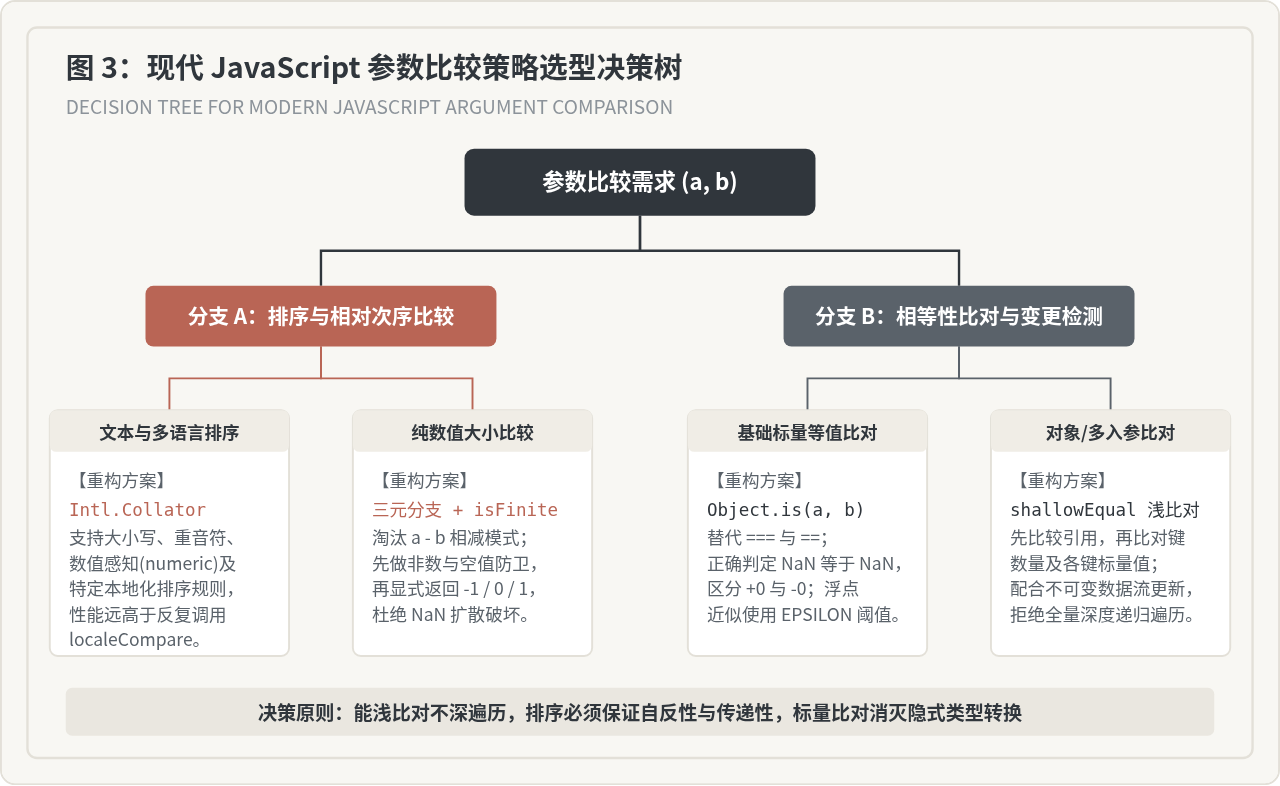
图 3:现代 JavaScript 参数比较策略选型决策树
| 参数场景 | 遗留旧写法 | 现代推荐重构方案 | 核心优势 |
|---|---|---|---|
| 数值大小排序 | (a, b) => a - b |
(a, b) => (a === b ? 0 : a < b ? -1 : 1) |
防止溢出,防御 NaN 破坏排序算法传递性 |
| 文本本地化排序 | a > b ? 1 : -1 |
new Intl.Collator(locale).compare |
支持中文拼音、字母大小写归一化及数字自然序 |
| 标量参数相等性 | a == b 或 a === b |
Object.is(a, b) |
正确识别 NaN 相等性,精确区分 +0 与 -0 |
| 变长入参变更校验 | 遍历 arguments |
Rest 参数 (...args) + shallowEqual |
支持静态分析与类型推导,不依赖外部运行上下文 |
| 配置对象入参比对 | 手写递归 for...in |
顶层键浅比对 + 不可变数据引用机制 | 时间复杂度稳定在 O(N),彻底防范循环引用栈溢出 |
五、重构中的高频陷阱与防范技巧
1. 浮点数计算结果比较的精度陷阱
旧代码中如果在参数比对中包含算术计算(如折扣率、税率比较),直接使用相等判断会因为二进制浮点精度出现假失败(如 0.1 + 0.2 === 0.3 为 false)。重构此类逻辑必须显式引入容差范围:
// 浮点数安全近似比较
function areNumbersClose(a, b, epsilon = Number.EPSILON) {
  return Math.abs(a - b) < epsilon;
}
2. 默认值兜底中的假值截断
老代码常使用 const timeout = options.timeout || 3000。当调用方显式传入参数 timeout = 0 时,逻辑或操作符 || 会将 0 误判为假值而强制替换为 3000。在重构入参比对和默认值合并时,应严格改用空值合并操作符 ??:
// 安全的默认值填充
function normalizeConfig(options = {}) {
  return {
    timeout: options.timeout ?? 3000,
    enableCache: options.enableCache ?? true
  };
}
3. 不可变数据结构对参数比对性能的提升
深度递归比对通常是旧架构缺乏数据流动规范的妥协产物。在重构大型对象入参比较时,应当推动调用端遵循不可变数据更新规范(如使用解构更新对象 {...oldState, updatedKey: val})。在比对侧,只需执行 O(1) 的引用相等性比较 prev === next,未命中时退化到一层的浅比较,即可节省 90% 以上的比对耗时。
六、重构总结与上线防劣化自查
完成参数比较旧代码的改造后,需要使用标准检查清单对受影响模块进行全面走查,确保没有在修复旧问题的同时引入隐式语义偏差。
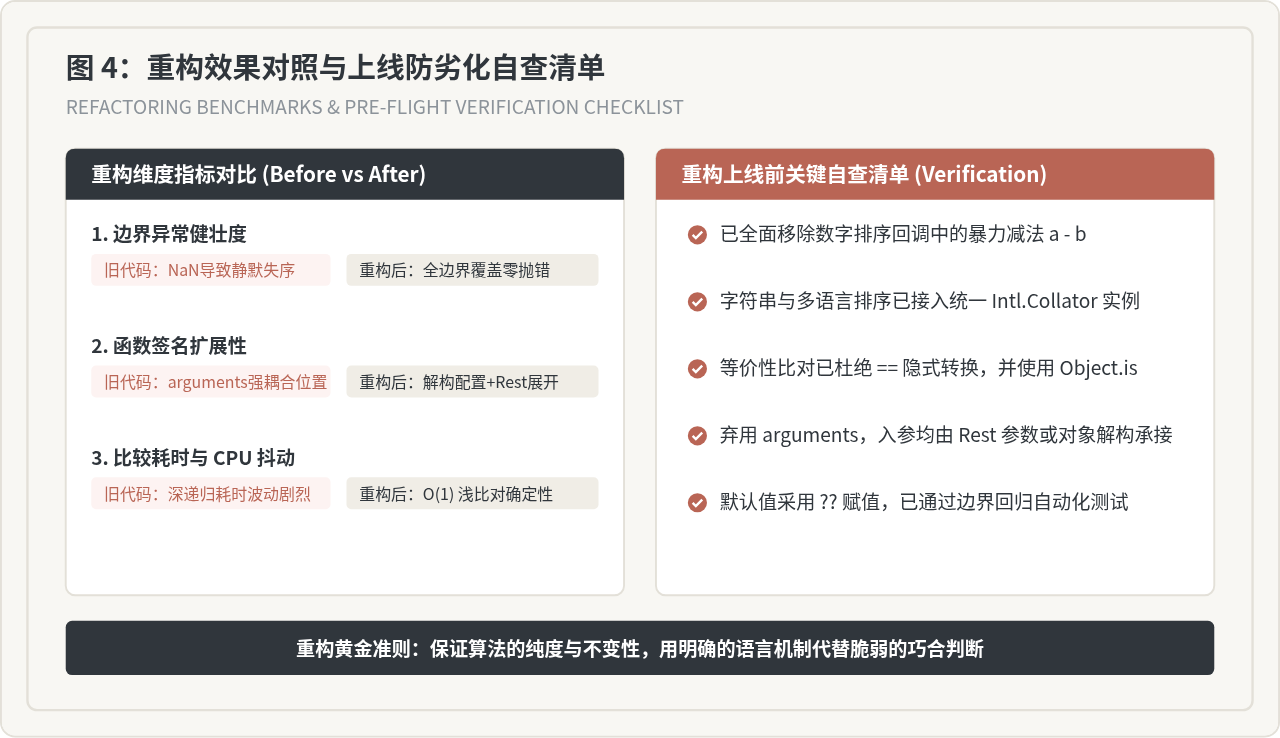
图 4:重构效果对照与上线防劣化自查清单
上线前防劣化五项必查要点
- 排序比较器自洽:检查项目中所有
sort()回调,确认已彻底清除非防御性的a - b,多分支比较器是否已覆盖相等时的返回0。 - 字符串语言环境:多语言排序是否已统一收拢到
Intl.Collator,避免在循环体内重复实例化。 - 全面告别双等号:对所有入参判定进行静态扫描,确保已移除无明确类型的宽松相等
==。 - 无 arguments 残留:函数签名全部改用显式具名形参或 Rest 语法,提升 TypeScript 或 JSDoc 的类型契约准确度。
- 极端用例单测全绿:运行包含
NaN、null、undefined和负零的自动化测试套件,确认重构前后对有效业务数据的处理结果完全一致。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章