

本文帮助开发者区分模型能力与产品工作流,通过代码生成约束、逻辑推理前提及复杂项目工具链等维度,对比DeepSeek与ChatGPT在实际开发中的表现,并提供基于真实任务的选型测试方法。
开发者选型指南:DeepSeek和ChatGPT编程与逻辑推理能力对比
作者:小算子
时间:2026-11-07
浏览:234
文章目录
若你的核心需求集中在代码编写与逻辑推演,DeepSeek 和 ChatGPT 均能提供支持。但在对比前,务必厘清“模型”与“产品”的界限:模型主导内容的理解与生成,而产品层面则决定了是否具备文件读取、工具调用、代码执行或仓库接入等能力。对于简单问答,直接评估回答质量即可;但在排查真实项目难题时,必须将上下文环境、工具链整合及验证机制纳入综合考量。
先分清模型能力与产品工作流
“DeepSeek”既可能指向其网页端服务,也可能指代 API 中的特定模型;同理,“ChatGPT”也是一个包含聊天界面、可选底层模型以及面向代码任务的 Codex 工作流的综合体。仅凭两个聊天窗口的一次性回复进行对比,结论极易受到模型版本迭代、系统提示词差异、联网状态及上下文窗口长度等因素的干扰。
对开发者而言,评估时应聚焦两个核心问题:首先,模型本身能否准确理解任务意图并构建正确方案?其次,当前产品形态是否具备获取项目文件、调用外部工具并将方案转化为实际代码的能力?前者主要考察模型的推理、代码生成及解释能力,后者则取决于文件上下文处理、工具调用机制、代码执行环境及权限配置。
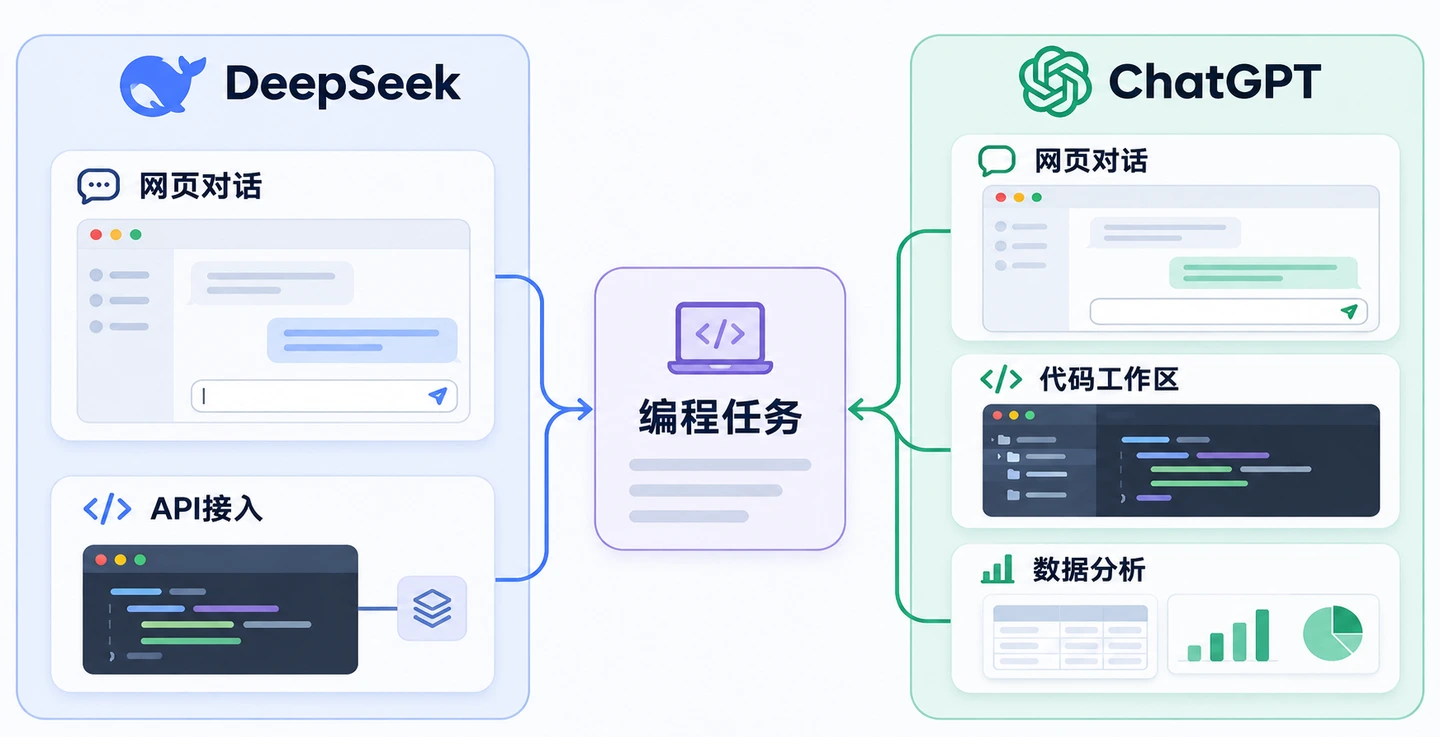
模型能力与产品工作流需要分开比较
代码生成要看约束是否被遵守
写一个小函数时,两边都可能给出看起来合理的代码。真正有区分度的是它是否理解边界条件、沿用项目约定,并给出能验证的结果。例如需求是判断一个数值是否达到年龄门槛,先把约定说清楚,再写最小实现:
function isAdult(age) {
  return age >= 18;
}
上述代码默认输入为有效数字,且门槛值包含 18。然而,若实际数据可能涉及字符串、空值或未定义年龄,就必须补充明确的输入规则,不能仅凭代码外观判定其正确性。相较于询问“代码质量如何”,要求模型阐明假设前提并补充边界测试用例,往往更具实用价值。
逻辑推理要追问前提与反例
在处理逻辑题、算法挑战或调试任务时,不应仅关注答案表现的自信程度。应要求模型列出关键前提、推导步骤,并提供一个能证伪错误结论的反例;若结论依赖特定额外条件,需明确标注。针对同一题目,可分别尝试普通模式与带推理增强模式,但需注意模式名称并不等同于准确率保证。DeepSeek API 文档中提供了思考模式及不同推理强度选项,具体可用能力会随模型版本和接口更新而变化。
调试过程中,可将问题拆解为“观察到的现象”、“预期结果”及“最小复现步骤”。如果模型仅提供一段补丁代码,却未解释该修改如何对应具体的错误现象,应继续要求其指出背后的假设依据及验证步骤。
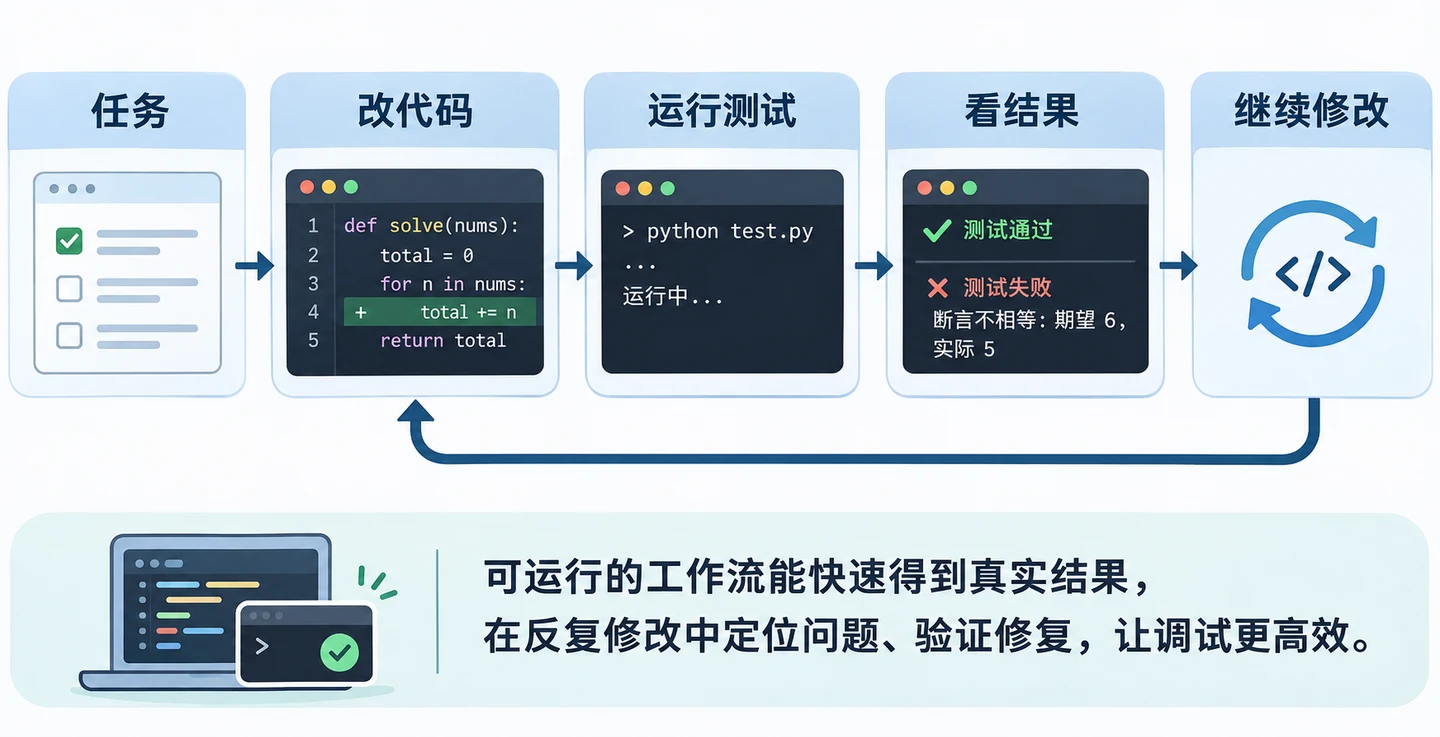
调试效果取决于代码与验证结果的迭代
复杂项目更依赖工具与上下文
当问题涉及多文件修改时,单次聊天回复与代码代理(Agent)的工作方式截然不同。ChatGPT 的 Codex 能够围绕仓库任务进行代码读写、命令执行、测试运行及改动审阅;同时,ChatGPT 也支持代码块预览及在受支持环境中执行 Python 代码。相比之下,DeepSeek API 支持工具调用及 Responses API 等接入方式,但其具体能力边界取决于调用端是否实现了工具集成、提供了文件访问权限并授予了相应操作许可。
因此,不能仅因某服务“支持工具调用”就推断其能自动访问本地项目或随意执行代码。在对比前,务必先确认接入入口与权限范围,进而评估其是否能利用报错信息和测试结果持续修正方案。
成本、速度和使用边界要按当前入口算
网页订阅、API 按量计费、团队工作区以及本地开发代理的成本核算口径各不相同。模型选择、推理强度设置、输入输出长度以及工具调用次数均会影响最终消耗,且厂商价格与套餐政策也会动态调整。切勿将旧文章中的单价直接作为当前成本参考,选型前应查阅各方最新的模型说明与计费文档。
此外,还需将代码与数据的上传可行性、组织合规性要求以及输出内容的人工审查需求纳入决策范畴。若代码严禁离开内网,即便云端服务推理能力再强也可能不适用;若仅需处理少量公开代码片段,部署与集成的隐性成本可能比单次回答的费用更为关键。
用同一任务做自己的小型对比
建议选取三类日常任务进行实测:补全一段函数、定位带有复现步骤的错误、解释一段陌生逻辑。为两个候选模型提供完全一致的任务描述、必要文件、上下文信息及测试条件,记录完成一次任务所需的返工次数,并评估结果的可运行性、对项目规范的符合度以及解释中是否指出了真实风险。
避免仅测试模型最擅长的领域,也不要将单次失误视为长期能力的定论。若对比的是产品层面,应允许各自使用真实可用的工具链;若对比的是模型本身,则应尽量统一提示词工程、上下文输入及可调用能力范围。
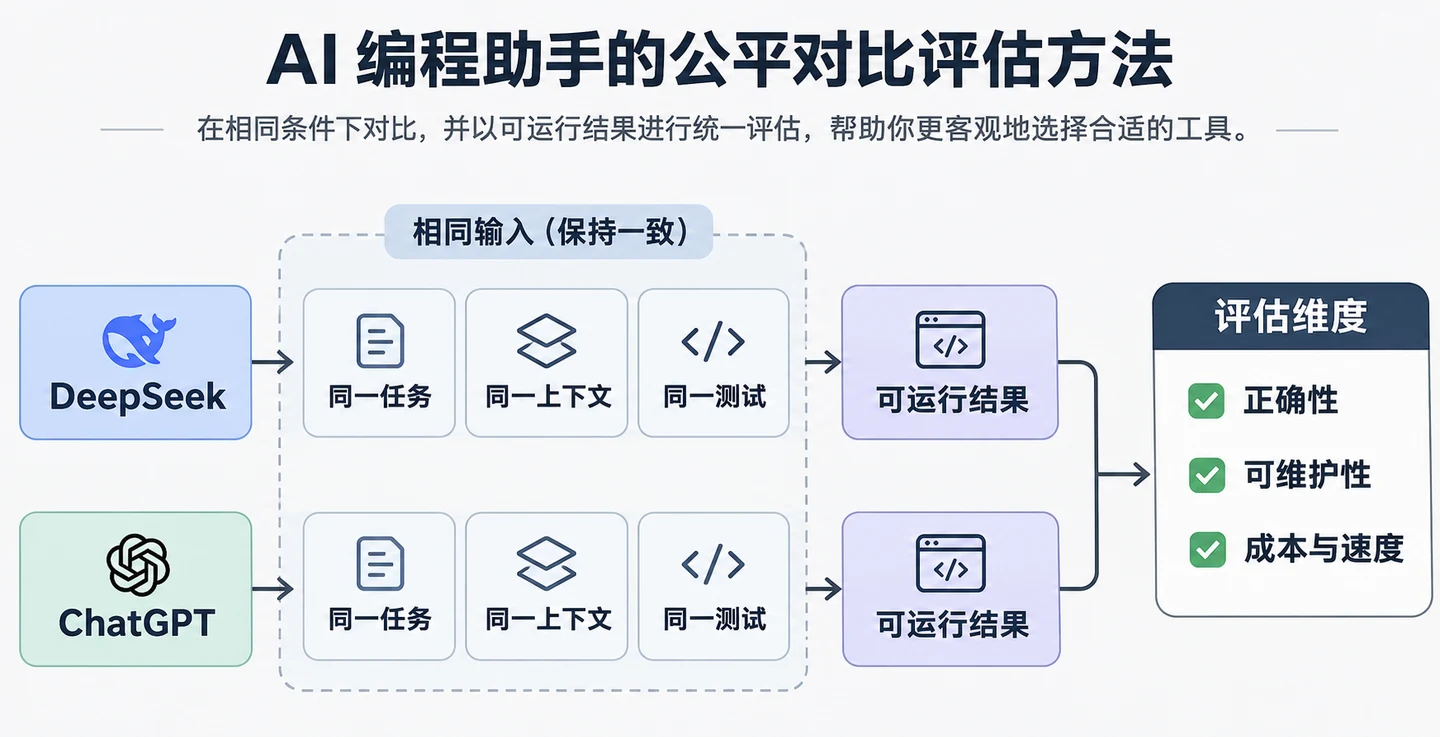
用一致条件检验真实开发任务
什么时候选哪一个
若需在仓库中直接进行规划、修改和验证代码,应优先比较能接入你开发环境的代理工作流;若仅需咨询概念、生成小段示例或通过 API 集成,则重点关注模型回答质量、接口兼容性、成本效益及数据合规要求。对于经常处理长上下文或需要多轮推演的任务,建议使用真实样例测试其上下文承接与自我修正能力。
两者并非在所有编程场景下都有固定的胜负关系。首先选出与你任务特性匹配的接入入口,再通过相同任务与可运行验证来做最终决定;由此得出的结论,远比笼统地争论“谁更会编程”更能指导日常开发工作。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章