

本文针对Stable Diffusion模型训练中常见的显存溢出(OOM)和损失函数(Loss)异常问题,提供系统的排查思路与解决方案。通过分阶段确认报错来源、调整关键训练参数、优化数据质量及正确理解缓存机制,帮助用户高效定位并解决训练故障,避免盲目调整参数。
Stable Diffusion模型训练报错排查:解决OOM显存溢出与Loss异常
作者:灵犀
时间:2026-11-07
浏览:316
文章目录
在 Stable Diffusion 模型训练过程中,OOM(Out Of Memory)错误通常意味着当前配置请求的显存超出了硬件可用上限;而 Loss 异常则可能源于学习率设置不当、数据质量问题、精度选择错误或训练流程缺陷。尽管这两类问题有时并发出现,但排查时应首先记录具体的报错信息与训练状态,随后分别缩小排查范围。切忌仅凭单一的 Loss 曲线走势或显存占用数值,就草率判定模型训练失败。
先确认报错发生在哪个阶段
首要任务是仔细审查训练窗口或日志中的完整报错信息,并明确其发生的具体阶段:是在加载模型、编码训练图像、执行前向计算时,还是在训练若干步之后。CUDA out of memory 标志着某次显存分配操作失败;若系统提示的是磁盘空间不足、系统内存耗尽或模型文件读取错误,则需转向对应资源的排查,此时单纯降低显存设置往往无法解决问题。
同时,需确认 GPU 上是否存在其他程序占用显存。建议关闭非必要的生成任务或其他训练进程后再次观察;若显存初始状态已接近满载,优先释放空间通常比调整复杂的高级参数更为直接有效。值得注意的是,PyTorch 采用缓存分配器机制,nvidia-smi 显示的显存占用量并不完全等同于当前张量实际使用的显存,因此应结合日志中的分配失败信息进行综合判断。
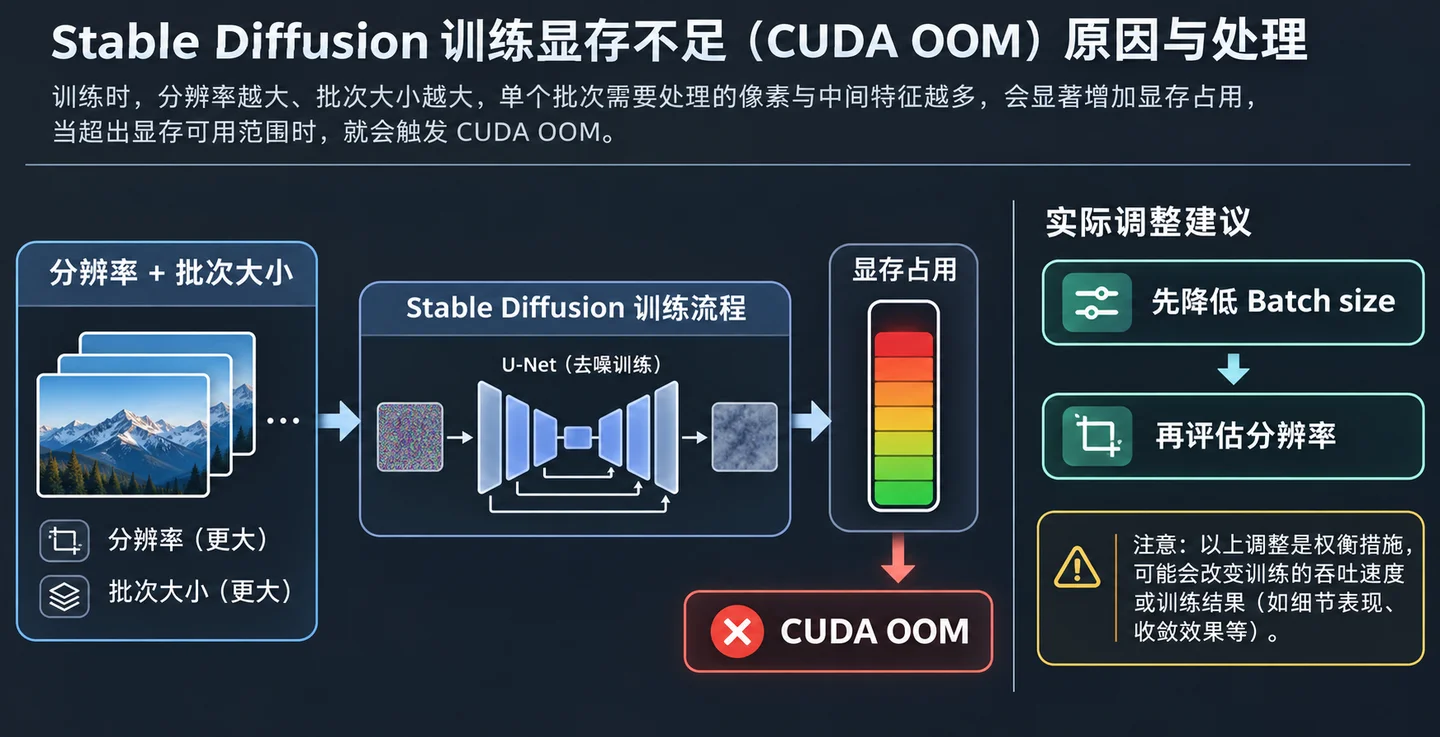
批次大小和分辨率会影响训练显存占用。
OOM 时按影响最大的设置逐项调整
面对 OOM 问题,首先尝试降低训练批次大小(Train batch size),必要时可从 1 开始测试,以验证基础配置的可行性。批次越大,单次并行计算所需的显存通常越多。若批次已设为 1,则需检查训练分辨率;分辨率越高,特征图计算带来的资源开销通常越大。虽然降低分辨率可能影响训练细节,但应根据目标模型和数据需求灵活决定,切勿将某一固定分辨率视为所有显卡通用的标准。
若调整批次后仍出现 OOM,可检查训练器是否支持梯度检查点(Gradient checkpointing)或省显存注意力实现。梯度检查点通过在反向传播时重新计算部分中间结果来节省显存,但这通常会增加计算耗时;省显存注意力机制也需确保与当前的训练框架、依赖版本及显卡环境兼容。此外,混合精度训练有助于降低内存占用,但应选择硬件和软件栈支持的精度格式,避免为节省显存而盲目开启实验性的全精度训练选项。
若希望维持较大的有效批次大小,可在训练器支持的情况下启用梯度累积:该机制将多个小批次的梯度累加后再更新参数,但需注意,它并不能减少单个微批次本身的显存需求。在调整参数时,建议每次仅修改一项,并在保持数据和其他参数不变的前提下重新启动训练,以便准确识别哪项设置起到了关键作用。
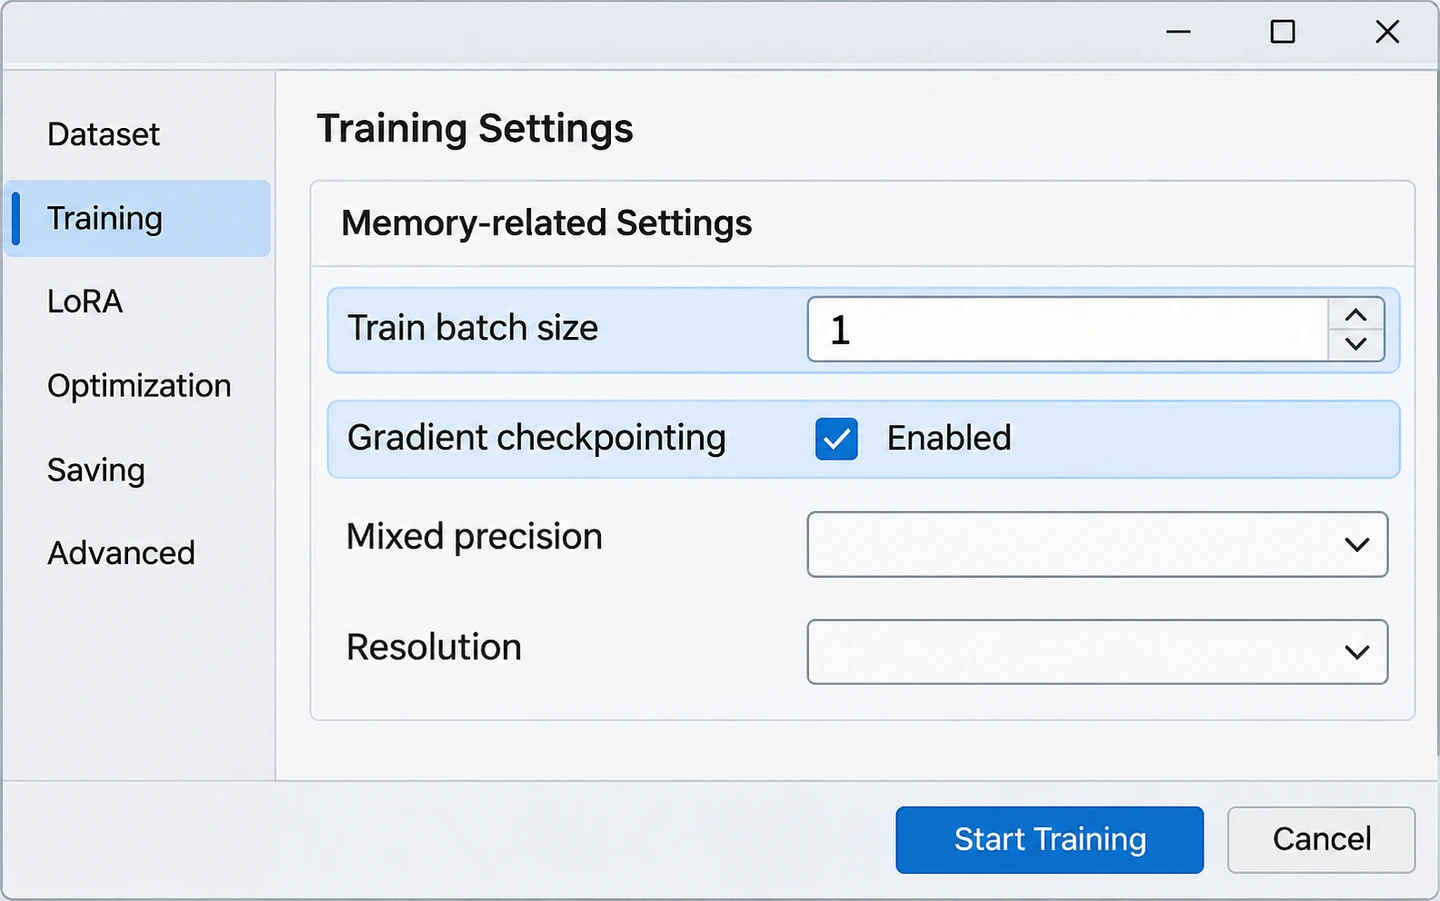
先从批次大小和梯度检查点等设置着手。
Loss 不下降或波动时先看趋势和日志
Loss 值仅是训练目标的一种数值记录,单点的高低并不能直接反映最终生成效果的优劣。首先应检查 Loss 曲线是否持续输出有效数值,是否存在突然上升、NaN 或 inf 等情况,并结合训练日志、采样预览及保存状态进行对照分析。由于不同的训练方式、数据集、损失定义及记录频率均会影响曲线形态,因此不存在适用于所有 Stable Diffusion 训练场景的统一合格阈值。
若 Loss 长时间几乎无变化,需检查训练是否真正在执行更新:确认学习率是否被误设为零或过低、训练步数是否正常递增、可训练模块是否已启用以及数据集是否成功加载。若 Loss 出现大幅震荡或突变为非有限值,应优先核查学习率是否过高、精度设置是否稳定、训练图像与标注文件是否损坏,以及日志中是否存在数值溢出或数据读取错误。学习率的设定需结合 LoRA、全量微调等具体训练方法以及模型和数据特性进行调整,不可直接照搬他人的单一数值。
此外,还应随机抽查部分训练图像及其对应标注,确保图像可正常打开、内容与描述基本匹配,且未将错误标签批量混入数据集。当数据或标注存在质量问题时,单纯延长训练时间可能会放大偏差。建议保存若干训练阶段的模型,并使用一致的提示词进行对比测试,结合样图效果、训练目标和 Loss 变化趋势综合判断,而非仅仅追求 Loss 曲线的持续下降。
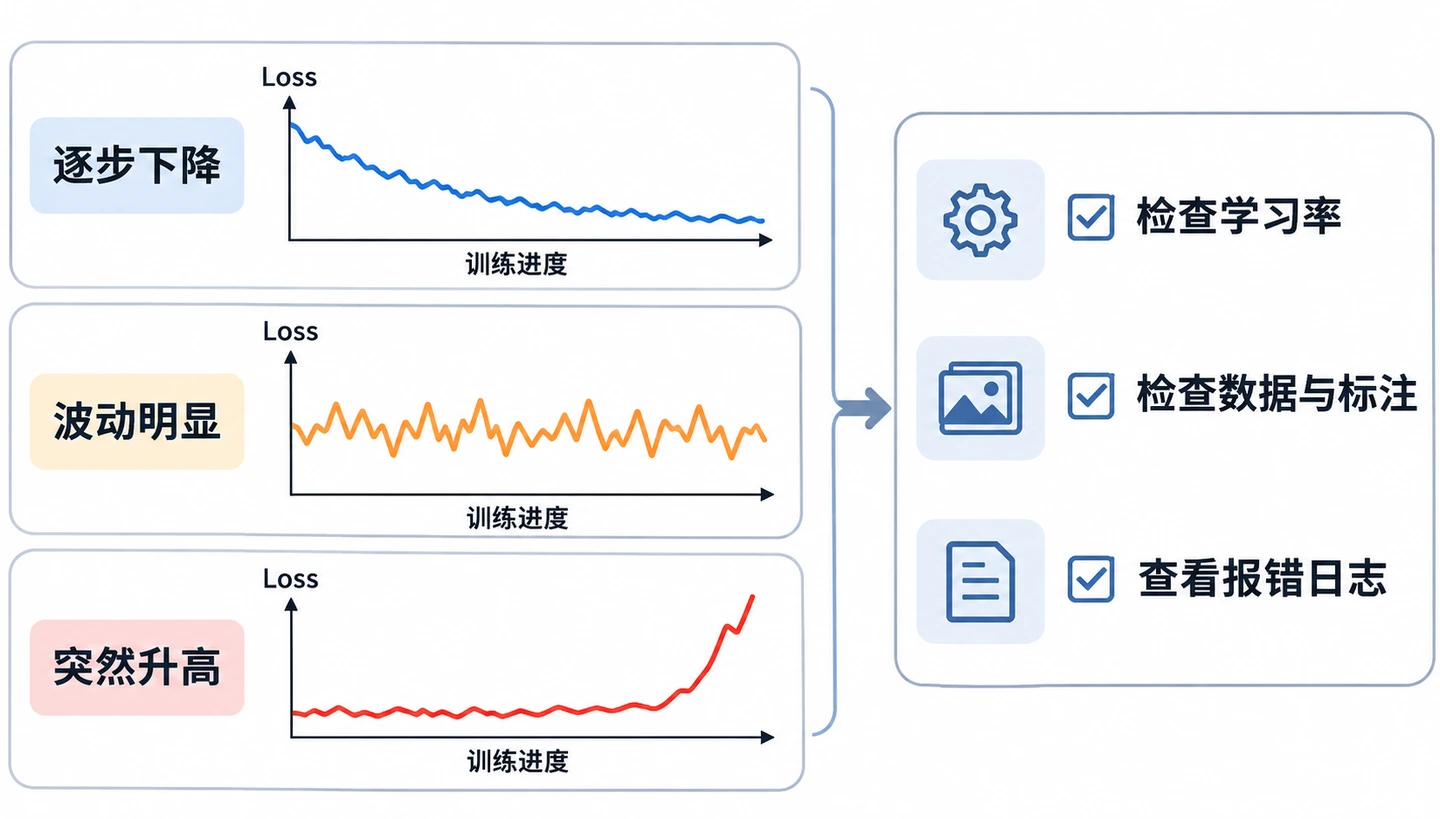
结合 Loss 趋势、数据与报错日志判断问题。
清理缓存不能代替配置排查
PyTorch 中的 torch.cuda.empty_cache() 仅能释放缓存分配器中当前未被占用的缓存块,无法释放仍被张量占用的显存,也不会凭空增加训练可用的显存总量。若错误源于真实的资源需求超过硬件上限,应优先减小批次或分辨率、启用兼容的省显存选项,并关闭占用 GPU 的其他任务。切勿将在程序运行中反复清理缓存视为解决 OOM 问题的稳定方案。
每次调整后,务必记录关键设置、报错阶段及曲线变化情况;若问题仍未解决,请保留完整的错误片段、训练器与依赖版本、显卡型号、训练方法及相关配置信息,以便根据具体错误进一步定位。这种做法有助于区分显存容量不足、兼容性问题和 Loss 配置异常,同时避免因同时改动多项参数而导致无法判断根本原因。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章