
深入解析JavaScript中递归遍历树形结构的核心实现与执行逻辑,涵盖先序与后序遍历、条件短路查找、自底向上剪枝过滤、不可变数据映射与扁平化,并详解调用栈机制与防御性编程实践。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript递归遍历树形结构的实现代码与逻辑详解
作者:木棉
时间:2026-11-21
浏览:496
文章目录
JavaScript 算法
递归模式
树形结构
调用栈分析
在前端与Node.js开发中,文件目录、组织部门架构、多级级联选择器(Cascader)以及权限路由菜单等业务数据,几乎无一例外采用嵌套树形结构呈现。由于树结构的任意一个子分支在结构形态上与其父级完全一致,使用递归(Recursion)是处理树形数据最自然、逻辑最直观且代码最紧凑的手段。本文面向需要扎实掌握树遍历的开发者,从数据结构自相似模型入手,剖析递归的基准出口与状态递推机制,提供先序/后序遍历、条件短路查找、自底向上剪枝过滤、不可变数据映射与一维扁平化的完整实现代码,并深入探讨调用栈行为与防范栈溢出的工程对策。
一、树形数据结构在JavaScript中的典型表示与自相似模型
在JavaScript程序中,树形数据通常以“嵌套对象”或“对象数组”形式存储。一个规范的树节点对象通常包含用于标识业务身份的标量属性(如 id、name),以及一个用于挂载下级子节点的数组属性(通常命名为 children)。当一个节点不存在子节点,或者子节点数组为空数组时,该节点即为树的“叶子节点”。
理解递归遍历的前提是领会树结构的自相似性(Self-Similarity):从根节点出发,其 children 数组中的每一个元素,本质上都可以单独剥离出来,作为一棵规模更小但结构完全相同的独立子树的根节点。这意味着:处理整棵大树的代码逻辑,可以直接复用到每一个子节点上,无需为每一层级编写重复的循环嵌套。
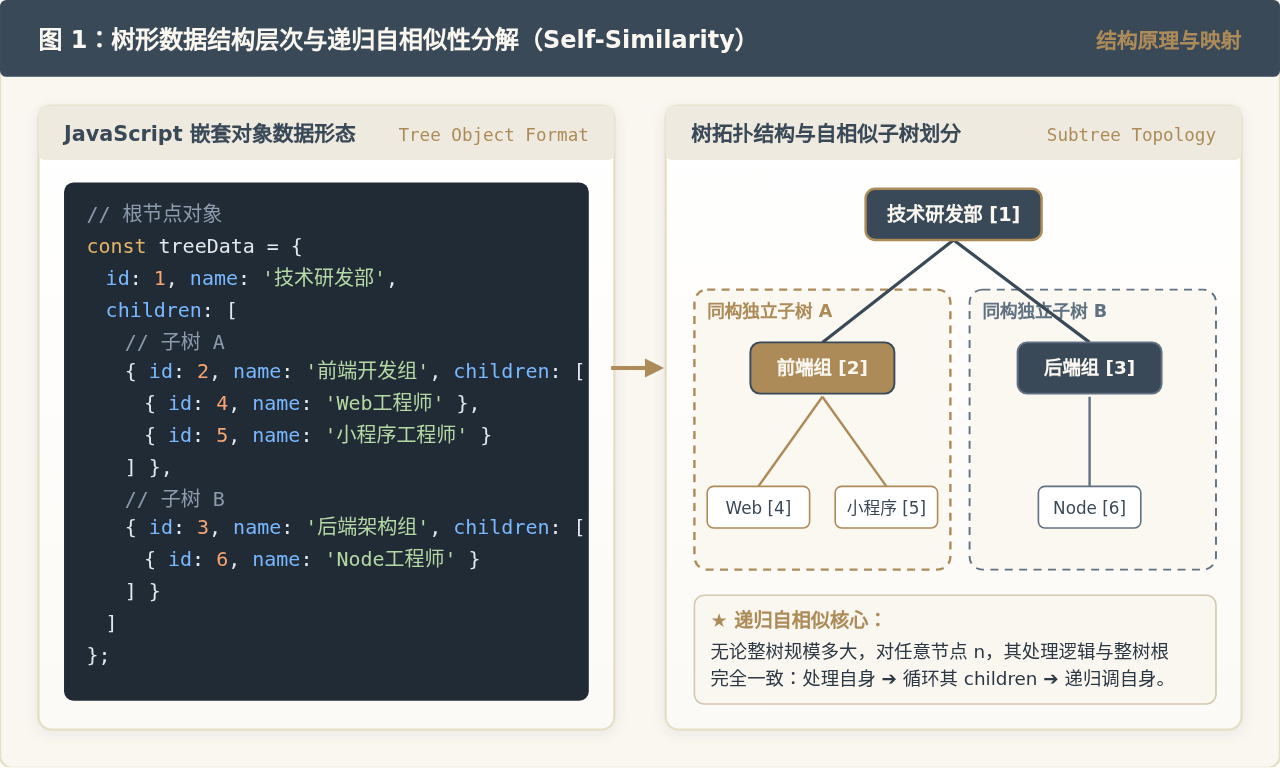
为了保证后续讲解中所有示例代码的可验证性与前后一致性,我们定义如下标准的组织架构树作为全局测试用例:
// 测试数据集:企业组织架构树
const departmentTree = {
  id: 1,
  name: '技术研发中心',
  children: [
    {
      id: 2,
      name: '前端技术组',
      children: [
        { id: 4, name: 'Web架构组', children: [] },
        { id: 5, name: '移动端组', children: [] }
      ]
    },
    {
      id: 3,
      name: '后端技术组',
      children: [
        { id: 6, name: '服务框架组', children: [] }
      ]
    }
  ]
};
二、递归遍历的核心逻辑与调用栈执行流程
设计一个无缺陷的递归函数,必须严格确立两个核心要素:基准终止条件(Base Case)与递推工作步(Recursive Step)。在树形遍历场景下:
- 基准终止条件:当输入节点为空,或者当前节点的
children数组为空时,当前函数调用完成本职任务,不再继续向下调用,执行流程自动返回上一层调用。 - 递推工作步:针对当前节点执行业务逻辑(如访问、打印、提取),随后循环其
children数组,以每个子节点为参数再次调用当前函数。
1. 先序遍历与后序遍历的次序差异
根据处理当前节点与遍历子节点的相对先后顺序,树的深度优先遍历(DFS)主要分为两种形态:
- 先序遍历(Pre-order):先处理当前节点本身,再递归遍历所有子节点。这种模式遵循“自顶向下”传播逻辑,适用于生成带有层级前缀的路径名称、按文档顺序渲染节点或下发继承配置属性。
- 后序遍历(Post-order):先递归遍历所有子节点,待所有子分支全部处理并回溯后,再处理当前父节点。这种模式遵循“自底向上”汇总逻辑,适用于计算下属所有子节点的文件体积总和、删除树节点时的级联清理,以及后文将详细介绍的剪枝筛选。
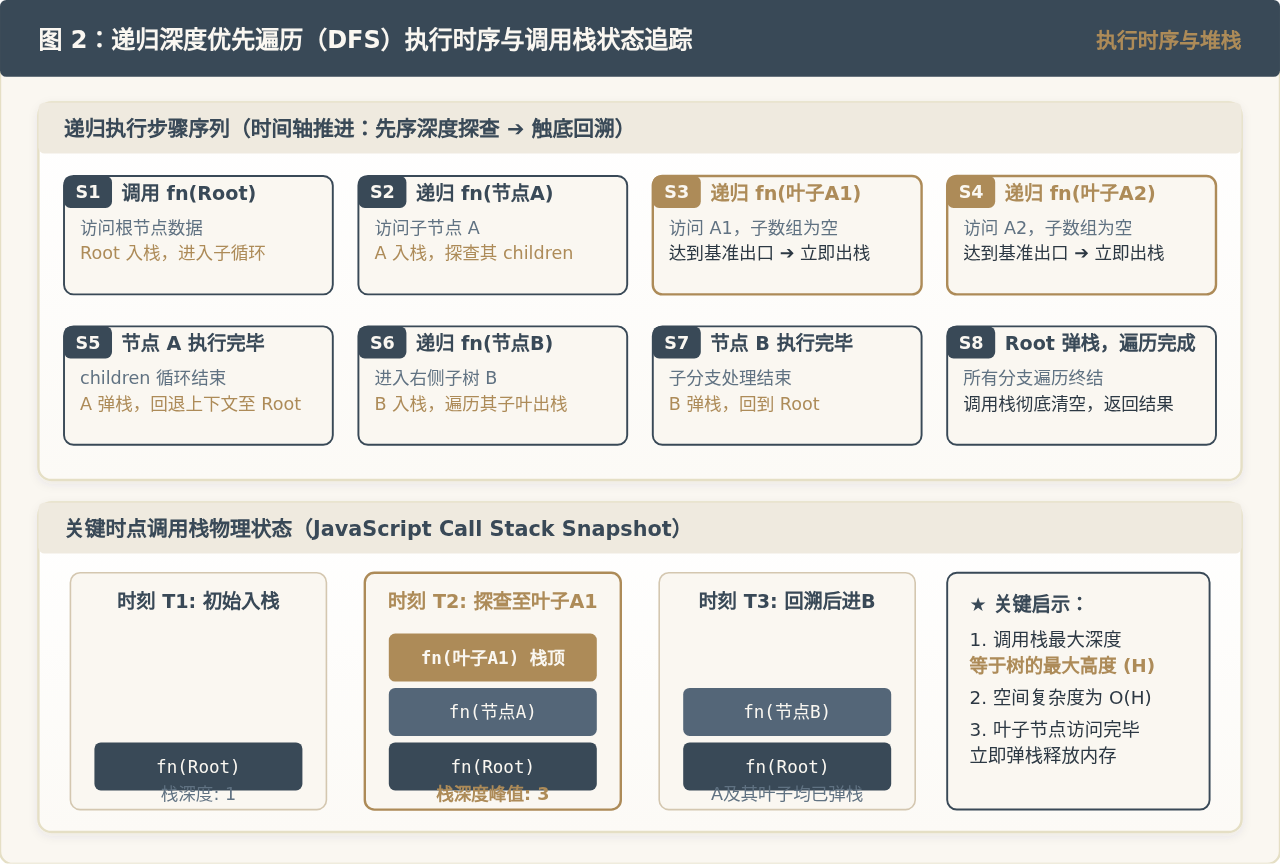
2. 基础遍历器的代码实现与执行追踪
以下代码演示了一个支持传入访问回调函数与层级深度追踪的标准递归遍历器。通过控制 callback 的执行时机,即可在先序和后序之间自如切换:
/**
 * 递归深度优先遍历树形结构
 * @param {Object} node - 当前遍历的树节点
 * @param {Function} callback - 节点访问回调函数,接收 (node, depth, order)
 * @param {number} depth - 当前节点的层级深度(根节点为 0)
 */
function traverseTree(node, callback, depth = 0) {
  // 基准防御:防止传入无效节点
  if (!node || typeof node !== 'object') {
    return;
  }

  // 1. 先序访问阶段(自顶向下)
  callback(node, depth, 'pre');

  // 2. 递归推进阶段:遍历所有子节点
  if (Array.isArray(node.children)) {
    for (const child of node.children) {
      traverseTree(child, callback, depth + 1);
    }
  }

  // 3. 后序访问阶段(自底向上)
  callback(node, depth, 'post');
}

// 执行先序打印测试
console.log('=== 先序遍历输出结果 ===');
traverseTree(departmentTree, (node, depth, order) => {
  if (order === 'pre') {
    const indent = '  '.repeat(depth);
    console.log(`${indent}[L${depth}] ${node.name} (ID: ${node.id})`);
  }
});
示例运行输出
=== 先序遍历输出结果 ===[L0] 技术研发中心 (ID: 1)
[L1] 前端技术组 (ID: 2)
[L2] Web架构组 (ID: 4)
[L2] 移动端组 (ID: 5)
[L1] 后端技术组 (ID: 3)
[L2] 服务框架组 (ID: 6)
三、高频业务场景的递归实战代码与逻辑详解
在实际项目中,纯粹的节点打印极为少见,更多的是围绕查找、过滤剪枝、数据结构映射和扁平化展开的业务操作。这四类场景各自具备独特的逻辑状态流转特征。
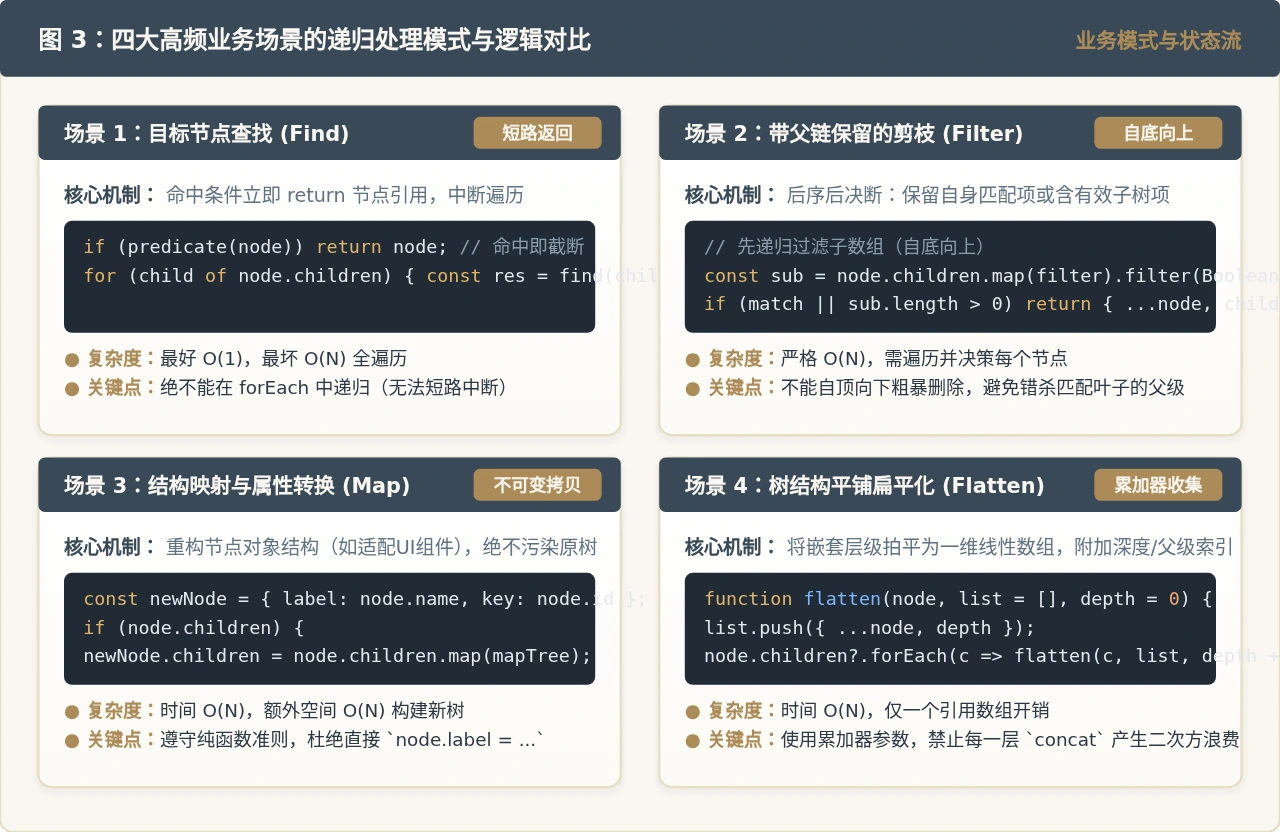
1. 目标节点查找(短路返回模式)
核心诉求:在树中查找满足特定条件的第一个节点(例如通过 id 查找节点)。一旦找到目标,必须立即阻断后续所有递归,直接将节点层层返回,避免进行整树全量扫描。
关键陷阱:很多初学者习惯在 children.forEach(...) 内部写 if (match) return child;。需要强调的是,forEach 的回调函数中的 return 仅相当于 continue,不仅无法提前终止 forEach 循环,更无法将结果传递给外层函数。因此,必须使用原生的 for...of 循环配合条件判断实现短路。
/**
 * 在树中按条件查找单个节点(短路返回)
 * @param {Object} node - 根节点
 * @param {Function} predicate - 判定条件函数,接收 node,返回 boolean
 * @returns {Object|null} 查找到的节点或 null
 */
function findNode(node, predicate) {
  if (!node || typeof node !== 'object') {
    return null;
  }

  // 1. 检查当前节点是否命中
  if (predicate(node)) {
    return node;
  }

  // 2. 递归检索子节点,使用 for...of 保证短路特性
  if (Array.isArray(node.children)) {
    for (const child of node.children) {
      const found = findNode(child, predicate);
      if (found) {
        return found; // 找到即刻上抛,中断后续兄弟节点检索
      }
    }
  }

  return null;
}

// 执行查找测试:查找 id 为 5 的节点
const targetNode = findNode(departmentTree, item => item.id === 5);
console.log('查找结果:', targetNode ? targetNode.name : '未找到');
示例运行输出
查找结果: 移动端组
2. 带父链保留的剪枝过滤(自底向上后序决策)
核心诉求:在搜索框中输入关键字时,前端需要对树形菜单进行实时过滤。规则是:如果某个叶子节点命中关键字,则不仅该叶子节点需要展示,其所在的上级所有父节点(作为上下文路径)也必须保留;反之,若某个子树内没有任何节点匹配,整条无用分支应被整体“剪除”。
算法逻辑:该场景无法从上往下一次决断,因为父节点自身虽然不匹配关键字,但无法提前预知其子孙节点是否匹配。因此必须采用自底向上的后序递归:先对所有子节点进行递归过滤,收集过滤后的有效子节点列表;如果“有效子节点列表非空”或者“当前节点自身命中”,则保留当前节点并装配过滤后的子列表;否则返回 null 彻底剔除。
/**
 * 树形结构关键字过滤(自底向上剪枝并保留父链)
 * @param {Object} node - 原始树节点
 * @param {Function} predicate - 筛选条件函数
 * @returns {Object|null} 修剪后的新树副本,无匹配项则返回 null
 */
function filterTree(node, predicate) {
  if (!node || typeof node !== 'object') {
    return null;
  }

  // 1. 先递归过滤子节点数组(自底向上)
  let filteredChildren = [];
  if (Array.isArray(node.children)) {
    filteredChildren = node.children
      .map(child => filterTree(child, predicate))
      .filter(Boolean); // 剔除返回 null 的无效分支
  }

  // 2. 判定当前节点留存条件:自身命中 OR 子节点有留存项
  const isCurrentMatch = predicate(node);
  const hasValidChildren = filteredChildren.length > 0;

  if (isCurrentMatch || hasValidChildren) {
    // 返回全新的不可变副本,挂载过滤后的子节点
    return {
      ...node,
      children: filteredChildren
    };
  }

  // 自身不匹配且无有效子节点,整体剪枝剔除
  return null;
}

// 执行过滤测试:筛选名称中包含“架构”的节点
const prunedTree = filterTree(departmentTree, item => item.name.includes('架构'));
console.log('修剪后树结构:', JSON.stringify(prunedTree, null, 2));
示例运行输出
修剪后树结构: {"id": 1,
"name": "技术研发中心",
"children": [
{
"id": 2,
"name": "前端技术组",
"children": [
{ "id": 4, "name": "Web架构组", "children": [] }
]
},
{
"id": 3,
"name": "后端技术组",
"children": [
{ "id": 6, "name": "服务框架组", "children": [] }
]
}
]
}
3. 树结构映射转换(不可变数据映射)
核心诉求:后端接口返回的字段命名与UI组件库(如 Element Plus 的 el-tree 或 Ant Design 的 Tree)不一致。例如后端字段为 id/name,而UI组件要求接收 key/title。
工程规范:严禁直接使用 node.key = node.id 对原数据进行就地篡改(In-place Mutation)。在现代前端框架中,直接修改源对象属性容易破坏响应式系统的依赖收集或引发不可预测的浅比较缓存失效。应当遵循纯函数原则,生成全新的对象副本。
/**
 * 递归转换树节点属性(不可变深层映射)
 * @param {Object} node - 原始树节点
 * @param {Function} transformFn - 转换规则函数,返回新节点对象
 * @returns {Object} 转换后的新树
 */
function mapTree(node, transformFn) {
  if (!node || typeof node !== 'object') {
    return node;
  }

  // 1. 调用转换函数处理当前节点
  const transformed = transformFn(node);

  // 2. 递归映射子节点
  let mappedChildren = [];
  if (Array.isArray(node.children)) {
    mappedChildren = node.children.map(child => mapTree(child, transformFn));
  }

  return {
    ...transformed,
    children: mappedChildren
  };
}

// 执行属性映射测试:转换为组件标准字段 key 和 title
const uiTree = mapTree(departmentTree, item => ({
  key: `dept-${item.id}`,
  title: item.name,
  isLeaf: !item.children || item.children.length === 0
}));
console.log('UI组件适配树:', uiTree.key, uiTree.title, '子节点数量:', uiTree.children.length);
示例运行输出
UI组件适配树: dept-1 技术研发中心 子节点数量: 2
4. 树形结构扁平化(累加器收集模式)
核心诉求:将多层级的树展开为一维线性数组,用于表格(Table)渲染、导出CSV或建立以 id 为键的极速映射表(Map)。
性能关键:避免在递归每一层时都使用 result.concat(...) 或扩展运算符 [...arr1, ...arr2]。每次数组解构合并都会重新申请内存并复制所有元素,导致算法的时间复杂度从 O(N) 恶化至 O(N^2)。高效的做法是通过默认形参传入一个累加器数组引用(accumulator),全程只对这一个数组执行 push 操作。
/**
 * 将嵌套树扁平化为一维数组(累加器模式)
 * @param {Object} node - 当前节点
 * @param {Array} accumulator - 结果累加收集器
 * @param {number} depth - 当前节点层级
 * @param {number|null} parentId - 父节点ID
 * @returns {Array} 扁平化后的节点列表
 */
function flattenTree(node, accumulator = [], depth = 0, parentId = null) {
  if (!node || typeof node !== 'object') {
    return accumulator;
  }

  // 1. 抽取当前节点属性,附加层级与父级指针,推入收集器
  accumulator.push({
    id: node.id,
    name: node.name,
    depth: depth,
    parentId: parentId
  });

  // 2. 递归平铺子节点
  if (Array.isArray(node.children)) {
    for (const child of node.children) {
      flattenTree(child, accumulator, depth + 1, node.id);
    }
  }

  return accumulator;
}

// 执行扁平化测试
const flatList = flattenTree(departmentTree);
console.log('扁平化节点总数:', flatList.length);
console.log('首个元素:', flatList[0]);
示例运行输出
扁平化节点总数: 5首个元素: { id: 1, name: '技术研发中心', depth: 0, parentId: null }
四、边界防御、性能陷阱与迭代替代方案
在企业级生产环境中,输入数据可能存在缺损、数据源不可信甚至存在恶意构造的数据环。直接运行未加防御的递归函数容易导致严重的运行时崩溃。
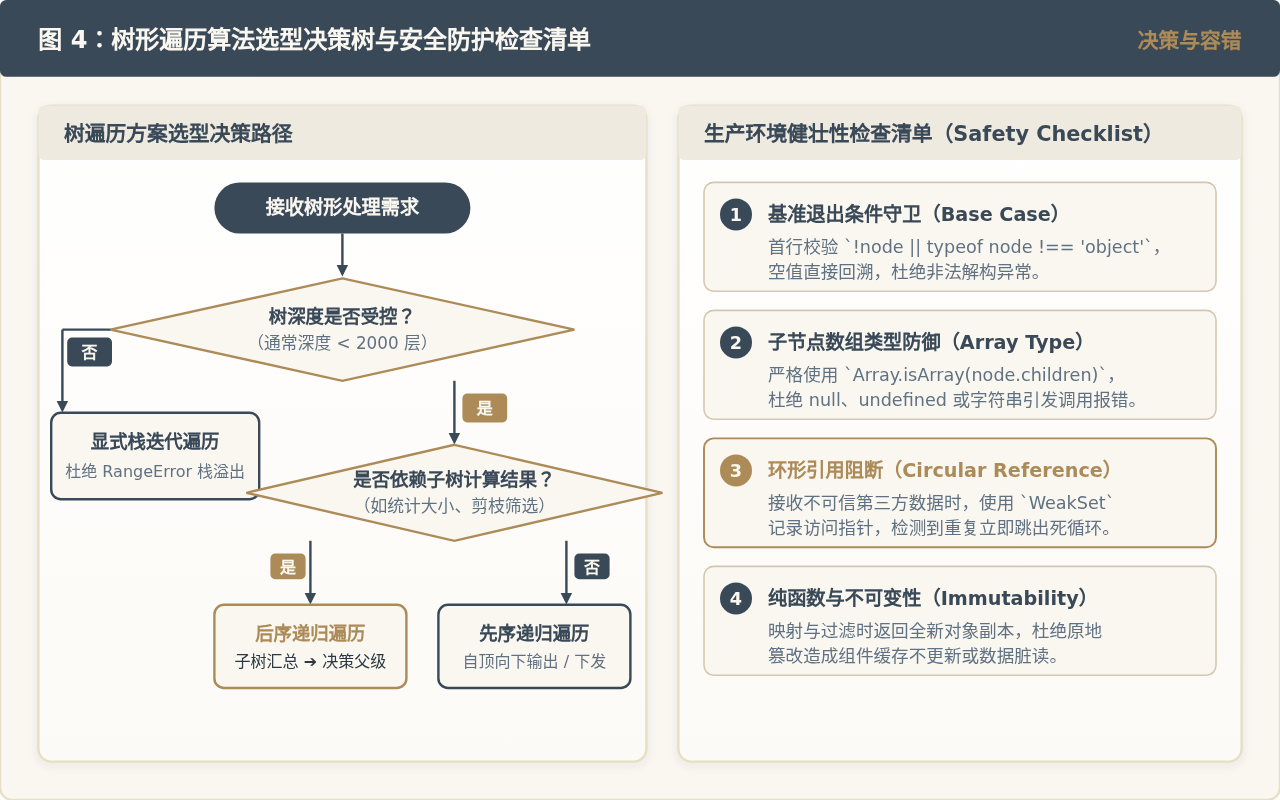
1. 必须落实的四项防御性措施
-
空值与数据类型守卫:必须在函数首行严格检查
!node || typeof node !== 'object',防止针对undefined执行属性访问抛出TypeError。 -
严格使用
Array.isArray:禁止使用if (node.children)这类隐式真值判断。如果脏数据中children意外为字符串或数字,使用for...of将直接引发运行时异常。 -
环形引用阻断(Circular Reference):如果业务数据中存在子节点引用父节点的情况(形成了图结构),普通的递归将陷入死循环,直至抛出
RangeError: Maximum call stack size exceeded。可以使用WeakSet保存已访问节点的引用,检测到重复立即跳出。 - 调用栈溢出风险评估:在V8引擎(Chrome / Node.js)中,函数的最大递归深度通常在 10,000 层 左右。如果待处理的树是由链表转化而来的极深树(深度超过 5,000 层),递归将触发调用栈溢出。
2. 显式栈迭代遍历(防栈溢出替代方案)
当树的深度未知或极深时,最佳工程实践是使用显式数组模拟调用栈的迭代法(Iterative DFS)。显式栈占用的内存位于堆(Heap)中,能够轻松承载数百万量级的节点而绝不会触发系统调用栈溢出:
/**
 * 基于显式栈的深度优先迭代遍历(彻底免疫栈溢出)
 * @param {Object} root - 根节点
 * @param {Function} callback - 访问回调
 */
function traverseTreeIterative(root, callback) {
  if (!root || typeof root !== 'object') return;

  // 使用堆内存中的普通数组模拟调用栈
  // 每个栈帧包含节点引用与对应深度
  const stack = [{ node: root, depth: 0 }];
  const visitedSet = new WeakSet(); // 防环引用守卫

  while (stack.length > 0) {
    const { node, depth } = stack.pop();

    if (!node || visitedSet.has(node)) continue;
    visitedSet.add(node);

    // 访问当前节点
    callback(node, depth);

    // 将子节点逆序压栈,保证出栈时子节点按原有正序被访问
    if (Array.isArray(node.children) && node.children.length > 0) {
      for (let i = node.children.length - 1; i >= 0; i--) {
        stack.push({
          node: node.children[i],
          depth: depth + 1
        });
      }
    }
  }
}

// 执行测试
console.log('=== 显式栈遍历执行验证 ===');
traverseTreeIterative(departmentTree, (node, depth) => {
  console.log(`[栈深度: ${depth}] ${node.name}`);
});
示例运行输出
=== 显式栈遍历执行验证 ===[栈深度: 0] 技术研发中心
[栈深度: 1] 前端技术组
[栈深度: 2] Web架构组
[栈深度: 2] 移动端组
[栈深度: 1] 后端技术组
[栈深度: 2] 服务框架组
五、递归与迭代技术选型对比
为了在实际开发中做出合理的工程权衡,下表汇总了递归与迭代两种方案在核心维度上的具体对比:
| 对比维度 | 递归遍历方案(Recursion) | 显式栈迭代方案(Iteration) |
|---|---|---|
| 代码可读性与可维护性 | 极高。逻辑紧凑,天然映射树结构的嵌套形态。 | 中等。需要手动维护栈结构和状态指针。 |
| 内存开销机制 | 依赖系统执行调用栈(Call Stack),深度受限于栈空间(约 10,000 层)。 | 依赖堆内存(Heap),受限于机器可用物理内存(数百万级)。 |
| 执行速度 | 在常规深度(< 500 层)下,V8引擎函数调用开销微乎其微,速度极快。 | 频繁进行数组 push/pop,在小规模数据下与递归无明显差异。 |
| 自底向上汇总能力 | 极强。天然支持函数回溯返回值,极易实现剪枝过滤与子节点统计。 | 较弱。若要实现后序遍历,需维护额外的标记位或双栈。 |
| 适用业务场景 | UI组件树、权限路由、分类目录等深度受控的标准业务数据。 | 海量文件扫描、AST语法树解析、深度不可控的外部导入数据。 |
工程落地建议
日常前端与常见后台业务中,树深度极少超过 20 层。在此类常规场景中,应当首选原生递归,其代码自解释性强、易于维护且天然支持自底向上的数据回溯。唯有当输入数据源自不可信的第三方文件、深层网络爬虫或深度不可测的大型依赖图时,才应切换至显式栈迭代遍历方案。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章