
深入解析在JavaScript中处理与解析超大JSON文件时的性能瓶颈,系统阐述流式解析、Web Worker多线程解耦、NDJSON格式重构、simdjson硬件加速等实用工程策略与完整代码示例。

当前位置:首页 > Node.js 性能优化 > 正文
JS优化超大JSON文件解析性能的策略
作者:慢半拍
时间:2026-11-21
浏览:639
文章目录
Web 前端 / Node.js 架构调优
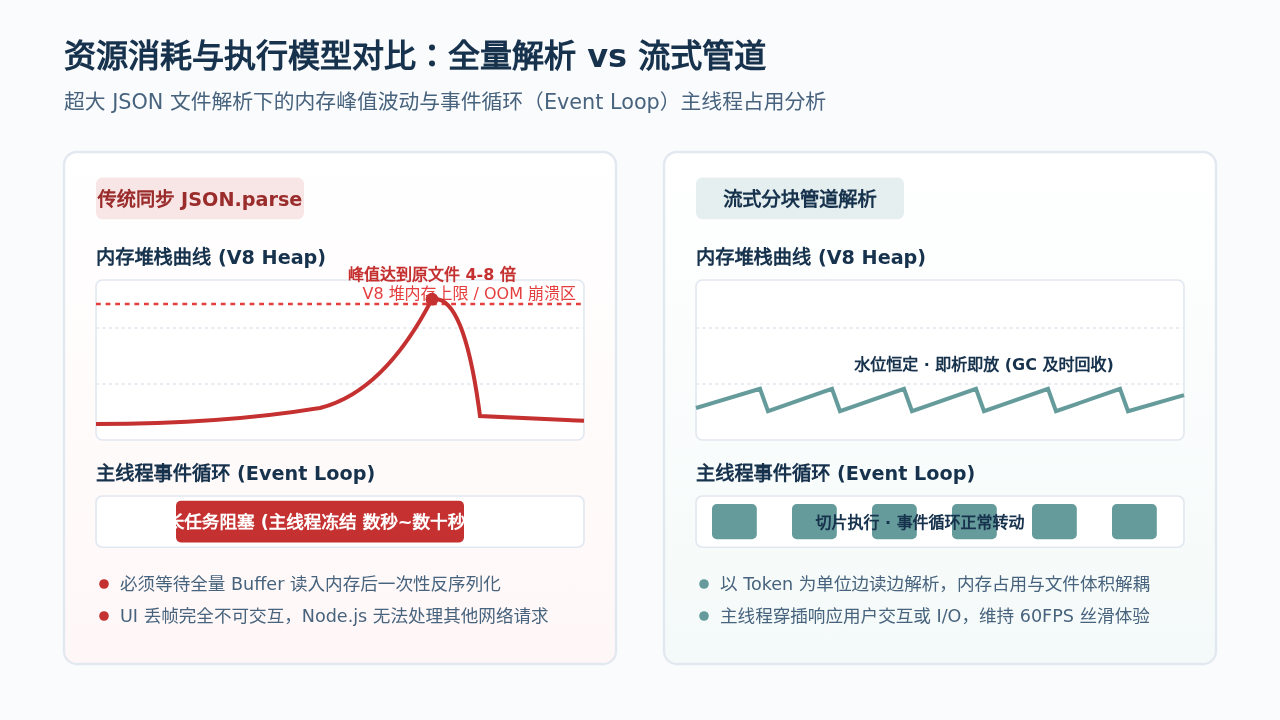
图 1:传统同步全量反序列化与流式管道解析的内存堆栈波动及主线程占用对比
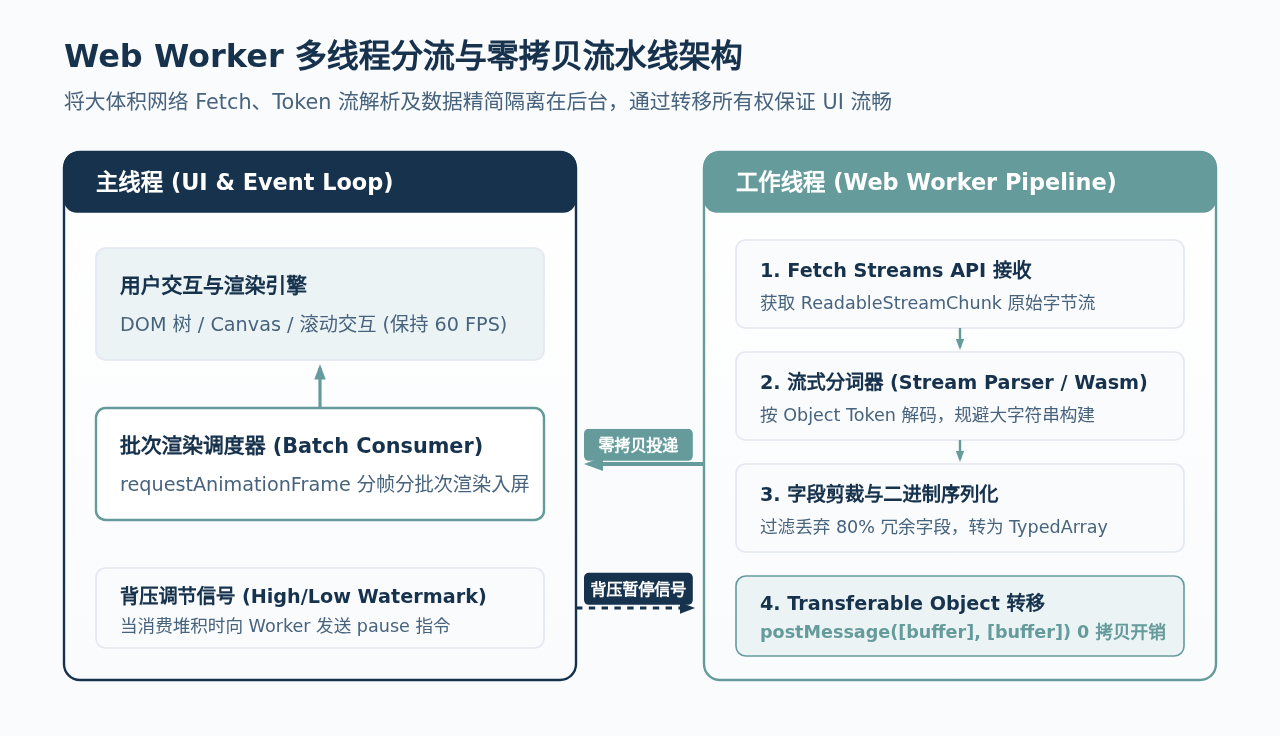
图 2:Web Worker 异步流式分词、就地裁剪与 Transferable 零拷贝通信全链路架构
Worker 脚本实现(worker-parser.js)
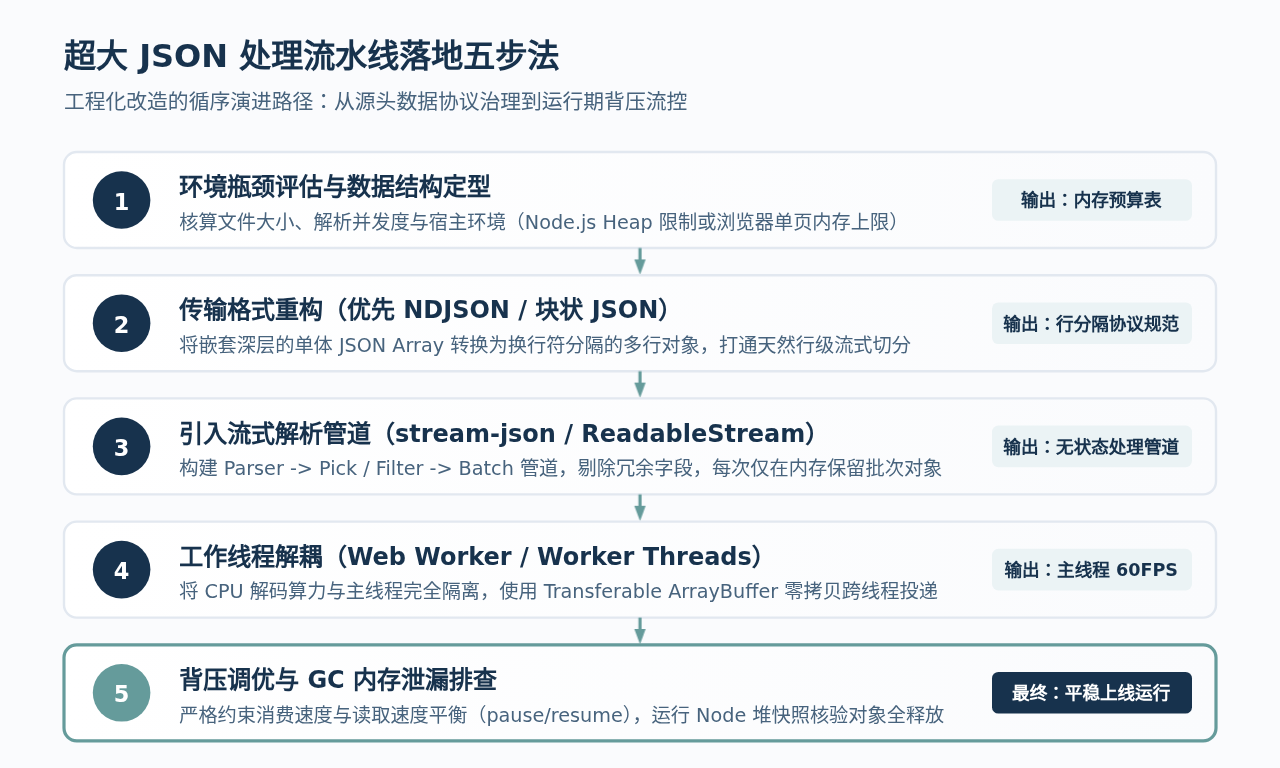
图 3:超大 JSON 处理流水线标准化工程实施与落地五步演进流程
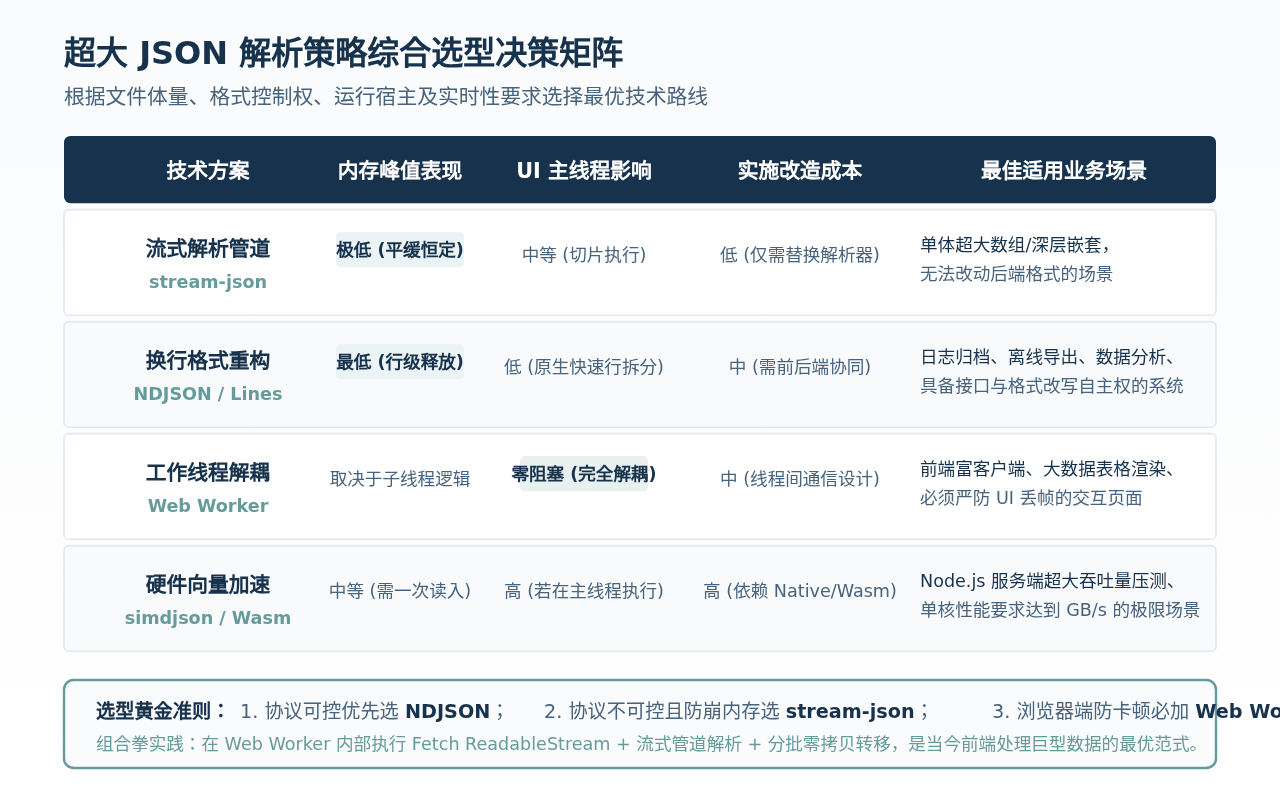
图 4:超大 JSON 解析策略综合选型决策矩阵与架构黄金准则
发布分类:性能工程实战
•
适用环境:Browser / Node.js / V8 Engine
•
阅读预计耗时:15 分钟
在 JavaScript 中处理达到几十兆(MB)甚至数吉字节(GB)的超大 JSON 文件时,直接调用原生的 JSON.parse 几乎必然会遭遇两大瓶颈:主线程长时间完全冻结与 V8 堆内存溢出(OOM, Out of Memory)。原生的解析方式要求一次性将整个字符串载入内存,并在调用栈中同步构建完整的复杂对象树,这在数据规模膨胀时是致命的。优化超大 JSON 解析性能的核心解决路径,本质上是将“全量同步反序列化”重构为“按需流动、多线程分流、细粒度消费与指令级加速”的流式流水线。本文将深入剖析底层内存与线程机制,并系统讲解五套可直接落地的优化策略与代码方案。
一、为什么超大 JSON 会拖垮 JavaScript 运行环境?
在探讨优化方案前,我们需要清晰理解为什么简单的 JSON.parse(text) 在应对大体积文件时会如此脆弱。这并非单纯的运算缓慢,而是由 V8 引擎的物理边界和底层内存模型共同决定的。
1. V8 字符串最大长度限制(String::kMaxLength)
许多开发者容易忽略的是,JavaScript 中的字符串并非无限长。在 64 位的 Node.js 与 Chromium V8 引擎中,单个字符串所允许的最大字符长度通常受限在约 512MB(不同 V8 版本在 512MB 至 1GB 之间,32 位环境更低至约 256MB)。当你的 JSON 文件体积超过该物理阈值时,在执行 fs.readFileSync 转化为单个字符串或调用 response.text() 的瞬间,引擎就会直接抛出 RangeError: Cannot create a string longer than 0x1fffffe8 characters 致命异常,导致程序直接崩溃退出,甚至根本来不及进入 JSON.parse 解析阶段。
2. 内存放大效应(Memory Bloat)与垃圾回收压力
一段磁盘上仅占 100MB 的 JSON 文本,在反序列化成 JavaScript 运行时堆对象后,其占用的内存往往会剧烈膨胀到 400MB 至 800MB(通常放大 4~8 倍)。造成这种极度膨胀的原因包括:
- Hidden Class(隐藏类/Map)元数据开销:每个 JS 对象不仅存储值,还需要额外指针指向其隐藏类、原型链和属性描述符。
- 指针寻址与对齐填充:64 位指针本身占用 8 字节,加之内存对齐规则,使得小对象的元数据开销常常远超其实际承载的有效荷载。
- 短时间内产生海量新生代对象:数百万个嵌套的小对象在极短时间内涌入堆中,瞬间塞满新生代半空间(Semi-space),频繁触发全停顿(Stop-the-world)的 Major GC,导致 CPU 占用率飙升至 100%。
3. 单线程事件循环(Event Loop)与长任务卡死
JSON.parse 是由底层 C++ 编写的纯同步函数。在执行期间,JavaScript 引擎的事件循环处于彻底阻塞状态。在浏览器端,这表现为典型的长任务(Long Task),页面帧率瞬间跌零,CSS 动画定格、用户点击和输入毫无响应,甚至触发浏览器的“页面无响应,是否强制关闭”提示;在 Node.js 服务端,该工作进程在解析期间无法接收任何新的 TCP 握手和 HTTP 请求,造成可怕的高尾延迟(Tail Latency)。
生产环境警示:不要在主事件循环中直接 parse 超过 20MB 的 JSON
即便你的机器拥有 64GB 物理内存,Node.js 默认单进程堆内存上限也仅在 1.4GB~2GB 左右(可通过 --max-old-space-size 放大,但无法根治同步阻塞)。在单线程里一次性解析几十兆的深层嵌套 JSON,足以让服务瞬间停摆数秒。
二、策略一:基于 Stream 的流式与管道化解析(零全量内存积压)
解决内存堆积最有效的工程策略是流式解析(Streaming Parsing)。流式解析不再假设“先拿到完整字符串,再生成完整树结构”,而是借鉴了 XML 时代的 SAX 事件驱动解析思想:从网络或磁盘以小 Buffer 块逐步读入,解析器以 Token(标记)为单位前行,一旦识别出一段完整的独立业务对象,便触发事件交由业务代码消费,随后立即丢弃并允许垃圾回收器复用该段内存。
1. Node.js 环境实战:使用 stream-json 构建流水线
在 Node.js 中,stream-json 是目前业界最成熟的流式 JSON 管道库。它基于 Node.js 原生 stream.Transform 机制,能够轻松应对 GB 级别的超大 JSON 数组或键值对字典。
const fs = require('fs');
const { parser } = require('stream-json');
const { streamArray } = require('stream-json/streamers/StreamArray');
const { Writable } = require('stream');

// 创建可读流:无需一次性读取,Node 会按 highWaterMark(默认 64KB)逐块推进
const pipeline = fs.createReadStream('./massive-dataset.json')
  .pipe(parser())          // 1. 语法词法流式解析器(Token 级别)
  .pipe(streamArray());    // 2. 针对根数组形态,逐条组装出元素对象

let recordCount = 0;

// 自定义下游可写流:负责分批处理业务逻辑并支持原生背压控制
const consumerStream = new Writable({
  objectMode: true,
  write(chunk, encoding, callback) {
    // chunk 包含 { index: 0, value: { id: ..., name: ... } }
    const item = chunk.value;
    recordCount++;

    // 模拟处理或写入数据库操作
    processRecord(item)
      .then(() => {
        // 调用 callback 告知上游:本条目已消费完毕,可以继续传递下一条
        callback();
      })
      .catch((err) => {
        callback(err);
      });
  }
});

pipeline.pipe(consumerStream);

consumerStream.on('finish', () => {
  console.log(`[成功] 解析完成!累计处理条目:${recordCount},内存峰值始终维持在低水平。`);
});

pipeline.on('error', (err) => {
  console.error('[错误] 解析流发生异常:', err.message);
});

async function processRecord(record) {
  // 在此处执行业务过滤、汇总或落库,避免向外部全局数组追加累加
  if (recordCount % 10000 === 0) {
    const memoryUsage = process.memoryUsage().heapUsed / 1024 / 1024;
    console.log(`已处理 ${recordCount} 行,当前活跃堆内存:${memoryUsage.toFixed(2)} MB`);
  }
}
2. 浏览器环境实战:Fetch Streams API 分块流读入
在前端现代浏览器中,我们可以借助 fetch 提供的 response.body(即 ReadableStream)配合异步迭代器,边下载边切片解析,而无需等待整个数百兆文件完全下载到 Blob 中:
async function fetchAndStreamJSON(url) {
  const response = await fetch(url);
  const reader = response.body.getReader();
  const decoder = new TextDecoder('utf-8');
  let buffer = '';

  while (true) {
    const { done, value } = await reader.read();
    if (done) break;

    // 将字节块解码为文本片段
    buffer += decoder.decode(value, { stream: true });

    // 配合轻量分词器或行提取逻辑,消费已闭合片段
    buffer = extractAndProcessTokens(buffer);
  }
}
核心注意点:严格遵守流的背压(Backpressure)机制
流式解析最大的误区是将解析出来的 data 事件直接 push 进一个全局的大 Array 中。这样做流式解析就完全失去了意义——内存依然会在你的业务数组中积聚爆炸。必须确保消费端具备背压信号,处理完一批再拉取一批,或及时聚合后写入持久化存储。
三、策略二:Web Worker 与多线程解耦(消除主线程卡顿)
即使使用了流式解析,分词和反序列化本身的 CPU 计算开销依然存在。在浏览器前端,若在主线程进行持续计算,页面交互必然出现掉帧。优化这一现象的标准武器是 Web Worker(在 Node.js 中则是 worker_threads)。
1. 跨线程通信的“二次雪崩”陷阱
许多初次使用 Web Worker 优化 JSON 解析的同学会踩入一个典型陷阱:在 Worker 中下载并解析出巨型 JavaScript 对象,然后通过 postMessage(hugeObject) 发回给主线程。此时浏览器会使用结构化克隆算法(Structured Clone Algorithm)对这个巨大的对象树进行深度递归遍历与内存拷贝,这一步会再次在主线程造成长达数秒的 CPU 卡死!
2. 终极解法:就地提纯与 Transferable Objects(零拷贝)
要真正发挥多线程的优势,应当遵循如下两条核心设计原则:
- 数据在 Worker 内部就地精简过滤:通常前端展示并不需要后端返回的 50 个字段,可能仅需展示 3 个汇总指标或首屏的 100 行。在 Worker 内部完成聚合、排序与过滤,仅将裁剪后的轻量数据返回。
- 使用 Transferable Objects 转移所有权:如果确实需要向主线程传递大批量数值(如三维点云坐标、波形图数据、高维向量),应在 Worker 内部将其打平成
Float32Array或Uint32Array等类型化数组,并在postMessage时将其底层的ArrayBuffer加入 Transfer 列表。这样数据指针的所有权瞬间移交主线程,传输耗时恒定在 0~1 毫秒内,完全杜绝内存拷贝开销。
// 运行在独立线程中的 worker-parser.js
self.onmessage = async (e) => {
  const { url } = e.data;
  const response = await fetch(url);
  const reader = response.body.getReader();

  // 假定我们需要解析的是包含海量坐标点的 JSON 数据
  // Worker 边读边将核心数值提取为一维 Float64Array
  const coordsBuffer = new Float64Array(1000000); // 预分配连续内存空间
  let pointer = 0;

  // ...执行分块解析并将数值填充进 coordsBuffer...

  // 关键步骤:使用 Transferable 零拷贝将 ArrayBuffer 所有权转移给主线程
  self.postMessage({
    action: 'DATA_READY',
    totalPoints: pointer,
    dataBuffer: coordsBuffer.buffer
  }, [coordsBuffer.buffer]); // 第二个参数是 Transferable 列表
};
四、策略三:源头数据协议重构——采用 NDJSON(JSON Lines)
在所有优化策略中,投入产出比最高、实现最优雅的策略其实是从传输格式切入。标准 JSON 在语法上要求最外层由方括号 [...] 或大括号 {...} 紧密闭合。这意味着,解析器在未读到最后一个字符之前,从语法层面上根本无法保证整个 JSON 文档的完整性与有效性。
1. 为什么说 NDJSON 是超大数据的天然救星?
NDJSON(Newline Delimited JSON,亦称 JSON Lines)规定:每一行内容本身就是一个完整且完全合法的独立 JSON 对象,各行之间使用标准的换行符
分隔。这一结构改变带来了巨大的工程红利:
- 极简的分块边界:无需任何复杂的递归下降或有限状态机语法词法分析器,单纯寻找
- 原生行级流式读取:无论数据文件是 100MB 还是 100GB,程序永远只需保持“单行文本”大小的临时内存缓冲区。
- 损坏容错能力极强:如果网络传输中第 5000 行发生字节损坏,后续第 5001 行及其之后的数据依然可以被毫无障碍地正确解析,而标准 JSON 会因为全局语法错误直接崩溃。
const fs = require('fs');
const readline = require('readline');

async function processMassiveNDJSON(filePath) {
  const fileStream = fs.createReadStream(filePath);

  // 利用 Node.js 内置的 readline 模块,自动根据
?
 分割行
  const rl = readline.createInterface({
    input: fileStream,
    crlfDelay: Infinity // 支持识别所有 CR LF 组合
  });

  let lineCount = 0;

  for await (const line of rl) {
    if (!line.trim()) continue; // 跳过空行

    // 每一行都可以安全地调用原生、快速的 JSON.parse
    // 且每条记录处理完后立即成为垃圾回收候选对象
    const record = JSON.parse(line);
    lineCount++;

    // 业务逻辑处理
    if (lineCount % 50000 === 0) {
      console.log(`已极速处理 ${lineCount} 行记录...`);
    }
  }

  console.log(`[完成] 总计成功处理 ${lineCount} 条独立记录。`);
}

processMassiveNDJSON('./massive-logs.ndjson');
五、策略四:超大 JSON 处理流水线工程实施五步法
在企业级真实项目中改造超大 JSON 解析流程时,不能盲目堆砌技术,而需要遵循清晰的技术演进路径。下面总结了在生产环境落地这套方案的标准步骤流程:
步骤详解与实施注意事项:
- 第一步:环境瓶颈评估与数据结构定型
首先统计生产环境中 JSON 文件的 P99 体积分布与并发请求数。如果在浏览器端且体积大于 30MB,或者在 Node.js 端并发数高且体积大于 50MB,必须将其划入重点优化清单,建立基准内存与 CPU 耗时指标。 - 第二步:传输格式重构(优先推动 NDJSON)
与后端协商,针对分页导出、日志归档或批量同步接口,改用application/x-ndjson规范输出流式响应。这是最具 ROI(投入产出比)的一步。 - 第三步:接入流式解析管道
在无法修改后端数据协议的前提下,引入成熟的流式解析器(如stream-json)。在管道中配置 Pick/Filter 节点,在反序列化的第一时间剔除无用字段,严禁整包载入内存。 - 第四步:工作线程解耦与零拷贝设计
在客户端前端通过 Web Worker 隔离数据拉取与解析逻辑,通过 TypedArray 与 Transferable Objects 消除主线程跨线程克隆负担,确保前端 UI 在处理百万级数据时仍保持稳定 60FPS。 - 第五步:背压调优与 GC 内存泄漏排查
编写自动化压力测试脚本,在持续输入超大体积流时,监控 Node.js 的heapUsed曲线是否呈现健康的“锯齿状”(升起后随 GC 回落到低水位),核验是否存在全局闭包引用导致对象无法释放。
六、策略五:WebAssembly 与 SIMD 硬件指令级加速(simdjson)
如果业务场景处于极端的高吞吐需求下(例如高性能网关、实时流计算系统或大规模本地数据分析工具),即便是流式解析也可能受制于单核 CPU 字符串遍历的速度上限。此时,引入硬件级加速方案是终极手段。
1. SIMD 与 simdjson 架构突破
传统的 JSON 解析器(包括 V8 内置的 C++ JSON.parse)本质上是按字节逐个向前移动指针判断引号、转义符和逗号。而由知名计算机科学家 Daniel Lemire 等人开发的 simdjson,利用现代 CPU 提供的 SIMD(单指令多数据流,如 Intel AVX-512、AVX2 或 ARM NEON)指令,能够在一个 CPU 周期内并行扫描 64 字节的数据块,单核解析速度超过 2GB/s 至 3GB/s,被誉为目前世界上最快的 JSON 解析引擎。
2. 在 Node.js 与 Web 端的使用方式
- Node.js 原生扩展:社区提供的
simdjson原生 C++ 绑定(如simdjson_nodejs),可以在服务端以接近原生内存带宽的速率直接对 Buffer 进行极速结构化解析。 - WebAssembly 移植版:通过 Emscripten 编译为 Wasm 并在浏览器或 Worker 中调用。需要注意的是,Wasm 方案需要将 JS 内存中的字符串拷贝至 Wasm 线性内存(Linear Memory),对于极度小型的 JSON 这种拷贝损耗会抵消 SIMD 的收益;但对于上百兆的巨型结构,simdjson 的加速优势将极为显著。
七、技术选型决策矩阵与生产避坑指南
为了帮助架构师和工程师根据具体约束作出理性选型,下表对主流方案进行了多维度的横向权衡对比:
生产环境落地总结与避坑清单
- 超大整数精度丢失问题:标准 JSON 规范中数字遵循双精度浮点数(IEEE 754)。当数据中包含超过
Number.MAX_SAFE_INTEGER(9007199254740991,例如 64 位雪花算法 Snowflake ID)的长整型时,JSON.parse会静默丢失低位精度。使用流式解析器(如stream-json)时,可配置数值解析中间件,将其捕获为字符串或原生BigInt。 - 不可预期的格式截断容错:在流式下载过程中,网络断流可能导致 JSON 在中途断开。若使用全量解析,程序将直接抛出语法错误且没有任何中间数据保留;而在流式与 NDJSON 管道中,已经处理并落库的数据具备确定性,可在错误处理钩子中记录断点 offset,实现优雅的断点续传。
- 避免对象池(Object Pool)滥用与隐式泄漏:部分开发者试图缓存并复用 JS 对象以降低 GC 压力,但在 V8 现代高度优化的隐藏类体系下,手写的对象池往往会导致属性顺序混乱破坏 Inline Cache(内联缓存),适得其反。让局部小对象在离开当前 chunk 作用域后自然随年轻代新生代 GC 迅速消亡,往往是最优且最安全的选择。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章