
深入解析JavaScript在处理数百兆及GB级大压缩包时内存溢出(OOM)的根本原因,提供基于流式处理与背压机制的高可用解压方案,涵盖Node.js串行解压实战、浏览器Web Worker架构与Zip炸弹防御。

当前位置:首页 > Node.js 性能优化 > 正文
JS 怎么处理大文件解压避免内存溢出
作者:巡夜人
时间:2026-10-30
浏览:234
文章目录
一、内存溢出的根源:全量加载与流式背压机制
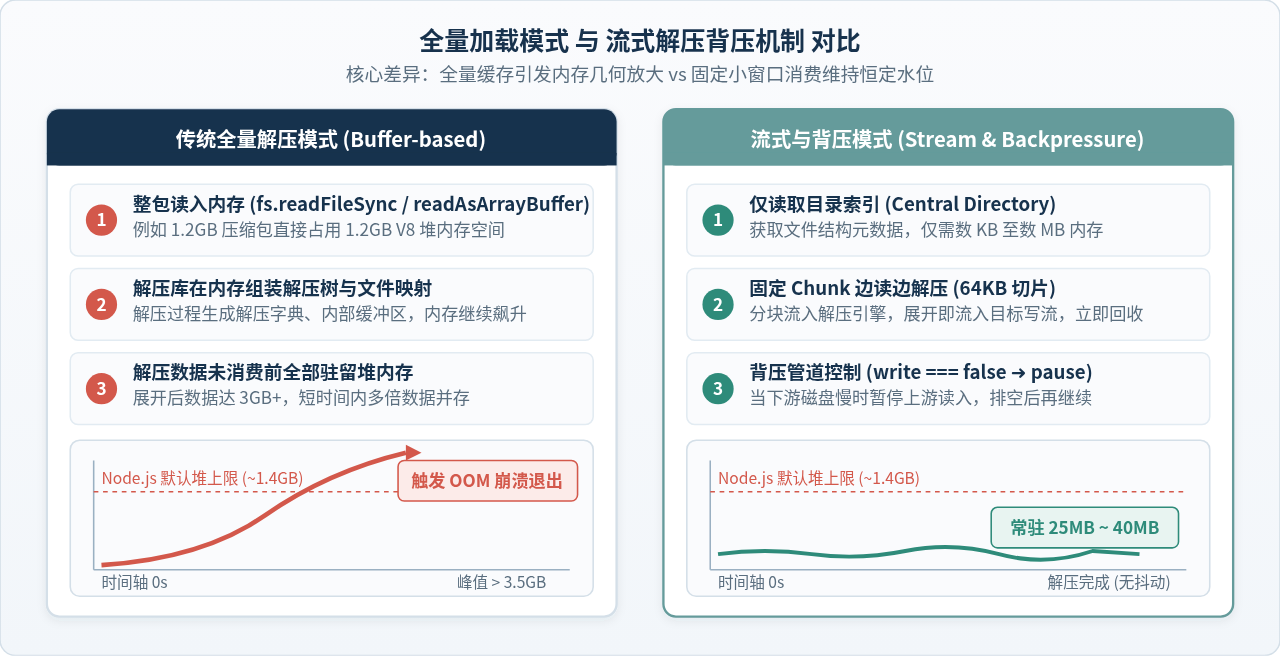
在理解怎么解压大文件前,必须先看清普通解压代码为什么会在大文件面前迅速崩溃。在 V8 引擎中,无论是 64 位 Node.js 运行环境还是浏览器标签页,默认的 JavaScript 堆内存(Heap Memory)都有上限限制。Node.js 默认堆大小通常在 1.4GB 左右(受宿主物理内存和配置影响),而移动端浏览器的标签页内存上限更低,往往只有几百兆。
很多开发者在解压文件时习惯使用以下伪代码所示的传统逻辑:
// 典型错误写法:全量 Buffer 读入与内存解压
const buffer = fs.readFileSync("2GB_dataset.zip"); // 堆占用 +2GB ➜ 接近或触及堆上限
const zip = new AdmZip(buffer);                   // 内存对象反序列化 ➜ 堆占用翻倍
const entries = zip.getEntries();
entries.forEach(entry => {
  const content = entry.getData();                 // 解压产物全部驻留内存 ➜ 直接 OOM 崩溃
  fs.writeFileSync(entry.name, content);
});
这种模式被称为“三次内存暴涨”:第一波是压缩包本身的巨大二进制 Buffer 进堆;第二波是解压库构建内部目录映射与解压字典;第三波是解压出的明文数据再次驻留堆中。解压 2GB 的压缩包,往往需要 5GB 到 8GB 的瞬时内存,V8 垃圾回收器(GC)频繁触发 Mark-Sweep 却无法回收强引用对象,最终直接报出 FATAL ERROR: Ineffective mark-compacts near heap limit Allocation failed - JavaScript heap out of memory。
要打破这个瓶颈,解压机制必须转向流式处理(Streaming)与背压(Backpressure):
- 固定滑动窗口:任何时刻,内存中只保存极少量的分块切片(Chunk,通常为 64KB)。
- 生产者与消费者速率平衡:当下游写入磁盘的速度(例如 80MB/s)慢于解压流展开速度(例如 200MB/s)时,写入流的内部缓冲区会迅速充盈。此时必须向上游发出暂停信号(
pause),阻止读取源继续产生数据;当下游缓冲区被物理磁盘消化(触发drain事件)后,再恢复供流(resume)。这种动态流量调节阀门就是背压机制。
二、Node.js 环境实战:基于流与背压的串行解压方案
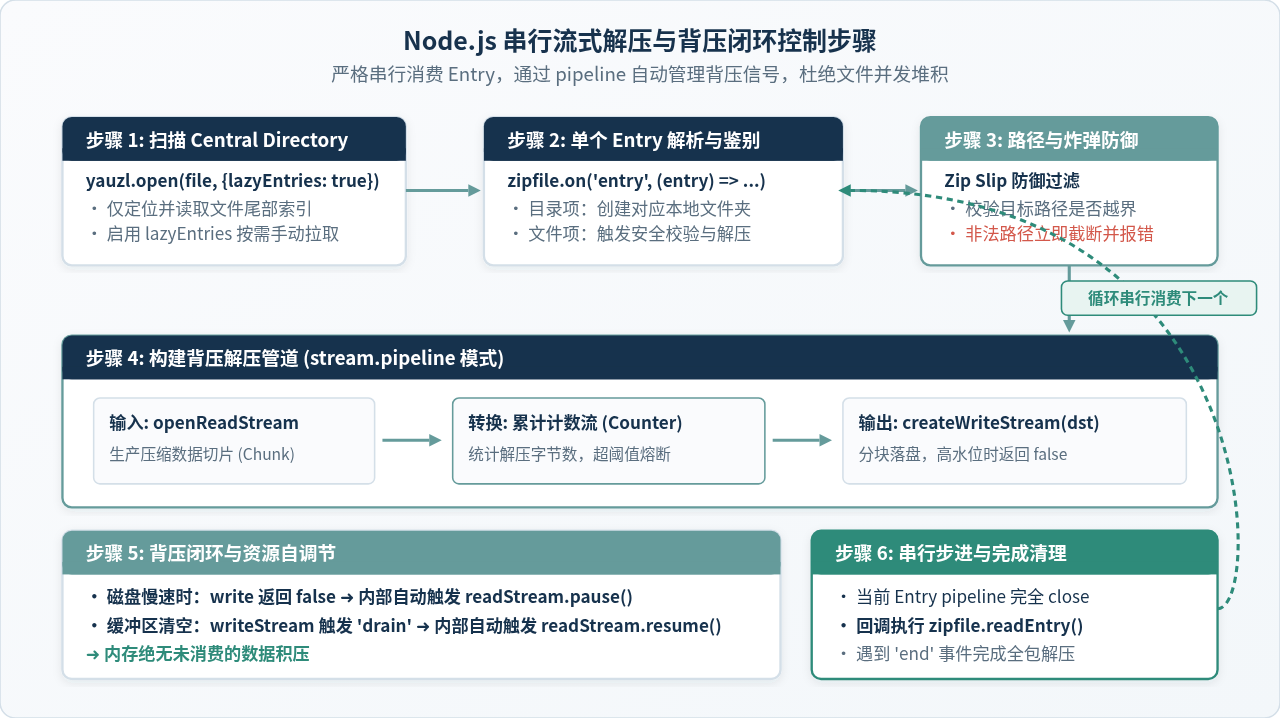
在 Node.js 中处理大 ZIP 文件,库的选择是成败的第一步。常见的 adm-zip 或默认配置下的 jszip 都偏向于整包内存解析,不适合处理 GB 级别的大型压缩包。官方生态中处理大 ZIP 文件的首选工具是 yauzl(Yet Another UnZip Library)或经过流式封装的 unzipper。
yauzl 遵循严格的 ZIP 规范,只通过 random-access 读取压缩包尾部的 Central Directory(中央目录索引),而绝不会在启动时解压文件内容。更重要的是,它提供了 lazyEntries: true 选项,允许我们按需、逐个拉取条目(Entry),实现真正的串行解压。
注意并发解压陷阱:即使使用了流式 API,也千万不要同时解压 ZIP 内的所有 Entry!如果一个 2GB 的压缩包内包含 5,000 个小文件,若在
entry 事件中并发触发 5,000 个 openReadStream,操作系统文件句柄会立即耗尽(EMFILE 错误),且并发流会在内存中积压海量临时缓冲区,再次导致内存溢出。必须坚持解完一个文件、落盘确认、再拉取下一个文件的串行策略。
完整的 Node.js 生产级解压代码示例
以下代码使用 yauzl 和 Node.js 原生的 stream/promises(pipeline),演示如何安全解压大文件并自动接管背压:
import fs from "node:fs";
import path from "node:path";
import { pipeline } from "node:stream/promises";
import yauzl from "yauzl";

/**
 * 安全串行流式解压 ZIP 文件,防止内存溢出与路径穿越
 * @param {string} zipFilePath 压缩包绝对路径
 * @param {string} targetDir 目标解压目录
 */
export async function extractLargeZipSafely(zipFilePath, targetDir) {
  // 确保目标基础目录存在
  await fs.promises.mkdir(targetDir, { recursive: true });
  const resolvedTargetDir = path.resolve(targetDir);

  return new Promise((resolve, reject) => {
    // 开启 lazyEntries:必须显式调用 readEntry 才会推进下一个条目
    yauzl.open(zipFilePath, { lazyEntries: true, autoClose: false }, (err, zipfile) => {
      if (err) return reject(err);

      // 错误统一兜底
      zipfile.on("error", (zipErr) => {
        zipfile.close();
        reject(zipErr);
      });

      // 所有文件解压完毕
      zipfile.on("end", () => {
        zipfile.close();
        resolve();
      });

      // 处理单项 entry
      zipfile.on("entry", async (entry) => {
        try {
          // 1. 规避 Zip Slip 漏洞:校验目标路径不能跳出基准目录
          const destPath = path.resolve(resolvedTargetDir, entry.fileName);
          if (!destPath.startsWith(resolvedTargetDir + path.sep)) {
            throw new Error(`检测到非法文件路径: ${entry.fileName}`);
          }

          // 2. 如果是目录项,直接创建后推进下一个
          if (/\/$/.test(entry.fileName)) {
            await fs.promises.mkdir(destPath, { recursive: true });
            zipfile.readEntry();
            return;
          }

          // 3. 如果是普通文件,先创建上级文件夹
          await fs.promises.mkdir(path.dirname(destPath), { recursive: true });

          // 4. 获取当前 entry 的只读流
          zipfile.openReadStream(entry, async (readStreamErr, readStream) => {
            if (readStreamErr) {
              zipfile.close();
              return reject(readStreamErr);
            }

            const writeStream = fs.createWriteStream(destPath);

            // 5. pipeline 自动管理背压与异常销毁
            // 当 writeStream 满时暂停 readStream,drain 后恢复
            try {
              await pipeline(readStream, writeStream);
              // 当前文件落盘彻底完成,串行提取下一个条目
              zipfile.readEntry();
            } catch (pipeErr) {
              zipfile.close();
              reject(pipeErr);
            }
          });
        } catch (err) {
          zipfile.close();
          reject(err);
        }
      });

      // 启动第一个 Entry 的读取
      zipfile.readEntry();
    });
  });
}
三、现代浏览器环境实战:Web Streams API 与 Web Worker 隔离
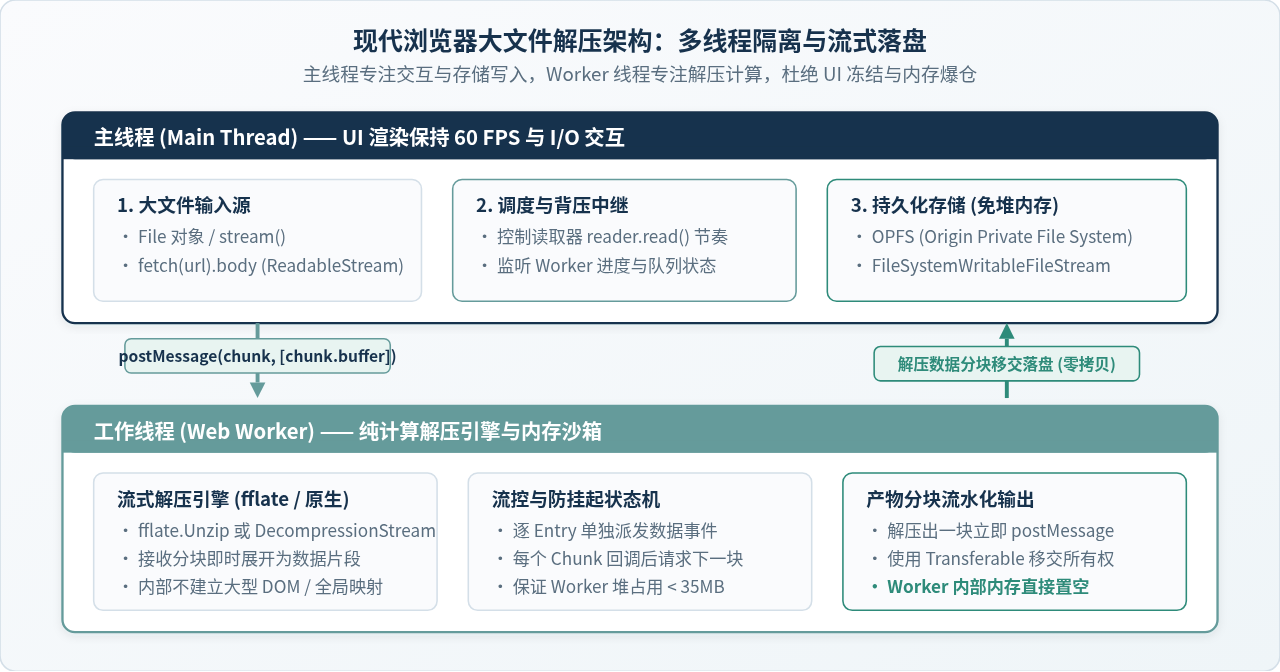
在浏览器端处理大文件解压时,面临更加严格的边界条件:
- 主线程不可阻塞:如果在主线程执行解压计算,CPU 占满会导致网页掉帧、输入无响应、UI 完全冻结。
- 内存空间严苛:移动端设备标签页通常分配不到 500MB 可用内存,稍有堆叠直接白屏崩溃。
- 无原生文件系统绝对路径:不能随意像 Node.js 那样调用
fs.createWriteStream写入系统任意目录。
针对浏览器环境,成熟的架构是:Web Worker 独立线程 + 流式解压库(如 fflate) + 现代存储 API(OPFS 或 File System Access API)。
关键实现细节:
- 零拷贝传输(Transferable Objects):主线程与 Web Worker 之间传递数据切片时,使用
postMessage(chunk, [chunk.buffer])移交底层ArrayBuffer的所有权,避免在线程通信中再做一份内存复制。 - 流式落盘(OPFS):利用浏览器私有文件系统(Origin Private File System),通过
createWritable()创建流式写入器。数据解压出一块,就立刻写入磁盘扇区,内存中的ArrayBuffer随即置空并触发 GC。
// 浏览器前端:主线程调用代码示例
async function decompressLargeFileInBrowser(file) {
  // 1. 在本地私有文件系统 (OPFS) 中准备解压目标目录
  const root = await navigator.storage.getDirectory();
  const outDir = await root.getDirectoryHandle("unpacked_output", { create: true });

  // 2. 创建解压 Worker 线程
  const worker = new Worker(new URL("./decompress-worker.js", import.meta.url), { type: "module" });

  // 3. 获取输入文件的 ReadableStream
  const fileStream = file.stream();
  const reader = fileStream.getReader();

  // 4. 分块推送到 Worker 进行解压,维持读写背压
  while (true) {
    const { done, value } = await reader.read();
    if (done) {
      worker.postMessage({ type: "EOF" });
      break;
    }
    // 使用 Transferable 零拷贝移交 ArrayBuffer
    worker.postMessage({ type: "CHUNK", chunk: value }, [value.buffer]);
  }
}
四、生产级高可用防线:Zip 炸弹防御与资源泄露排查
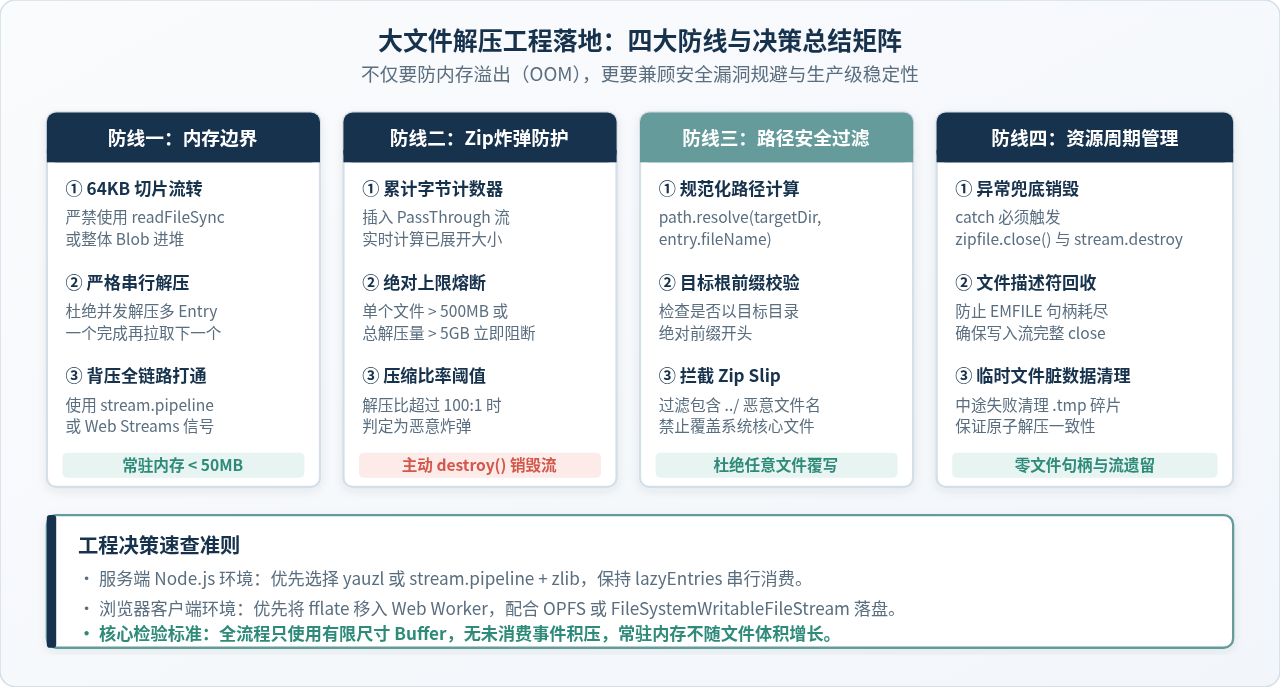
在大文件解压的生产实践中,除了代码写法的内存控制,还必须建立严密的安全防御边界。解压外部上传的文件时,最致命的两类风险是“Zip 炸弹”与“文件句柄泄露”。
1. Zip 炸弹(Decompression Bomb)防御
Zip 炸弹是指利用 DEFLATE 算法的极端压缩特性,制作出的超高压缩比恶意文件。例如著名的 42.zip,压缩包体积仅 42KB,一旦在服务端展开,解压数据量高达 4.5PB。如果代码没有设定解压体积熔断机制,即使使用流式写入,也会在短时间内耗尽服务器的全部磁盘空间,导致系统崩溃。
防御方法:在 stream.pipeline 中嵌入自定义计数器流(PassThrough 流),实时统计单个文件和全包解压后的累计字节数:
- 绝对尺寸阈值:设置单个解压文件最大不超过 500MB,全包累计解压体积不超过 5GB。
- 压缩比率阈值:如果累计解压字节数与压缩包体积的比例超过
100:1,立即判定为恶意炸弹。 - 熔断动作:一旦越界,立即调用
readStream.destroy()和zipfile.close(),中断解压流程,并物理删除已写入的临时碎片。
2. 异常时的流销毁与文件句柄回收
当解压中断(例如客户端断开连接或磁盘满载报错)时,未正确关闭的流会导致底层操作系统文件描述符(FD)一直处于打开状态。如果长时间运行,将出现 EMFILE: too many open files 故障。务必遵循以下规则:
- 优先使用
stream.pipeline代替传统的readable.pipe(writable)。传统pipe在下游出错时不会主动销毁上游流,而pipeline会在任何环节抛错时自动调用所有参与流的destroy()。 - 在
try...catch或reject最终出口中,显式执行zipfile.close()。 - 对于写入未完成的文件,先通过临时后缀命名(如
filename.ext.tmp),解压并关闭完成后再rename为正式文件;一旦中途异常,立即捕获清理.tmp文件。
五、技术选型与最佳实践对照表
针对不同规模的文件和不同的运行环境,推荐采用以下经过生产检验的方案矩阵:
| 运行环境 | 解压目标格式 | 推荐工具库 / API | 内存占用基线 | 核心注意事项 |
|---|---|---|---|---|
| Node.js 服务端 | .zip 大文件 (> 1GB) | yauzl (lazyEntries: true) |
< 40MB 恒定 | 必须串行消费 Entry;使用 stream.pipeline 衔接落盘 |
| Node.js 服务端 | .tar.gz / .tgz | zlib.createGunzip + tar-stream |
< 30MB 恒定 | 流式管道直连;配合 tar-stream 的 entry 消费回调控制节奏 |
| 现代浏览器 | .zip 大文件 | fflate + Web Worker |
< 50MB 恒定 | 必须移入 Worker 线程;使用 Transferable 零拷贝传递数据块 |
| 现代浏览器 | .gz / deflate | 原生 DecompressionStream |
< 20MB 恒定 | 结合 OPFS (FileSystemWritableFileStream) 分块持久化 |
防内存溢出落地 Checklist
- 拒绝全量 Buffer 读入:检查代码中是否已彻底移除
readFileSync、FileReader.readAsArrayBuffer等阻塞式全量读取方法。 - 严格串行解压:确认 ZIP 内部所有 Entry 为排队顺序提取,未并发触发多个写入流。
- 背压通路完好:确认数据从解压器到磁盘流完全处于
pipeline或背压事件控制下,下游未消费完毕前上游必须能够暂停供流。 - 规避 Zip Slip:每个 Entry 写入前,通过
path.resolve验证路径是否依然落在目标根目录内。 - 装配 Zip 炸弹安全熔断:解压通道内置字节累加计数器,达到预设上限(如 5GB)立刻销毁流并清理现场。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章