
深入讲解在Node.js环境下如何高效格式化并输出大型JSON文件,剖析V8内存限制与堆溢出成因,提供基于Stream管道、自定义转换流与成熟工程库的流式解决方案,兼顾内存恒定与高吞吐I/O。

当前位置:首页 > Node.js 性能优化 > 正文
Node.js环境下怎么高效格式化并输出大型JSON文件
作者:听澜
时间:2026-11-03
浏览:360
文章目录
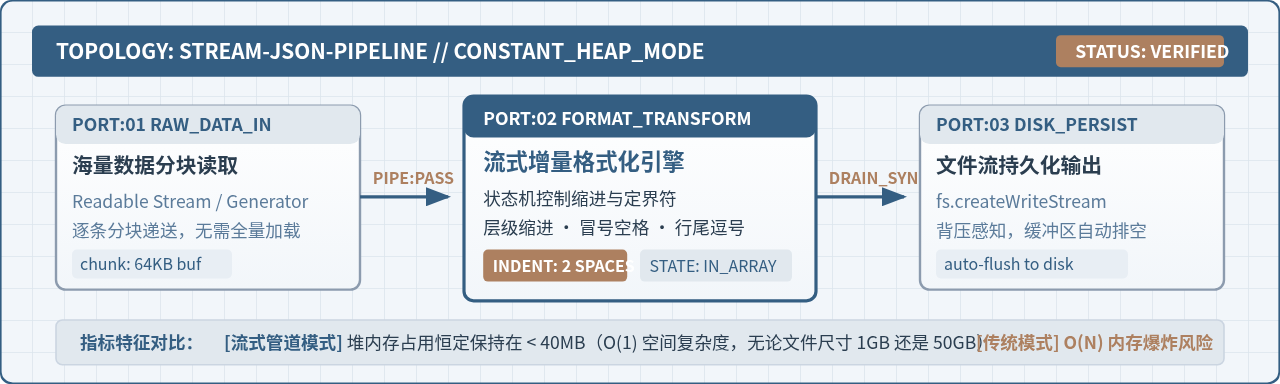
在 Node.js 环境下处理大型 JSON 文件的格式化输出时,最核心的解决路径是杜绝全量内存序列化,全面转向“流式分块(Streaming)转换与背压写入管道”。通过将数据源解耦为逐条产生的对象流,利用自定义 Transform 转换流在单项序列化的同时插入缩进与定界符,最后借助
stream.pipeline 管道交由文件写入流持久化,可以将整机的堆内存占用牢牢锁定在固定且极低的几十兆字节内,彻底根除 V8 堆溢出(OOM)与超长字符串异常。
一、内存瓶颈:常规格式化写法的失效原因深度拆解
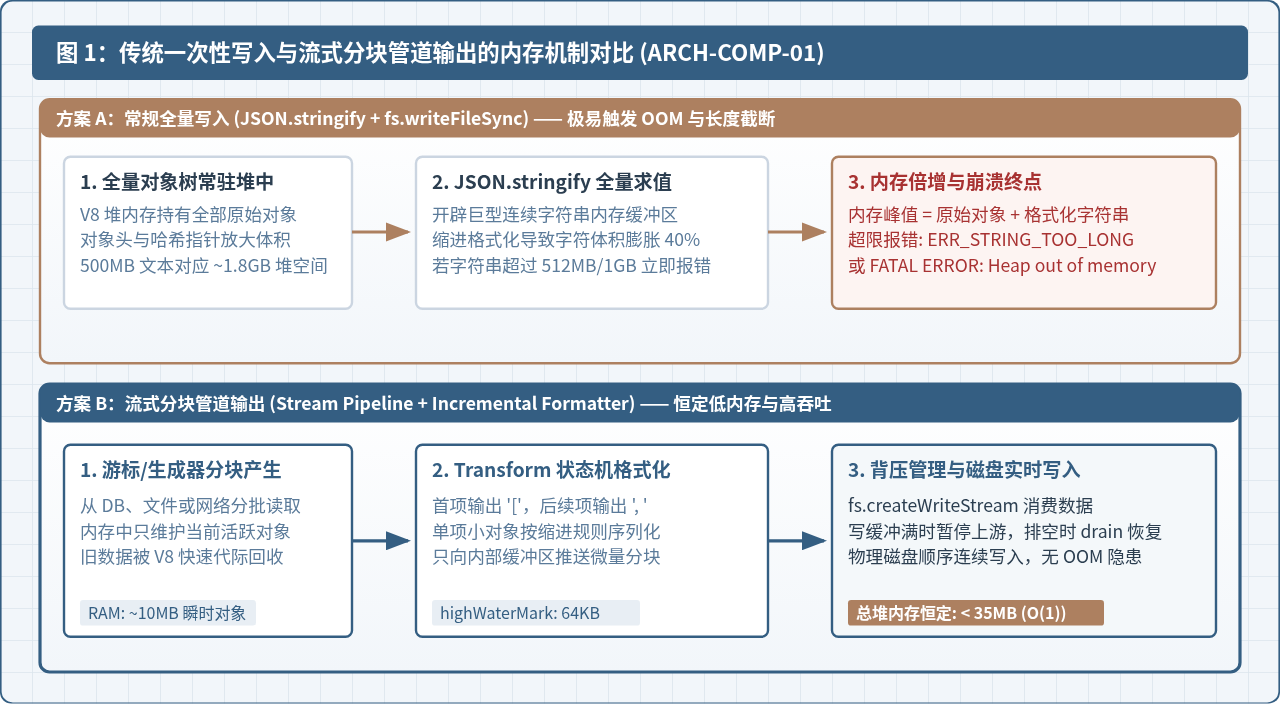
在常规的脚本开发中,最普遍的 JSON 格式化操作是调用 JSON.stringify(data, null, 2) 并使用 fs.writeFileSync('output.json', jsonStr) 一次性写入磁盘。这种写法在数据量小于数十兆字节时非常简洁高效,因为 V8 引擎针对轻量数据的原生 C++ 序列化实现拥有极高的执行速率。
然而,一旦数据规模扩展至数百兆字节甚至数吉字节(GB),常规写法必然在运行时遭遇崩溃。崩溃的根本诱因并非磁盘 I/O 吞吐不足,而是 Node.js 底层 V8 运行时的两道硬性限制:
-
V8 堆内存天花板与内存倍增效应: Node.js 默认的 V8 堆内存限制在 64 位系统下通常为 1.4GB 至 4GB。当我们在内存中维护一个 500MB 的复杂 JavaScript 对象树时,由于对象头、哈希散列指针以及原型链的额外开销,该对象树在堆中占用的实际物理内存往往会膨胀至 1.5GB 到 2GB。此时调用
JSON.stringify,V8 需要在堆中分配一块全新的、连续的内存空间来拼装格式化后的字符串。对象树与产出的格式化字符串同时共存,导致内存瞬时倍增,直接触发FATAL ERROR: Ineffective mark-compacts near heap limit Allocation failed - JavaScript heap out of memory。 -
V8 字符串最大字符长度截断: 在 V8 引擎内部,单条字符串对象的最大长度受到编译常量
kMaxLength的物理约束(在不同 Node.js 版本中通常限制在 512MB 到 1GB 字符)。当对海量数据进行格式化(包含大量换行符与空格缩进)时,字符串尺寸极易突破这一上限,运行时将直接抛出不可恢复的RangeError: Invalid string length致命错误。
二、流式排版:状态机转换与背压管道的核心架构
要绕开上述限制,唯一可靠的工程方案是“化整为零”——建立基于流(Stream)的连续变换管道。流式方案的核心思想是将海量数据视为按时间连续流淌的片段(Chunks),在任意时间点,内存中仅保留当前正在处理的单一数据对象和极小的排版缓冲区。
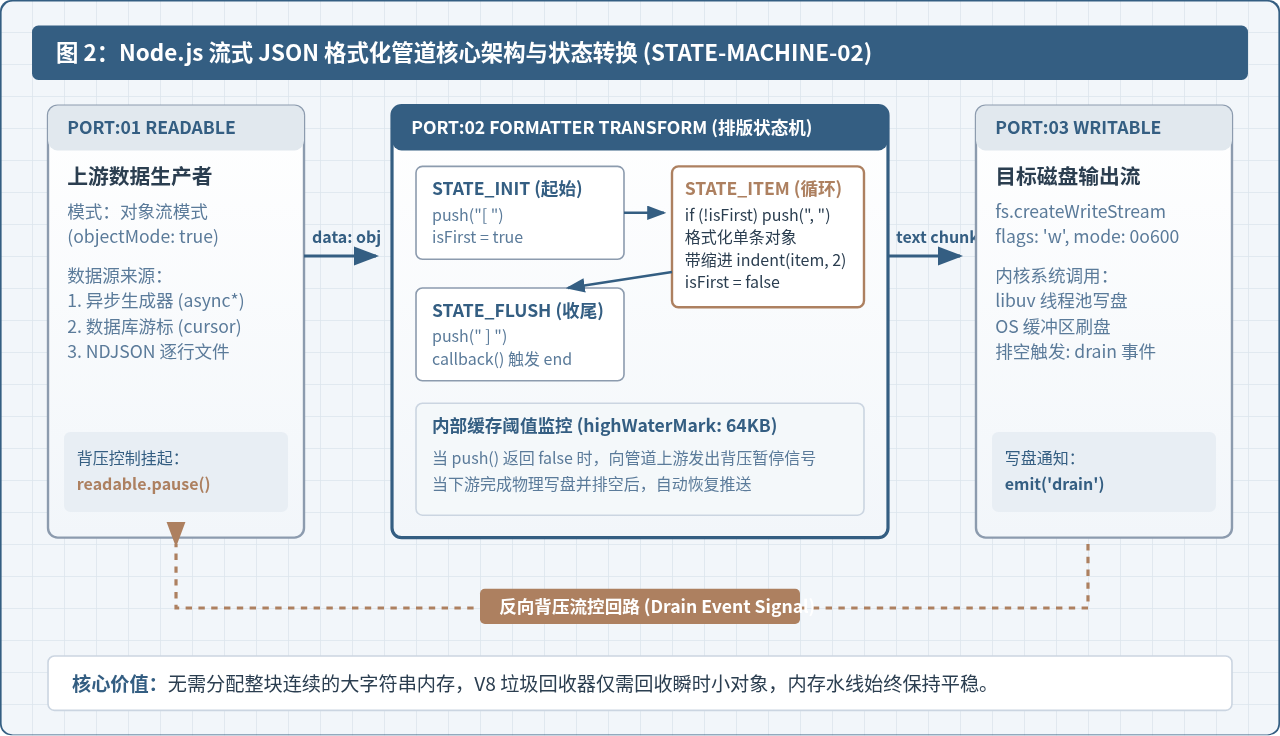
流式格式化管道由三个紧密协作的阶段构成:
- 数据生产者(Readable Stream): 以可迭代流的方式逐条产生数据对象。数据源可以来自数据库游标(如 MongoDB Cursor、PostgreSQL Stream)、NDJSON 逐行文件,或是 Node.js 原生的异步生成器(Async Generator)。
-
排版状态机(Transform Stream): 格式化不仅要求输出 JSON 键值,还需要规范缩进(例如两个空格)与数组括号。转换流内部维护一个轻量的排版状态机:在接收到第一个数据项前输出起始符号
[;处理中间数据项时,仅对当前项执行独立的轻量JSON.stringify(item, null, 2),添加层级偏移缩进,并在项与项之间补全逗号,;在数据流触发结束(Flush)钩子时,统一输出收尾闭合符号]。 -
背压流控与持久化(Writable Stream): 目标文件流接收格式化文本。由于磁盘 I/O 速率往往低于内存转换速率,当写入缓冲区堆积到设定阈值(
highWaterMark)时,目标流的write()方法将返回false。此时管道机制会自动暂停上游读取,待磁盘完成物理写盘并触发drain事件后,再恢复上游供数。
三、动手实操:构建基于 Stream 的大文件格式化输出程序
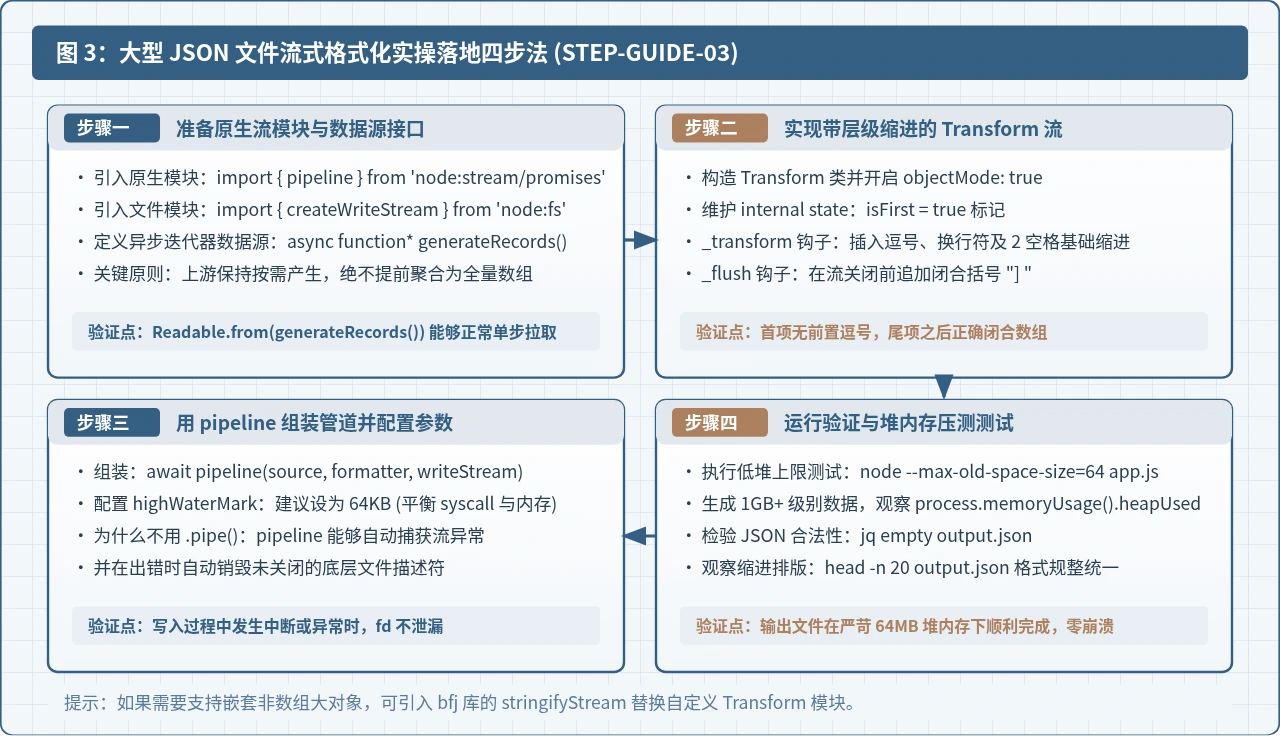
下面提供一个完全基于 Node.js 原生 API 的生产级实现。该方案不需要安装任何第三方外部依赖,通过继承 stream.Transform 实现了通用的数组对象流式排版器,并通过 node:stream/promises 中的 pipeline 自动调度背压与错误销毁。
1. 完整工程实现代码
import { Transform, Readable } from 'node:stream';
import { pipeline } from 'node:stream/promises';
import { createWriteStream } from 'node:fs';

/**
 * 专用于将对象流格式化为漂亮缩进 JSON 数组的转换流
 */
class JsonArrayFormatTransform extends Transform {
  constructor(options = {}) {
    super({
      ...options,
      writableObjectMode: true, // 接收上游的对象数据
      readableObjectMode: false // 向下游输出字符串/Buffer
    });
    this.isFirstItem = true;
    this.indent = options.indent || '  ';
  }

  _transform(chunk, encoding, callback) {
    try {
      let output = '';

      // 首条数据推送前,先输出数组起始符 '['
      if (this.isFirstItem) {
        output += '[
';
        this.isFirstItem = false;
      } else {
        output += ',
';
      }

      // 将单个独立对象格式化为缩进文本
      const itemStr = JSON.stringify(chunk, null, this.indent);

      // 为该项内部的每一行追加外层基础缩进,保证整体层级对齐
      const indentedItem = itemStr
        .split('\n')
        .map(line => this.indent + line)
        .join('\n');

      output += indentedItem;
      this.push(output);
      callback();
    } catch (err) {
      callback(err);
    }
  }

  _flush(callback) {
    // 上游数据全部读完后,闭合数组符号
    if (this.isFirstItem) {
      // 如果没有任何数据写入,输出合法的空数组 '[]\n'
      this.push('[]\n');
    } else {
      this.push('\n]\n');
    }
    callback();
  }
}

/**
 * 模拟海量数据生产源(异步生成器)
 * @param {number} count 生产的记录总条数
 */
async function* recordGenerator(count) {
  for (let i = 1; i <= count; i++) {
    yield {
      id: i,
      uuid: `rec_${i.toString().padStart(8, '0')}`,
      timestamp: Date.now(),
      status: i % 2 === 0 ? 'ACTIVE' : 'PENDING',
      metrics: {
        cpu_usage: Number((Math.random() * 100).toFixed(2)),
        mem_rss: 1024 * 1024 * 32 + (i * 10),
        tags: ['streaming', 'node_fs', 'json_pipe']
      }
    };
  }
}

/**
 * 导出主调度函数
 */
async function exportLargeFormattedJson(targetFilePath, totalRecords = 100000) {
  console.log(`[START] 开始流式格式化写入 ${totalRecords} 条数据到 ${targetFilePath}...`);
  const startTime = performance.now();

  // 1. 创建上游读取流
  const sourceStream = Readable.from(recordGenerator(totalRecords));

  // 2. 实例化格式化转换流
  const formatter = new JsonArrayFormatTransform({
    indent: '  ',
    highWaterMark: 64 * 1024 // 64KB 缓冲区
  });

  // 3. 创建目标文件写入流
  const destinationStream = createWriteStream(targetFilePath, {
    flags: 'w',
    mode: 0o600, // 符合文件权限安全规范
    highWaterMark: 64 * 1024
  });

  // 4. 组装背压管道并执行
  try {
    await pipeline(sourceStream, formatter, destinationStream);
    const durationSec = ((performance.now() - startTime) / 1000).toFixed(2);
    const memUsage = (process.memoryUsage().heapUsed / 1024 / 1024).toFixed(2);
    console.log(`[SUCCESS] 写入完成!总耗时: ${durationSec} 秒,当前堆占用: ${memUsage} MB`);
  } catch (err) {
    console.error('[ERROR] 管道处理过程发生异常:', err);
    throw err;
  }
}

// 执行测试
exportLargeFormattedJson('./large_formatted_output.json', 100000);
2. 运行步骤与结果检验
为了客观验证流式输出在严苛内存限制下的稳定性,我们可以在执行命令时加入 V8 内存限制参数,观察其实际表现:
-
执行测试:
运行命令
node --max-old-space-size=64 app.mjs。该参数强制将 V8 堆内存上限压缩到仅 64MB。 -
输出检验:
程序在 64MB 极限内存环境下稳定生成了包含 100,000 条深层对象的格式化文件,产出文件大小约 35MB(若生成 1,000,000 条则达到 350MB+),运行时
heapUsed指标自始至终稳定在 25MB 至 35MB 之间,无任何抖动式内存攀升。 -
格式合法性校验:
在终端中执行
head -n 25 large_formatted_output.json查看头部缩进结构,确认首项缩进严格对齐;执行tail -n 10 large_formatted_output.json确认数组闭合;最后使用jq empty large_formatted_output.json验证语法,无报错退出证明格式完全合规。
四、性能调优、核心参数与常见陷阱排查
在生产级高吞吐场景中,仅仅“能跑通”并不足够,还需要针对系统调用开销与数据拓扑特性进行针对性调优:
1. highWaterMark 缓冲区的权衡策略
Node.js 文件流默认的 highWaterMark 为 64KB(对象流则默认为 16 个对象)。
如果将字节缓冲设得过小(例如 1KB),流管道会频繁触发 write 返回 false 与 drain 事件,导致 CPU 上下文切换频繁、底层 libuv 系统调用(syscall)开销陡增,降低写入吞吐量;
反之,若盲目将缓冲区增大到 64MB 以上,虽然减少了系统调用,但会占用过多未落盘的内存缓冲。在常规服务器与容器部署环境中,推荐将 highWaterMark 设置为 64KB 到 256KB,这一区间通常能完美契合操作系统文件系统块(Block Size)与磁盘写入缓存。
2. 避免使用 stream.pipe(),统一采用 stream.pipeline
老旧代码中常使用 source.pipe(formatter).pipe(dest)。这种传统写法存在严重的设计缺陷:当下游目标文件发生磁盘空间已满(ENOSPC)或写入权限异常时,pipe() 不会自动清理上游流的事件监听,导致已打开的文件描述符(File Descriptor)发生泄漏。
现代 Node.js 必须统一采用 node:stream/promises 提供的 pipeline,它能保证在管道任何环节出错时,立刻销毁所有关联的流句柄并释放物理资源。
3. 复杂任意拓扑大对象的处理:选用 bfj 库
上述自定义 Transform 流主要面向“顶层为数组/集合”的流式数据,这覆盖了绝大多数数据库导出、日志收集和批量账单场景。
但如果需要格式化的是一个单体巨大且深层嵌套的单一对象(例如复杂的知识图谱 AST),手动编写状态机拆解将非常繁琐。此时可引入工业级成熟库 bfj (Big-Friendly JSON)。
import bfj from 'bfj';
import { createWriteStream } from 'node:fs';

const destinationStream = createWriteStream('./giant_nested_object.json', { mode: 0o600 });

// bfj.stringifyStream 利用微任务切片分步遍历巨大对象,边遍历边向流输出
const stream = bfj.stringifyStream(giantDataStructure, {
  space: 2 // 格式化两格缩进
});

stream.pipe(destinationStream);
stream.on('end', () => console.log('深层嵌套对象格式化输出完成'));
bfj 的核心价值在于它在遍历复杂 JavaScript 数据结构时,将遍历过程拆解到事件循环的多个 tick 中,既不一次性耗尽内存,也不会阻塞主线程的 I/O 处理。
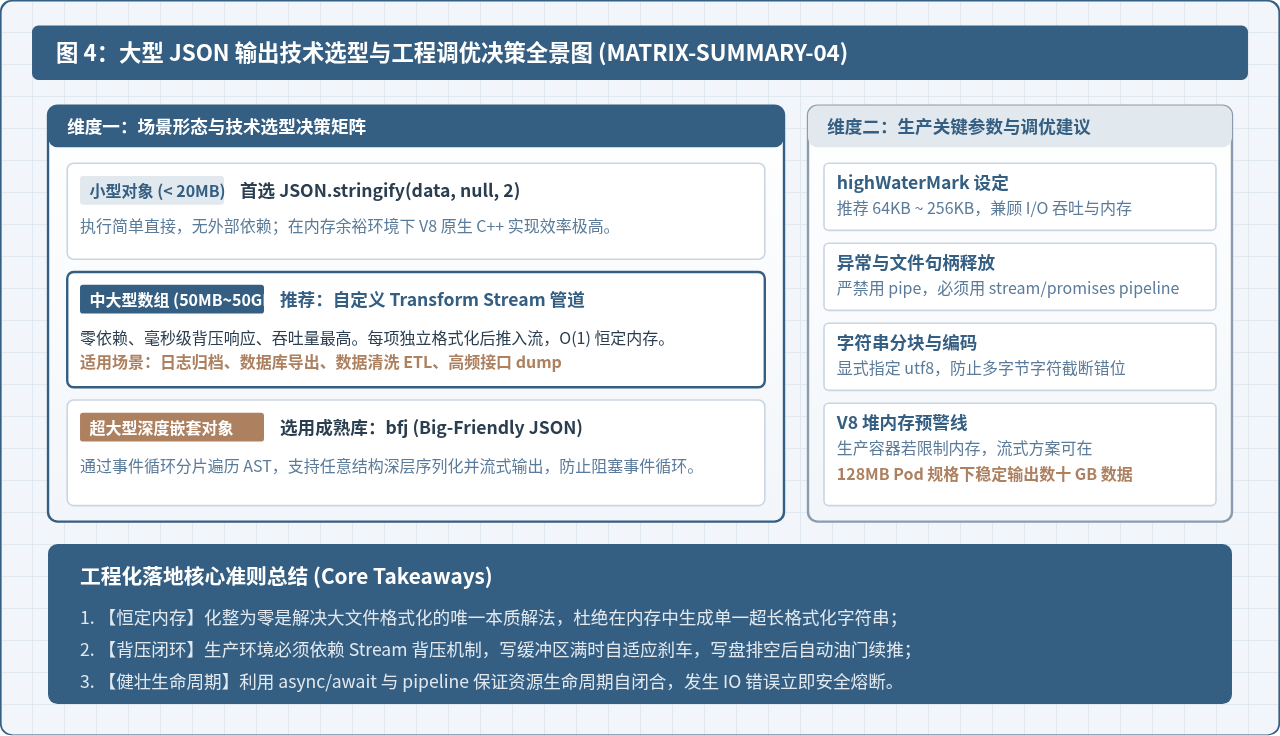
五、选型总结与工程决策指南
高效格式化与输出大型 JSON 文件并非单纯依赖提高硬件内存配置,而是一场典型的以“时间换空间”和“流控治过载”的架构设计。读者可根据下表针对具体业务场景快速制定方案:
| 场景与数据特征 | 典型数据规模 | 推荐实施方案 | 核心收益与注意事项 |
|---|---|---|---|
| 常规轻量对象 | < 20 MB | 原生 JSON.stringify + 文件写入 |
极速、无附加逻辑,直接利用 V8 底层优化。 |
| 批量数据、列表导出、ETL管道 | 50 MB ~ 50 GB+ | 原生 Transform Stream + pipeline |
最优选方案:零外部依赖,O(1) 恒定内存,毫秒级背压自适应流控。 |
| 巨型不规则、深层嵌套单体图谱 | 100 MB ~ 数 GB | bfj 流式序列化器 (stringifyStream) |
解耦事件循环微任务,防止单次遍历锁死事件循环或溢出堆上限。 |
| 行格式流式交换 | 任意规模 | NDJSON (每行一个独立 JSON) | 网络传输首选,省略缩进与开闭符号维护,消费端可并发解析。 |
生产落地准则:
牢记“化整为零”与“背压闭环”。当面对大容量 JSON 输出需求时,首先审视数据源能否解耦为异步迭代器或游标;只要数据源具备分批生产能力,结合 Node.js 原生 Transform 流即可在任意极小规格的容器环境内,平稳高效地输出标准格式化的大型 JSON 文件。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章