
深入对比JavaScript生态中xlsx(SheetJS)与exceljs两个主流Excel库在读取能力、内存机制、API设计、流式解析及样式元数据处理上的核心区别与选型依据。

当前位置:首页 > Node.js 性能优化 > 正文
xlsx与exceljs库在JavaScript中读取Excel的区别
作者:极速慢跑
时间:2026-10-30
浏览:257
文章目录
在JavaScript技术栈中,xlsx(即社区广泛使用的SheetJS)与exceljs是处理Excel文件的两个标杆级开源库。两者在读取Excel文件时,虽然都能完成“将工作簿转化为程序可用数据”的目标,但在底层的抽象模型、内存占用模式、API设计哲学、流式读取支持以及对样式与元数据的保留能力上,存在着本质的设计分歧。理解这些区别,是构建高性能、低资源消耗且稳定可靠的表格解析链路的关键前提。
一、核心判断:轻量数据转换器 vs 完整文档对象模型
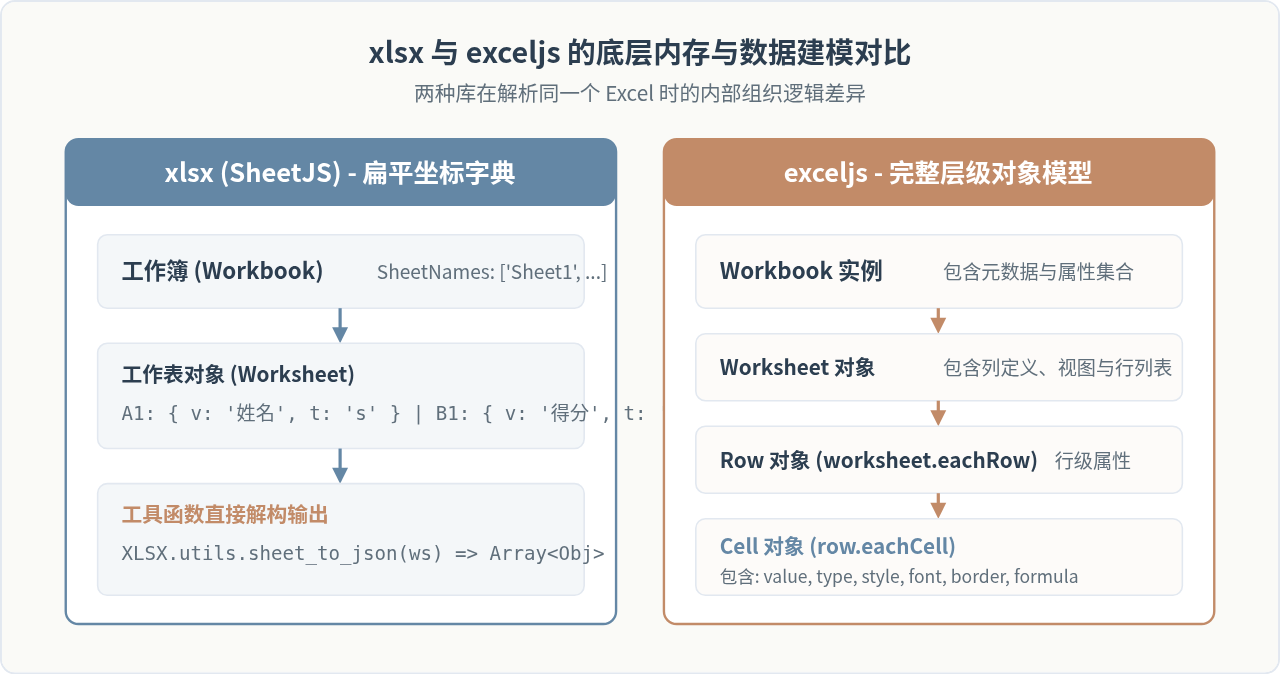
对这两个库的选型与使用,首先需要建立一个清晰的技术定位判断:xlsx的定位是“轻量级的高性能数据抽取与格式转换器”,而exceljs的定位是“对Excel对象模型(OOXML)的完整面向对象映射与流式文档引擎”。
这一设计出发点的差异直接决定了它们的数据组织形式。当读取一个 .xlsx 文件时:
- xlsx库倾向于将整张表格解构为一个扁平的坐标字典。它将单元格按
A1、B2这样的直接地址映射在内存中,工作簿对象仅仅是工作表字典与引用范围的集合。读取完成后,开发者通常调用其内置的工具函数(如sheet_to_json)迅速将其转换为一维对象数组。 - exceljs库则完整还原了Excel的标准层级结构:
Workbook -> Worksheet -> Row -> Cell。每一个对象都拥有独立的属性与方法体系,单元格不仅包含显式值,还内嵌了类型、样式定义、公式原文、计算缓存值、数据有效性及富文本切片。
二、API调用与读取操作流程的差异
由于抽象层级不同,两者的常规读取代码展现出完全不同的风格。我们通过标准的“读取本地文件并打印首张工作表数据”场景来观察操作流程的区别。
1. xlsx的标准读取方式
xlsx 的调用以同步静态函数为主(支持传入文件路径或 Buffer),代码极其紧凑,通常 4 至 5 行即可完成从文件到结构化 JSON 对象的提取:
// 运行环境: Node.js (需要通过 npm install xlsx 安装)
const XLSX = require('xlsx');

// 1. 同步读取文件整本加载至内存
const workbook = XLSX.readFile('user_data.xlsx');

// 2. 获取第一张工作表名称及其工作表对象
const firstSheetName = workbook.SheetNames[0];
const worksheet = workbook.Sheets[firstSheetName];

// 3. 将工作表直接转换为以首行为键的 JavaScript 对象数组
const records = XLSX.utils.sheet_to_json(worksheet);

console.log('读取记录总数:', records.length);
console.log('首条记录内容:', records[0]);
2. exceljs的标准读取方式
exceljs 严格遵循现代 JavaScript 的异步 Promise/async-await 规范,需要先初始化工作簿实例,然后通过文件读取器加载,再通过面向对象的迭代器逐层访问:
// 运行环境: Node.js (需要通过 npm install exceljs 安装)
const ExcelJS = require('exceljs');

async function readExcelFile() {
  // 1. 实例化工作簿
  const workbook = new ExcelJS.Workbook();

  // 2. 异步加载并解析文件
  await workbook.xlsx.readFile('user_data.xlsx');

  // 3. 按名称或索引(从1开始)获取指定工作表
  const worksheet = workbook.getWorksheet(1);

  const records = [];

  // 4. 遍历所有非空行进行数据提取
  worksheet.eachRow({ includeEmpty: false }, (row, rowNumber) => {
    // 忽略表头首行
    if (rowNumber === 1) return;

    // row.values 返回该行单元格的值数组(索引 1 对应 A 列)
    records.push({
      id: row.getCell(1).value,
      name: row.getCell(2).value,
      score: row.getCell(3).value
    });
  });

  console.log('读取记录总数:', records.length);
}

readExcelFile();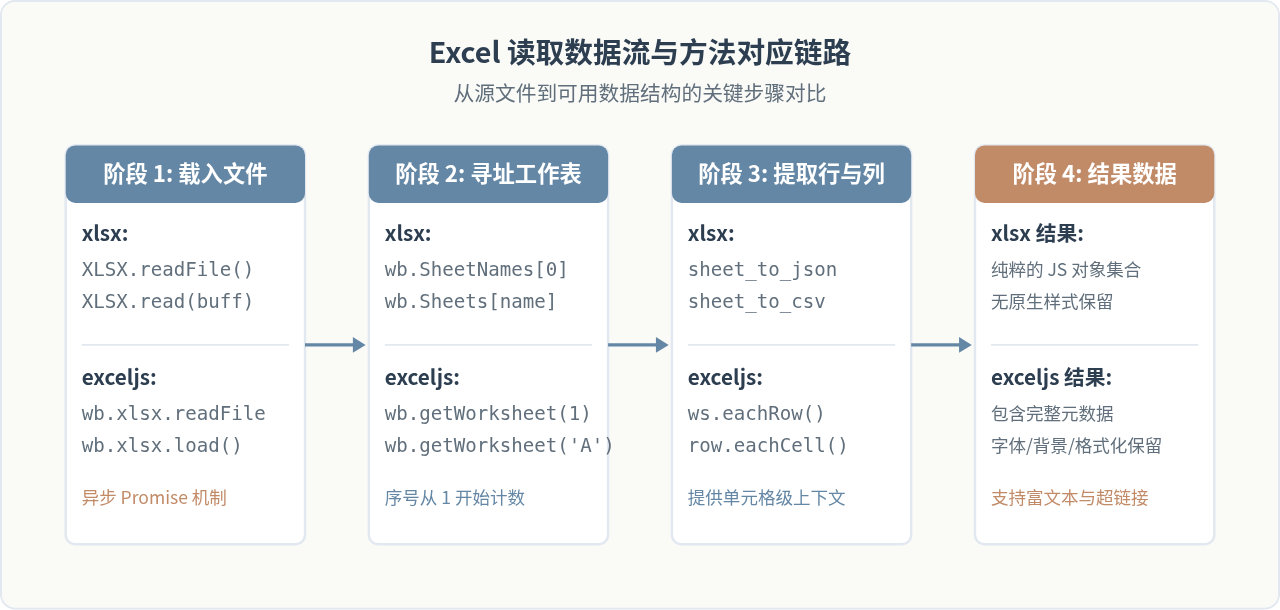
三、大文件读取与内存机制深度对比
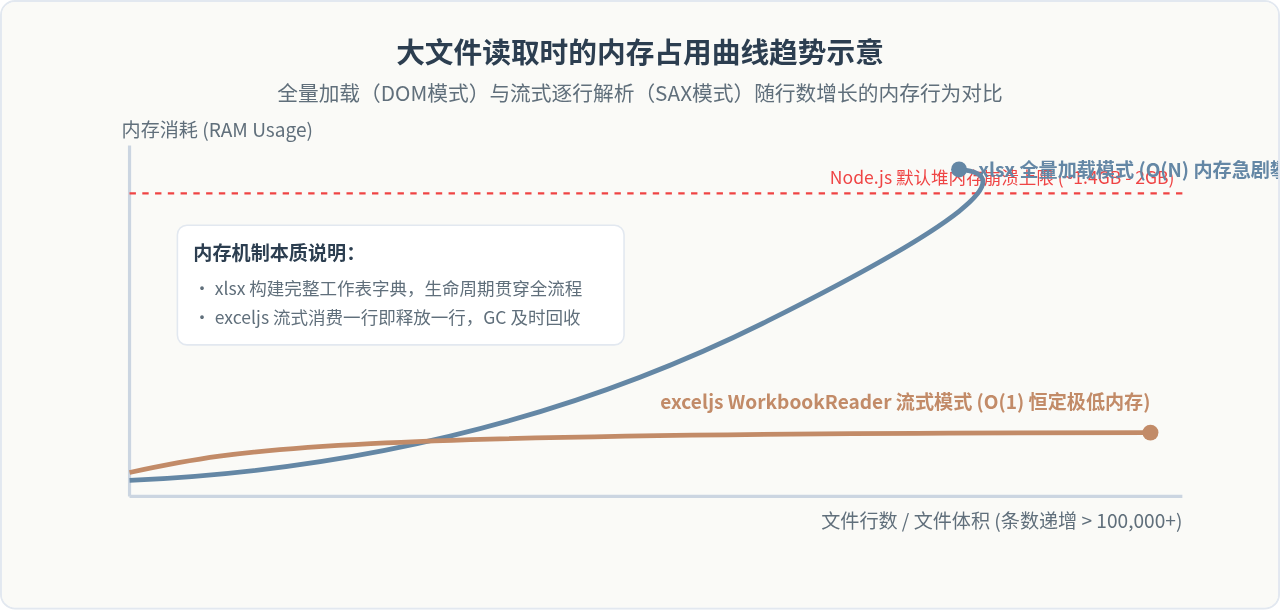
当处理 50MB 以上或数十万行的庞大 Excel 文件时,两个库的表现会出现根本性的分水岭。这源于两者底层针对 XML 解压与数据解析的机制差异。
1. xlsx的内存限制与行为特征
社区开源版本的 xlsx 主要依赖一次性全量加载解析:
- 整个
.xlsx文件(本质是打包的 XML 集合)在解压后,所有工作表内容、共享字符串表(sharedStrings)都会被一次性解析并全部常驻在 V8 引擎堆内存中。 - 即使只需要读取前10行,库也必须将整个文件解压并构建完成。
- 在处理几十万行的数据时,内存峰值常会迅速攀升至数吉字节,极易触发 Node.js 的
FATAL ERROR: Ineffective mark-compacts near heap limit Allocation failed - JavaScript heap out of memory崩溃。
2. exceljs的流式读取器(WorkbookReader)
与全量载入不同,exceljs 专门提供了原生流式解析模块 ExcelJS.stream.xlsx.WorkbookReader。它基于 SAX 事件驱动模型,边从磁盘读取字节流,边逐步发射行事件,处理完后立即允许垃圾回收机制回收上一行对象,从而将内存占用稳定在极低水平:
const ExcelJS = require('exceljs');

async function streamLargeExcel(filePath) {
  // 配置流式解析选项,可主动关闭样式与超链接以进一步榨干性能
  const options = {
    sharedStrings: 'cache', // 缓存共享字符串
    hyperlinks: 'ignore',    // 忽略超链接
    styles: 'ignore'         // 忽略样式,大幅降低内存与 CPU 开销
  };

  const workbookReader = new ExcelJS.stream.xlsx.WorkbookReader(filePath, options);

  let totalRowCount = 0;

  // 使用异步迭代器逐个读取工作表与行
  for await (const worksheetReader of workbookReader) {
    for await (const row of worksheetReader) {
      totalRowCount++;
      // row.values 仅代表当前行数据,处理完毕后即可被 GC 回收
      const rowData = row.values;
      if (totalRowCount % 50000 === 0) {
        console.log(`已流式处理 ${totalRowCount} 行数据...`);
      }
    }
  }

  console.log(`流式读取完毕,共解析 ${totalRowCount} 行`);
}
四、元数据、样式与复杂格式的读取能力
如果业务不仅要求读取单元格的“字符串字面量”,还依赖于富文本、公式、单元格样式、颜色填充或超链接,两个库的差距会进一步拉大。
1. xlsx(社区版)的局限
- 样式丢失:在 npm 上公开安装的
xlsx社区开源版本移除了对单元格样式的解析支持。读取带背景色、粗体字、边框的文件时,样式元数据会被丢弃。若需要完整样式支持,官方要求升级为商业化的 Pro 版本。 - 富文本简化:当单个单元格内存在混合字体(例如前半段是黑色普通文本,后半段是红色下划线加粗文本)时,xlsx 通常只提取纯文本拼接结果,富文本的颜色和片段属性均丢失。
- 公式与缓存值:xlsx 可以在单元格对象中同时保留
f(公式字符串)和v(公式上次计算结果),但不会在读取时自动重算公式。
2. exceljs的完整元数据呈现
exceljs 在开源协议下完整支持对 OOXML 所有属性的透明解析:
- 样式与填充:读取后通过
cell.fill可获取前景底色、图案填充;通过cell.font可获知字体名称、大小、粗体、斜体及 RGBA/ARGB 颜色值。 - 原生富文本对象:当单元格包含富文本时,
cell.value会返回一个结构化的富文本对象(包含richText数组),数组中每一项均独立包含其切片文本与专门对应的font样式。 - 公式与结果分离:对于公式单元格,
cell.value会返回类似于{ formula: 'SUM(A1:A10)', result: 150 }的清晰结构,方便业务按需取用原始公式或已存结果。 - 数据验证与有效性:支持读取单元格配置的下拉列表、整数范围等数据有效性规则。
五、前端浏览器与Node.js服务端适用性区别
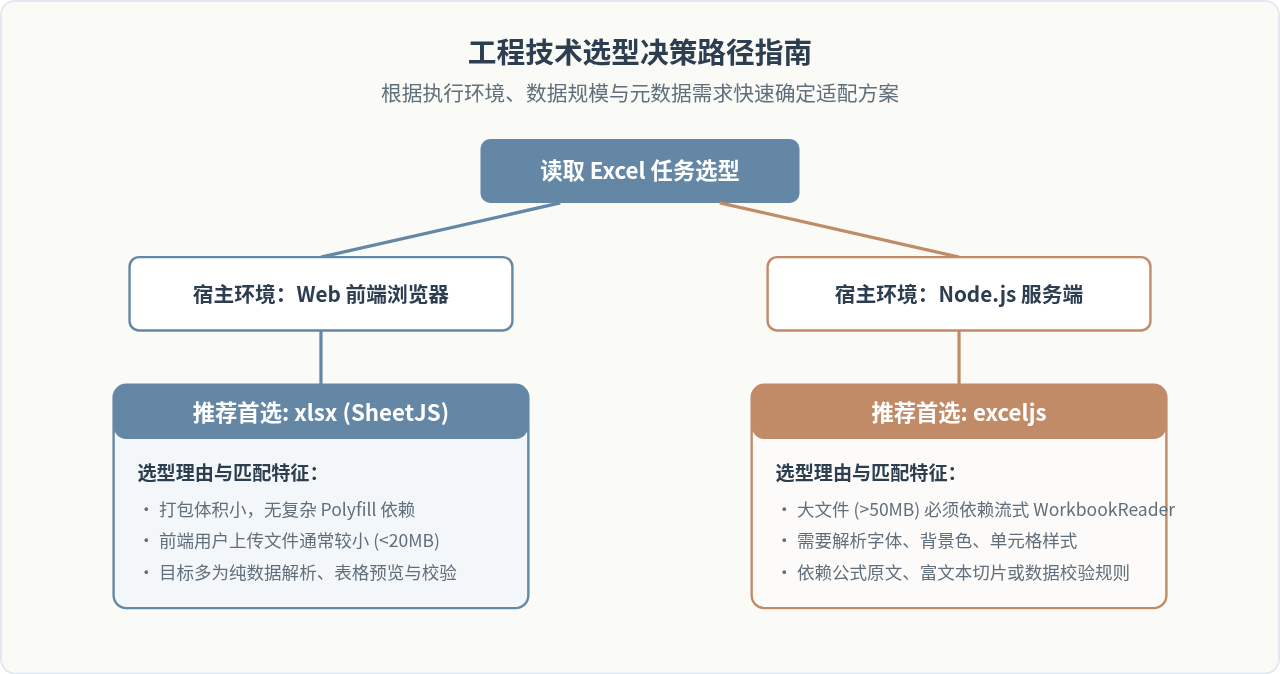
在实际工程架构中,选择哪个库还需要结合执行环境(浏览器宿主 vs Node.js 容器)来综合权衡打包体积与构建成本:
| 对比维度 | xlsx (SheetJS) | exceljs |
|---|---|---|
| 打包体积 (Bundle Size) | 轻量(Minified 压缩后约 200KB - 300KB) | 较重(完整包含依赖后约 800KB - 1MB+) |
| 浏览器端直接解析 | 极佳。直接传入 FileReader 的 ArrayBuffer 即可解析,开箱即用。 |
可用但较重。通常需配置 polyfill(如 stream、buffer 等 Node 模块垫片),且增加前端包体积。 |
| 超大文件读取 (>100MB) | 受内存限制严重,在后端容易造成 OOM 崩溃。 | 极佳。通过 WorkbookReader 流式管道平稳处理数百万行。 |
| 格式完整度与样式 | 社区版仅支持纯数据,无样式元数据。 | 极佳。支持字体、颜色、边框、公式、富文本、合并单元格等全量属性。 |
| API 学习成本 | 简单直接,调用一两个静态方法即可拿到 JSON。 | 中等,需熟悉 Workbook、Worksheet、Row、Cell 面向对象模型与流事件。 |
六、实践建议与总结
在实际开发过程中,不需要在两个库之间做二元对立的选择,而是应该结合系统的架构分层精准投放:
- 前端场景:如果是让用户在网页端上传一个几十或几百行的 Excel 模板,用于快速解析后在页面表格中预览并提交后端 API,xlsx 是压倒性的首选。它的打包体积轻量,API 几行搞定,不会给首屏加载带来沉重负担。
- 后端大数据导入:如果是 Node.js 后端定时拉取数十万行财务对账单、库存底表等大文件,必须直接选用 exceljs 的流式读取器(WorkbookReader)。使用流式管道处理不仅能杜绝服务器内存爆仓(OOM),还能让系统在处理超大任务时依然保持稳定的 CPU 与内存吞吐。
- 精细化文档处理:如果业务不仅要读数据,还要校验“单元格是否标红”、“公式是否被篡改”或读取带样式的富文本说明,exceljs 的完整对象模型是唯一能够低成本满足需求的开源选择。
避坑提醒:在 Node.js 中使用
exceljs 流式读取超大文件时,务必记得根据实际业务在 options 中声明 styles: 'ignore' 与 hyperlinks: 'ignore'。关闭不必要的元数据解析能够使解析速度提升 30% 以上,并大幅削减临时对象的分配开销。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章