

在JavaScript中处理特殊字符并安全生成JSON的实用实践指南。详细分析引号、反斜杠、控制字符、HTML敏感标记及Unicode代理对的转义机制,提供生产级安全代码与技术决策流程。
JS处理特殊字符时怎么安全生成JSON
作者:极速慢跑
时间:2026-11-05
浏览:139
文章目录
Web开发安全 · 实践规范
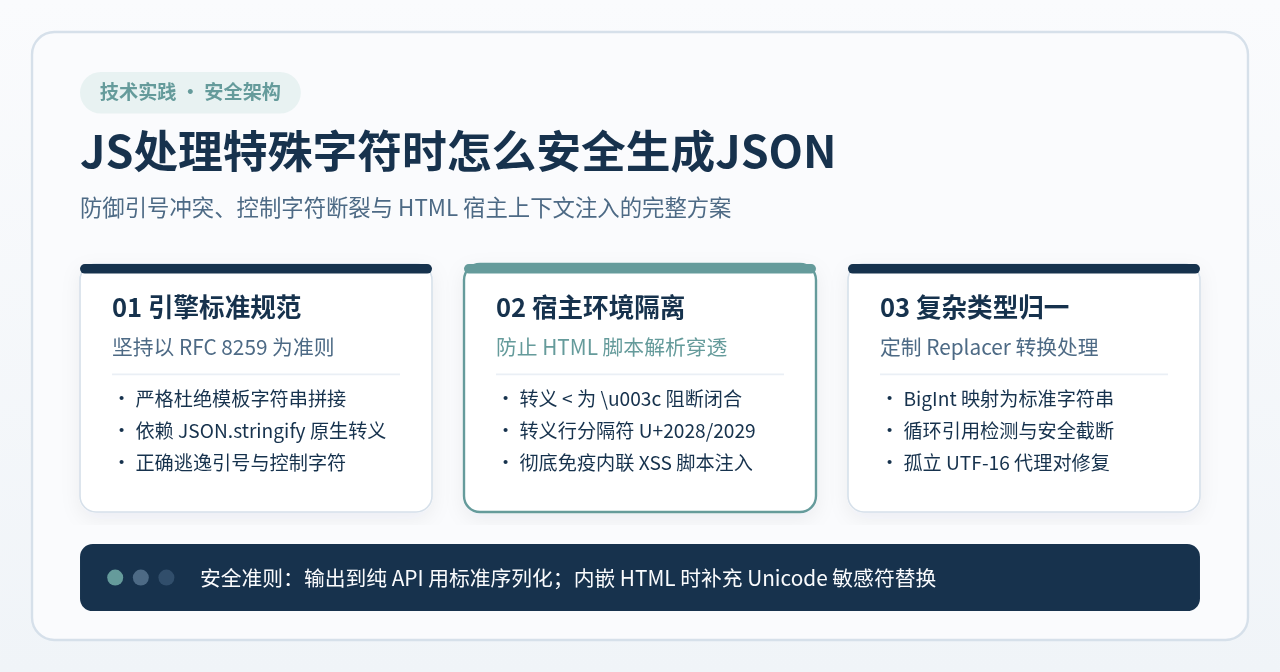
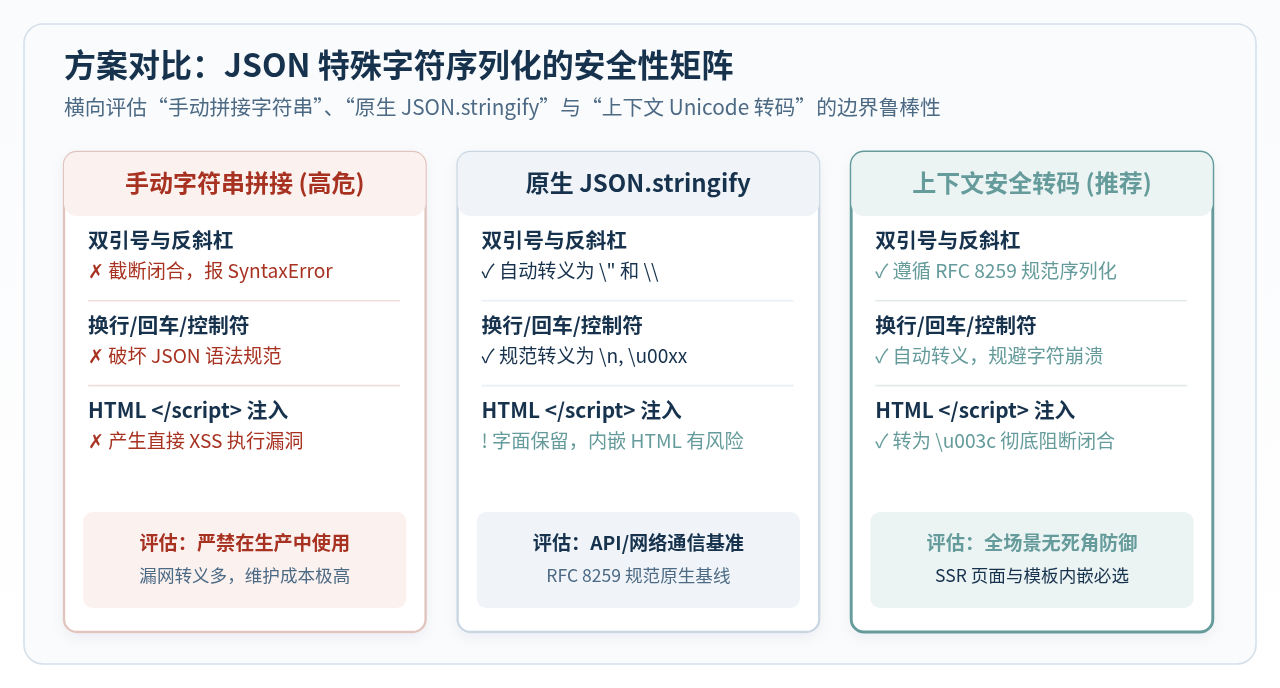
图 1:特殊字符生成 JSON 的三种技术方案对比矩阵
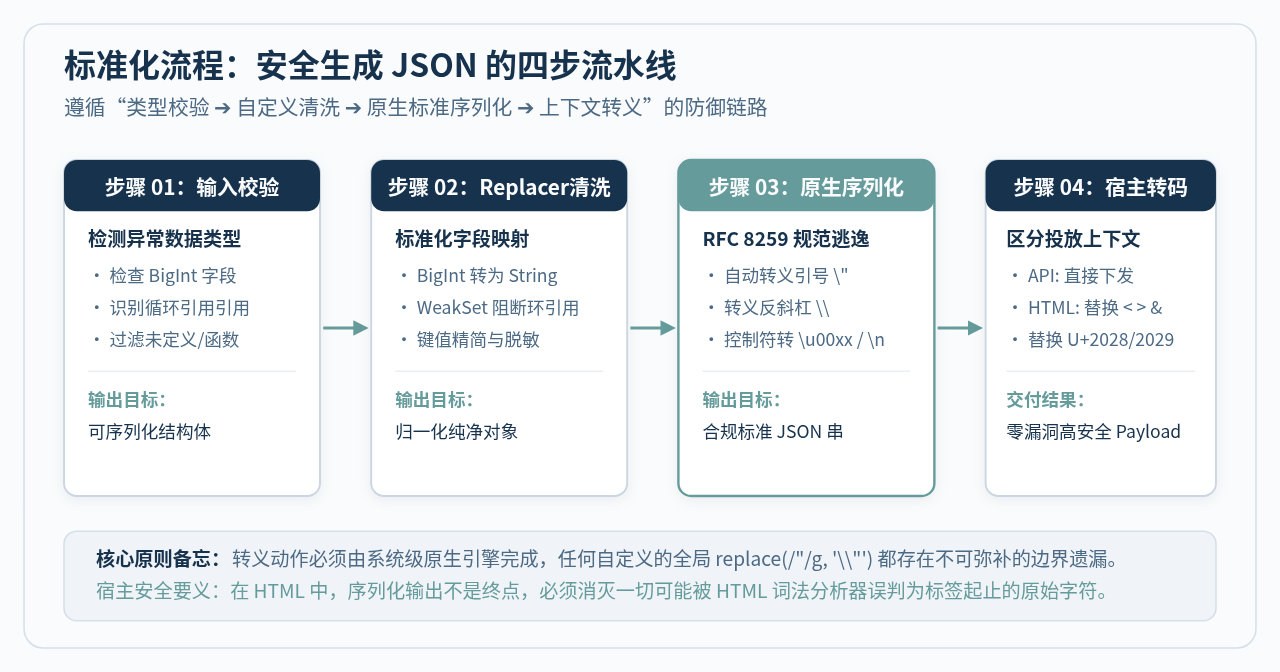
图 2:安全生成 JSON 的四步标准化流程
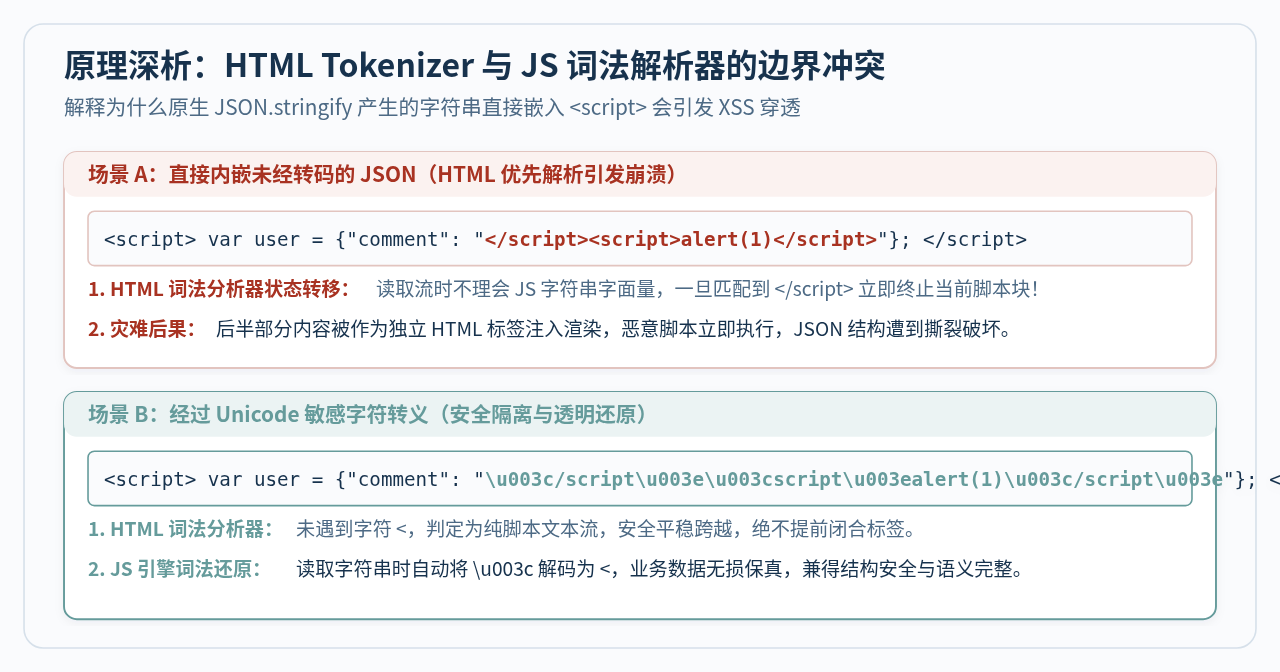
图 3:浏览器 HTML 与 JS 词法解析器冲突机制原理
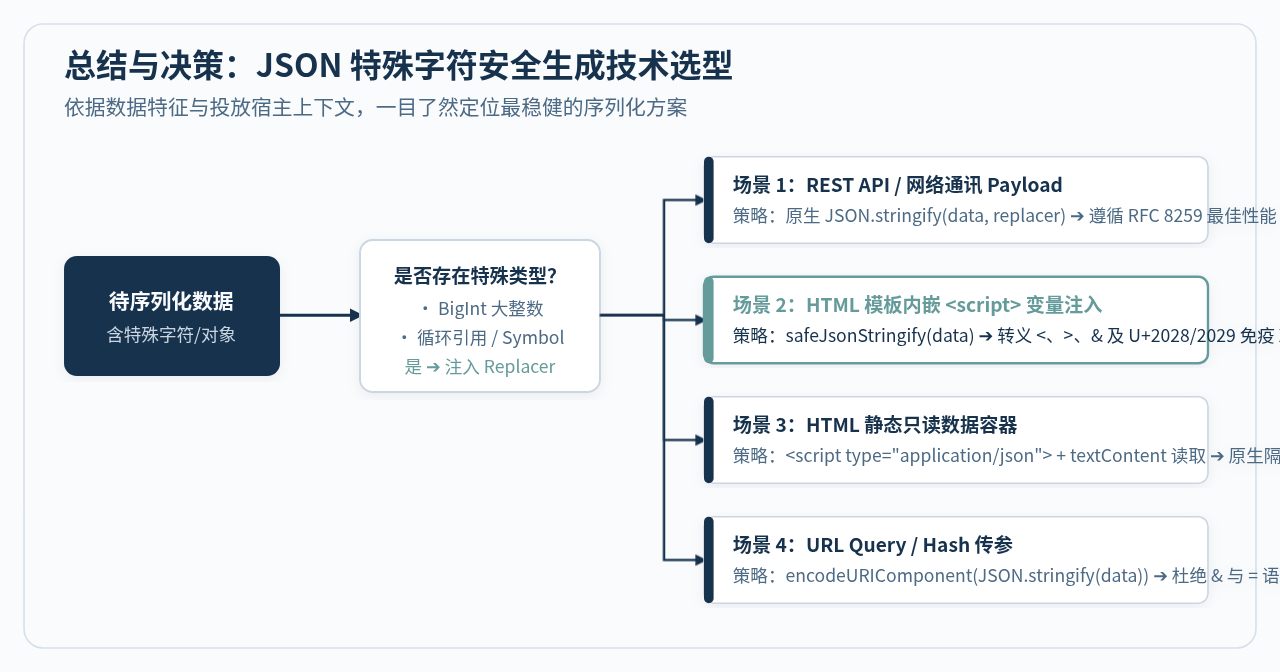
图 4:特殊字符 JSON 生成技术选型决策树
主题:特殊字符转义与安全序列化
适用标准:ECMAScript / RFC 8259
在 JavaScript 中处理包含特殊字符(如双引号、反斜杠、控制字符或 HTML 敏感标记)的数据并安全生成 JSON,核心原则只有一条:坚决杜绝手动拼接字符串,始终使用原生 JSON.stringify() 作为基础序列化引擎,并在需要嵌入 HTML 脚本环境时补充上下文安全的 Unicode 转义。绝大多数由于特殊字符导致的“JSON 解析失败”或“跨站脚本(XSS)漏洞”,根源都在于使用了模板字符串拼接或遗漏了宿主环境的特殊边界。
一、特殊字符为什么容易破坏 JSON 结构?
根据 JSON 规范(RFC 8259),JSON 文本中的字符串必须由双引号包裹,且内部特定字符必须严格转义。一旦跳过规范直接使用字符串拼接,极易引发语法崩溃或逻辑越界:
- 双引号(
")与反斜杠(\): 双引号是 JSON 字符串的边界定界符,若内容中含有未转义的双引号,解析器会将其视作字符串结束,从而产生未预期的标记并抛出SyntaxError;反斜杠作为转义引导符,若未被转义为\\,其后续字符将被当作无效的转义序列。 - ASCII 控制字符(U+0000 至 U+001F): 包括换行符(
\n)、回车符(\r)、制表符(\t)及空字节(\0)。JSON 规范明确禁止在字符串中出现字面意义上的裸控制字符,必须使用规范转义形式(如\n或\u000a)。手动拼接多行文本时经常因插入了物理换行而使 JSON 解析直接报错。 - HTML 标签阻断字符(
<、>、/): 当 JSON 数据被直接嵌入到 HTML 网页的<script>标签内时,浏览器的 HTML 词法分析器拥有更高的优先级。一旦遇到</script>标记,HTML 解析器会立即截断该脚本块,无视它是否处于 JavaScript 字符串引号之内,从而引发严重的 XSS 注入漏洞。 - 行分隔符 U+2028 与段分隔符 U+2029: 在旧版 ECMAScript 规范(ES2019 之前)中,这两个 Unicode 字符虽然是合法的 JSON 字符,但直接放在 JavaScript 源码中会被视作非法换行符,导致在用
eval或内联脚本读取时发生语法解析错误。 - 孤立代理对(Lone Surrogates): 在 UTF-16 编码下,超出基本多语言平面的字符(如 Emoji)由高位代理和低位代理对组成。如果字符串被错误截断留下孤立代理项(如单个
\uD800),老版本引擎直接序列化可能产生非法的 UTF-8 字节序列。
二、对比与选型:为什么绝对不能手动拼接?
不少开发者在处理简单对象时习惯使用模板字符串快速拼接,例如:
// 错误示范:手动拼接字符串,极度危险且脆弱
function unsafeBuildJson(username, bio) {
  return `{"name": "${username}", "bio": "${bio}"}`;
}
只要 bio 中包含一个用户输入的英文双引号(例如 Say "Hello")或者真实换行符,这段代码返回的字符串就完全无法被 JSON.parse() 解析。如果试图通过正则表达式手动替换:
// 错误示范:自制简易转义,无法覆盖边界场景
function naiveEscape(str) {
  return str.replace(/"/g, '\\"');
}
这种做法依然漏洞百出:它无法正确处理已经存在的反斜杠(导致 \\ 变成 \\\"),无法处理 \u0000 到 \u001f 的所有 ASCII 控制字符,更无法防止 HTML 标签穿透。编写符合 RFC 8259 规范的转义逻辑是一项细致且复杂的底层任务,应当完全交由 JavaScript 原生引擎中的 JSON.stringify() 完成。
三、安全生成标准 JSON 的四个关键步骤
在标准数据通信(如 RESTful API 响应、WebSocket 传输、Node.js 文件保存)场景下,安全生成 JSON 需要经过以下标准化流程:
步骤一:数据源清洗与特殊类型处理
原生 JSON.stringify() 虽然对字符串转义极其严谨,但遇到特定 JavaScript 变量类型时有特殊默认行为:
undefined、函数(Function)以及Symbol:出现在对象键值中会被直接忽略丢弃;出现在数组中会被转换为null。BigInt类型:直接序列化会直接抛出TypeError: Do not know how to serialize a BigInt。- 循环引用对象:若对象内部存在自引用或环状链表,会抛出
TypeError: Converting circular structure to JSON。
对于含有大整数或循环引用的数据,应当在序列化前引入 replacer 替换函数进行清洗归一:
// 安全清洗函数:支持 BigInt 并自动跳过循环引用
function createSafeReplacer() {
  const seen = new WeakSet();
  return function (key, value) {
    // 转换 BigInt 为字符串,避免报错并防止高精度丢失
    if (typeof value === 'bigint') {
      return value.toString();
    }
    // 过滤循环引用对象
    if (typeof value === 'object' && value !== null) {
      if (seen.has(value)) {
        return '[Circular Reference]';
      }
      seen.add(value);
    }
    return value;
  };
}
步骤二:调用原生 JSON.stringify 进行核心序列化
将清洗后的对象传入序列化引擎:
const rawData = {
    title: '产品说明书 "V2.0"\n路径:C:\\app\\data',
    controlChar: '第一行\n第二行\t制表符\u0000空字符',
    bigNumber: 9007199254740993n
};

const jsonResult = JSON.stringify(rawData, createSafeReplacer());
// 原生引擎会自动将引号转义为 \",反斜杠转为 \\,控制字符转为 \n、\t、\u0000
步骤三:确认字符集与 Unicode 格式
现代 JavaScript 运行环境(Node.js、现代浏览器)均遵循 ES2019 引入的“Well-formed JSON.stringify”规范。当遇到孤立的 UTF-16 代理对字符(如 \uD800)时,它不再输出畸形的 UTF-8 字节,而是转义为形式如 "\\ud800" 的 Unicode 转义文本,从而保证输出流始终为合法的 UTF-8 编码文本。
四、进阶场景:在 HTML/SSR 环境中防御转义穿透
很多现代前端应用(如 Next.js、Nuxt 或传统服务端模板引擎)需要将服务端准备好的数据作为全局变量注入到 HTML 页面中,例如:
<!-- 危险示范:直接在 script 标签中输出 JSON.stringify 的结果 -->
<script>
  window.__INITIAL_DATA__ = <%- JSON.stringify(userData) %>;
</script>这里存在严重的安全漏洞。即使 JSON.stringify() 已经对双引号和反斜杠做了严格转义,但如果 userData.bio 的内容是 "</script><script>alert(1)</script>",生成的 HTML 代码会变成:
<script>
  window.__INITIAL_DATA__ = {"bio":"</script><script>alert(1)</script>"};
</script>
安全警告:HTML 词法分析器优先于 JavaScript 执行
浏览器在加载 HTML 时,HTML 解析器首先对文档进行词法标记(Tokenization)。当它在 <script> 块内读到 </script> 字符序列时,会无条件判定当前脚本块已经结束。随后紧跟的 <script>alert(1)</script> 将作为全新标签立即被执行,造成跨站脚本攻击(XSS)。
生产级防御方案:HTML 敏感字符 Unicode 转码
根据 JSON 与 JavaScript 语法规则,任何字符串字符都可以用 \uXXXX 形式的四位十六进制转义表示。对于 HTML 解析器敏感的字符(<、>、&、/)以及可能破坏 JS 解析的换行符(U+2028、U+2029),将其统一替换为 Unicode 转义形式即可实现彻底隔离:
/**
 * 生产级安全函数:将对象安全序列化为可内嵌到 HTML <script> 标签中的 JSON 字符串
 * @param {any} data 待序列化数据
 * @param {Function} [replacer] 自定义替换函数
 * @param {number|string} [space] 缩进空格数
 * @returns {string} 上下文安全的 JSON 字符串
 */
function safeJsonForHtml(data, replacer = null, space = 0) {
  // 1. 先通过原生引擎完成标准的 RFC 8259 基础序列化
  const json = JSON.stringify(data, replacer, space);

  if (!json) {
    return '';
  }

  // 2. 将 HTML 敏感字符与特殊行终止符替换为 Unicode 转义序列
  return json.replace(/[<>&/\u2028\u2029]/g, (char) => {
    switch (char) {
      case '<':
        return '\\u003c';
      case '>':
        return '\\u003e';
      case '&':
        return '\\u0026';
      case '/':
        return '\\u002f';
      case '\u2028':
        return '\\u2028';
      case '\u2029':
        return '\\u2029';
      default:
        return char;
    }
  });
}经过转码后,</script> 变成了 \u003c\u002fscript\u003e。HTML 解析器在遇到反斜杠时不会将其视作标签符号,因而平稳跳过;而当 JavaScript 引擎后续解析此字符串时,会自动还原为真实的字符,整个过程既保证了代码绝对安全,又对业务数据完全无损。
更优架构:采用独立的 JSON 数据容器
除了对 <script> 内联代码进行 Unicode 转义外,现代前端工程更推荐将数据直接输出到专用的 type="application/json" 容器中:
<!-- 推荐结构:使用非执行性 script 标签盛放数据 -->
<script id="server-state" type="application/json">
  <%- safeJsonForHtml(userData) %>
</script>

<script>
  // 客户端安全获取数据
  const rawText = document.getElementById('server-state').textContent;
  const safeState = JSON.parse(rawText);
</script>
application/json 类型的脚本块不会被浏览器作为可执行程序运行,从物理层面规避了执行风险。
五、常见避坑指南与自查清单
在日常开发与代码审查中,围绕 JSON 特殊字符处理常常会出现以下几类典型失误:
| 易错场景 | 错误表象与隐患 | 正确规范与解决策略 |
|---|---|---|
| 双重序列化 (Double Escaping) | 对已经序列化好的 JSON 字符串再次调用 JSON.stringify(),导致双引号变成 \\\",客户端反序列化困难。 |
确保入参是原生 JavaScript 数据对象,若已知输入为字符串且需校验,先 JSON.parse 或校验类型后再处理。 |
| URL 查询参数传递 | 将 JSON 字符串直接拼接到 URL 的 query 中,特殊字符 &、=、? 会破坏 URL 协议解析。 |
必须配合 encodeURIComponent(JSON.stringify(data)) 进行网络传输前置编码。 |
| 大整数精度截断 | 超过 Number.MAX_SAFE_INTEGER (9007199254740991) 的数字序列化后在前端反序列化时精度丢失。 |
使用 Replacer 识别 bigint 或超长数字,强制将其序列化为 String 类型。 |
| 正则过滤破坏原有数据 | 盲目使用正则剔除所有反斜杠或特殊符号,导致密码、文件路径或代码片段等有效业务数据损坏。 | 严禁通过“直接剔除特殊字符”来追求安全,必须使用合规的 Unicode 转义机制保持语义完整。 |
六、总结
在 JavaScript 中安全生成含有特殊字符的 JSON,本质上是区分“标准语法转义”与“宿主上下文安全”两层防线的过程:
- 在任何纯粹的数据流场景(文件写入、HTTP Body 传输、服务间 RPC 调用),严禁手写模板字符串拼接,完全委托原生
JSON.stringify()处理双引号、反斜杠与 ASCII 控制字符的转义。 - 在数据需要穿透到 HTML 页面上下文(SSR 初始状态注入、内联脚本变量赋值)时,必须在原生序列化产物的基础上,对
<、>、&以及U+2028、U+2029等关键符号做一层二次 Unicode 实体转义。 - 对于复杂或外部不可控的动态数据,始终配置具备
BigInt支持与循环引用检测能力的replacer函数,确保序列化过程的稳健性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章