
深入探讨基准元素(Pivot)选择策略对 JavaScript 快速排序算法性能的决定性影响,分析固定基准、随机基准、三数取中与九数取中策略的运作机制、退化场景及工程优化方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
基准元素选择策略对 JavaScript 快速排序性能的影响
作者:听澜
时间:2026-11-03
浏览:146
文章目录
主题:算法与工程实现
环境:Node.js / 现代浏览器 (V8)
重点:基准选择、递归深度与退化防护
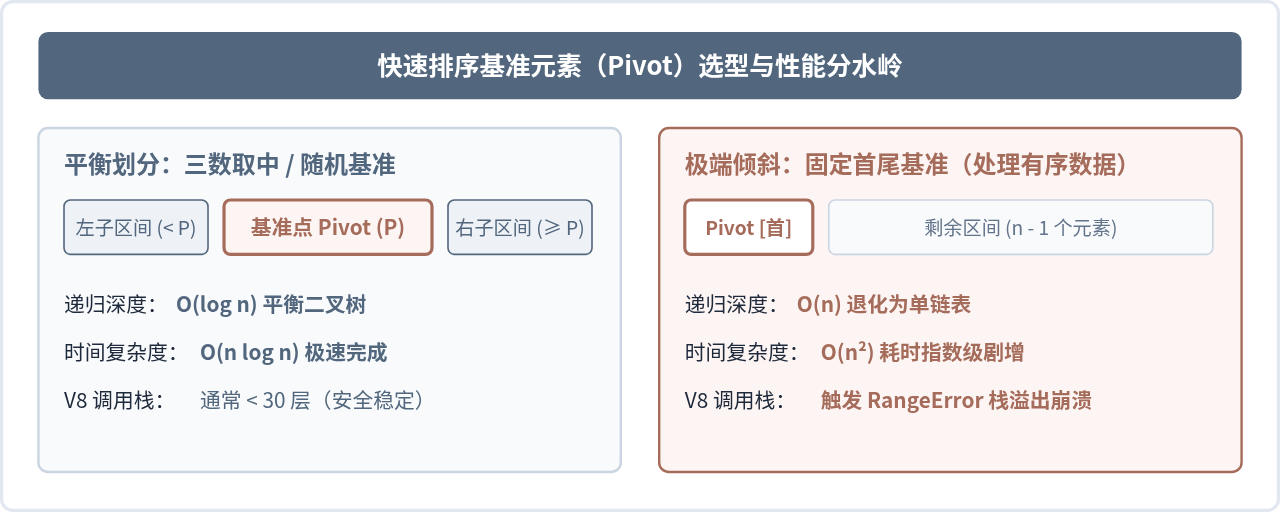
快速排序的核心性能瓶颈并非比较与交换的操作耗时,而在于基准元素(Pivot)能否将数组划分为规模尽可能对称的两个子区间。选择不当的基准策略会在面对已排序、逆序或大量重复值等常见工程数据时,使原本期望为 O(n log n) 的算法骤然退化为 O(n²),在单线程的 JavaScript 引擎中不仅会造成显著的事件循环卡顿,还会直接触发调用栈溢出(RangeError: Maximum call stack size exceeded)。理解并选用适配场景的基准选取策略,是保障前端与 Node.js 排序稳定性的关键。
一、基准元素与分区的基本机制
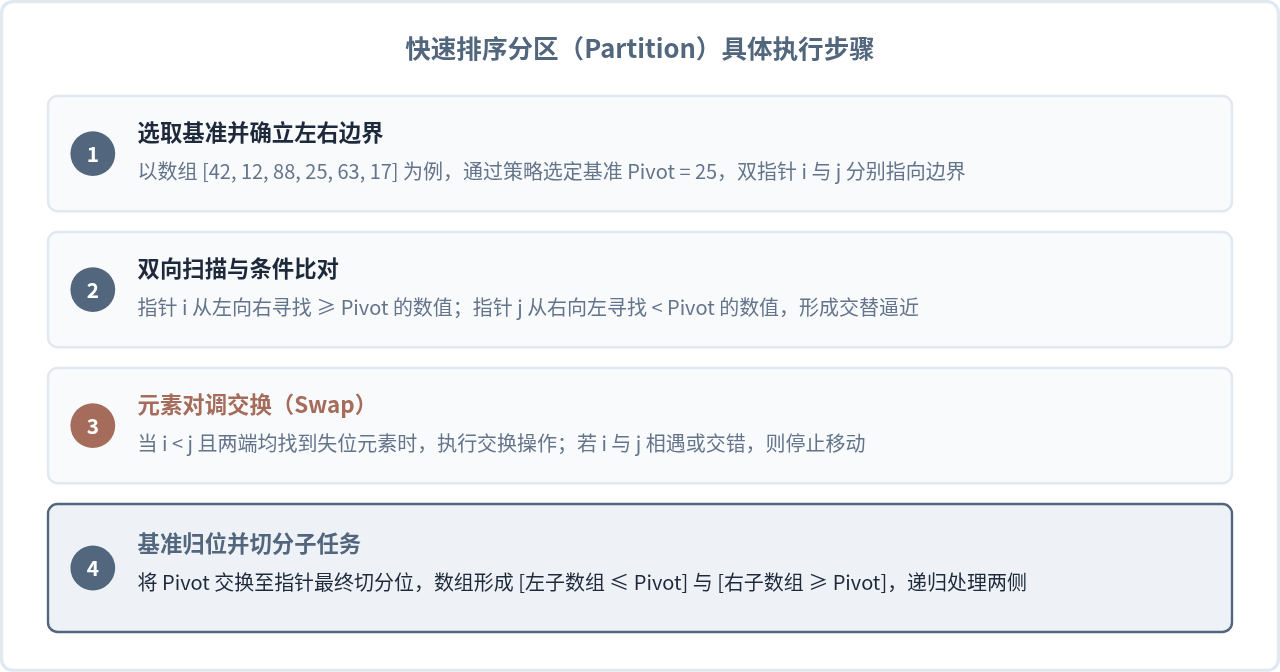
快速排序遵循“分而治之”的设计范式。其核心操作是在待排序的区间 [left, right] 中挑选一个元素作为基准点(Pivot),然后通过双指针遍历该区间,将所有小于基准的元素移至左侧,大于等于基准的元素移至右侧,最后将基准元素安放于两个区间的交界处。
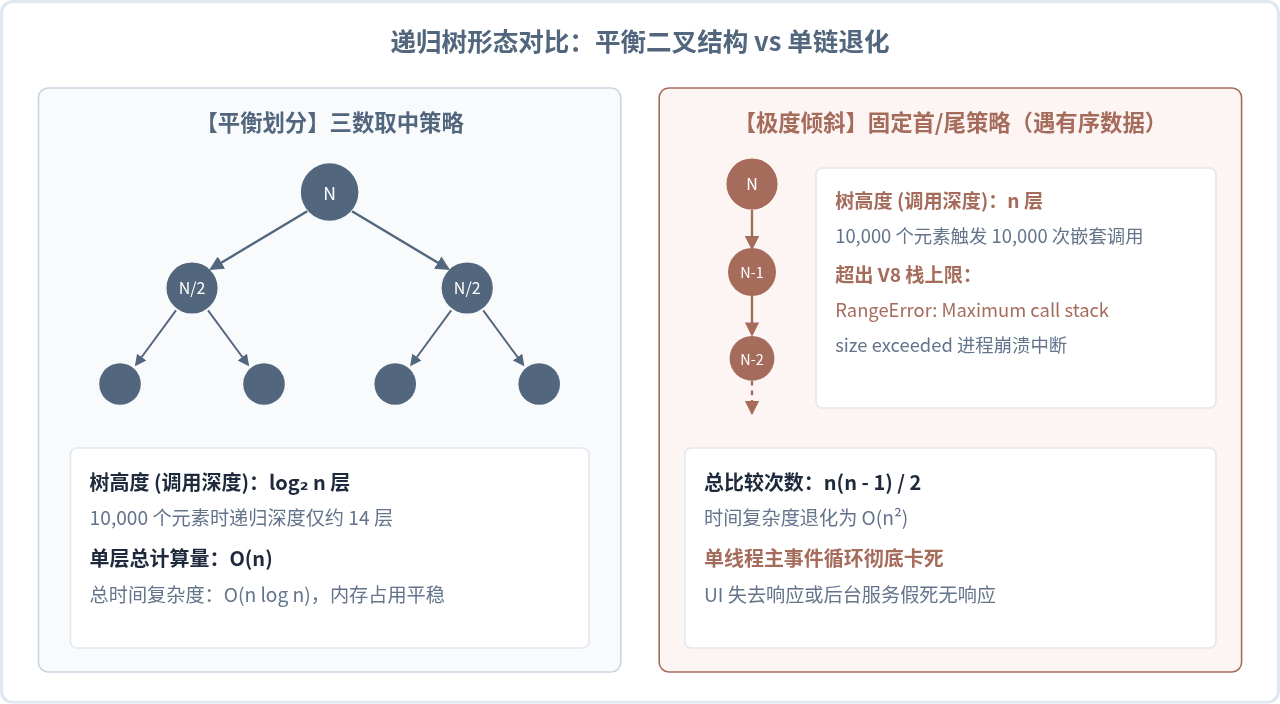
这个分区过程(Partition)的时间复杂度严格为 O(k),其中 k 是当前区间的元素个数。但是,整个快速排序的总体时间开销,完全取决于分区后两边子区间的规模比例。如果每次选择的基准值都能恰好平分区间,递归树的高度即为 log₂ n;若每次选出的基准都是当前区间的极值(最小值或最大值),单次分区只能剔除一个元素,递归树就会变成一条长度为 n 的单链。
二、常见基准选择策略及其机制
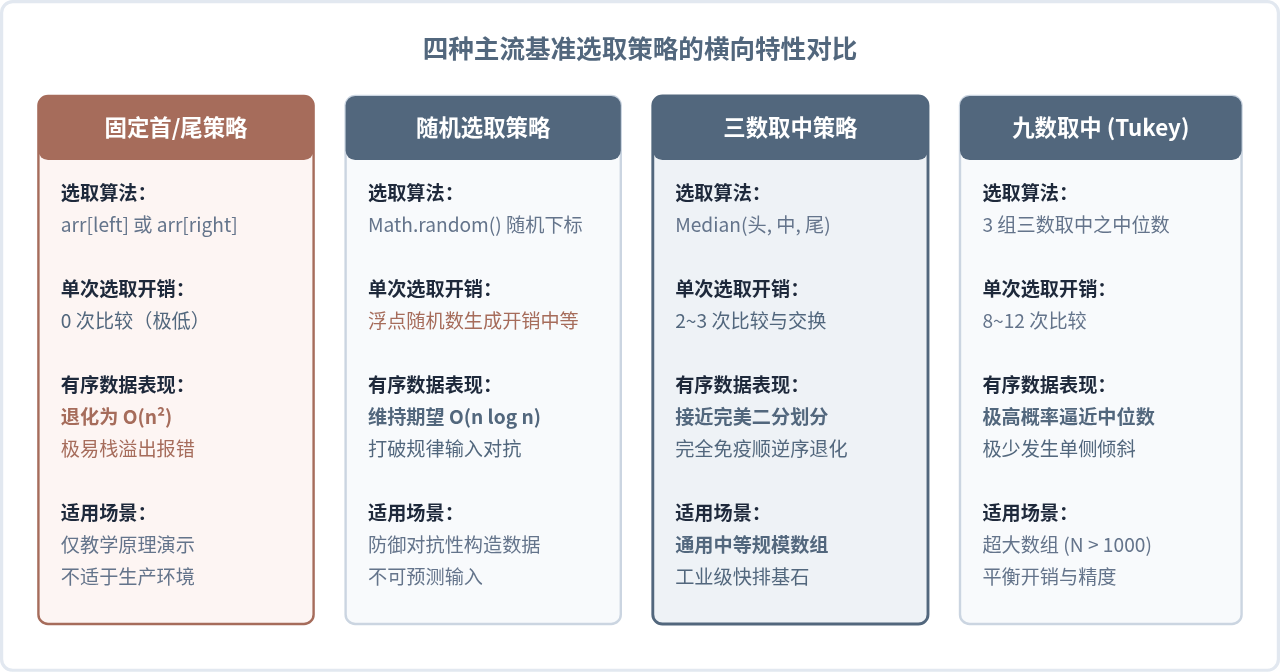
为了在不同场景下平衡选择开销与防退化能力,工程实践中衍生出了以下四种主要基准选取策略:
1. 固定首尾元素策略(Fixed Pivot)
最简单的实现方式是无条件直接选择当前区间的第一个元素 arr[left] 或最后一个元素 arr[right] 作为基准。其代码实现极其精简,完全没有额外的计算开销。然而,该策略在现实生产数据中极度脆弱。
2. 随机选取基准策略(Random Pivot)
在待排区间内随机生成一个下标 Math.floor(Math.random() * (right - left + 1)) + left,将其与边界元素交换后再执行标准分区。这种策略破坏了特定输入模式(如升序、降序)对算法的针对性攻击,使得任意输入的最坏情况概率均摊至极低水平。
3. 三数取中策略(Median-of-Three)
采样当前区间的头(left)、中(mid = Math.floor((left + right) / 2))、尾(right)三个元素,经过最多 3 次比较,取其中位数作为基准点。该方法无需调用随机数生成器,能完美规避已排序、逆序数组带来的退化,且计算开销仅为数条简单的条件判断。
4. 九数取中伪中位数策略(Tukey's Ninther)
针对大规模数据集(如元素量超过 1000),将区间划分为三等份,在每份内分别采用“三数取中”,最后对产生的三枚中位数再次进行“三数取中”。这种多重采样逼近了真实中位数分布,是 V8 引擎早期 Array.prototype.sort 的经典底层设计思路。
三、性能断崖:递归树退化与数学原理解析
为什么基准点的细微差异会导致性能产生质的飞跃?这可以通过递归树的形态差异得到直观解释。
假设对一个已经按升序排列的包含 n 个元素的数组进行排序。如果采用固定选取首元素 arr[left] 的策略:
- 第一次分区:选取当前最小值,所有其余
n - 1个元素均大于它。经历n - 1次比较后,生成一个长度为 0 的左区间和一个长度为n - 1的右区间。 - 第二次分区:在
n - 1个元素中继续取最小值,经历n - 2次比较,划分出 0 和n - 2。 - 依此类推,总比较次数为:
(n - 1) + (n - 2) + ... + 1 = n(n - 1) / 2。
当 n = 10,000 时,平衡划分仅需约 10000 × 13.3 ≈ 1.33 × 10⁵ 次比较;而退化后的比较次数高达 5 × 10⁷ 次,操作量剧增近 380 倍!
四、JavaScript 运行环境的特殊约束
在 C/C++ 或 Go 等编译型语言中,即使快速排序发生倾斜,也可能仅表现为运行时间拉长。但在 JavaScript 的运行机制下,退化会直接带来灾难性的运行时异常:
⚠️ 关键风险:V8 引擎调用栈深度限制
Node.js 与 Chrome 的 V8 引擎对 JavaScript 递归函数调用的栈深度有明确硬限制(通常在 10,000 层左右)。当处理一个包含 15,000 个元素的有序数组且使用固定首元素策略时,由于每次只能缩减 1 个元素,调用深度将直逼 15,000,必然直接抛出
Node.js 与 Chrome 的 V8 引擎对 JavaScript 递归函数调用的栈深度有明确硬限制(通常在 10,000 层左右)。当处理一个包含 15,000 个元素的有序数组且使用固定首元素策略时,由于每次只能缩减 1 个元素,调用深度将直逼 15,000,必然直接抛出
RangeError: Maximum call stack size exceeded,导致进程异常退出。
此外,还有两项在 JavaScript 中常被忽视的性能特性:
-
Math.random()的隐藏损耗:
为了避免退化而盲目在每次递归中调用Math.random()并不明智。在 V8 引擎中,Math.random()需要维护内部随机数生成器状态并产生浮点数,紧接着还要执行乘法与Math.floor()取整。在递归深度数十层的调用链中,累计的随机数计算耗时可能占到排序总执行时间的 25% 以上。 -
单线程阻塞影响:
JavaScript 的主线程负责页面渲染与事件响应。一旦排序复杂度从毫秒级的O(n log n)暴涨到秒级的O(n²),主事件循环将被完全阻塞,导致页面彻底卡死无响应。
五、工业级实现:三数取中与双指针快速排序
为了兼顾防退化能力与执行效率,工业级 JavaScript 实现应采用“三数取中”基准选择,并配合双指针原地交换(In-place Partition)。以下是生产环境可用的完整 JavaScript 代码:
/**
 * 三数取中策略:比较 left、mid、right 三个位置的值,
 * 将中位数调整至 arr[mid],并返回该中位数值作为基准
 */
function medianOfThree(arr, left, right) {
  const mid = (left + right) >> 1;

  // 通过三次简单比较,保证 arr[left] <= arr[mid] <= arr[right]
  if (arr[left] > arr[mid]) {
    swap(arr, left, mid);
  }
  if (arr[left] > arr[right]) {
    swap(arr, left, right);
  }
  if (arr[mid] > arr[right]) {
    swap(arr, mid, right);
  }

  // 将中位数 arr[mid] 与 arr[right - 1] 对调,作为隐式哨兵
  swap(arr, mid, right - 1);
  return arr[right - 1];
}

/** 辅助原地交换函数 */
function swap(arr, i, j) {
  const temp = arr[i];
  arr[i] = arr[j];
  arr[j] = temp;
}

/** 核心快速排序主函数 */
function quickSort(arr, left = 0, right = arr.length - 1) {
  if (left >= right) return;

  // 小区间优化:当区间长度小于等于 10 时,切换为更低开销的插入排序
  if (right - left <= 10) {
    insertionSort(arr, left, right);
    return;
  }

  // 选取基准元素(三数取中)
  const pivot = medianOfThree(arr, left, right);

  // 双指针划分:由于 arr[left] <= pivot 且 arr[right - 1] === pivot,指针从内侧推进
  let i = left;
  let j = right - 1;

  while (true) {
    while (arr[++i] < pivot) {}
    while (arr[--j] > pivot) {}

    if (i >= j) break;
    swap(arr, i, j);
  }

  // 将基准点放回交界位置
  swap(arr, i, right - 1);

  // 尾递归优化视角:优先递归较小区间,减少调用栈峰值
  quickSort(arr, left, i - 1);
  quickSort(arr, i + 1, right);
}

/** 插入排序:小规模子区间极速处理 */
function insertionSort(arr, left, right) {
  for (let i = left + 1; i <= right; i++) {
    const target = arr[i];
    let j = i - 1;
    while (j >= left && arr[j] > target) {
      arr[j + 1] = arr[j];
      j--;
    }
    arr[j + 1] = target;
  }
}
六、总结与工程决策决策树
基准元素的选择是快速排序在工业落地中的第一道防线。单凭一种朴素策略无法应对所有数据形态。下方的工程决策图展示了现代排序算法在处理不同数据规模与分布时的分流逻辑:
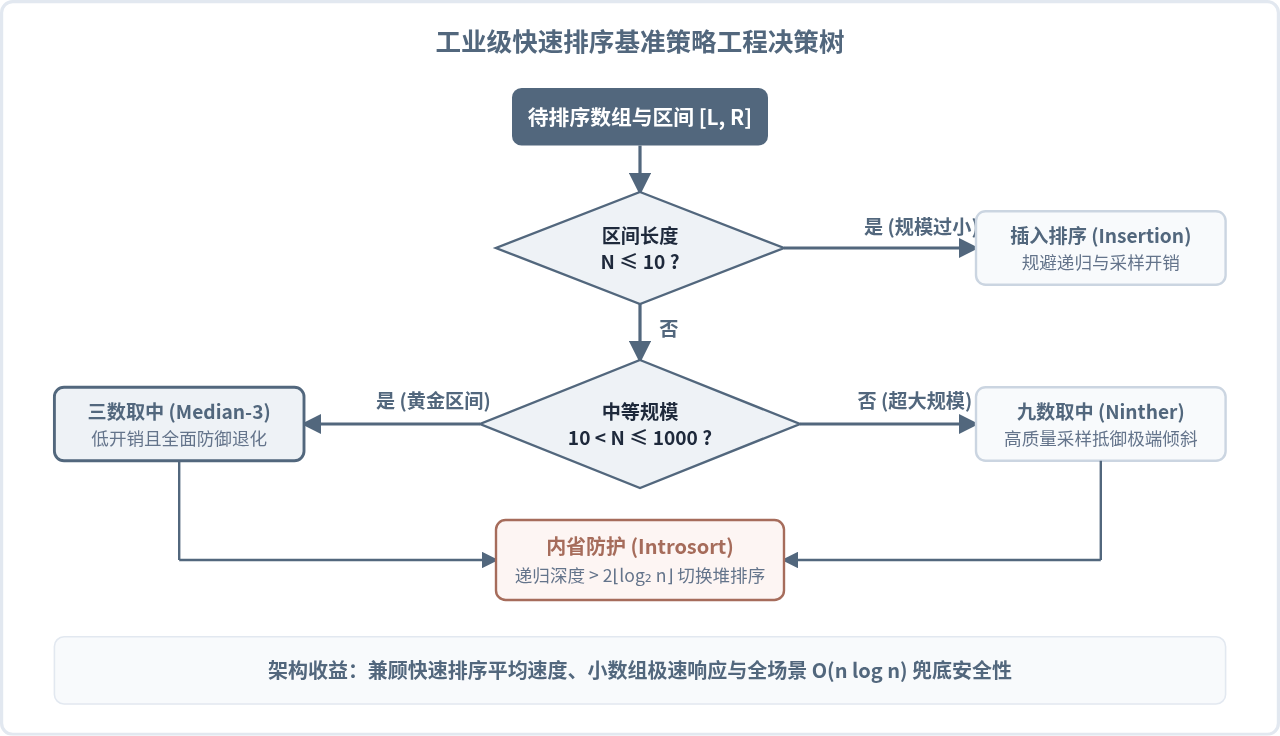
| 基准策略 | 采样比较次数 | 升序/降序表现 | 抗极端构造能力 | 工程适用结论 |
|---|---|---|---|---|
| 固定首/尾 | 0 次 | 退化至 O(n²),栈溢出 | 极差 | 不可在实际项目中使用 |
| 随机选取 | 依赖 Math.random | 保持 O(n log n) | 强 | 适合对抗外部恶意输入,常规排序耗时偏高 |
| 三数取中 | 2~3 次 | 保持 O(n log n) 最优状态 | 优良 | 推荐:中小至通用规模数组的最佳平衡点 |
| 九数取中 | 8~12 次 | 高度对称划分 | 极强 | 海量元素大数组(V8 底层常用实践) |
归纳而言,在 JavaScript 运行环境中编写快速排序时,切忌使用固定位置基准。对于绝大多数业务场景,以“三数取中”为核心、在长度小于 10 时回退至“插入排序”的混合设计,能够在不引入复杂随机数计算的前提下,彻底杜绝单侧倾斜退化与 RangeError 栈溢出风险,使排序过程平稳运行在期望的 O(n log n) 性能区间内。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章