
深入解析 JavaScript 中 String.prototype.split 方法的切分机制、纯字符串与正则表达式分隔符特性、捕获组保留机制、Unicode/Emoji 防坑处理及生产级清洗流水线。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS字符串转数组:split方法详解与分隔符选择
作者:纸飞机
时间:2026-11-04
浏览:387
文章目录
JavaScript 权威技术指南
字串处理与数据结构
环境: ECMAScript 5.1+ / Node.js / Modern Browsers

在 JavaScript 开发中,将字符串切割并转换为数组最直接、最核心的原生方法是 String.prototype.split()。该方法接收一个定界符(分隔符)与一个可选的长度限制参数,在内部遍历匹配切分点,并将截取出的子字符串依次组织为全新的数组返回。本文将系统拆解 split() 的底层执行机制、不同类型分隔符(普通字符串、正则非捕获组与捕获组)的匹配行为差异,深入分析生产环境中常见的边界陷阱(包括空字符串返回值、Unicode 代理对切碎及 limit 截断机制),并给出面向不同业务场景的最佳分隔符选型策略与数据清洗范式。
一、split() 核心语法与执行机制拆解
split() 是挂载于 String.prototype 上的原生方法,用于按照指定规则将一个字符串拆解成多个子字符串组成的数组。其标准方法签名如下:
const result = str.split([separator[, limit]]);理解该方法的关键在于掌握其参数缺省行为与内部扫描过程:
- separator(分隔符):指定以何种标记进行拆分,可传入纯字符串或正则表达式。若省略该参数或传入
undefined,split()不会对字符串做任何切割,而是直接返回一个仅包含原字符串单项的全新数组(即[str]);若传入空字符串"",则会将原字符串按 UTF-16 编码单元逐字符物理切碎。 - limit(限制长度):可选的非负整数,用于指定生成数组的最大元素个数。当返回数组的长度达到
limit时,切分扫描即刻终止,后续所有字符均不再被处理或保留。 - 返回值与不可变性:
split()始终返回一个全新的Array实例,原字符串本身作为原始类型具有不可变性(Immutable),不会产生任何副作用。
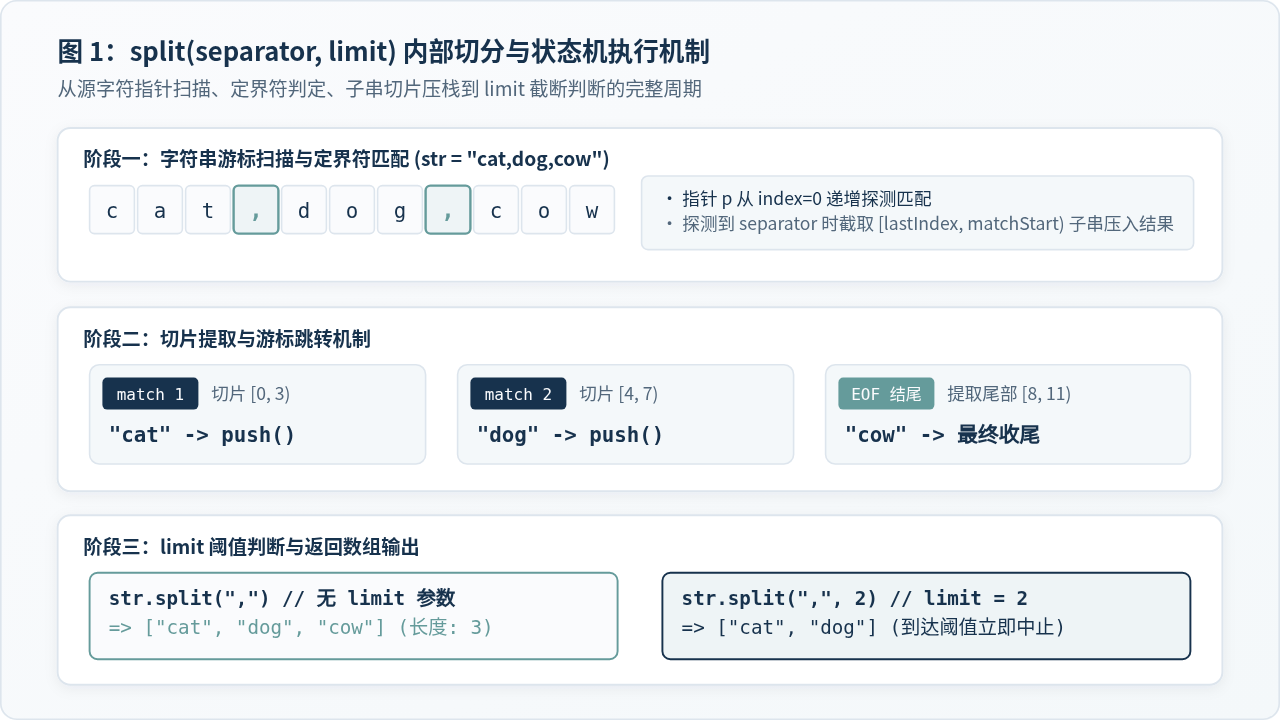
如上图所示,当 JavaScript 引擎执行 str.split(separator) 时,内部游标从索引 0 线性向右扫描。每当探测到与 separator 匹配的区间时,引擎会提取上一次匹配结束位置到本次匹配起始位置之间的子串,并将其压入结果数组中;扫描抵达字符串末尾时,将剩余尾部子串完成最终压入。如果指定了 limit,一旦压入元素的数量达到设定阈值,算法立即跳出扫描并返回当前数组。
// 基础示例 1:默认不传参 vs 传入空字符串
const raw = "apple,banana,orange";

const arrDefault = raw.split();
const arrChars = raw.split("");
const arrByComma = raw.split(",");
const arrWithLimit = raw.split(",", 2);
示例输出
arrDefault => ["apple,banana,orange"] (长度为 1)arrChars => ["a", "p", "p", "l", "e", ",", "b", ...]
arrByComma => ["apple", "banana", "orange"]
arrWithLimit => ["apple", "banana"] (第三项 orange 被直接丢弃)
二、分隔符类型选择与模式匹配深度对比
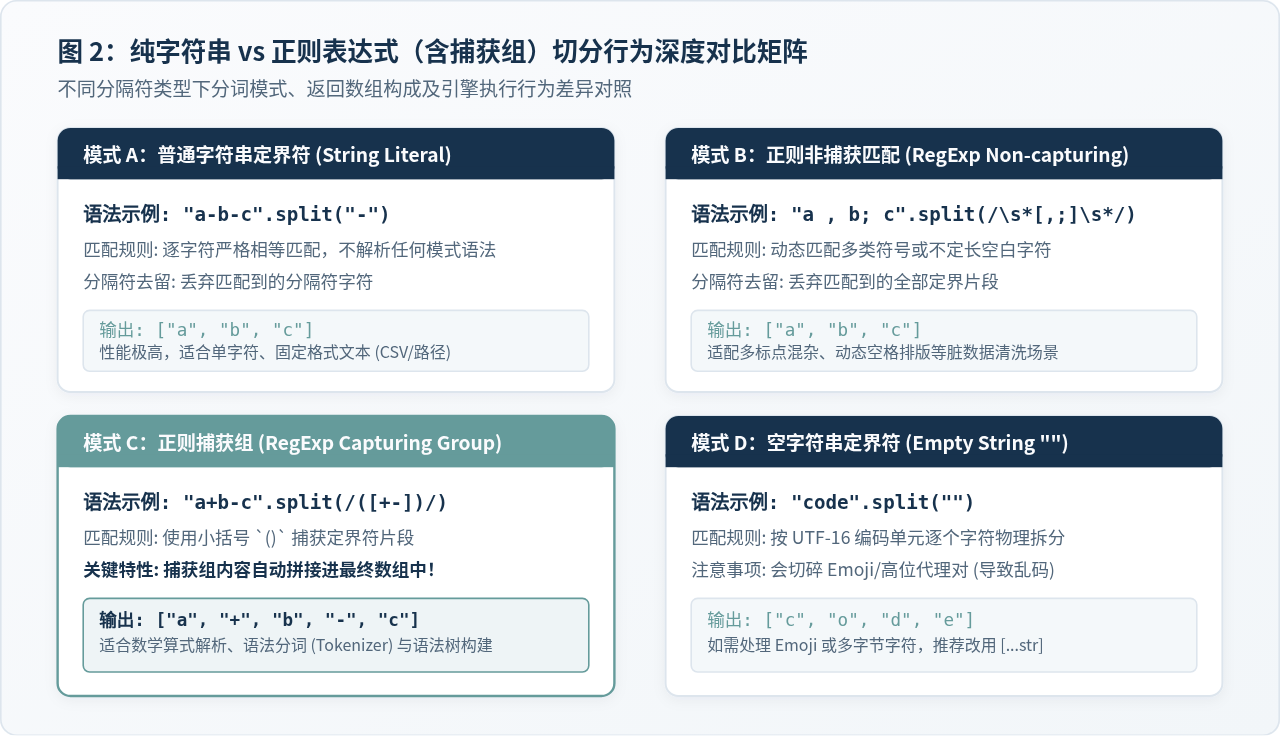
在实际编码中,选择“纯字符串字面量”还是“正则表达式”作为分隔符,不仅决定了代码的简洁程度与执行效率,更直接影响分词结果的准确性。
1. 纯字符串分隔符:精确匹配与高效解析
当目标字符串拥有严格统一的结构(例如标准 CSV 格式的单英文逗号、URL 路径中的斜杠 /、系统配置项中的冒号 :)时,应当优先使用纯字符串作为分隔符。纯字符串比较在 V8 等现代 JS 引擎中走轻量级文本搜索分支,无需启动正则表达式编译与状态回溯机制,执行性能最高且语义直观。
// 适用场景:严格单字符或固定子串切割
const path = "/api/v1/users/profile";
const pathSegments = path.split("/");
// 结果: ["", "api", "v1", "users", "profile"]
2. 正则表达式分隔符:模糊匹配与多符号融合
在面对来自用户表单输入、剪贴板粘贴或非标文本日志等真实场景时,分隔符往往不统一。例如用户可能会随机混用中英文逗号、分号,或者在标点两侧留有任意数量的空格或换行符。此时纯字符串匹配无法胜任,必须通过正则表达式构建复合模式。
// 适用场景:处理不定长空格与混合标点
const mixedInput = "前端, 后端 ; 运维 , 测试
移动端";

// 正则匹配:匹配一个或多个包含中英文逗号、分号或空白字符的连续片段
const tags = mixedInput.split(/[,,;;\s]+/);
示例输出
tags => ["前端", "后端", "运维", "测试", "移动端"]
3. 捕获组与非捕获组的关键区别(重要特性)
这是 split() 方法中最常被忽视却极其关键的底层行为:如果传递给 split() 的正则表达式中包含捕获括号 ( ... ),则匹配到的分隔符本身也会被作为独立元素压入最终返回的数组中!相反,如果使用非捕获括号 (?: ... ),则分隔符仅参与规则匹配,不会被保留在结果中。
const formula = "10+20*30-40";

// 1. 使用普通正则(无捕获组):分隔符被完全丢弃
const numbersOnly = formula.split(/[+*-]/);
// 结果: ["10", "20", "30", "40"]

// 2. 使用包含捕获括号的正则:分隔符被原样保留进数组
const tokens = formula.split(/([+*-])/);
// 结果: ["10", "+", "20", "*", "30", "-", "40"]

// 3. 需要括号分组但不想保留分隔符时,务必使用 (?: ) 非捕获组
const splitByWords = "appleANDbananaORorange".split(/(?:AND|OR)/);
// 结果: ["apple", "banana", "orange"]
💡 架构选型建议
当编写语法解析器(Lexer/Tokenizer)、公式计算器、或者富文本高亮分词工具时,捕获组特性是实现“将操作符与操作数一并保留”最优雅的高性能手段;但在日常普通数据清洗时,若仅是为了在正则中组织优先级或使用“或”运算,务必使用 (?:pattern),避免产生意料之外的脏数组项。
三、分隔符选择策略与典型场景实战
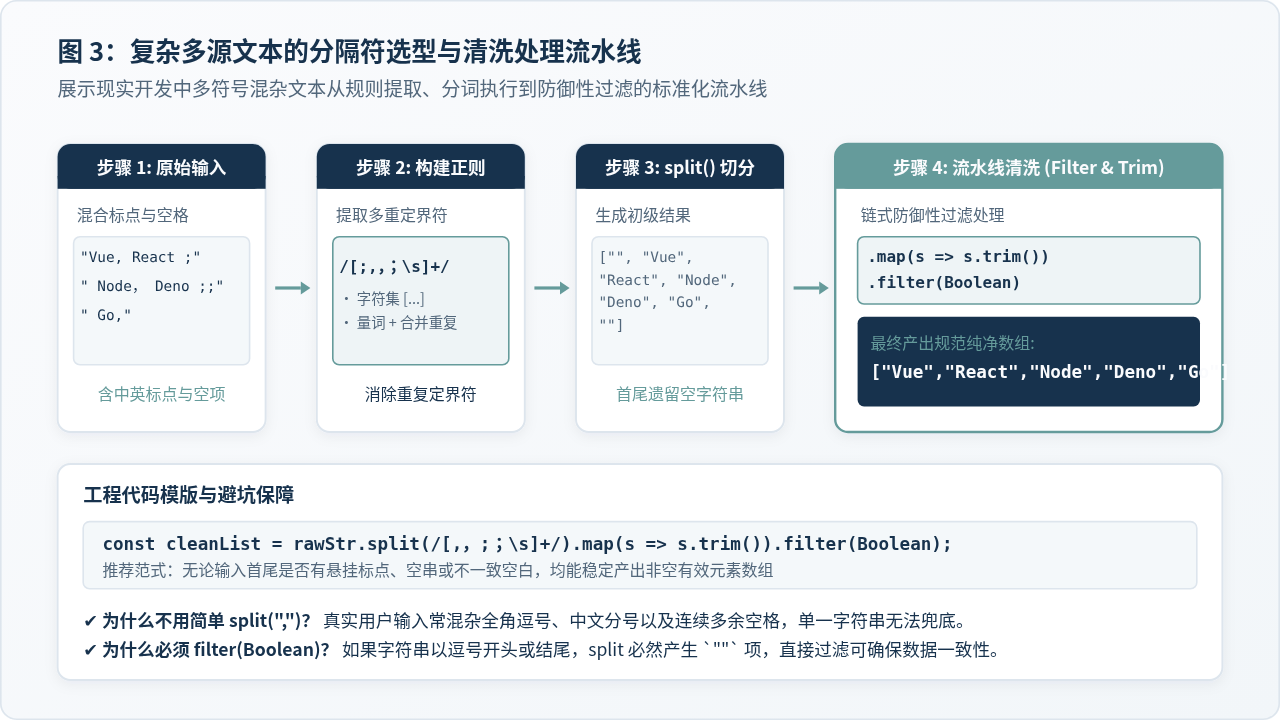
在工程实践中,由于数据源质量参差不齐,直接调用 split() 往往会出现包含首尾空字符串、多余空白或无效项的问题。建立一条标准的切分清洗流水线能够从根本上保证数据契约的严谨性。
场景 1:用户多行标签输入的健壮性切分
用户在网页的 <textarea> 中粘贴多个标签,往往包含换行、连续空格、以及中英文标点。下述工程范式结合了正则表达式字符集与管道过滤:
function parseUserTags(input) {
  if (!input || typeof input !== "string") return [];

  return input
    .split(/[,,;;

	]+/)  // 1. 覆盖多种标点与控制字符
    .map(tag => tag.trim())   // 2. 清除单词两侧残余空格
    .filter(Boolean);          // 3. 剔除因开头、结尾或连续标点导致的空字符串
}

// 测试验证
const sample = " , JavaScript, TypeScript ; Python

 Go , ";
console.log(parseUserTags(sample));
示例输出
["JavaScript", "TypeScript", "Python", "Go"]
场景 2:URL 查询参数(Query String)的分级两段切分
在无 URLSearchParams 或轻量级解析场景下,可以通过连续两层 split 分别处理键值对定界符 & 与赋值定界符 =:
function parseQueryParams(queryString) {
  const cleanQuery = queryString.replace(/^\?/, "");
  if (!cleanQuery) return {};

  const params = {};
  cleanQuery.split("&").forEach(pair => {
    if (!pair) return;
    const [key, value] = pair.split("=");
    params[decodeURIComponent(key)] = decodeURIComponent(value || "");
  });
  return params;
}

const qs = "?category=frontend&page=1&sort=desc";
console.log(parseQueryParams(qs));
示例输出
{ category: "frontend", page: "1", sort: "desc" }
四、边界条件、高频陷阱与防坑要点
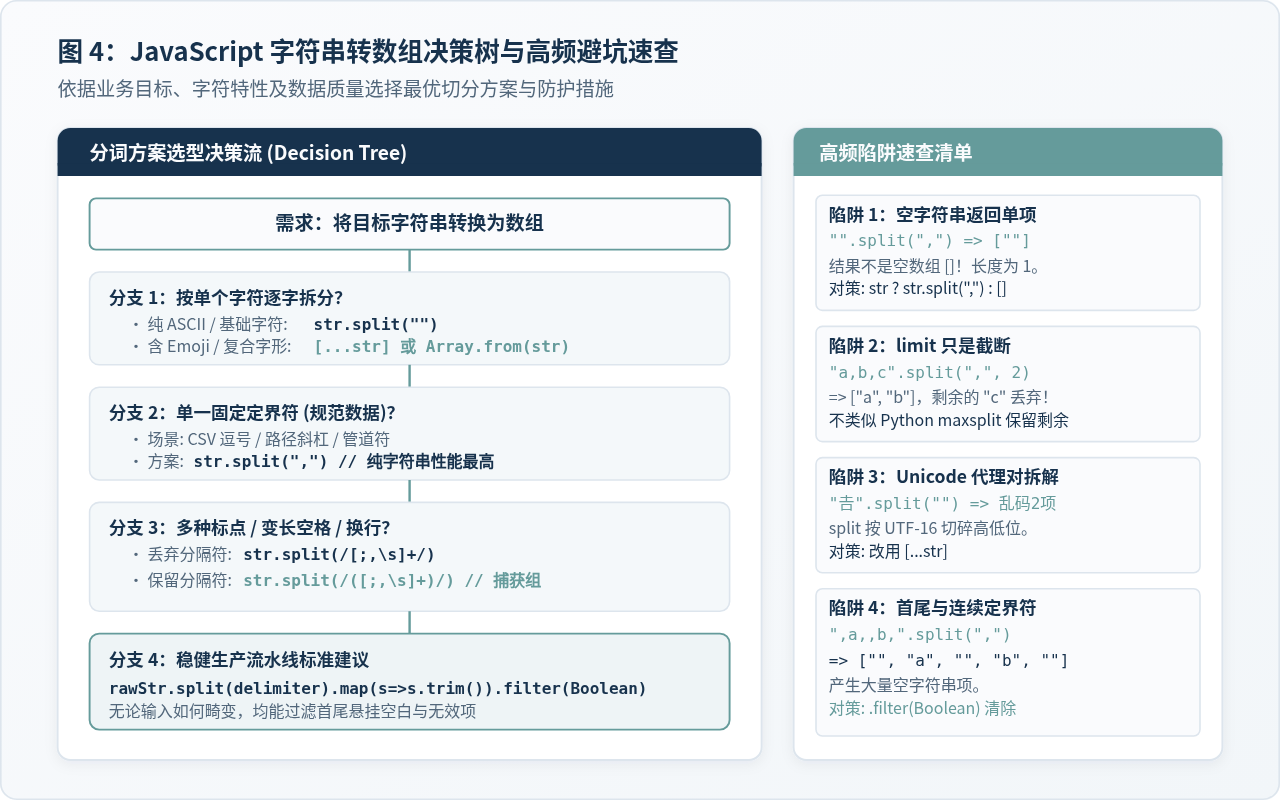
split() 在诸多边缘情况下表现出的行为往往有违直觉,必须在开发与代码审查中给予针对性关注。
陷阱 1:空字符串调用 split 不返回空数组
这是 JavaScript 初学者极易踩坑的经典问题:当对一个长度为 0 的空字符串 "" 使用任意非空分隔符执行 split 时,返回的不是空数组 [],而是包含一个空字符串单项的数组 [""]!
const str = "";
console.log(str.split(","));        // 输出: [""],length 为 1!
console.log(str.split(",").length); // 1,非 0

// 推荐的安全防御写法:
const safeArray = str ? str.split(",") : [];
陷阱 2:使用 split("") 切分 Unicode 与 Emoji 导致乱码
JavaScript 内部字符串基于 UTF-16 编码单元实现。对于超过单个 16 位表示范围的字符(例如大多数 Emoji 表情、复杂符号或罕见汉字),它们是由两个 16 位代理对(Surrogate Pair)组合而成的。使用 str.split("") 会粗暴地将高低位代理拆散,导致生成非法字符或乱码。
const emojiStr = "hello👋";
// 错误做法:split("") 破坏了 Unicode 字符
const broken = emojiStr.split("");
console.log(broken);
// 输出: ["h", "e", "l", "l", "o", "\uD83D", "\uDC4B"] (拆分为两个损坏的孤立代理项)
// 正确做法 1:使用 ES6 展开运算符(基于 Code Point 迭代器)
const safe1 = [...emojiStr];
// 输出: ["h", "e", "l", "l", "o", "👋"]
// 正确做法 2:使用 Array.from()
const safe2 = Array.from(emojiStr);
// 输出: ["h", "e", "l", "l", "o", "👋"]
// 正确做法 3:针对带组合修饰符的复合 Emoji(如家庭、肤色),使用现代 Intl.Segmenter
const segmenter = new Intl.Segmenter("zh", { granularity: "grapheme" });
const graphemes = [...segmenter.segment("👨👩👦")].map(s => s.segment);
// 完整保留单个人形字形簇: ["👨👩👦"]陷阱 3:limit 参数只做截断,不合并剩余子串
在 Python 等其他语言中,str.split(sep, maxsplit) 会将剩余部分合并作为数组的最后一项。但 JavaScript 的 limit 仅代表结果数组的最大容量(Capacity),一旦达到 limit 项,剩余的所有字符将被彻底丢弃。
const record = "2026-11-02-Meeting-Notes-Draft";

// 预期如果是希望保留剩余内容为单项,直接用 limit 会丢失数据:
const cut = record.split("-", 3);
console.log(cut);
// 实际输出: ["2026", "11", "02"],后续的 "Meeting-Notes-Draft" 全部丢失!

// 若需要实现类似 Python 的保留尾部切分,需手动截取:
function splitWithRest(str, sep, maxCount) {
  const parts = str.split(sep);
  if (parts.length <= maxCount) return parts;
  const result = parts.slice(0, maxCount - 1);
  result.push(parts.slice(maxCount - 1).join(sep));
  return result;
}
console.log(splitWithRest(record, "-", 4));
// 输出: ["2026", "11", "02", "Meeting-Notes-Draft"]
陷阱 4:行首、行尾分隔符与连续分隔符
若字符串以分隔符开头或结尾,或者存在连续重复的分隔符,split() 会在切分点两侧提取出长度为 0 的空字符串 ""。例如 ",a,b,".split(",") 将得到长达 4 的数组 ["", "a", "b", ""]。在业务逻辑处理前,务必使用 .filter(Boolean) 清洗掉无效空项。
五、总结与分隔符选择对照表
为了在工程开发中快速决策,下表汇总了不同输入特征与需求下的分隔符与方法选型对照:
| 场景需求 | 推荐使用方法 / 分隔符 | 核心示例 | 注意事项 |
|---|---|---|---|
| 标准格式定界切分 | 纯字符串字面量 "sep" |
str.split(",") |
性能最优,要求输入格式规范统一 |
| 多类型标点混杂 | 正则字符集 /[...]+/ |
str.split(/[,,;;\s]+/) |
务必配合 .filter(Boolean) 过滤空项 |
| 分词且需保留分隔符 | 正则捕获组 /(...)/ |
str.split(/([+\-*/])/) |
小括号会触发分隔符注入结果数组机制 |
| 正则分组但丢弃分隔符 | 正则非捕获组 /(?:...)/ |
str.split(/(?:AND|OR)/) |
使用 ?: 显式禁止分隔符注入 |
| 按单字逐字符拆散 | 展开运算符 [...str] |
[...str] 或 Array.from(str) |
替代 split(""),防止破坏 Emoji 与代理对 |
| 安全空串保护 | 三元防御运算 | str ? str.split(",") : [] |
防御 "".split(",") 返回 [""] 的特异现象 |
掌握 String.prototype.split() 的核心不在于记住单一 API,而在于针对不同的业务数据质量,审慎评估分隔符规则的边界表达能力。在涉及多源、非标准用户输入的生产环境中,将“正则表达式分隔符”、“链式 trim 清洗”与“空值过滤”组合成标准流水线,是构建高可用、高健壮性前端与服务端系统的基础保障。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章