
深入解析在JavaScript中将数字转换为中文大写或小写时的连续零消除机制与五大边界情况防御,提供基于4位万进制分节与状态机消零的完整原生代码实现。

当前位置:首页 > JavaScript 基础 > 正文
JS数字转中文时怎么处理连续零和边界情况
作者:异步漫步
时间:2026-11-03
浏览:214
文章目录
在前端表单展示、发票大写金额录入、合同编号生成或电子书语音朗读等实际场景中,将阿拉伯数字转换为规范的中文表达是高频出现的需求。不同于阿拉伯数字按位独立显示,中文数字有着严格的读音归纳与节权层级规律。如果仅将每个数字做字典映射,数字 1005 就会错误地输出为“一千零零五”,而 100000005 则可能变成令人费解的“一亿万零五”。
处理该问题的标准做法是采用4位万进分节体系,搭配单零状态机压缩机制与极端边界前置拦截。本文将针对连续零的处理规则进行逐层推导,深入解析纯零、首位十、跨节全零、小数逐位朗读以及 JavaScript 浮点大数精度丢失等五大典型边界,并给出一份可直接投入生产运行的原生实现方案。
核心机制与难点剖析:为什么连续零极易出错
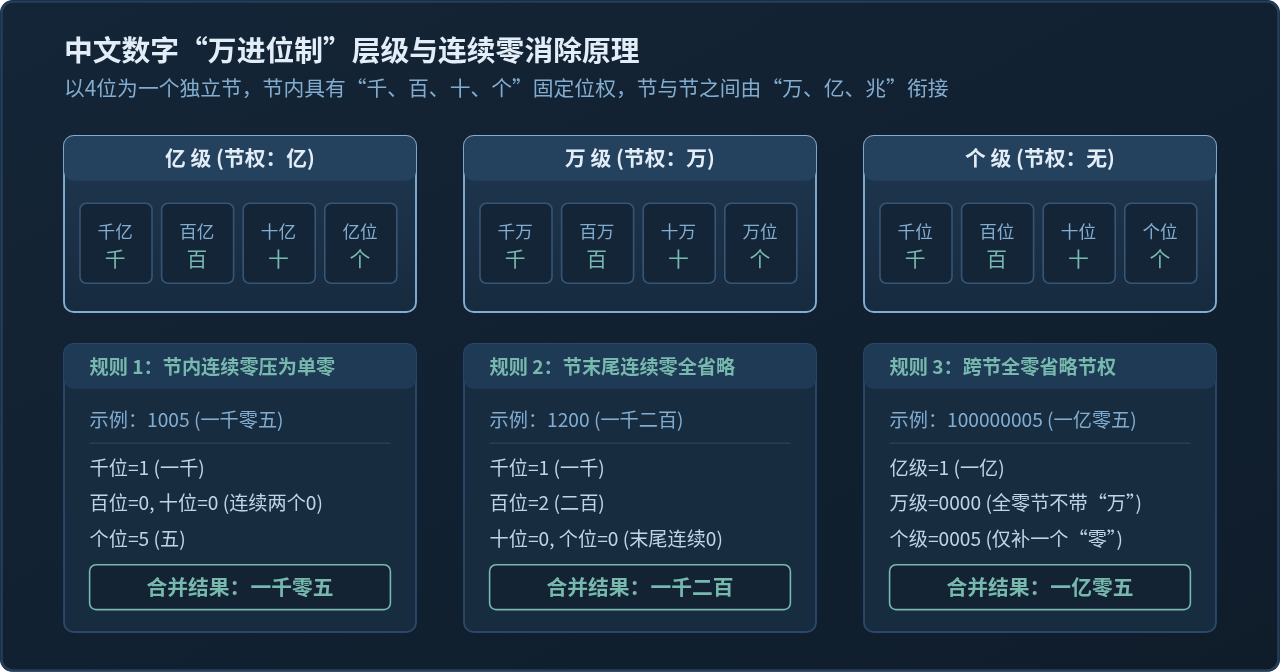
中文数字系统与西方以“千”(103)为基准的三位分节计数不同,采用的是**“万进位制”**(104)。每4位数字构成一个独立的节(个级、万级、亿级、兆级),而每个节内又严格包含“千、百、十、个”四个基本位权。这种双层嵌套结构决定了“零”的处理不仅存在于节内,更贯穿于跨节之间。
在中文读数习惯中,零并不是单纯的数字,而是一种**“断裂权位的声学占位符”**。连续零的合并与消减必须满足以下三条核心规则:
- 规则一(节内中间连续零压为单零):在同一个4位分节中,若非零数字之间出现了一个或多个连续的零,无论连续几位,在发音上永远只保留一个“零”。例如数字
1005,千位为1、百位为0、十位为0、个位为5,百位与十位的两个连续零只能读出一个“零”,最终读作“一千零五”,不可输出“一千零零五”。 - 规则二(节末尾连续零完全省略):若连续的零出现在一个节的末尾,这些零完全不发音。例如数字
1200,千位为1、百位为2、十位与个位皆为0,末尾的零直接隐去,读作“一千二百”,不可读作“一千二百零”。 - 规则三(跨节全零与单零平滑衔接):当某个4位分节的所有位权全部为零时(例如
100000005中的万级为0000),该节对应的节权词“万”必须彻底舍弃,坚决不能输出“一亿万零五”;与此同时,这个全零节向更低位传递了一个“权位中断”的信号,使得整个跨度长达7个零的数字在亿级与个级之间,仅凭一个“零”实现平滑衔接,规范输出“一亿零五”。
算法设计与分步实现:从分节到状态消零
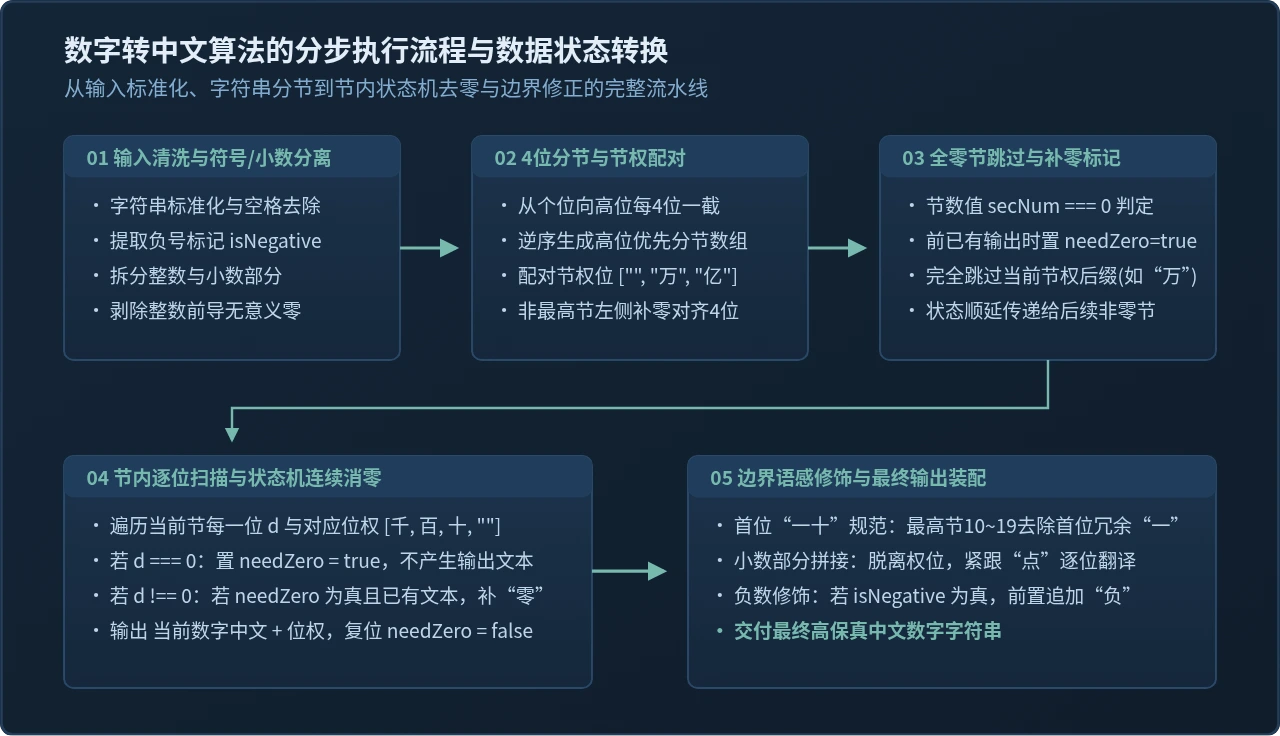
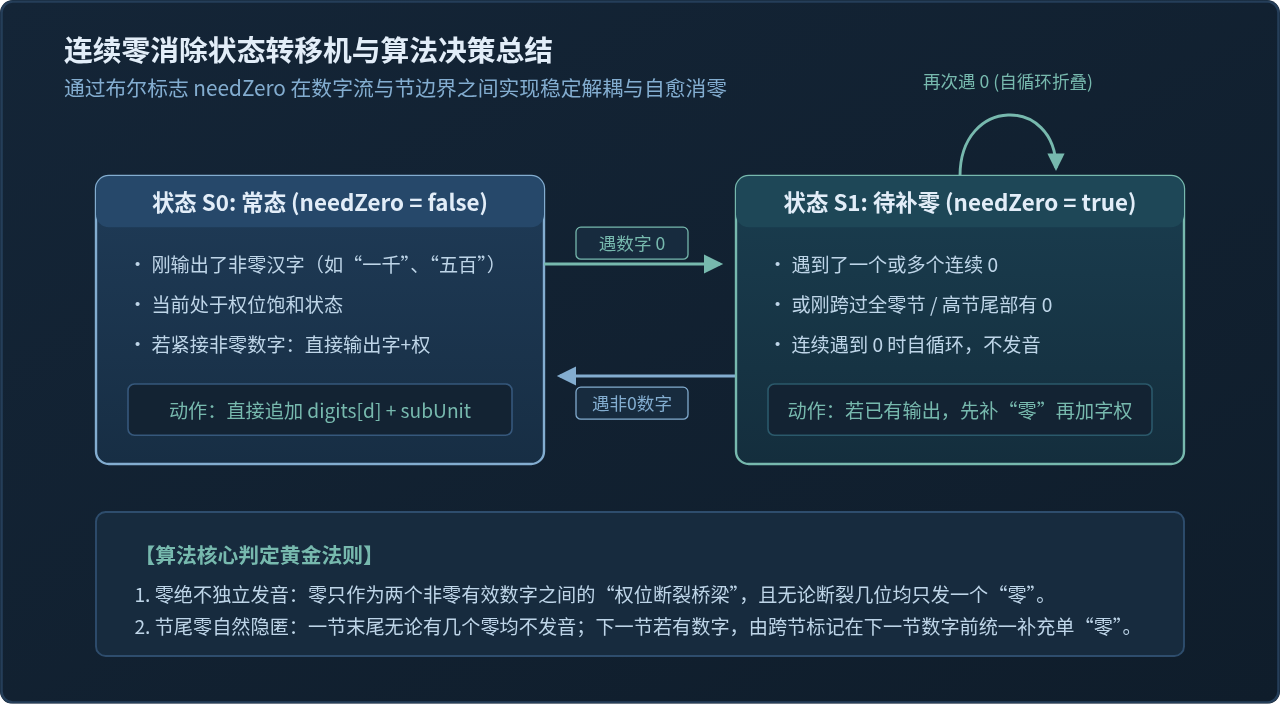
要让计算机稳定实现上述语言学规则,最清晰优雅的架构是:自低向高分节、自高向低扫描、使用布尔标志 needZero 跟踪待补零状态。整个转换逻辑被划分为五个明确的流水线步骤:
步骤一:输入清洗与数据分离
首先将输入参数统一转为字符串并剔除首尾空白,利用正则表达式 /^-?\d+(\.\d+)?$/ 校验其数字合法性。若带有负号,提取负数标记 isNegative = true 并截去符号。随后以小数点 . 为界切分出整数部分和小数部分,使用正则 /^0+/ 剥离整数部分前导无意义的零。若整数部分被全剥空(如原始输入为 "000"),则回退保底为 "0"。
步骤二:4位万进分节与权重配对
从整数部分末尾(最低位个级)开始,以4位为一组向前切片。例如对于 "100050",从末尾切出 "0050"(个级),剩余 "10"(万级)。将切分出的分节数组反转,使其变为从最高节到最低节的遍历顺序。分节索引天然对应了节权后缀数组 ["", "万", "亿", "兆"]。
步骤三:高位优先的节遍历与全零节处理
为了精确比对节内“千、百、十、个”的位置,除了最高节可能不足4位之外,其余所有较低分节都必须使用 padStart(4, '0') 补齐为标准的4字符字符串(如 "50" 补为 "0050")。
当判定 parseInt(secStr, 10) === 0 时,表明该节是全零节。只要之前已经输出了高位内容,就必须将 needZero 置为 true,同时不输出该节的节权词,直接 continue 跳过该节。
步骤四:节内逐位扫描与状态机连续消零
在非零分节内部,从左至右遍历每一个数字 d 及其对应的位权 ["千", "百", "十", ""]:
- 如果
d === 0:说明碰到了零,不产生即时输出,仅将needZero标记置为true。如果后续继续碰到0,needZero保持为true,多余的零自然被折叠压缩。 - 如果
d !== 0:说明遇到了非零数字。此时检查:若needZero为true且之前已有输出文本,则先追加一个汉字“零”,随后立即将needZero重置为false。紧接着追加当前数字的汉字及其位权(例如“五”加“百”)。
步骤五:特殊语感修饰与装配交付
节遍历结束后,检查首位读音:如果整个整数的最高节数值在 10 到 19 之间(例如 14),生成的文本为“一十四”,按照中文习惯应截去开头的“一”简化为“十四”。对于小数部分,脱离位权系统直接逐位查表拼接;若包含负号,在最前面追加“负”字即可。
关键边界情况的针对性处理
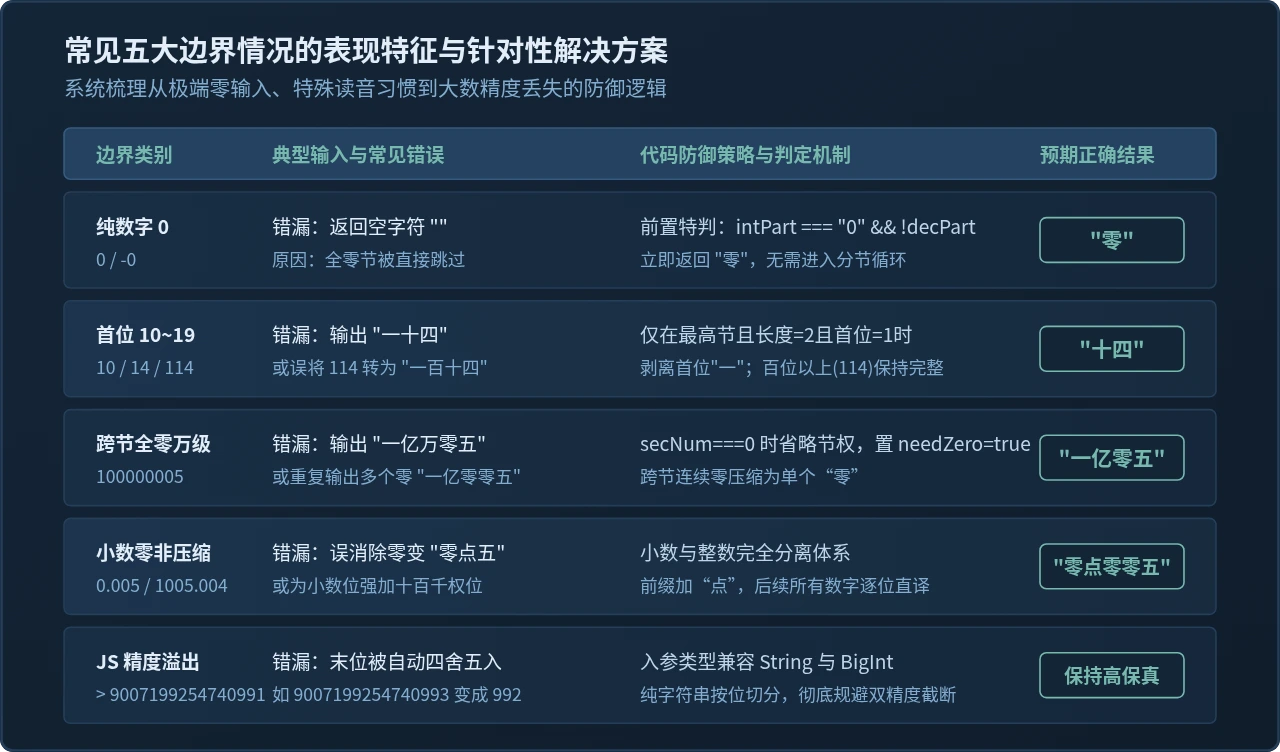
数字转中文涉及许多容易产生边缘缺陷的特殊分支。一个健壮的生产级函数必须对以下五种边界进行针对性拦截:
边界 1:纯数字 0 与 -0 的前置特判
如果直接进入分节循环,数字 0 的分节数值为0,会被全零节逻辑跳过,导致最终返回空字符串 ""。因此必须在分节前进行拦截:当整数部分清洗后为 "0" 且不存在小数部分时,直接根据正负标记返回 "零"。
边界 2:10~19 首位“一”的口语习惯规范
在中文表达中,开头的 14 读作“十四”而非“一十四”;但是在数字内部时,该“一”绝不能省略,例如 114 必须读作“一百一十四”,100014 读作“十万零一十四”。因此,代码中剥离“一”的判定条件必须极其严谨:仅当当前节为全局最高节、且该节原始长度恰好为2且以“1”开头时(即 idx === 0 && secStr.length === 2 && secStr[0] === '1'),才执行 secResult = secResult.slice(1)。
边界 3:跨“亿”级别的全零“万”节穿透
像 100000005 这样亿位和个位之间跨越了整个“万级”的数字,万级分节为 "0000"。如果程序盲目给每个节追加节权,就会拼出“一亿万零五”;如果每个节各自独立补零,就会拼出“一亿零零五”。通过将 needZero 提升到外层节循环共享,全零节跳过节权并保持 needZero = true,当且仅当个级的“五”出现时才由全局状态统一补上唯一的“零”,从而彻底规避重复。
边界 4:小数部分非压缩朗读
很多人误将整数的权位消零逻辑套用到小数部分,导致 0.005 被错误转换或丢掉中间的零。在中文规范中,小数部分必须在“点”之后按数字逐位直接念出,连续的零每一个都代表一位精度,必须原样保留。例如 1005.004 读作“一千零五点零零四”,前部的 00 在整数中被压缩,而后部的 00 在小数中完整保留。
边界 5:JavaScript 浮点大数精度安全上限
JavaScript 的基础 Number 类型采用 IEEE 754 双精度浮点数存储,其安全整数上限为 Number.MAX_SAFE_INTEGER(即 9007199254740991,共16位)。超过此范围的数字如果作为数值类型传入,在进入函数前就会被底层静默截断(例如 9007199254740993 会变成 9007199254740992)。因此生产级函数入参必须支持直接传入 string 或 BigInt,并在内部全流程基于字符串切片操作,以确保超大整数的高保真转换。
完整可运行的 JavaScript 实现方案
以下是凝聚了上述万进分节体系、单零状态机与边界防护的完整实现代码。该实现不依赖任何第三方库,兼容 Node.js 与主流浏览器环境:
/**
 * 将数字或数字字符串转换为标准中文读法
 * 支持处理连续零、大数分节、首位十优化、负数与小数
 * @param {number|string|bigint} input - 待转换的数值或字符串
 * @returns {string} 转换后的中文文本
 */
function numberToChinese(input) {
  if (input === null || input === undefined || input === '') {
    return '';
  }

  // 统一规整为字符串并去除首尾空格
  let str = String(input).trim();

  // 校验输入格式:支持可选负号、纯整数或浮点小数
  if (!/^-?\d+(\.\d+)?$/.test(str)) {
    throw new TypeError(`[numberToChinese] 无效的数字格式: "${input}"`);
  }

  // 提取负数标记
  let isNegative = false;
  if (str.startsWith('-')) {
    isNegative = true;
    str = str.slice(1);
  }

  // 拆分整数与小数部分
  let [integerPart, decimalPart = ''] = str.split('.');

  // 剔除整数部分前导无意义的零
  integerPart = integerPart.replace(/^0+/, '');
  if (!integerPart) {
    integerPart = '0';
  }

  // 汉字数字与位权字典
  const DIGITS = ['零', '一', '二', '三', '四', '五', '六', '七', '八', '九'];
  const SUB_UNITS = ['', '十', '百', '千'];
  const SECTION_UNITS = ['', '万', '亿', '兆'];

  // 边界 1:纯数字 0 的特判
  if (integerPart === '0' && !decimalPart) {
    return '零';
  }

  // 步骤二:4位一组从低到高切分整数部分
  const sections = [];
  for (let i = integerPart.length; i > 0; i -= 4) {
    sections.push(integerPart.slice(Math.max(0, i - 4), i));
  }

  const totalSections = sections.length;
  let integerChinese = '';
  let needZero = false; // 跨节与节内连续零的共享追踪标记

  // 如果整数部分本身就是 0,但带小数(如 0.05),整数部分记为“零”
  if (integerPart === '0') {
    integerChinese = '零';
  } else {
    // 步骤三:从最高节开始向下遍历
    for (let i = totalSections - 1; i >= 0; i--) {
      const secStr = sections[i];
      const secNum = parseInt(secStr, 10);
      const secUnit = SECTION_UNITS[i] || '';

      // 遇到全零节(如 100000005 中的万级 0000)
      if (secNum === 0) {
        if (integerChinese) {
          needZero = true; // 向低位传递补零需求,但跳过节权词
        }
        continue;
      }

      // 非最高节左侧补齐至4位,便于精确对齐千百十个各个位权
      const padded = i < totalSections - 1 ? secStr.padStart(4, '0') : secStr;
      const pLen = padded.length;
      let secChinese = '';

      // 步骤四:节内逐位扫描与状态机去零
      for (let j = 0; j < pLen; j++) {
        const digit = parseInt(padded[j], 10);
        const subUnit = SUB_UNITS[pLen - 1 - j];

        if (digit === 0) {
          needZero = true;
        } else {
          // 遇非零数字,根据状态机判断是否需要补单个“零”
          if (needZero && integerChinese) {
            integerChinese += '零';
            needZero = false;
          } else if (needZero && secChinese) {
            secChinese += '零';
            needZero = false;
          } else {
            needZero = false;
          }
          secChinese += DIGITS[digit] + subUnit;
        }
      }

      // 边界 2:首位 10~19 时去除冗余的“一”(如 14 -> "十四",但 114 -> "一百一十四")
      if (i === totalSections - 1 && secStr.length === 2 && secStr[0] === '1') {
        secChinese = secChinese.slice(1);
      }

      integerChinese += secChinese + secUnit;
    }
  }

  // 拼接最终结果
  let finalResult = integerChinese;

  // 边界 4:小数部分逐位直译
  if (decimalPart) {
    finalResult += '点';
    for (let i = 0; i < decimalPart.length; i++) {
      finalResult += DIGITS[parseInt(decimalPart[i], 10)];
    }
  }

  // 负数前缀修饰
  if (isNegative) {
    finalResult = '负' + finalResult;
  }

  return finalResult;
}
测试用例与验证结果对比表
为了验证上述实现的准确性,下表列出了涵盖常见数字、连续多零、全零节跳跃、小数以及超大整数的验证数据:
| 测试输入 | 测试类型 | 算法输出结果 | 验证说明 | 状态 |
|---|---|---|---|---|
0 / -0 |
纯零与符号 | 零 |
前置拦截,不进入分节循环 | PASS |
10 / 14 |
首位十读法 | 十 / 十四 |
最高节去除冗余“一”字 | PASS |
114 |
非首位十读法 | 一百一十四 |
百位存在时完整保留“一十” | PASS |
1005 |
节内连续多零 | 一千零五 |
百位与十位两个零压缩为单个“零” | PASS |
1200 |
节末尾连续零 | 一千二百 |
节尾连续零自然隐去,不发音 | PASS |
100050 |
万级与个级衔接 | 十万零五十 |
万级末尾零与个级千位缺位平滑合并为单零 | PASS |
100000005 |
跨亿全零万节 | 一亿零五 |
万级0000完全省略节权,两节间仅补一个“零” | PASS |
100050000 |
跨亿非全零万节 | 一亿零五万 |
万级有效数字保留“万”字,个级全零自然隐去 | PASS |
0.05 |
纯小数连续零 | 零点零五 |
整数补“零”,小数位保留连续零精度 | PASS |
1005.004 |
带小数混合型 | 一千零五点零零四 |
整数部分执行分节消零,小数部分逐位保留零 | PASS |
-1005 |
负数转换 | 负一千零五 |
前置拼接“负”字 | PASS |
"1000000000000" |
兆级大数 | 一兆 |
万进制顺利递进至兆位 | PASS |
总结与边界速查清单
在 JavaScript 中处理数字转中文的核心,在于摆脱对单一数字映射的简单思维,建立**“分节位权”与“动态状态机”**的双层处理模型。总结起来,只要牢记以下三条黄金法则,即可避开所有的连续零与边界陷阱:
- 万进分节是根基:必须严格按照从低到高4位分节,非最高分节必须使用
padStart(4, '0')补足4位,位权计算才能分毫不差。 - 零只作连接桥梁:零绝不能独立发音。节内连续零、节末尾零以及跨节全零,本质上都是数字流中的“中断”,通过一个布尔变量
needZero延迟到下一个非零数字出现时,最多仅输出一个“零”。 - 输入隔离与分治:正负号、整数部分、小数部分遵循完全不同的读数逻辑。将它们在入口处严格拆解,分别处理后再进行装配,能够最大程度降低函数的圈复杂度,杜绝边界死角。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章