
深入解析JavaScript中原地合并数组以降低GC开销与内存分配的核心技术,全面对比push.apply展开与经典for循环、分块合并的机制、性能差异与调用栈安全边界。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS怎么原地合并数组以提升性能?push.apply与循环方案
作者:安全边界
时间:2026-11-21
浏览:360
文章目录
分类:前端性能优化 / JavaScript底层机制
适用环境:Node.js / 现代浏览器 (V8, JSC, SpiderMonkey)
在 JavaScript 中合并两个数组时,最直观的
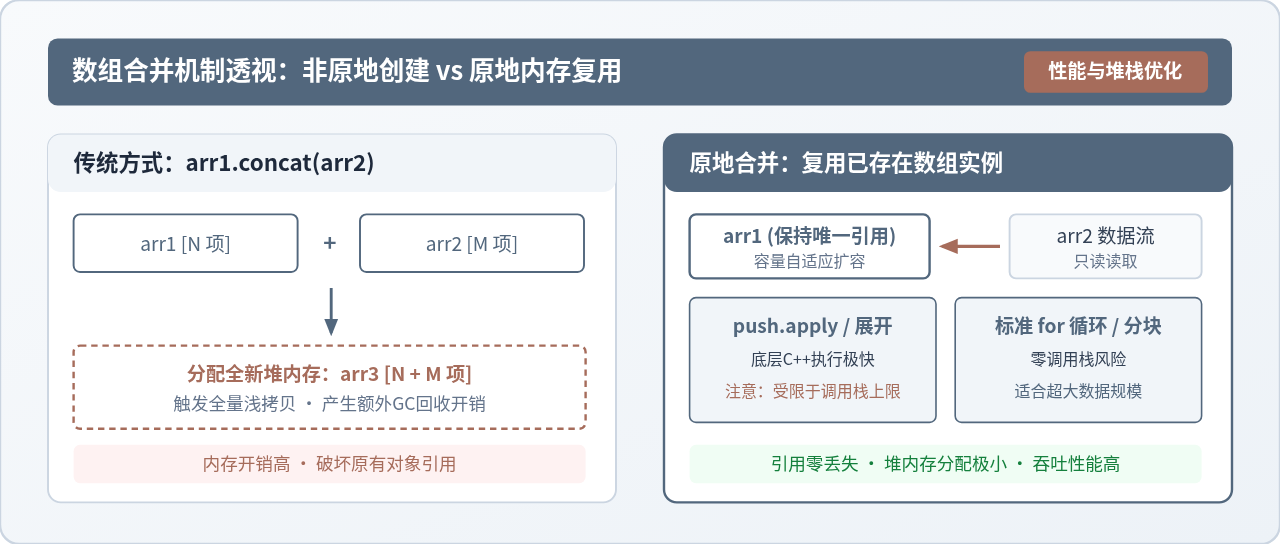
concat 或解构扩展语法 [...a, ...b] 都会在堆内存中重新开辟空间并创建全新数组,不仅增加内存分配开销,还会加重垃圾回收(GC)负担。若要在保留已有数组引用的同时实现原地合并以提升性能,主要依靠以首个数组为宿主就地追加元素:在中小数据量时借助 Array.prototype.push.apply 利用引擎内置的原生调用展开追加;当面对未知规模或大规模数组时,则需采用传统的 for 循环或者分块追加策略,避免触发 JavaScript 引擎的调用栈溢出。
从一个容易被忽略的内存抖动现象切入
在前端处理实时数据流、分页长列表渲染,或者 Node.js 批量拉取日志做数据聚合时,开发者经常会写出如下代码:
// 常见的非原地合并写法
let result = [];
for (const batch of dataBatches) {
  result = result.concat(batch); // 或者 result = [...result, ...batch];
}
当批次较少、数据量只有几十或几百项时,这段代码运行得毫无波澜。然而一旦数据量上升到数万级别,或者该合并操作在动画帧循环与高频事件处理函数中重复执行,页面的帧率便会突然掉帧,Node.js 进程也会频繁出现 CPU 占用率忽高忽低的时延抖动。
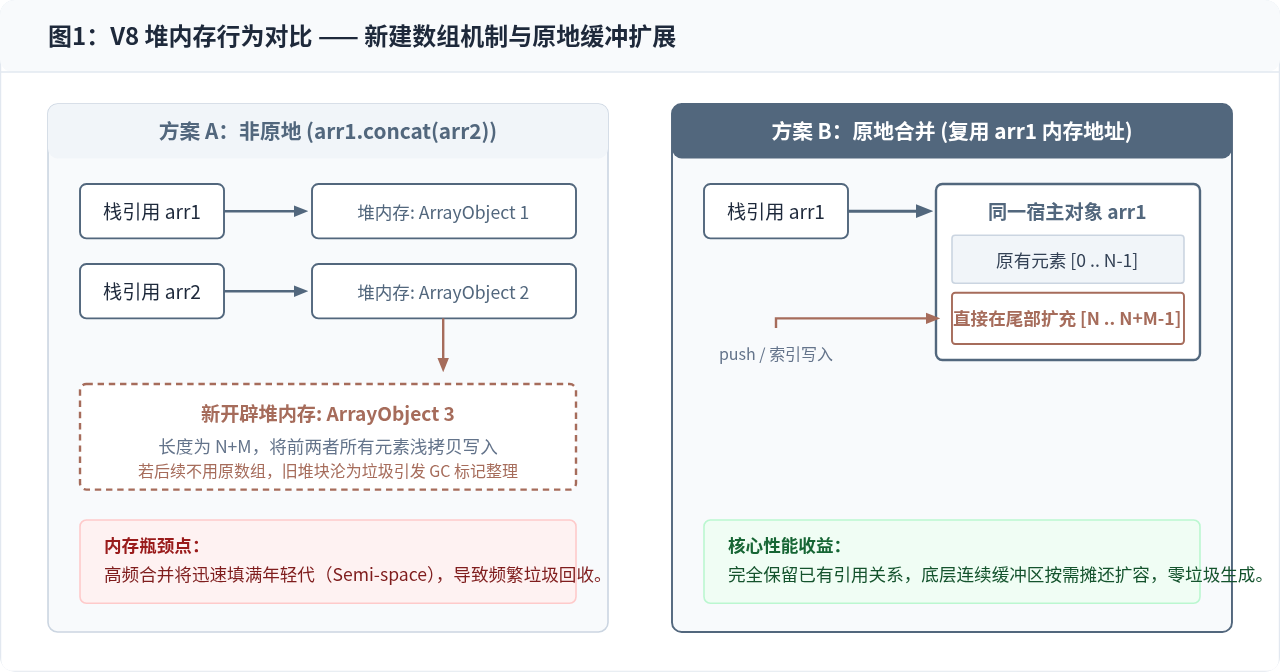
产生这一现象的根本原因并不在于逻辑复杂度,而在于内存分配与引用的不断抛弃。每次执行 concat 或展开语法,JavaScript 引擎都需要在堆内存里申请一块足以容纳两个数组长度总和的新空间,将元素逐个复制到新数组中,随后将旧数组实例丢弃。这些被丢弃的中间对象会迅速塞满 V8 引擎的新生代内存(New Space),频繁触发清除垃圾(Scavenge GC)甚至全局标记整理(Full GC),导致程序出现肉眼可见的卡顿。
方案一:push.apply 的原地追加机制与速度优势
如果既要保留对目标数组 arr1 的现有引用地址(例如该数组已被组件状态或外部上下文持有),又要避免分配第三个多余的临时数组,最典型的做法就是直接调用 Array.prototype.push。
然而原生的 push() 接收的是逗号分隔的单项参数列表(push(item1, item2, ...)),而非一个完整的数组。在 ES5 时代,JavaScript 提供了 Function.prototype.apply,其核心功能就是指定函数内部的 this 指向,并将传入的数组作为参数列表解构成独立形参传递给目标函数:
const target = [1, 2, 3];
const source = [4, 5, 6];

// 将 target 作为 this 传入,source 作为参数数组解构
Array.prototype.push.apply(target, source);

console.log(target); // [1, 2, 3, 4, 5, 6]
console.log(target.length); // 6,原数组实例被直接修改
在现代 ES6+ 语法中,许多人习惯写成扩展运算符形式 target.push(...source)。需要明确的是,从底层语义来看,target.push(...source) 与 Array.prototype.push.apply(target, source) 在参数传递上几乎是一致的,都是将整个 source 数组一次性解构为函数的调用形参。
为什么它在中小规模下速度极快?因为 push.apply 的参数解构与数组扩容完全在引擎底层的 C++ 原生循环中执行,省去了 JavaScript 脚本层的解释执行损耗。对于长度在几千以内的常规业务数组,这种写法不仅代码简练,而且执行速度通常显著快于手动手写的非优化循环。
方案一的致命缺陷:调用栈溢出(RangeError)
尽管 push.apply 在视觉上非常优雅,但很多系统在平稳运行几个月后突然线上崩溃,罪魁祸首往往就是它。
JavaScript 的函数调用依赖调用栈(Call Stack)。当使用 apply 或展开运算符 ... 将一个数组传递给函数时,引擎必须在调用栈帧中开辟连续的形参寄存器或栈槽(Stack Slots)来存放这批参数。然而,函数调用栈的物理深度与单次调用的参数数量有着严格的引擎限制。
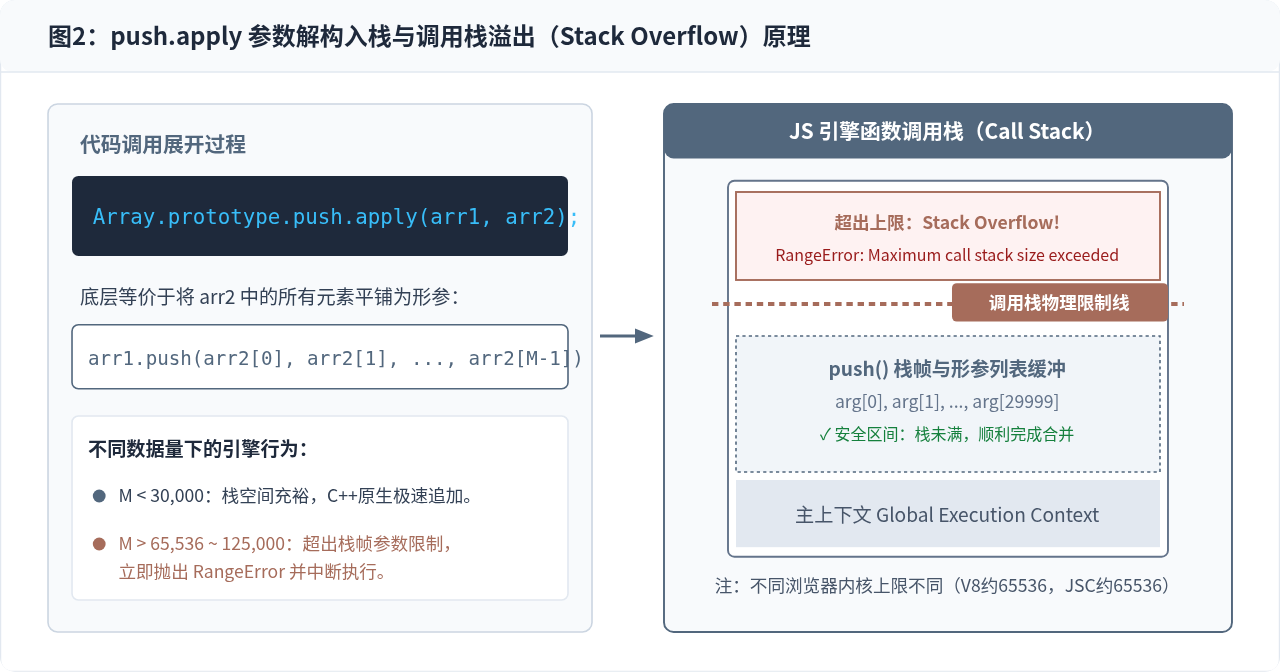
可以通过一个极简的片段来观察这个物理边界:
const target = [];
const source = new Array(130000).fill(1);

try {
  // 尝试将 13 万项通过 apply 压入栈帧
  Array.prototype.push.apply(target, source);
} catch (err) {
  console.error(err);
  // 输出示例: RangeError: Maximum call stack size exceeded
}
特别提醒:在主流 JavaScript 引擎中,单次调用的形参上限并不统一。V8 引擎通常在 65,536 项附近触发栈边界检测,在某些特定架构或旧版 Node.js 中甚至在更小的数值就会抛错;Safari 的 JavaScriptCore 引擎也有类似的硬限制。因此,凡是数组长度不可控、来自于外部接口或用户上传文件的场景,坚决不能直接使用 push.apply 或 push(...arr)!
方案二:极简且零风险的传统 for 循环
当数据规模突破数万甚至达到百万级别,或者数组长度在运行时不可预测时,最朴素的 for 循环反而是最稳健、吞吐能力最强的工程解法。
function mergeInPlaceLoop(target, source) {
  const sourceLen = source.length;
  for (let i = 0; i < sourceLen; i++) {
    target.push(source[i]);
  }
  return target;
}
许多开发者初看会觉得逐个 push 显得笨重,但从运行时原理剖析,它具备三个关键优势:
- 零栈深压力:每次循环调用
push只压入一个参数,执行完即刻出栈,调用栈深度恒定为 1,哪怕合并 10,000,000 个元素也绝对不会发生栈溢出。 - 现代 JIT 优化极高:现代 V8 引擎的 TurboFan 编译器会对这种标准的单态(Monomorphic)数组迭代进行极致内联(Inlining),循环体甚至会被直接编译成高效的本地汇编指令,性能损耗极其轻微。
- 内存扩容摊还复杂度为 O(1):虽然随着元素增多
target会发生底层数组缓冲区的重新分配,但 V8 内部采用了倍增策略(Amortized doubling),扩容次数对数级递减,整体时间复杂度保持在坚实的 O(N)。
如果希望进一步榨取性能,还可以利用目标数组的既有长度直接基于索引赋值,避免反复执行 push 函数调用:
function mergeInPlaceFastIndex(target, source) {
  const targetLen = target.length;
  const sourceLen = source.length;
  for (let i = 0; i < sourceLen; i++) {
    target[targetLen + i] = source[i];
  }
  return target;
}
方案三:兼顾速度与安全的折中方案——分块批量合并(Chunking)
有些对性能极致敏感的大型应用既想利用 push.apply 底层原生 C++ 的高吞吐速度,又必须防止超长数组击穿调用栈。这时可以引入分块(Chunking)策略,将超长来源数组拆分为安全规格的小批次(如每批 10,000 到 20,000 项),分段调用 push.apply:
function mergeInPlaceChunked(target, source, chunkSize = 10000) {
  const len = source.length;
  for (let i = 0; i < len; i += chunkSize) {
    // 利用 slice 获取安全范围内的子数组,再由 apply 展开
    Array.prototype.push.apply(
      target,
      source.slice(i, i + chunkSize)
    );
  }
  return target;
}
虽然 source.slice() 会产生临时的浅拷贝分块数组,但由于单块体积小且生命周期极短,只在新生代内存的幼年区闪烁即逝,不会造成全局 GC 阻塞,整体性能在大体量数据下表现非常亮眼。
工程选型与性能权衡指南
在实际代码评审与架构落地过程中,不要盲目迷信单一句法的绝对优越,而应结合调用频率、数据规模确定性以及代码可维护性进行选择。
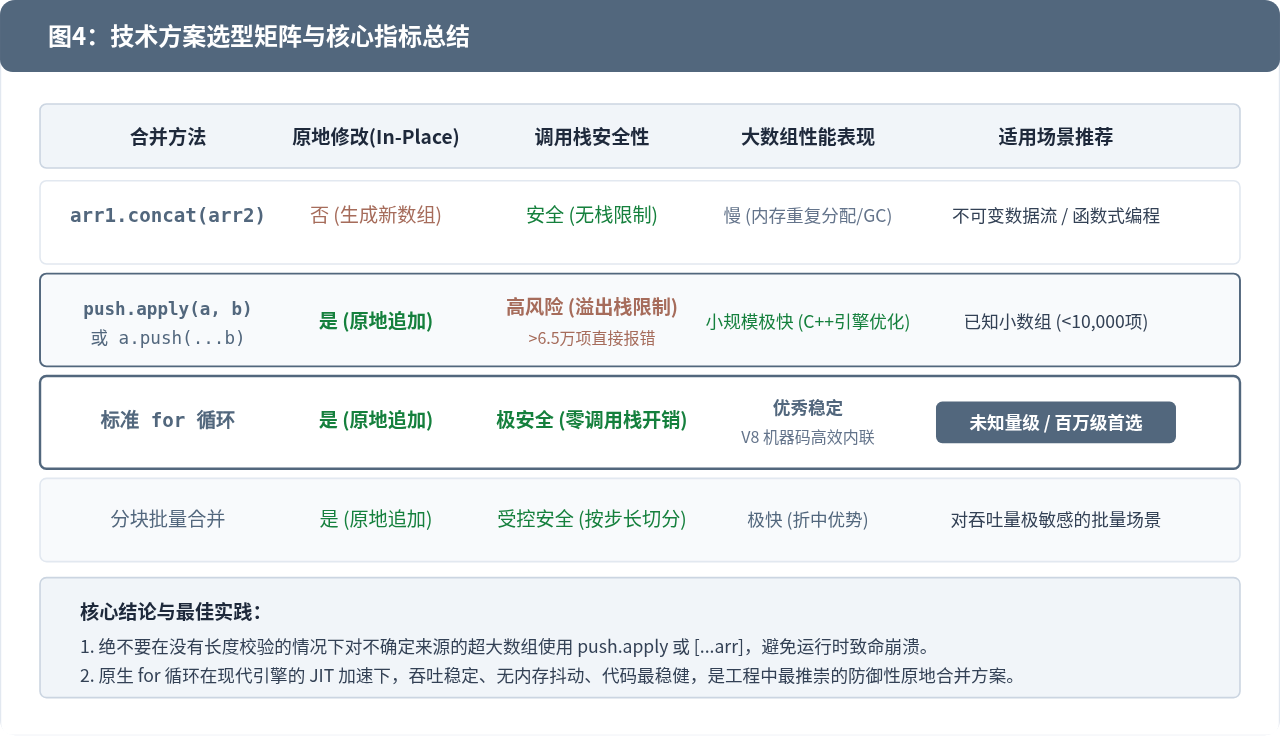
选型实践总结:
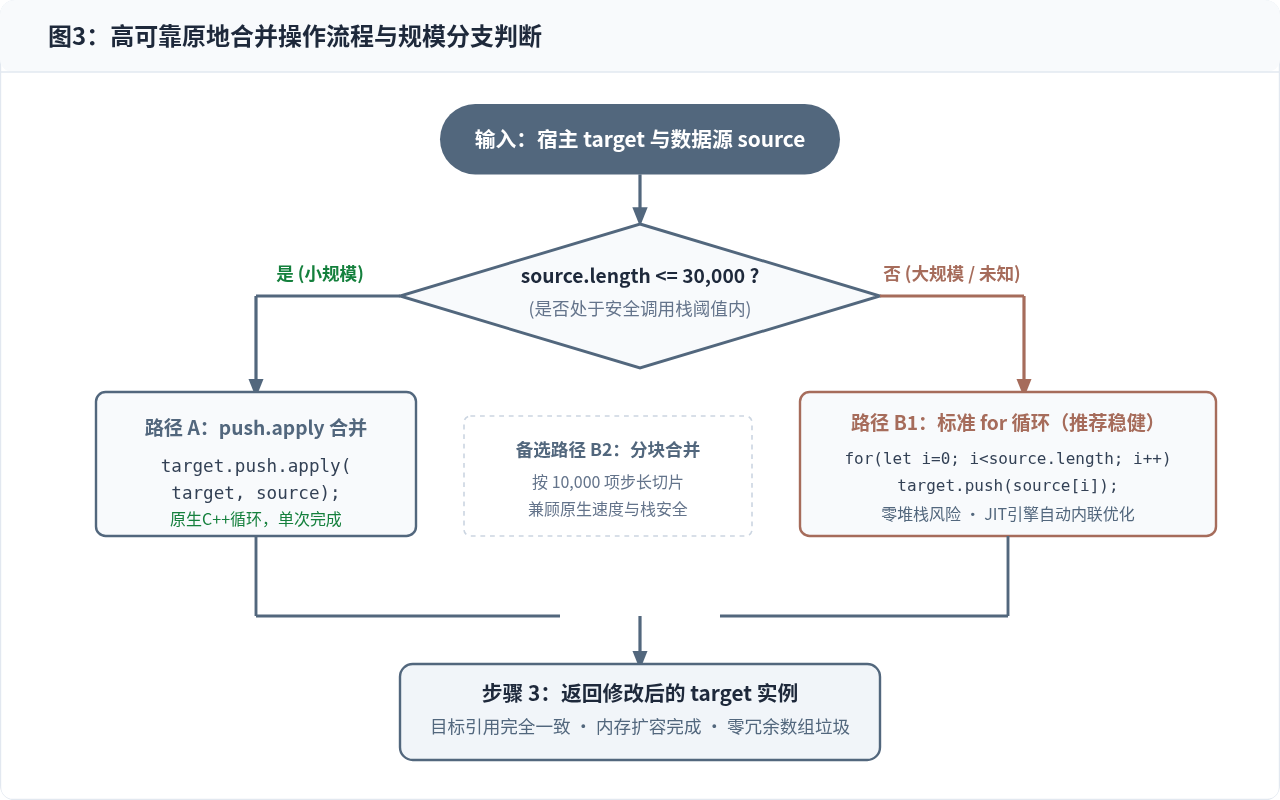
- 日常小数组(长度稳定 < 5,000 项):直接使用
target.push(...source)或Array.prototype.push.apply(target, source),代码表达力最强,原生执行快。 - 未知来源、动态输入或数据量可能突破万级:坚决采用标准
for循环,零栈溢出隐患,杜绝一切隐蔽的运行时崩溃风险。 - 不可变状态更新(如 React / Redux 驱动):若架构本身要求引用更新触发视图重绘,则应规范使用
concat或展开语法,但务必控制高频触发点。
通过在源头控制内存对象的创建与抛弃,不仅能让数组合并操作本身的执行速度显著提升,更能在全局层面上避免垃圾回收器频繁介入导致的卡顿,让应用在长时间运行与高并发吞吐场景下保持平稳流畅。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章