
深入解析在 Node.js 中使用 crypto-js 处理大文件加密的核心挑战。通过分析 V8 堆内存溢出原因,给出基于 CryptoJS.algo 的分块流式加密完整方案,涵盖 WordArray 转换、IV 头部注入、背压治理、解密验证与技术选型权衡。

当前位置:首页 > Node.js 性能优化 > 正文
Node.js 中使用 crypto-js 加密大文件的最佳实践
作者:霁月
时间:2026-11-05
浏览:221
文章目录
Node.js 架构与流式安全
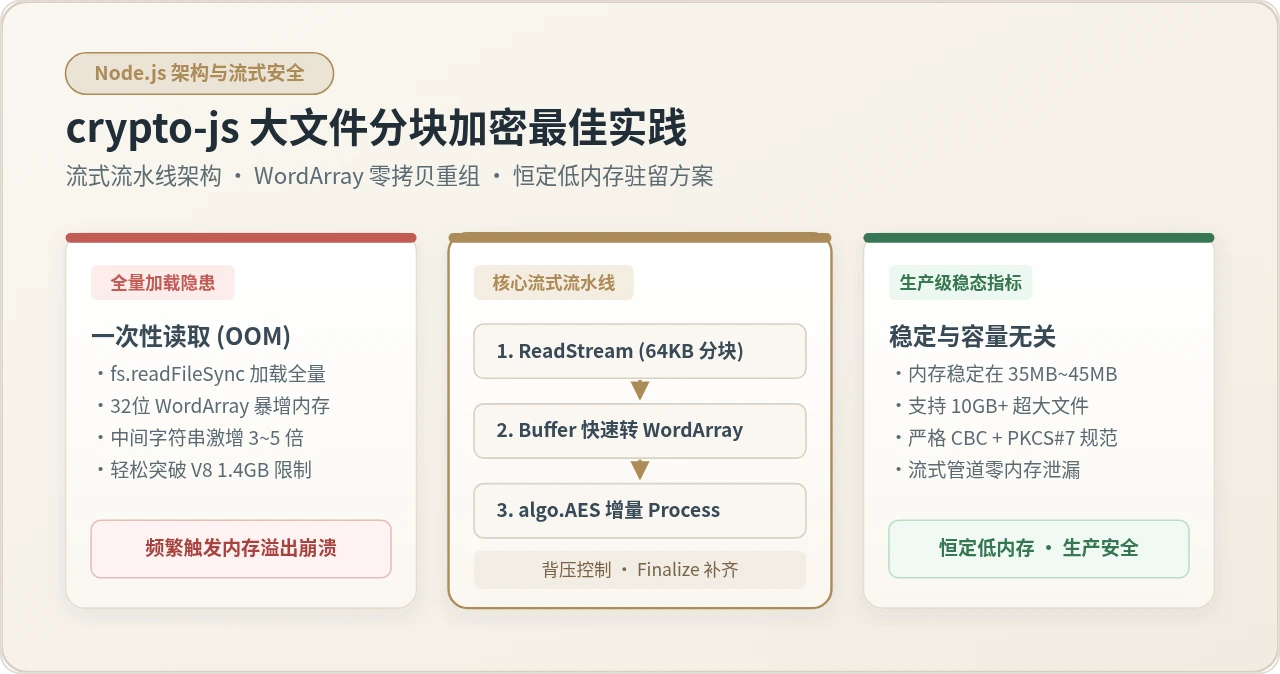
图 0:Node.js × crypto-js 大文件分块流式加密全景架构与指标概览
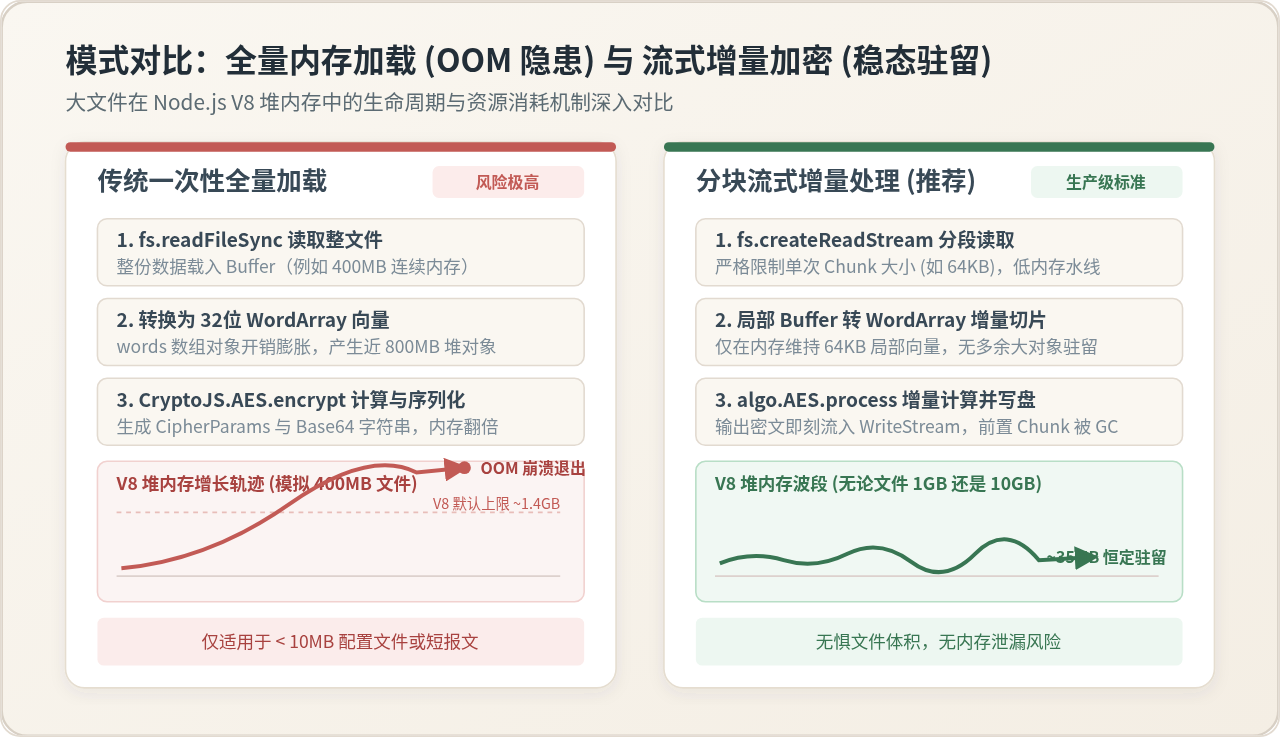
图 1:全量内存加载 (OOM 隐患) 与 流式增量加密 (稳态驻留) 内存模型对比
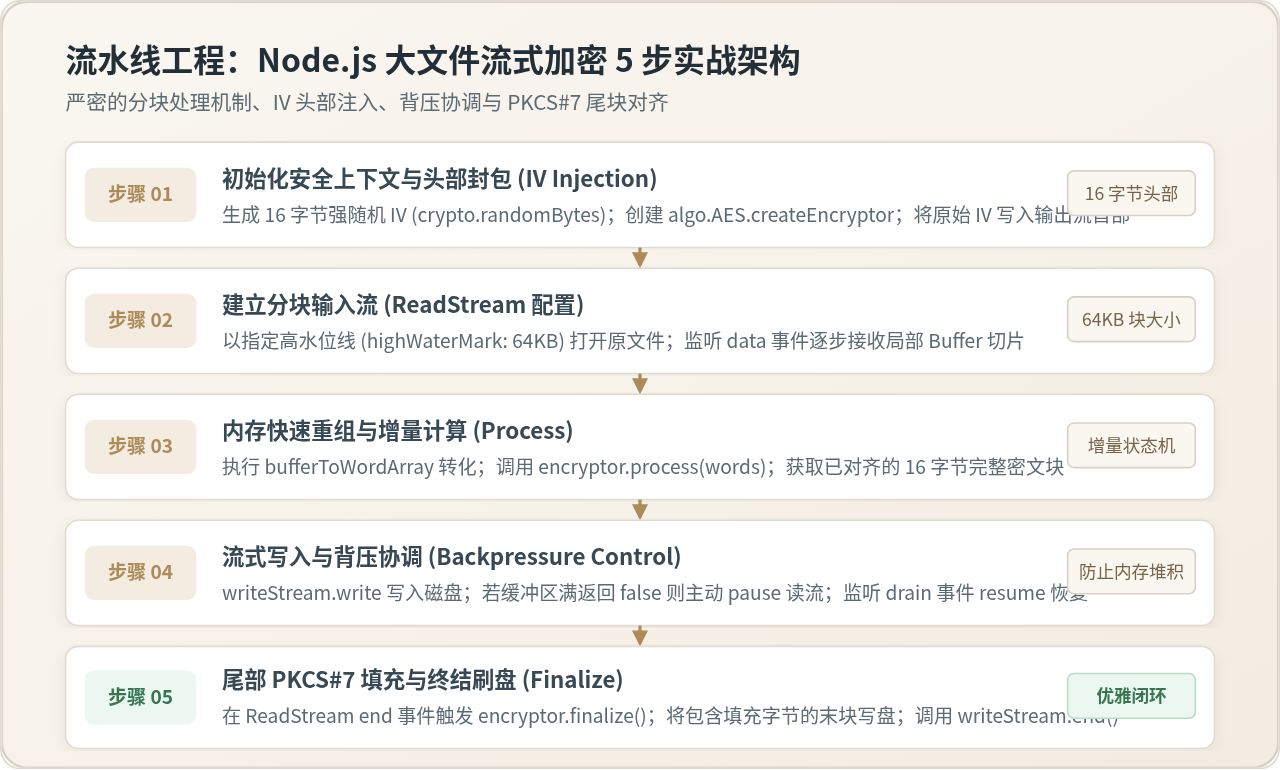
图 2:Node.js 大文件流式加密 5 步流水线工程架构
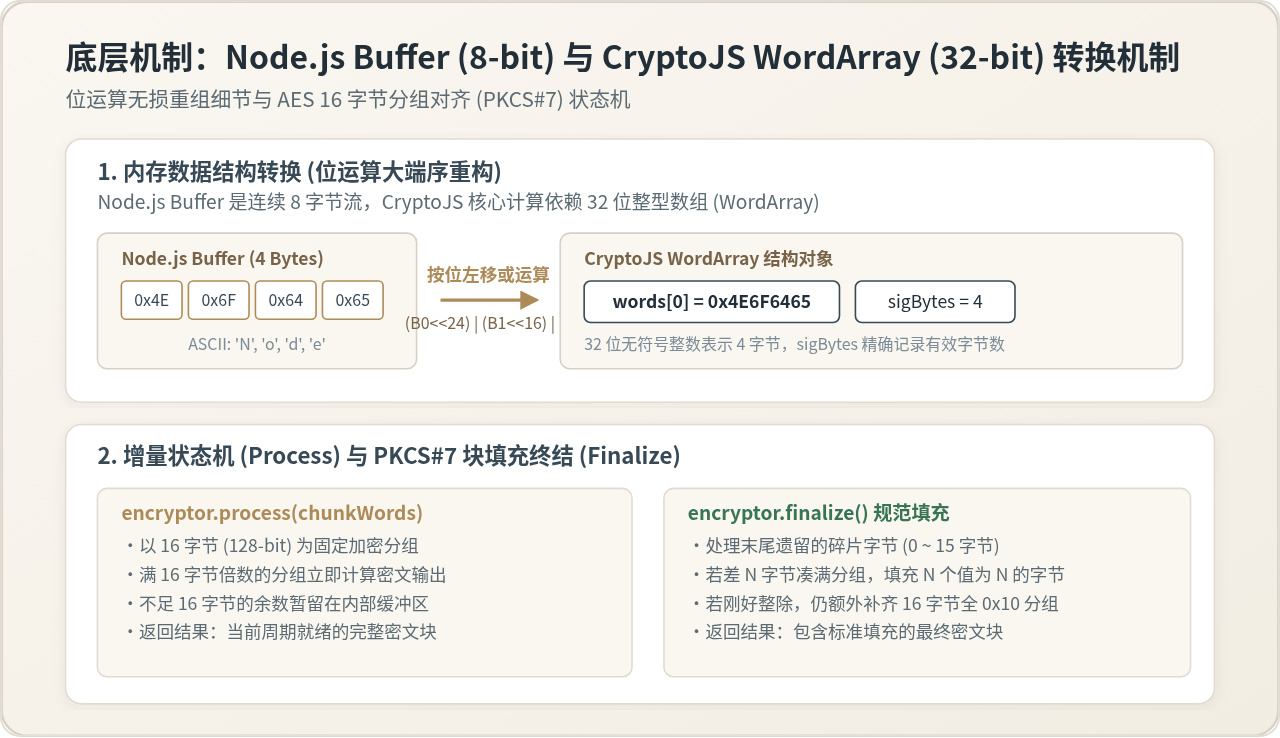
图 3:Buffer 字节流与 WordArray 32位字向量内存转换及 PKCS#7 填充原理
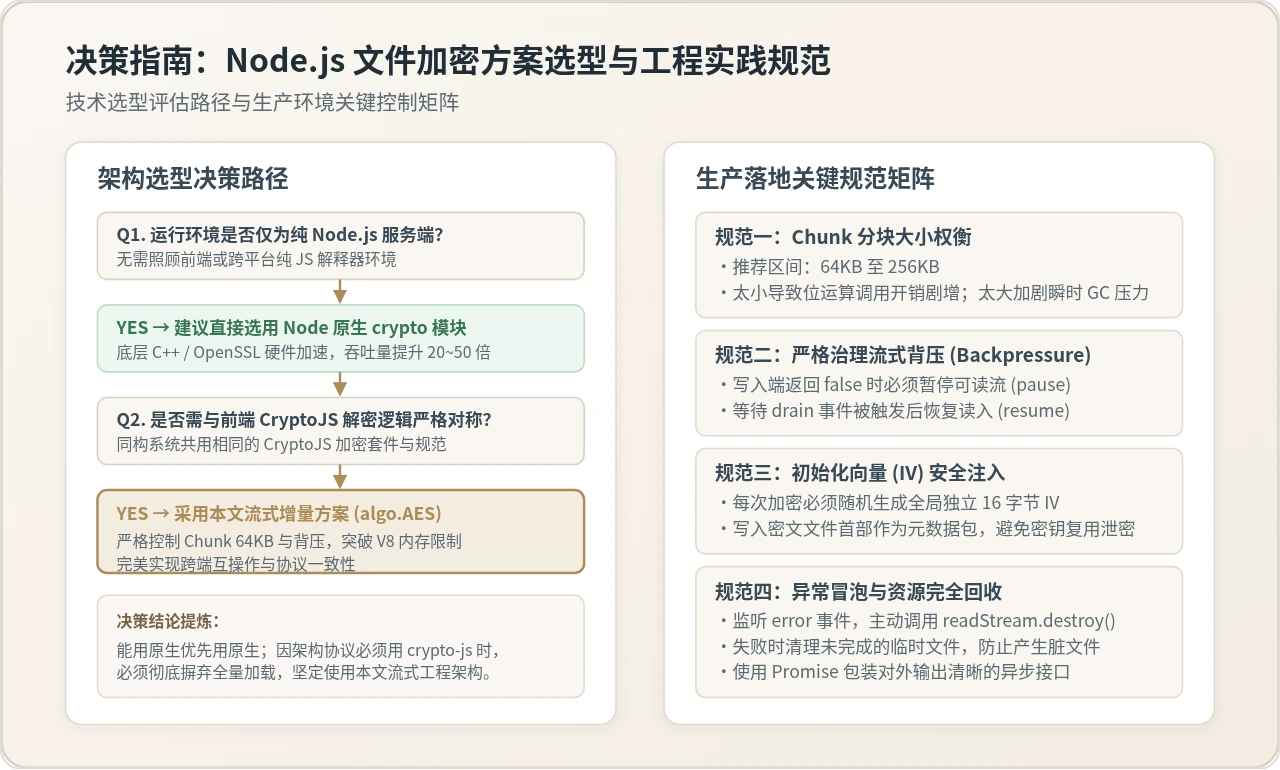
图 4:Node.js 大文件加密技术选型决策树与工程落地规范矩阵
在 Node.js 中使用
crypto-js 对大文件进行加密时,最核心的瓶颈是内存溢出(OOM)与 WordArray 对象的内存暴增。解决这个问题的核心最佳实践是:基于 Node.js 的 fs.createReadStream,采用 CryptoJS.algo.AES.createEncryptor 提供的流式增量接口分块处理(推荐 64KB Chunk),在头部安全注入随机 IV,结合流式背压机制实时写出密文并由 V8 回收前置内存。
一、大文件加密的瓶颈:为什么常规方式会崩溃
初次使用 crypto-js 的开发者,通常会沿用处理短文本的惯性写法:使用 fs.readFileSync 一次性读取目标文件为 Buffer,将其转为字符串或直接传入 CryptoJS.AES.encrypt()。对于几十 KB 或几 MB 的小型配置文件,这种方式简单直接且能正常运作。然而,当文件体量增长到几百兆字节或上吉字节(GB)时,程序会毫无征兆地瞬时崩溃,抛出 Node.js 开发者极其熟悉的致命错误:
FATAL ERROR: Ineffective mark-compacts near heap limit Allocation failed - JavaScript heap out of memory
出现这种现象的原因,深植于 crypto-js 的内部架构与 V8 虚拟机的内存管理机制中:
-
32 位字向量(WordArray)膨胀:
crypto-js最初是为前端纯 JavaScript 环境设计的加密库,其底层所有算法均基于 32 位整数(Word)数组进行位运算。当我们将 Node.js 的原生Buffer(连续的单字节无符号整型数组)转换为CryptoJS.lib.WordArray时,V8 需要为每个元素创建 JavaScript 对象及外层封装,导致原本紧凑的原生堆外内存暴增为 2 到 3 倍的 JavaScript 堆对象。 -
中间密文字符串翻倍:
CryptoJS.AES.encrypt的默认输出是CipherParams对象。若调用其.toString()导出 Base64 或 Hex 密文,V8 需要在堆内分配一段极其巨大的连续 UTF-16 字符串内存。一个 500MB 的文件在加解密过程中,瞬时内存占用会轻松突破 2GB 至 3GB。 -
V8 堆内存上限约束:Node.js 在 64 位系统下默认分配给 V8 的最大堆内存通常在 1.4GB 至 2GB 左右(即便通过
--max-old-space-size人工调大,也只是延缓崩溃点,无法根治高并发与吉字节文件的内存吞噬)。
核心结论
严禁在 Node.js 中对大于 10MB 的文件执行
fs.readFileSync 配合 CryptoJS.AES.encrypt。要实现大文件的安全可靠加密,必须将“整包全量加载”重构为“分块流式(Streaming)增量加密”。
二、方案核心机制:基于 CryptoJS.algo 的增量加密
许多开发者误以为 crypto-js 只能做一次性加密。事实上,crypto-js 内部提供了底层的分块增量 API —— CryptoJS.algo.AES.createEncryptor。它是构建流式加密管道的灵魂核心。
增量加密状态机将加解密工作切分为两个阶段:
-
encryptor.process(wordArrayChunk):接收当前的一小块数据切片。AES 算法以 16 字节(128 位)为一个独立密码分组。process()会尽可能消化当前数据中能够凑满 16 字节整数倍的分组并立即输出对应密文;若切片末尾存在不足 16 字节的余数碎片,它会将碎片存放在内部轻量寄存器中,等待下一次process()输入时拼合。 -
encryptor.finalize():当整个文件所有数据切片全部灌入完成后调用。它会取出内部留存的最终碎片,按照密码学标准(默认是 PKCS#7)自动补齐填充字节,并完成最后一个分组的加密输出。
除了增量计算,大文件加密在协议设计上还必须解决初始化向量(IV)存储问题。在 AES-CBC 模式下,每次加密都必须生成全新的 16 字节强随机 IV,以确保相同明文不会生成相同的密文。由于解密端同样需要该 IV,最佳工程实践是:在加密流启动的第一时间,将这 16 字节原始 IV 率先写入目标文件头部(Header),随后紧跟连续的密文流。解密时只需率先切出前 16 字节作为 IV,即可完美还原解密器状态。
三、生产级代码实现:分块流式加密与背压控制
在编写具体实现前,需要解决 Node.js Buffer 与 CryptoJS.lib.WordArray 之间的高效互转问题。常规的 CryptoJS.enc.Hex.parse(buffer.toString('hex')) 会额外产生大量的中间字符串,对垃圾回收(GC)造成沉重负担。
最优雅的做法是通过32 位无符号字向量的位运算进行直接内存重组,避免产生任何临时十六进制字符串:
下面是生产级的大文件流式加密完整模块,代码中包含了严格的类型转换、背压监控(Backpressure Handling)以及完整的异常清理流:
/**
 * Node.js 大文件流式加密模块 (基于 crypto-js)
 * 依赖安装:npm install crypto-js
 */
const fs = require('fs');
const crypto = require('crypto'); // 用于生成系统级高强度随机 IV
const CryptoJS = require('crypto-js');

/**
 * 高性能将 Node.js Buffer 转换为 CryptoJS WordArray (零字符串中间分配)
 * @param {Buffer} buffer
 * @returns {CryptoJS.lib.WordArray}
 */
function bufferToWordArray(buffer) {
  const len = buffer.length;
  const words = [];
  for (let i = 0; i < len; i += 4) {
    // 将连续 4 个 8-bit Byte 拼接为一个 32-bit 大端序整数
    words.push(
      ((buffer[i] || 0) << 24) |
      ((buffer[i + 1] || 0) << 16) |
      ((buffer[i + 2] || 0) << 8) |
      ((buffer[i + 3] || 0))
    );
  }
  return CryptoJS.lib.WordArray.create(words, len);
}

/**
 * 将 CryptoJS WordArray 转换为 Node.js Buffer
 * @param {CryptoJS.lib.WordArray} wordArray
 * @returns {Buffer}
 */
function wordArrayToBuffer(wordArray) {
  const { words, sigBytes } = wordArray;
  const buffer = Buffer.alloc(sigBytes);
  for (let i = 0; i < sigBytes; i++) {
    const byte = (words[i >>> 2] >>> (24 - (i % 4) * 8)) & 0xff;
    buffer[i] = byte;
  }
  return buffer;
}

/**
 * 大文件流式加密核心函数
 * @param {string} inputPath 源文件绝对路径
 * @param {string} outputPath 加密后输出文件路径
 * @param {string|Buffer} secretKey 密钥 (建议 256 位,即 32 字节)
 * @param {Object} options 配置项 (chunkSize: 默认 64KB)
 * @returns {Promise<void>}
 */
function encryptLargeFile(inputPath, outputPath, secretKey, options = {}) {
  const chunkSize = options.chunkSize || 64 * 1024; // 默认 64KB Chunk

  return new Promise((resolve, reject) => {
    // 1. 规范化密钥为 WordArray
    const keyBuffer = Buffer.isBuffer(secretKey) ? secretKey : Buffer.from(secretKey, 'utf8');
    const keyWords = bufferToWordArray(keyBuffer);

    // 2. 生成强安全随机 16 字节 IV 并封装为 WordArray
    const rawIV = crypto.randomBytes(16);
    const ivWords = bufferToWordArray(rawIV);

    // 3. 创建增量加密器状态机 (AES-256-CBC, PKCS#7 填充)
    const encryptor = CryptoJS.algo.AES.createEncryptor(keyWords, {
      iv: ivWords,
      mode: CryptoJS.mode.CBC,
      padding: CryptoJS.pad.Pkcs7
    });

    // 4. 开启文件输入输出流
    const readStream = fs.createReadStream(inputPath, { highWaterMark: chunkSize });
    const writeStream = fs.createWriteStream(outputPath);

    // 率先写入 16 字节 IV 头部
    writeStream.write(rawIV);

    // 5. 流事件与背压控制
    readStream.on('data', (chunk) => {
      // 局部切片转换与增量计算
      const chunkWords = bufferToWordArray(chunk);
      const encryptedWords = encryptor.process(chunkWords);
      const outputBuffer = wordArrayToBuffer(encryptedWords);

      // 写入磁盘流并进行背压控制 (Backpressure)
      if (outputBuffer.length > 0) {
        const canContinue = writeStream.write(outputBuffer);
        if (!canContinue) {
          readStream.pause();
          writeStream.once('drain', () => {
            readStream.resume();
          });
        }
      }
    });

    readStream.on('end', () => {
      // 6. 终结流:计算尾部 PKCS#7 填充块
      const finalWords = encryptor.finalize();
      const finalBuffer = wordArrayToBuffer(finalWords);

      if (finalBuffer.length > 0) {
        writeStream.write(finalBuffer);
      }

      writeStream.end();
    });

    writeStream.on('finish', () => {
      resolve();
    });

    // 异常防护与流销毁
    readStream.on('error', (err) => {
      writeStream.destroy();
      reject(err);
    });
    writeStream.on('error', (err) => {
      readStream.destroy();
      reject(err);
    });
  });
}
代码关键细节深度剖析
-
为何必须监听
drain背压?Node.js 的流如果读取速率(通常来自高速固态硬盘)远大于写入速率(或网络发送速率),底层 WriteStream 内部缓冲队列会持续堆积。如果不配合pause()和resume()实施背压控制,即使使用了分块,也会在内存缓冲区中堆积数万个未写入的 Chunk,再次诱发内存爆仓。 - Chunk 分块大小该如何选择?推荐设置在 64KB 到 256KB 之间。若设置过小(如 4KB),会导致 JavaScript 频繁进行函数调用和位运算循环,CPU 切换开销增大,显著拉低 I/O 吞吐;若设置过大(如 64MB),则单次垃圾回收的停留时间会拉长。64KB 是吞吐量与内存开销之间的经典平衡点。
四、流式解密与跨端互操作验证
加密与解密是不可分割的对称过程。大文件的解密同样必须遵循流式增量原则。需要注意的是,由于我们在加密时把 16 字节随机 IV 放置在了输出文件的头部,在解密时必须先从文件流中截获前 16 字节初始化解密器,再将后续字节流灌入 CryptoJS.algo.AES.createDecryptor。
/**
 * 大文件流式解密核心函数
 * @param {string} encryptedPath 密文文件路径
 * @param {string} outputPath 还原后的解密明文路径
 * @param {string|Buffer} secretKey 密钥 (与加密时保持完全一致)
 * @returns {Promise<void>}
 */
function decryptLargeFile(encryptedPath, outputPath, secretKey) {
  return new Promise((resolve, reject) => {
    const keyBuffer = Buffer.isBuffer(secretKey) ? secretKey : Buffer.from(secretKey, 'utf8');
    const keyWords = bufferToWordArray(keyBuffer);

    const readStream = fs.createReadStream(encryptedPath, { highWaterMark: 64 * 1024 });
    const writeStream = fs.createWriteStream(outputPath);

    let decryptor = null;
    let headerBuffer = Buffer.alloc(0);

    readStream.on('data', (chunk) => {
      let payloadChunk = chunk;

      // 1. 率先提取前 16 字节的 IV 头部
      if (!decryptor) {
        headerBuffer = Buffer.concat([headerBuffer, chunk]);
        if (headerBuffer.length < 16) {
          return; // 头部尚未收齐,等待下一次 chunk
        }

        const ivBuffer = headerBuffer.subarray(0, 16);
        const ivWords = bufferToWordArray(ivBuffer);

        // 初始化增量解密器
        decryptor = CryptoJS.algo.AES.createDecryptor(keyWords, {
          iv: ivWords,
          mode: CryptoJS.mode.CBC,
          padding: CryptoJS.pad.Pkcs7
        });

        // 截取 IV 之后的真实密文数据
        payloadChunk = headerBuffer.subarray(16);
        headerBuffer = null; // 释放引用
      }

      if (payloadChunk.length === 0) return;

      // 2. 增量解密计算
      const chunkWords = bufferToWordArray(payloadChunk);
      const decryptedWords = decryptor.process(chunkWords);
      const outBuf = wordArrayToBuffer(decryptedWords);

      if (outBuf.length > 0) {
        const canContinue = writeStream.write(outBuf);
        if (!canContinue) {
          readStream.pause();
          writeStream.once('drain', () => readStream.resume());
        }
      }
    });

    readStream.on('end', () => {
      if (!decryptor) {
        return reject(new Error('密文文件损坏:长度不足 16 字节头部'));
      }

      try {
        // 3. 终结解密:自动校验并剥除 PKCS#7 填充
        const finalWords = decryptor.finalize();
        const finalBuf = wordArrayToBuffer(finalWords);
        if (finalBuf.length > 0) {
          writeStream.write(finalBuf);
        }
        writeStream.end();
      } catch (e) {
        reject(new Error('解密失败:密码错误或密文数据遭篡改'));
      }
    });

    writeStream.on('finish', () => resolve());
    readStream.on('error', (err) => { writeStream.destroy(); reject(err); });
    writeStream.on('error', (err) => { readStream.destroy(); reject(err); });
  });
}
跨端互操作易错点:OpenSSL 格式与原始二进制
常规
CryptoJS.AES.encrypt(string, passphrase) 如果传入的是字符串口令,默认会使用 OpenSSL 兼容的 Salted__ 派生算法(EVPKDF),并在文件前 16 字节写入 Salt。本文的最佳实践采用了显式传入 256 位确定性 Key 与随机 IV 的二进制头部封包模式。如果你的前端或第三方对接方使用的是传统口令派生模式,需使用 CryptoJS.PBKDF2 或 CryptoJS.EvpKDF 派生出相同的 WordArray Key,方可保持双向完全兼容。
五、技术选型与工程权衡:crypto-js 与 Node.js 原生 crypto 的对比
在系统架构设计中,我们应当客观认知 crypto-js 在 Node.js 服务端的定位与局限。crypto-js 是完全基于纯 JavaScript 编写的,而 Node.js 官方内置的 crypto 模块底层基于 C++ 实现的 OpenSSL / BoringSSL,享有 CPU 硬件加密指令集(如 AES-NI)加速。
| 评估维度 | CryptoJS 分块流式方案 (本文实践) | Node.js 原生 crypto 模块 (createCipheriv) |
|---|---|---|
| 底层驱动 | 纯 JavaScript (V8 JIT 解析与位运算) | C++ Binding (底层 OpenSSL,支持硬件 AES-NI 加速) |
| 加解密吞吐量 | 约 15MB/s ~ 45MB/s (视 CPU 单核性能而定) | 约 400MB/s ~ 1.5GB/s (几乎达到 NVMe 磁盘极速) |
| 内存稳定性 | 恒定在 35MB~50MB (通过 64KB Chunk 与背压达成) | 极低,近乎纯内核/堆外 Buffer 直通 (~20MB) |
| 跨端与同构性 | 极强。与前端浏览器代码 100% 共享实现逻辑与对象体系 | 仅限于 Node.js / Bun 服务端环境,前端需 WebCrypto |
| 适用场景 | 必须与既有前端 CryptoJS 算法实现严格一致的互操作系统 | 纯服务端数据存储、大文件备份、高并发文件上传/下载加密 |
生产落地检查清单(Checklist)
- 确定是否必须使用 crypto-js:若无前端强契约依赖,纯 Node.js 环境优先使用原生
crypto.createCipheriv。 - 彻底杜绝同步加载:全局禁用
fs.readFileSync加密大文件,必须使用流式增量状态机。 - 分块规格标准化:保持 64KB 到 256KB 的
highWaterMark,既不拖垮 GC,也维持理想吞吐。 - 强制实施背压机制:检查
write()的返回值,严格配套pause()、resume()及drain监听。 - 随机 IV 协议封装:杜绝硬编码固定 IV,每次加密生成 16 字节随机数,封装至文件起始 16 字节。
- 异常状态销毁:在流出错回调中,务必显式销毁文件流并回收临时密文切片,防止磁盘产生不可逆脏数据。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章