

深入剖析前端JavaScript加密的安全性与底层局限,结合逆向调试操作步骤、常见误区与端到端纵深防御架构,解答前端加密为何无法保证绝对安全以及如何正确设计Web应用安全体系。
前端JS加密真的安全吗
作者:听澜
时间:2026-11-05
浏览:201
文章目录
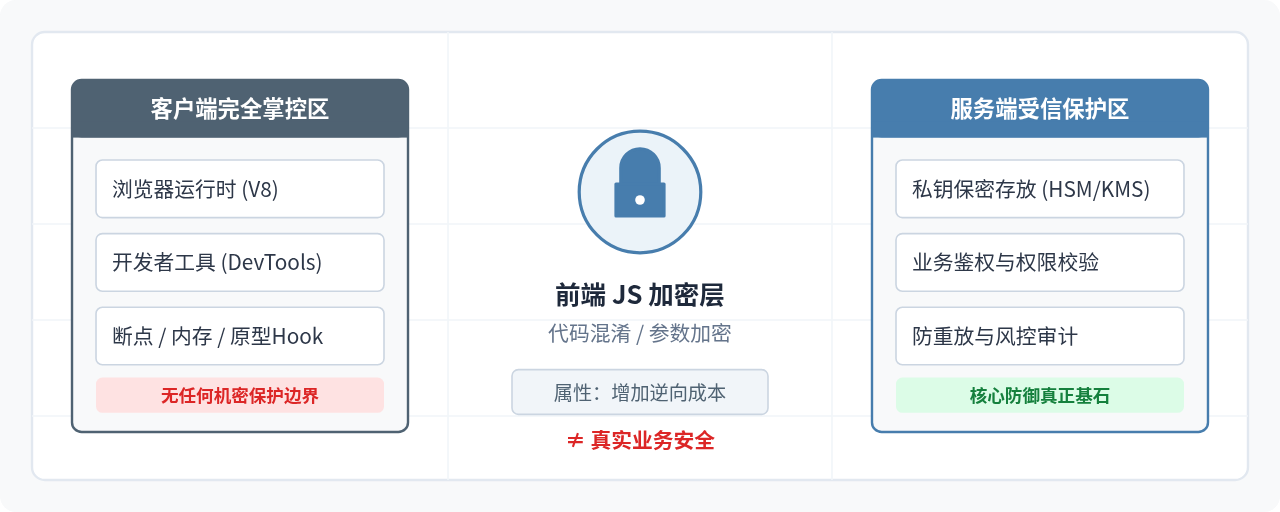
结论先发:前端 JavaScript 加密不能提供绝对的安全性,它无法防止逻辑被逆向分析,也无法保证保存在客户端的密钥不被提取。客户端环境由用户和潜在攻击者完全控制,代码的执行过程、内存中的变量以及解密逻辑完全透明。前端加密的实际作用是提高逆向门槛和破解成本,但绝不能替代服务端的鉴权、数据校验与传输层安全。
一、前端JS加密无法保密的底层逻辑
很多开发者在面对接口防爬、数据防窃取或作弊防护时,第一反应往往是“在前端用 JS 把数据加密后再发出去”或者“把前端代码混淆打包”。但要理解前端加密的局限,首先要理解现代浏览器的运行机制。
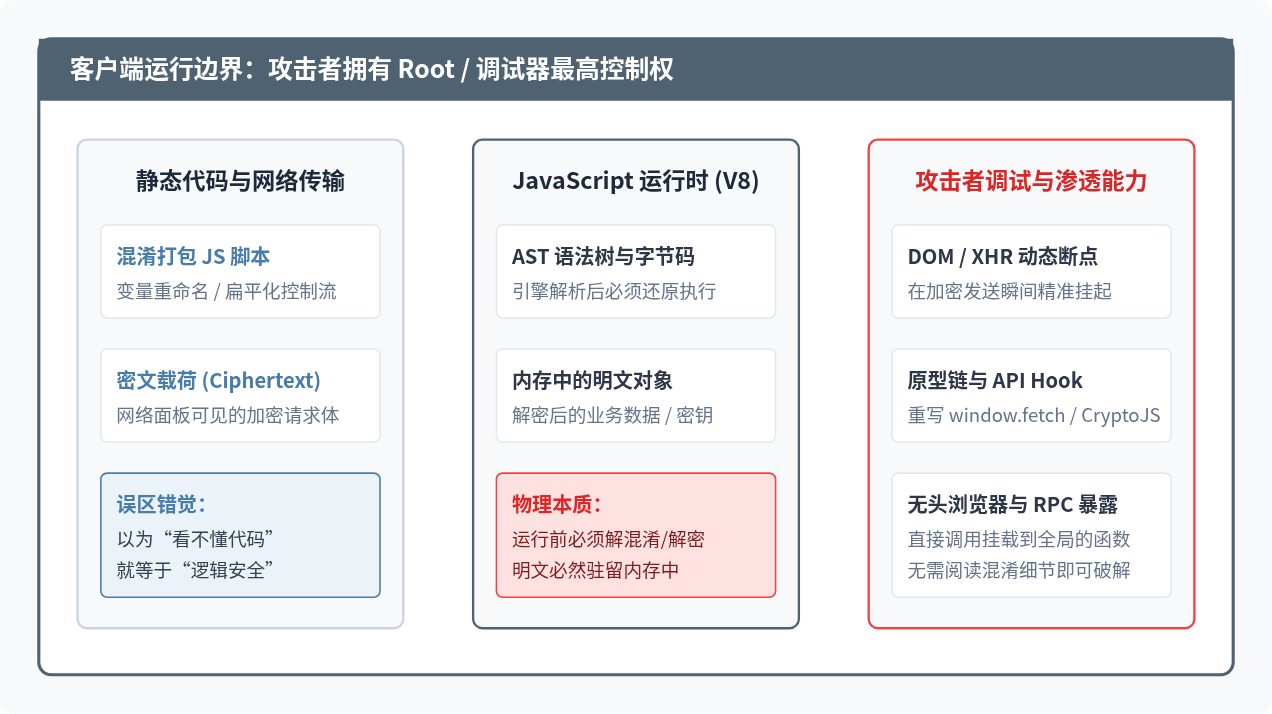
现代计算机安全体系基于“受信环境”与“不可信环境”的划分。服务端机房属于受信环境,只有授权运维人员才能接触到服务器内存;而浏览器运行在用户的个人电脑或移动设备上,属于典型的不可信终端。用户拥有该设备的最高权限(Root 或 Administrator),这意味着浏览器所做的一切操作,对设备持有者都是完全开放的。
密码学中有一条著名的基本原则——柯克霍夫原则(Kerckhoffs's principle):一个密码系统的安全性必须完全依赖于密钥的保密性,而不能依赖于算法或实现机制的隐蔽性。然而,在纯前端场景下,这个原则遭遇了致命的物理困境:
- 密钥必须暴露给执行引擎:如果前端负责加密或解密,那么加密算法所需要的密钥、初始向量(IV)或动态生成逻辑,必须在前端代码中可被读取。即使开发者把密钥藏在极其复杂的混淆字符串里,当 JavaScript 引擎(如 V8)执行到实际的加密函数时,传入函数的参数必然是还原后的明文密钥。
- 运行时完全可观测:浏览器自带的 DevTools 不仅能单步调试代码,还能实时查看堆栈帧(Call Stack)、作用域变量(Scope Variables)以及堆内存快照(Heap Snapshot)。没有任何一行在前端执行的 JavaScript 代码能逃过断点的捕获。
- 代码逻辑可被任意篡改与重写:攻击者可以借助浏览器扩展、本地代理工具(如 Charles、Fiddler、mitmproxy)或直接在控制台执行 Monkey Patch(猴子补丁),覆盖全局对象、篡改原生原型链(如
Function.prototype、JSON.parse),从而在数据出入的关键路径上实现透明拦截。
二、逆向破解前端加密的实战操作步骤
为了让大家清晰地看到前端加密是如何被瓦解的,我们来看一段典型的“前端 AES 加密”实现,并演示攻击者如何通过浏览器开发者工具,在不需要完全读懂混淆代码的情况下快速提取明文和密钥。
1. 典型的脆弱前端加密代码示例
以下代码模拟了许多业务系统中的常见写法:在向服务端提交表单前,使用 AES 算法对请求体进行加密,并将密钥直接定义在模块或页面内:
// 开发者认为:通过混淆这段代码,别人就拿不到数据和密钥了
const SECRET_KEY = "k8#9vLm2@xP0!qW5"; // 16字节 AES 密钥
const IV_VECTOR  = "1234567890123456";

function encryptPayload(data) {
  const jsonStr = JSON.stringify(data);
  const cipher = CryptoJS.AES.encrypt(jsonStr, CryptoJS.enc.Utf8.parse(SECRET_KEY), {
    iv: CryptoJS.enc.Utf8.parse(IV_VECTOR),
    mode: CryptoJS.mode.CBC,
    padding: CryptoJS.pad.Pkcs7
  });
  return cipher.toString();
}

// 业务触发请求
function submitOrder(orderInfo) {
  const encrypted = encryptPayload(orderInfo);
  fetch("/api/v1/order/create", {
    method: "POST",
    headers: { "Content-Type": "application/json" },
    body: JSON.stringify({ payload: encrypted })
  });
}
2. 逆向分析的完整操作步骤
面对经过 Webpack 打包或甚至经过 JavaScript-Obfuscator 强混淆后的上述代码,有经验的逆向分析人员通常遵循以下标准步骤展开攻击:
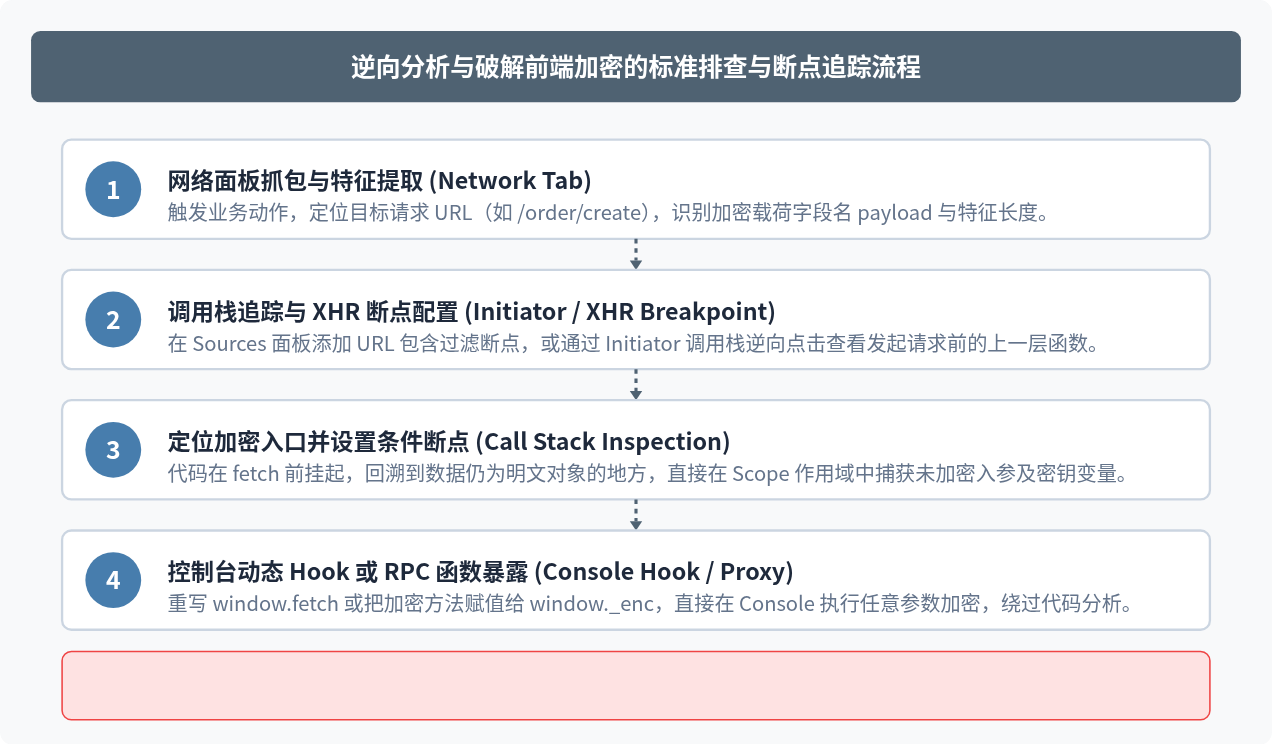
详细排查细节:
- 步骤 1:定位网络行为。打开 Chrome DevTools 的 Network 面板,点击页面的提交按钮。过滤器选择
Fetch/XHR,查看发送出去的数据。此时攻击者看到的是一段乱码字符串"U2FsdGVkX1+..."。 - 步骤 2:顺藤摸瓜找调用栈。在 Network 面板中,每条请求都有一个
Initiator列。把鼠标悬停在上面,或者直接切换到该请求的Initiator子标签,浏览器会清晰列出触发此网络请求的完整 JavaScript 调用堆栈(Call Stack)。哪怕函数名被混淆成_0x1a2b,只要沿着调用链往上点一级,就能直接跳到发起fetch的源码行。 - 步骤 3:下断点与内存捕获。在 Sources 面板中,于该行代码打一个普通断点或条件断点。再次点击提交按钮,页面代码在发送瞬间暂停。在右侧的
Scope(作用域)窗口里,所有局部变量一览无余:传入的未加密原始表单对象清晰可见,正在使用的加密密钥SECRET_KEY也直接以纯文本形式展示。 - 步骤 4:无成本重放与自动化。甚至攻击者都不需要阅读加密算法是用 AES 还是国密 SM4。只要在断点暂停时,在 Console 控制台输入:
接着,攻击者使用 Puppeteer 或 Playwright 启动自动化浏览器,随时执行// 挂载加密函数到全局对象 window.__myToolEncrypt = encryptPayload;page.evaluate(() => window.__myToolEncrypt({ amount: 9999 })),即可自动源源不断地生成合法的加密请求载荷。这种方式被称为“RPC 远程调用”,彻底免去了扣代码和反混淆的耗时工作。
安全提醒:不要把“逆向困难”误以为是“绝对安全”
代码混淆确实能增加人工阅读的难度,延长反编译的时间,但这属于“以隐蔽求安全”(Security through Obscurity)。在安全工程学上,基于隐蔽的方案只要被破解一次,整个系统的防线就会彻底崩溃。
三、前端加密容易踩入的三个典型误区
很多团队在系统设计初期,往往因为对安全边界理解不清晰而投入大量精力做无用功。以下是最典型的三类设计误区:
误区一:把接口参数加密当成防刷、防爬虫的唯一屏障
一些开发者认为,只要把请求参数加密成密文,爬虫就无法解析参数结构,脚本就无法伪造请求。然而从上述破解流程可以看出,爬虫作者根本不需要理解参数是如何加密的。他们既可以通过 Hook 直接把加密函数暴露给外部脚本,也可以直接把混淆后的 JS 打包扔进 Node.js 虚拟环境(如 vm2、JSDOM)中直接运行。只要服务端没有严格的频次限制和行为验证,加密参数阻挡不了任何稍微懂点逆向的黑灰产。
误区二:在前端实现核心商业逻辑或权限校验
“先从服务端下载密文小说/付费视频,再在前端用 JS 解密播放”、“在前端判断用户是否为 VIP,是则解密高级功能代码”——这类方案的安全性为零。因为最终呈现给用户的屏幕、扬声器或 DOM 节点必定是明文的,攻击者只需要拦截解密后的 return 结果,即可免费获取未授权的数据内容。
误区三:认为前端加密可以替代 HTTPS 传输层安全
有些项目在开发内网系统或测试环境时,因申请和配置证书繁琐,便提出“既然前端已经做了 AES 加密,传输过程就不怕被抓包了,没必要非上 HTTPS”。这是极度危险的认知:
- 没有 HTTPS,中间人攻击(MITM)可以随意篡改在网络中传输的 HTML 和 JS 文件。攻击者可以在客户端下载 JS 文件的那一秒,把恶意代码(如偷取密码的探针)注入进去。
- 即使数据密文没有被立刻破解,缺乏传输层完整性校验的通信极易受到重放攻击(Replay Attack)和降级攻击。
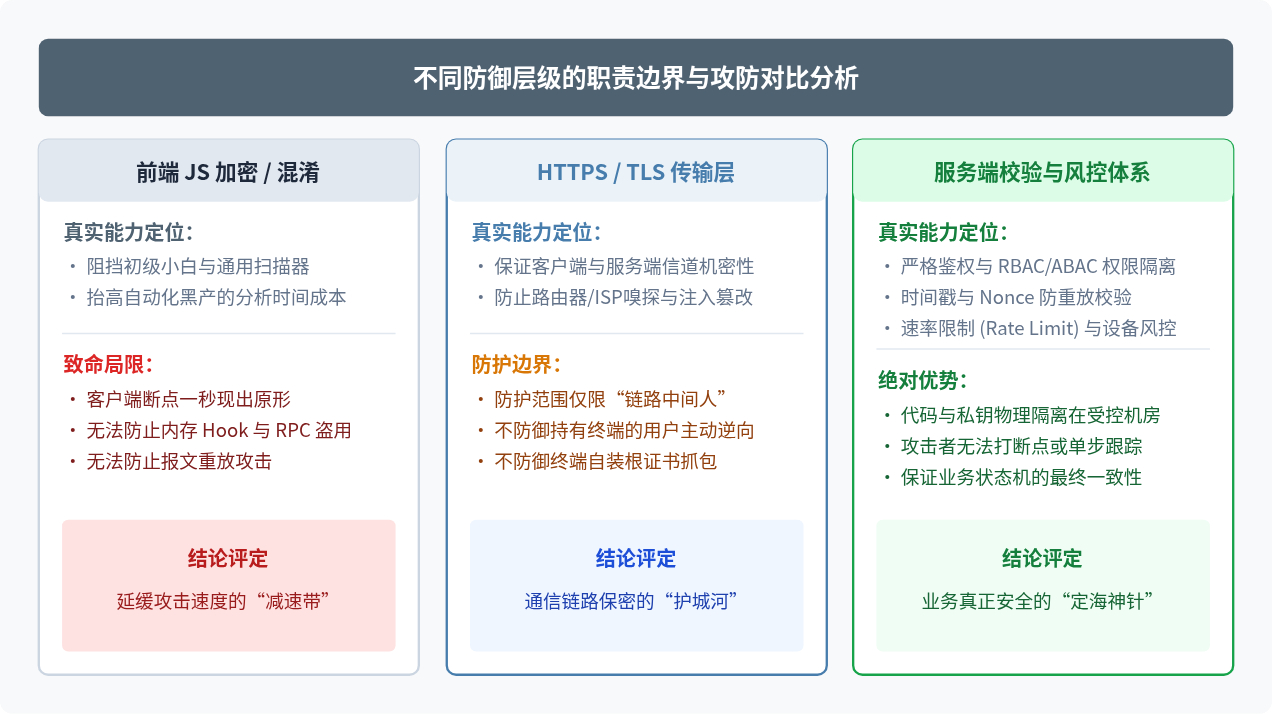
四、什么时候需要在前端进行加密?
既然前端加密无法防止逆向,那是不是意味着前端就不应该写任何加密代码?并不是。在经过严谨安全设计的系统中,前端加密有其明确的适用场景和正确打开方式:
1. 敏感口令的非对称公钥加密提交
在用户登录或修改密码时,很多安全规范(如金融行业标准)要求用户密码在离开浏览器那一刻就不能是明文。这并不是为了防范终端用户自己,而是为了:
- 防御内部网关日志泄露:大型架构中,请求进入机房后通常由 Nginx、API 网关处理,再通过消息队列或服务网格转发。如果明文传输,网关访问日志或网络抓包分析中极易留下用户的原始明文密码。
- 正确实现:前端使用服务端提供的 RSA 公钥 对密码进行加密。由于公钥只能加密、无法解密,即便终端逆向者拿到了公钥和加密后的数据,在没有服务端私钥的情况下,也无法反向解密出明文。这才是符合柯克霍夫原则的安全设计。
2. 端到端加密应用(End-to-End Encryption, E2EE)
在 Signal、WhatsApp Web 端、1Password 或部分在线文档系统中,业务要求“甚至服务提供商自己的服务器都不能看到用户数据”。
在这种架构下,加解密工作必须在前端浏览器中完成。其密钥由用户的主密码(Master Password)在客户端通过 PBKDF2 或 Argon2 等算法派生而来,该密钥绝不上传给服务端。此时,加密的防御目标不是“防范终端设备的所有者”,而是“防范不可信的云端服务器与中间链路”。这属于合法且必须的前端加密场景。
3. 增加恶意爬虫与自动化黑产的攻防成本
在电商抢购、验证码校验等强对抗业务中,利用代码混淆和动态签名算法(如生成每次请求变化的 _signature)可以有效将 90% 的自动化脚本挡在门外。黑产团队不得不投入人力去逆向 JS 或配置昂贵的真实浏览器集群,从而让攻击的经济收益低于攻击成本。但必须始终记住:这是一种风控对抗博弈手段,而不是绝对安全的防火墙。
五、构建真正可靠的 Web 端到端纵深防御体系
抛弃“靠前端加密保安全”的侥幸心理后,现代 Web 应用应当如何设计真正的安全架构?核心原则只有一个:零信任客户端(Zero Trust Client),即把所有的前端请求都视为潜在的恶意伪造,把安全校验的重心完全收拢到服务端。
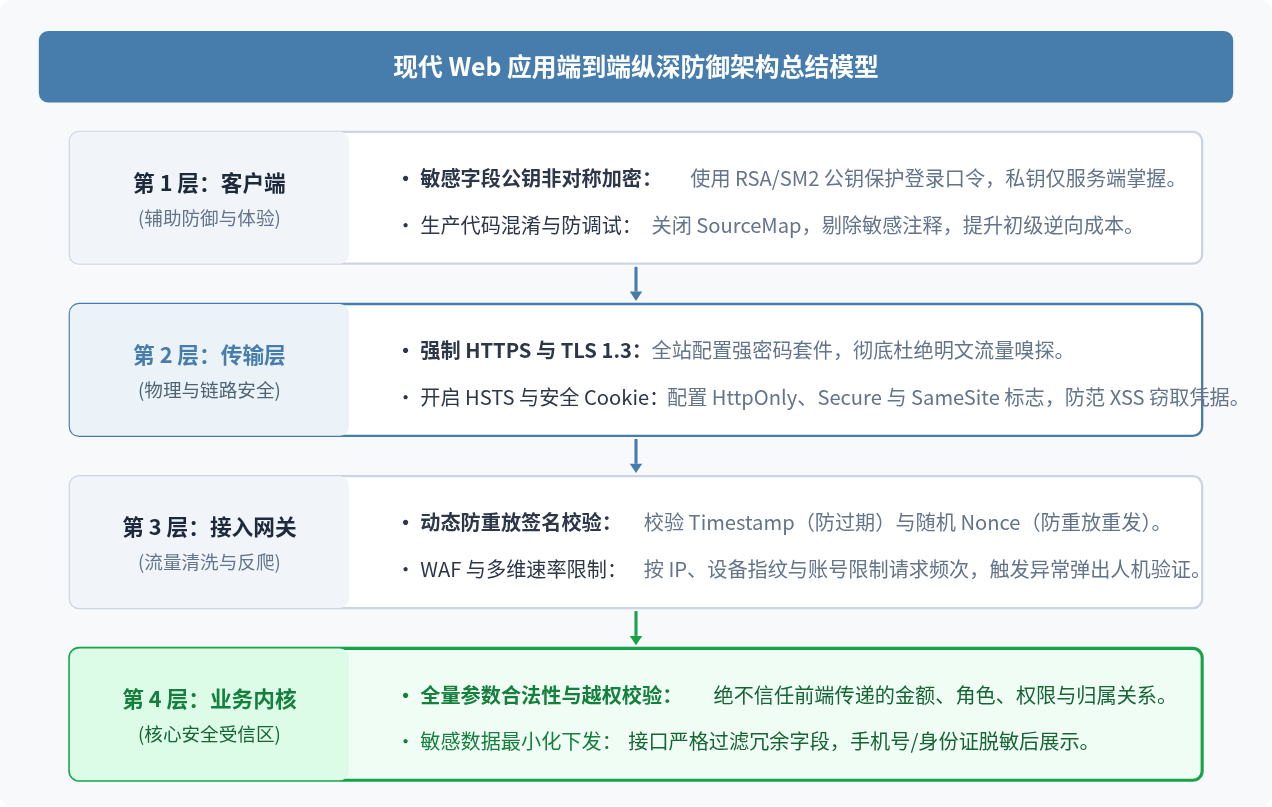
落地实践清单:
- 绝不将对称加密的密钥(如 AES Key)硬编码在前端代码中。如果前端需要解密数据才能展示,说明该数据本身就已经公开给该用户了;如果用户没有权限查看,后端根本就不应该将该数据字段返回。
- 使用时间戳(Timestamp)与随机随机数(Nonce)设计防重放机制。客户端每次请求附带当前时间戳和随机 UUID,服务端在缓存中记录已使用的 Nonce,并拒绝时间偏差超过 60 秒的请求。这能使攻击者即便录制了合法密文,也无法反复重放。
- 权限控制在数据库查询阶段收敛。防止水平越权(IDOR):用户查询
/api/order/detail?orderId=10086时,服务端必须检查当前登录用户的userId是否确实是该订单的创建者,而不是仅仅依赖参数是否加密。 - 关键业务增加风控验证码。当检测到同一个 IP 或同一台设备短时间内发起密集请求时,主动弹出图形滑块或生物行为验证,把成本直接转嫁给打码平台和黑产。
六、总结
回到最初的问题:前端 JS 加密真的安全吗?
答案是:单靠前端 JS 加密,无法构建起真实可靠的安全防线。前端代码天生处于敌方完全掌控的物理终端中,断点调试、内存检查和运行时 Hook 可以让任何混淆与对称加密在几分钟内原形毕露。
优秀的系统架构师绝不把希望寄托在前端的“障眼法”上。正确的工程实践是将前端代码定位为交互与展示层,把对称密钥、商业核心算法、数据权限控制牢牢锁在服务端,同时借助 HTTPS 筑牢传输通道。唯有理清各自的安全边界,才能打造出真正经得起实战检验的高安全 Web 系统。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章