

深入解析JavaScript代码混淆的两大核心机制:控制流平坦化与字符串加密。通过抽象语法树(AST)重构原理、状态机调度转换、字典移位与运行时动态解密流程,全面剖析其技术实现、关键差异与防护边界。
JavaScript代码混淆原理详解:控制流平坦化与字符串加密
作者:霁月
时间:2026-11-03
浏览:449
文章目录
技术原理详解 / 前端安全
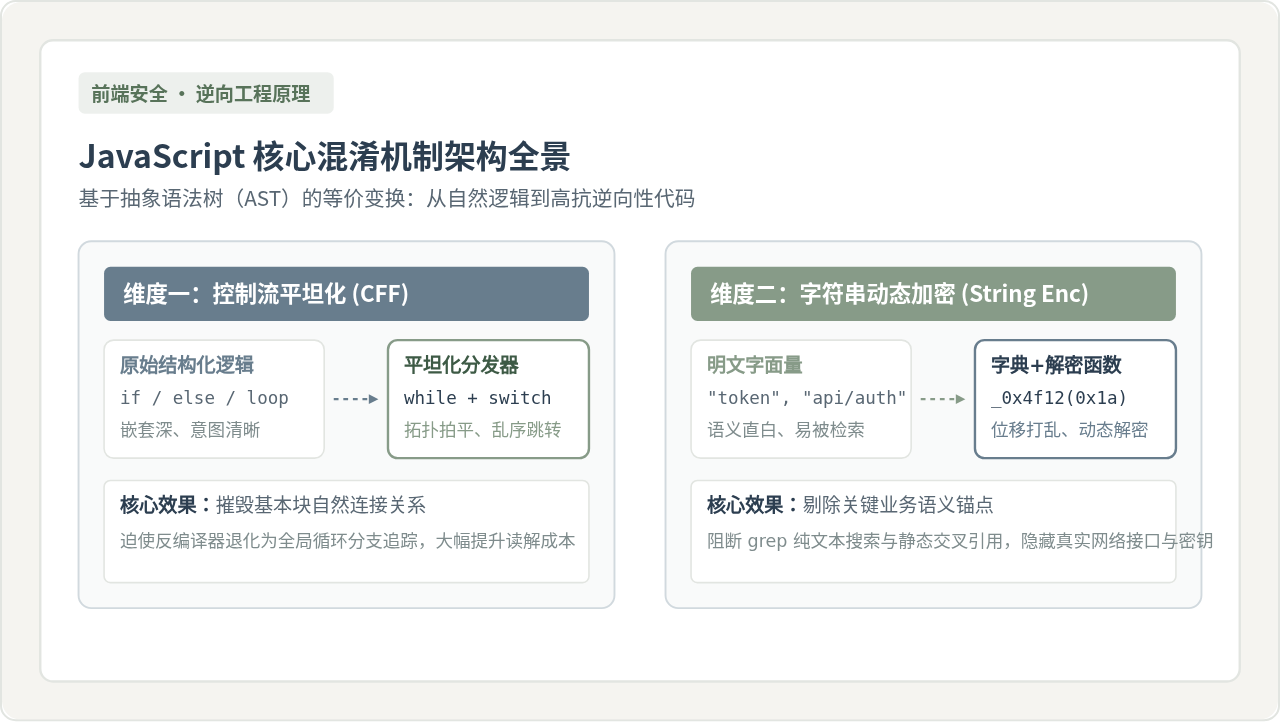
图 0:JavaScript 核心混淆机制全局架构
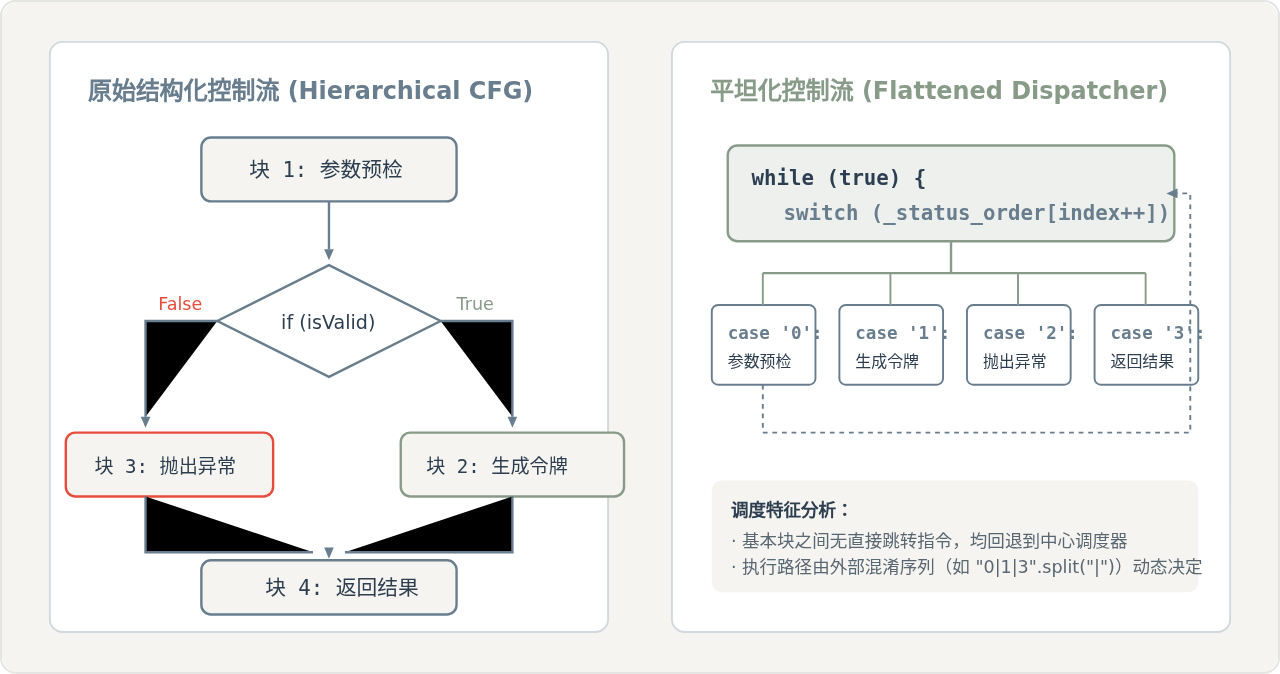
图 1:原始分层控制流与平坦化状态机拓扑对比
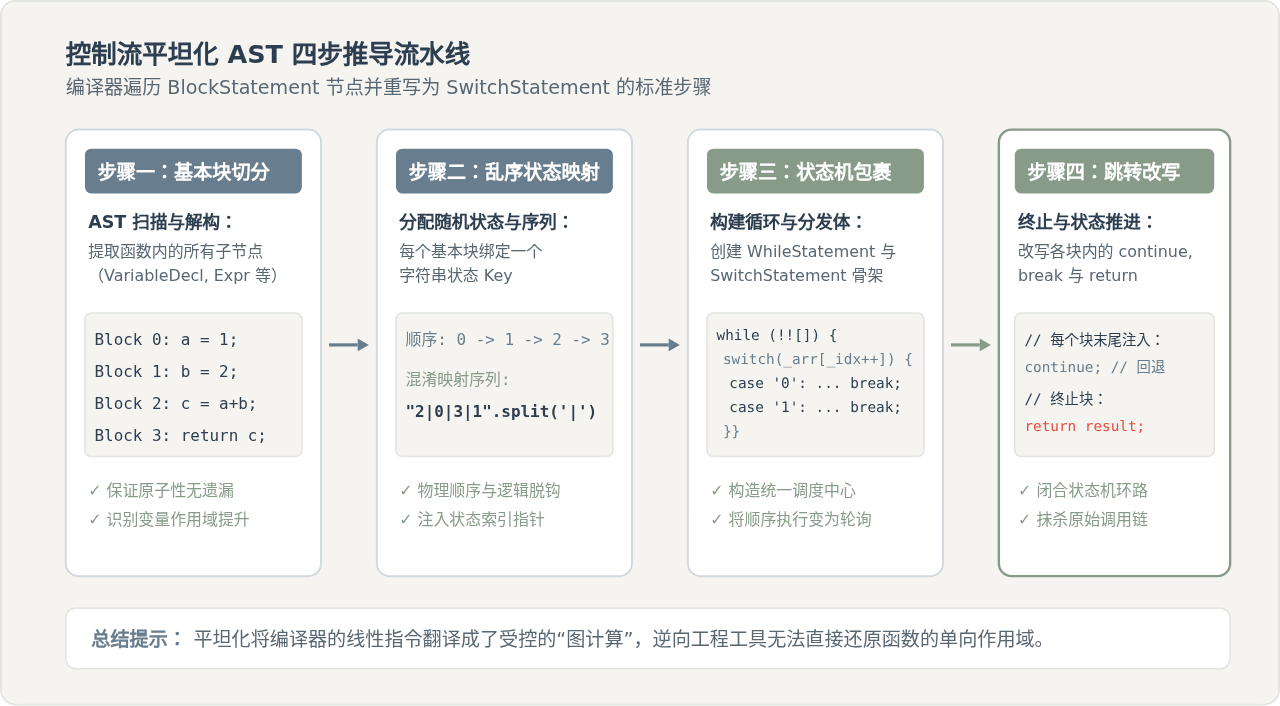
图 2:控制流平坦化的 AST 四步变换推导流程
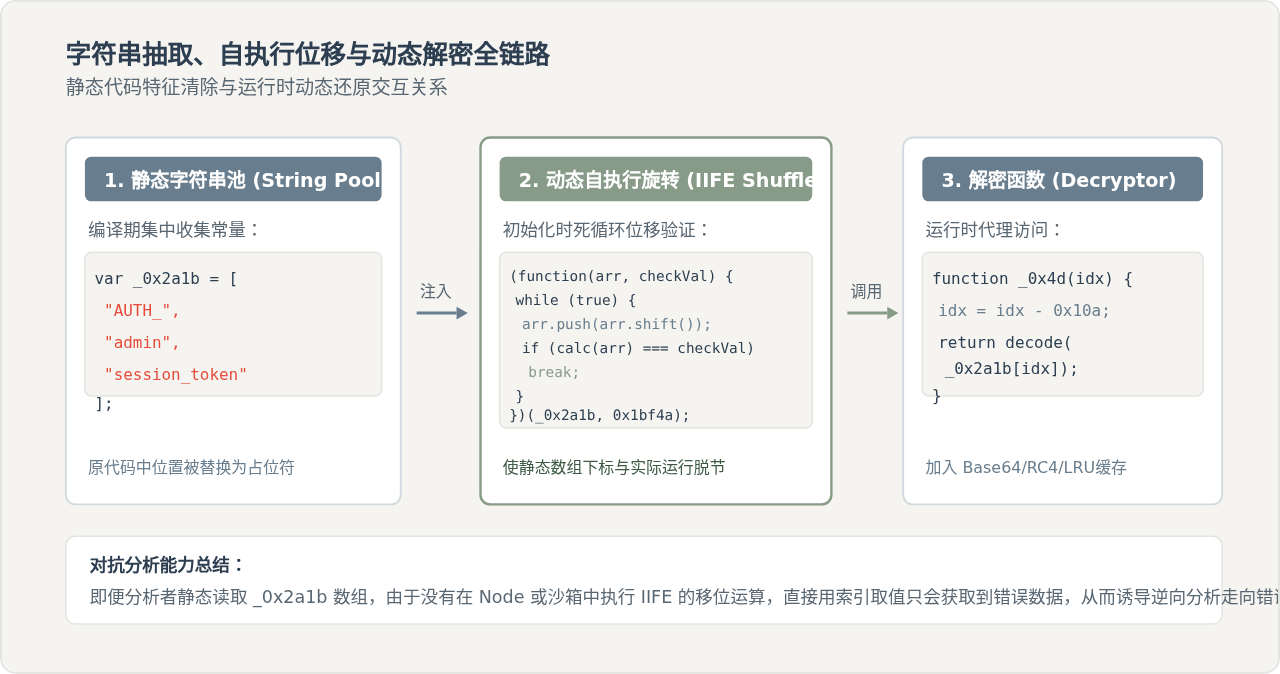
图 3:字符串抽取、IIFE 数组旋转与解密函数运行时链路
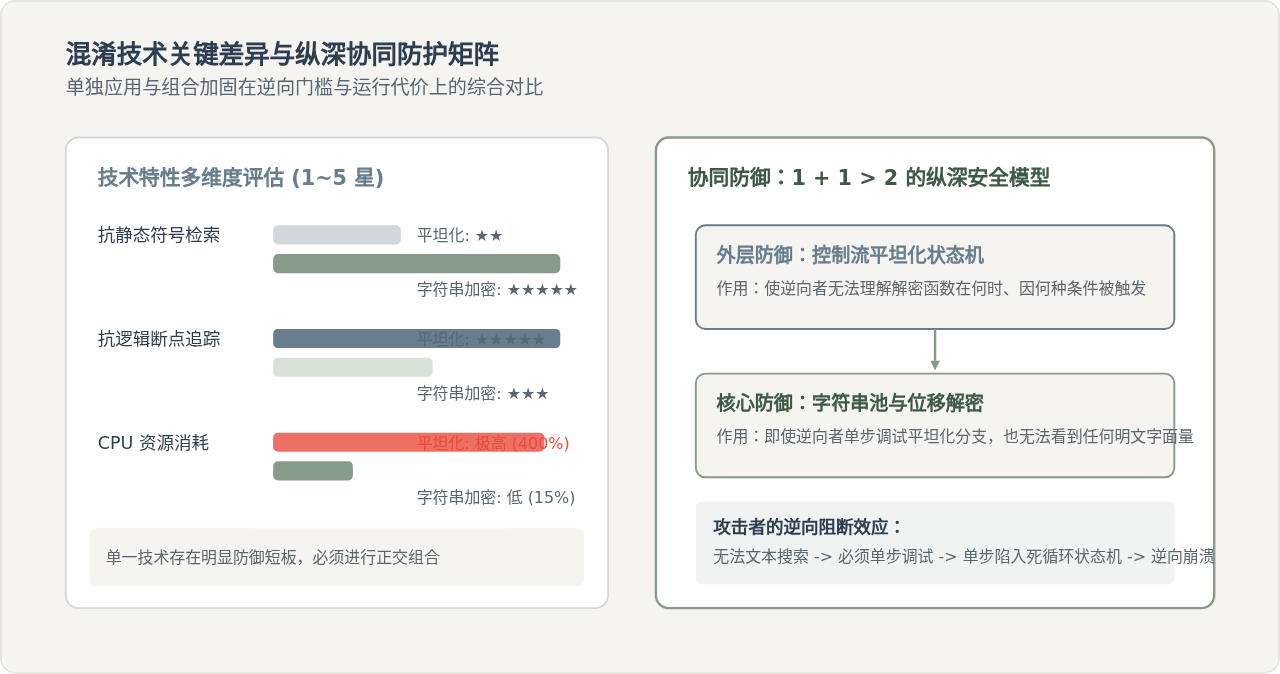
图 4:技术维度对比与双重纵深协同加固体系
JavaScript 作为客户端解释型脚本,其源码在分发过程中完全向运行环境与分析者公开。为了防止业务核心算法、鉴权凭据与反作弊逻辑被轻易逆向分析,代码混淆通过“语义等价变换”重构源码结构。其中,控制流平坦化(Control Flow Flattening)负责打碎程序原有的分支与循环拓扑,字符串加密(String Encryption)则消除暴露业务线索的字面量常量。本文通过原理剖析、抽象语法树(AST)重构示例与执行推导,全面拆解这两大核心混淆技术的底层工作方式。
一、混淆的本质:语义等价下的结构重塑
在深入具体算法前,必须确立对 JavaScript 混淆本质的认知:代码混淆是一次严格保持语义与执行结果等价的程序变换过程。无论代码结构被改写得多么错综复杂,它在给定的输入下必须输出与原始代码完全相同的计算结果,产生完全相同的副作用。
基础的代码压缩(Minification)或简单的标识符重命名(Mangle)虽然能够将 calculateTax() 替换为 a(),但并没有改变程序的控制流骨架和数据常量。分析者只要观察函数之间的嵌套跳转顺序,配合代码中未被修改的 URL、错误提示等明文字符串,便可快速还原出整个业务模型。
现代混淆器因此将防御重心转移到两个最具攻击性的维度:
- 执行流维度(Control Flow):抹除调用关系与时序线索,让反编译工具生成的控制流图(CFG)失去层次。
- 数据流维度(Data Constant):抹除一切具有可读业务意义的静态文本常量,阻断逆向工程中的关键词切入点。
二、控制流平坦化(Control Flow Flattening)
控制流平坦化最初源于针对二进制程序的安全加固算法(如 Chenxi Wang 等人提出的控制流平坦化理论),后被广泛移植至 JavaScript 编译转换中。其目标是消除函数内部深层嵌套的 if-else、for、while 和顺序语句块,将整个控制流拓扑“拍扁”为一个包含巨大 switch-case 的单层无限循环结构。
1. 控制流图的形态演变
在未经混淆的代码中,执行逻辑是分层且有向的。分析者或者反编译程序可以自顶向下绘制出清晰的控制流图。平坦化后,所有的基础代码块(Basic Block)都被提升为平级的 case 分支,所有的跳转统一经由中央调度变量(Dispatcher Variable)分发。
2. AST 转换推导过程
在 AST 层面实现平坦化通常分为四个不可逆的推导阶段:
3. 代码变换对比示例
考虑如下负责密码复杂性校验与令牌生成的简短业务函数:
原始代码 (Cleartext Logic)
function generateSession(userId, role) {
  var prefix = "AUTH_";
  var timestamp = Date.now();
  var isValid = (role === "admin" && userId > 1000);
  if (isValid) {
    return prefix + userId + "_" + timestamp;
  }
  return null;
}
经控制流平坦化重写后,函数体被改造为由数组驱动的状态机:
平坦化后代码 (Flattened Code)
function generateSession(userId, role) {
  // 混淆后的状态推进顺序字典
  var _dispatch_seq = "3|1|4|0|2".split("|");
  var _seq_ptr = 0;
  var prefix, timestamp, isValid;

  while (true) {
    switch (_dispatch_seq[_seq_ptr++]) {
      case "0":
        if (isValid) {
          return prefix + userId + "_" + timestamp;
        }
        continue;
      case "1":
        timestamp = Date.now();
        continue;
      case "2":
        return null;
      case "3":
        prefix = "AUTH_";
        continue;
      case "4":
        isValid = (role === "admin" && userId > 1000);
        continue;
    }
    break;
  }
}
变量作用域提升的必要处理
注意上述代码中 prefix, timestamp, isValid 变量声明在 while 循环外进行了统一前置。这是因为在原始代码中,某些变量可能声明在条件块内部;如果不进行变量提升(Hoisting),平坦化到不同 case 中会导致跨分支变量访问的 ReferenceError。
三、字符串动态加密与运行时还原
控制流平坦化虽然打乱了代码跳转,但在上述混淆代码中,"AUTH_"、"admin" 等字符串依旧以明文形式存在。逆向者只需使用全局文本检索即可定位到目标分支。因此,字符串加密是消除代码语义线索的关键防线。
1. 字符串混淆的三层防护体系
现代混淆工具对字符串的处理绝非简单的 btoa() 或固定异或,而是包含三个紧密嵌套的环节:
- 字符串提取与集中池化(String Array Extraction):提取代码中所有字符串字面量,统一存放至一个顶部全局/闭包数组。
- 数组旋转位移(Array Shift & IIFE):利用立即执行函数(IIFE),在代码初始化加载阶段执行
arr.push(arr.shift()),让数组内的实际物理索引与其编译期的静态索引发生偏差。 - 解密包装函数(Decryptor Wrapper Function):注入解密函数,包含索引偏移纠正、密钥解密(如 RC4、异或或字符编码重排)以及解密结果的内存缓存。
2. 完整字符串混淆示例
混淆实现代码 (Obfuscated String Implementation)
// 1. 全局字符串池(明文已被 Base64 / RC4 或原始提取)
var _0x19a2 = [
  'QVVUSF8=',      // Base64 of "AUTH_"
  'YWRtaW4=',      // Base64 of "admin"
  'dW5kZWZpbmVk'  // Base64 of "undefined"
];

// 2. 自执行数组旋转(使物理下标与解密偏移完全绑定)
(function (_array, _targetNum) {
  var _shiftFn = function (_step) {
    while (--_step) {
      _array['push'](_array['shift']());
    }
  };
  _shiftFn(++_targetNum);
}(_0x19a2, 0x1f));

// 3. 解密包装函数与内存缓存
var _0x3b8c = function (_index, _key) {
  _index = _index - 0;
  var _str = _0x19a2[_index];
  // 模拟 Base64 解密与字符还原
  if (_0x3b8c['initialized'] === undefined) {
    _0x3b8c['base64Decode'] = function (str) {
      return atob(str);
    };
    _0x3b8c['dataCache'] = {};
    _0x3b8c['initialized'] = true;
  }
  if (_0x3b8c['dataCache'][_index] === undefined) {
    _0x3b8c['dataCache'][_index] = _0x3b8c['base64Decode'](_str);
  }
  return _0x3b8c['dataCache'][_index];
};

// 4. 业务代码中的调用形态
function checkPermission(role) {
  // 原始代码: return role === "admin"
  return role === _0x3b8c(0x1);
}
四、控制流平坦化与字符串加密的关键差异与协同影响
为了准确评估混淆对程序安全性与性能的影响,必须在统一的基准条件(同一应用、相同执行环境与相同逆向手段)下,对比这两种技术的关键差异:
| 比较维度 | 控制流平坦化 (CFF) | 字符串加密 (String Enc) |
|---|---|---|
| 混淆作用域 | 控制逻辑与执行流(算法步骤、循环与分支架构) | 数据字面量(接口路径、参数名称、配置常量) |
| 防御的核心逆向手段 | 防御 IDA/Ghidra/AST 工具生成的控制流图分析与符号执行 | 防御静态文本检索(Grep)、字符串交叉引用查找 |
| 对运行性能的消耗 | 极高(大量无用 switch 分发、CPU 分支预测完全失效) | 中低(通过 LRU 缓存后仅在初次调用时产生解密函数开销) |
| 主要副作用 | 代码体积急剧膨胀(200%~500%),执行延迟增加 | 增加微小的初始加载耗时与内存缓存驻留 |
| 反混淆破解思路 | 静态符号执行分析状态变量,还原 Switch 基本块跳转顺序 | 通过 Node.js 沙箱运行 IIFE 与解密函数,直接批量静态替换函数调用 |
为什么协同使用能产生质变?
如果仅使用字符串加密,逆向人员可以通过 Chrome DevTools 在解密函数 _0x3b8c 内打上条件断点或利用 console.trace(),通过观察上层调用栈,立刻在清晰的分层业务函数中截获明文与调用上下文。
如果仅使用控制流平坦化,逆向人员虽然无法理清循环跳转,但通过搜索诸如 "https://api.domain.com/v1/auth" 等接口特征,可以直接精准定位到处理该逻辑的那个 case 块,绕过其余所有的干扰状态。
当两者结合使用时,字符串解密函数散落在几十个被打乱的 case 状态分支中。逆向工具既无法通过关键词定位入口,调用栈回溯也全部终止在平坦化的调度器 while-switch 闭包内,二者相互掩护,极大地抬高了自动化反编译与人工静态阅读的成本。
五、工程实践中的权衡与防护边界
在实际的前端安全工程中,不能盲目地对整个项目开启全量平坦化。开发者需要掌握明确的边界与调优原则:
- 核心计算与循环规避:控制流平坦化会引入额外的变量查找与循环判断,严重干扰 V8 引擎的 JIT(即时编译)优化与 CPU 分支预测。严禁对 Canvas 逐帧渲染、高频加密计算或密集数据循环开启平坦化,否则会导致帧率暴跌。
- 针对性混淆策略:建议仅对敏感的业务判定入口(如支付签名生成、设备指纹上报、反作弊逻辑校验)开启
controlFlowFlattening: true,其余通用代码只做标识符混淆与死代码注入。 - 防御边界认识:代码混淆是增加逆向成本(Time to Crack)的延时手段,而非密码学上的绝对安全。配合 AST 插件(如 Babel)针对特定混淆器编写的反平坦化脚本(通过符号执行重建 CFG 图)与动态内存 Hook,终究能逐步还原逻辑。因此,至关重要的商业机密与鉴权判定,仍必须坚守在受信的服务端环境中完成。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章