
深入详解使用 crypto-js 进行 Base64 与 Hex 编码转换的正确姿势。通过剖析 WordArray 二进制数据结构,提供无损互转、格式清洗、加解密直接序列化等标准实战代码与避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
crypto-js 处理 Base64 和 Hex 编码转换的正确姿势
作者:听澜
时间:2026-11-05
浏览:586
文章目录
技术精要
主题:编码转换与数据流转
适用工具:crypto-js 3.x / 4.x
环境:浏览器 / Node.js
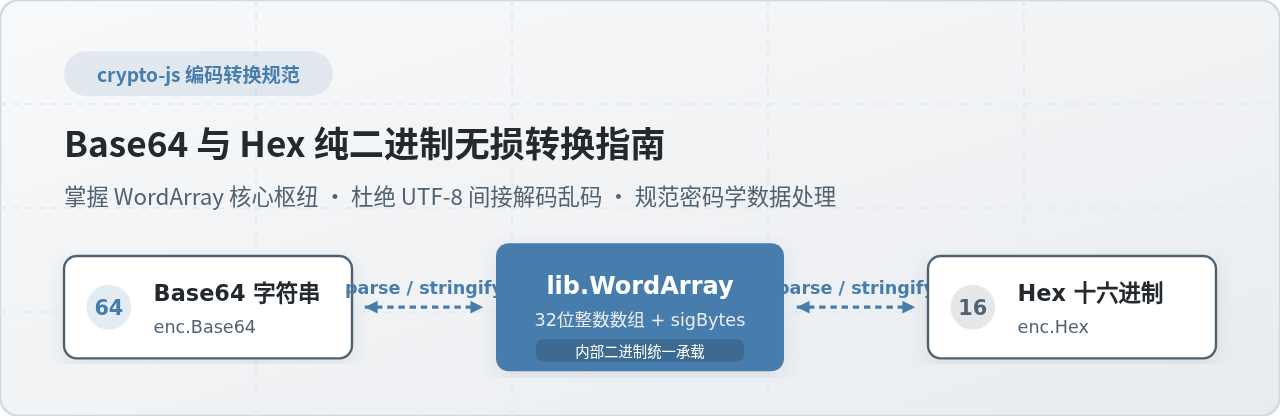
在前端加密或对接后端接口时,开发者经常需要在 Base64 与 Hex(十六进制)两种数据编码之间互相转换。正确的做法是:以
CryptoJS.lib.WordArray 作为唯一的二进制中间载体,使用源编码器的 parse() 解码为原始字节流,再直接调用目标编码器的 stringify() 导出目标文本。任何试图将二进制密文先转成普通 UTF-8 字符串再做二次转码的做法,都会破坏非 ASCII 字符对应的原始字节,导致解密失败或数据损坏。
一、认识核心中枢:为什么必须基于 WordArray?
很多开发者在接触 crypto-js 时,容易把 enc.Base64、enc.Hex 与 enc.Utf8 当作互相平级的“字符串格式化函数”,甚至写出 btoa() 或 decodeURIComponent 与之混用的代码。这种理解脱离了 crypto-js 的核心架构。
在 crypto-js 内部,所有加密算法(AES、DES、RSA 填充等)和散列算法(MD5、SHA-256 等)运算的输入与输出对象既不是普通字符串,也不是原生 Uint8Array,而是其自建的核心类 CryptoJS.lib.WordArray。
一个 WordArray 对象本质上包含两个字段:
words:一个 32 位整型数字数组(每个 32-bit word 容纳 4 个字节)。sigBytes:有效字节总数(用来标记实际数据长度,防止 4 字节对齐时的末尾多余零字节被误认)。
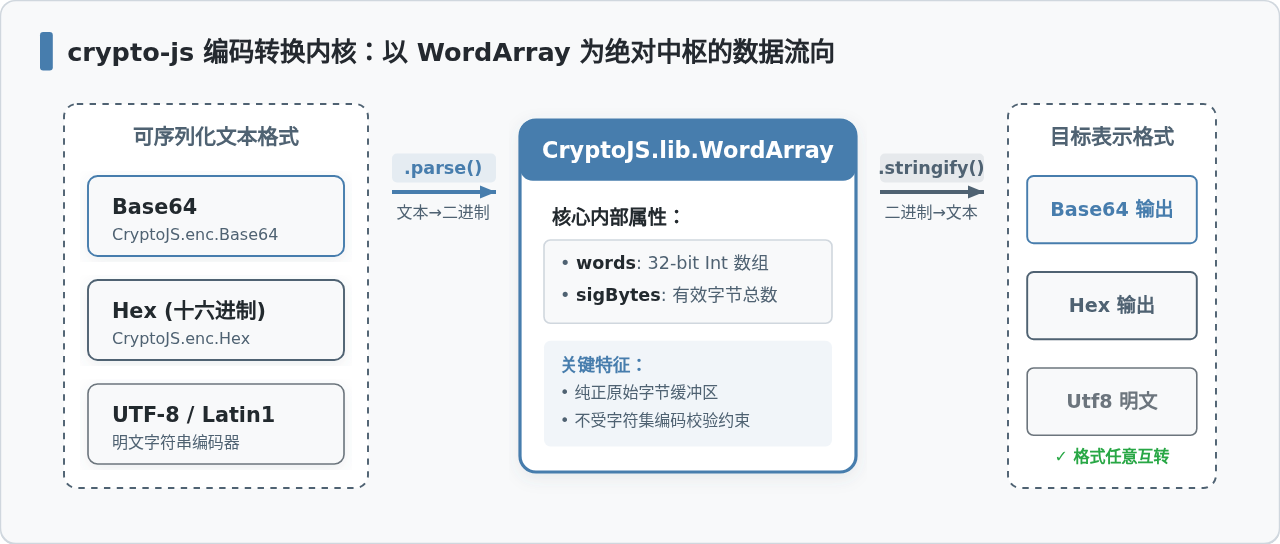
CryptoJS.enc 命名空间下的所有编码器(包括 Hex、Base64、Utf8、Latin1)都严格遵循相同的接口设计:
parse(encodedStr):将对应格式的文本字符串解析并还原为原始二进制WordArray。stringify(wordArray):将内存中的二进制WordArray编码并序列化为目标格式的字符串。
因此,Base64 与 Hex 之间的转换,本质上是“Base64 文本 ➔ WordArray 二进制 ➔ Hex 文本”的直接过程,不需要且绝对不能经过字符编码(如 UTF-8)的解释。
二、Base64 与 Hex 无损互转的规范写法
基于上述中枢模型,两个编码系统之间的转换只需要两步串联,一行代码即可高精度完成。
1. Base64 转 Hex(十六进制)
将 Base64 编码的签名、密钥、初始化向量(IV)或密文转换为十六进制字符串:
const CryptoJS = require("crypto-js");

// 示例:标准 Base64 字符串(对应十六进制 0102030405060708)
const base64Str = "AQIDBAUGBwg=";

// 正确做法:Base64 解析为 WordArray,再由 Hex 序列化输出
const words = CryptoJS.enc.Base64.parse(base64Str);
const hexResult = CryptoJS.enc.Hex.stringify(words);

console.log(hexResult);
// 输出: "0102030405060708"
一行式简写形式为:
const base64ToHex = (b64) => CryptoJS.enc.Hex.stringify(CryptoJS.enc.Base64.parse(b64));2. Hex(十六进制)转 Base64
反向转换同样遵循对称原则。将后端给出的 Hex 格式私钥或密文转换为 Base64 传输格式:
// 示例:十六进制字符串
const hexStr = "0102030405060708";

// 正确做法:Hex 解析为 WordArray,再由 Base64 序列化输出
const words = CryptoJS.enc.Hex.parse(hexStr);
const base64Result = CryptoJS.enc.Base64.stringify(words);

console.log(base64Result);
// 输出: "AQIDBAUGBwg="
一行式简写形式为:
const hexToBase64 = (hex) => CryptoJS.enc.Base64.stringify(CryptoJS.enc.Hex.parse(hex));💡 语法糖小技巧:WordArray 实例的 toString 方法
当一个对象已经是
WordArray 时,直接调用 wordArray.toString(CryptoJS.enc.Base64) 或 wordArray.toString(CryptoJS.enc.Hex) 等同于 CryptoJS.enc[Format].stringify(wordArray)。如果不传入任何编码器参数,wordArray.toString() 默认会采用 CryptoJS.enc.Hex 输出。
三、标准三步操作流程与异常防御
在实际工程中,外部传入的 Hex 或 Base64 字符串往往包含空格、换行符、URL 安全替换字符,甚至是不对齐的奇数位 Hex。如果不做校验直接解析,可能引发难以定位的静默错误。
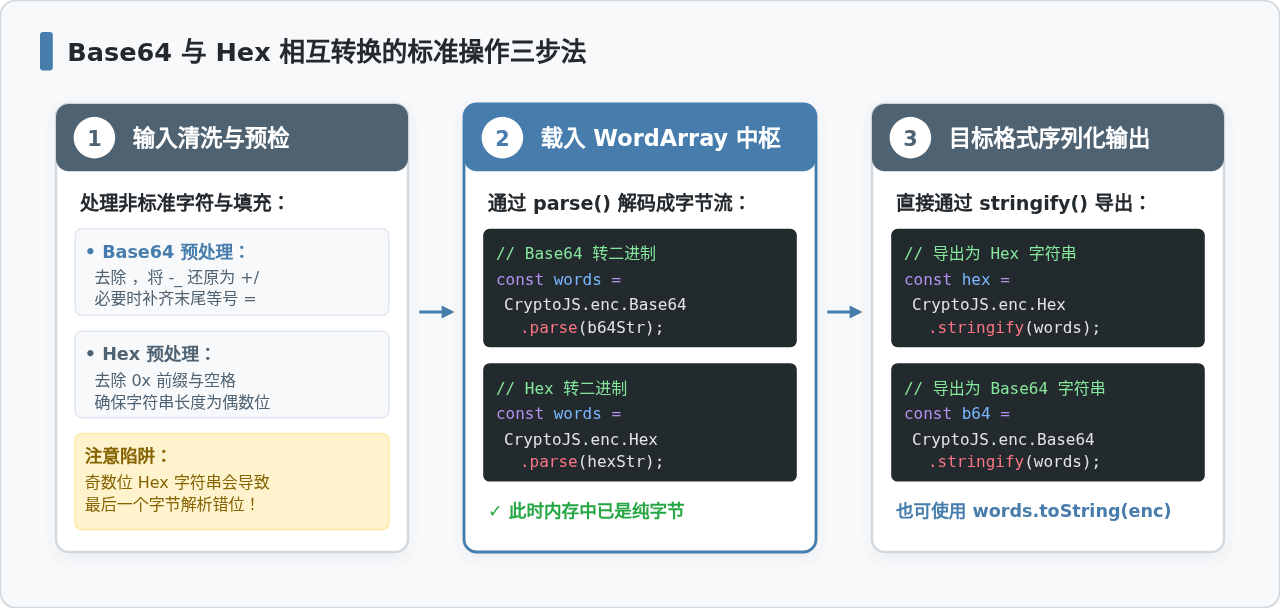
完整的防御性转换函数实现如下:
const CryptoJS = require("crypto-js");

/**
 * 健壮地将 Base64 转换为 Hex 字符串
 * 兼顾 URL-Safe Base64 格式及缺失的尾部填充
 */
function safeBase64ToHex(input) {
  if (!input || typeof input !== "string") {
    return "";
  }

  // 步骤一:清洗与格式规整
  let cleanB64 = input.trim()
    .replace(/-/g, "+")
    .replace(/_/g, "/");

  // 补齐缺失的 '=' 填充符
  while (cleanB64.length % 4 !== 0) {
    cleanB64 += "=";
  }

  // 步骤二与三:中枢解析与输出
  const words = CryptoJS.enc.Base64.parse(cleanB64);
  return CryptoJS.enc.Hex.stringify(words);
}

/**
 * 健壮地将 Hex 转换为 Base64 字符串
 * 自动清理 0x 前缀,补全奇数位
 */
function safeHexToBase64(input) {
  if (!input || typeof input !== "string") {
    return "";
  }

  // 步骤一:去除常见前缀与多余空格
  let cleanHex = input.trim().replace(/^0x/i, "").replace(/\s+/g, "");

  // 奇数位 Hex 必须在头部或尾部补位(依据协议要求通常在左侧补 0)
  if (cleanHex.length % 2 !== 0) {
    cleanHex = "0" + cleanHex;
  }

  // 步骤二与三:中枢解析与输出
  const words = CryptoJS.enc.Hex.parse(cleanHex);
  return CryptoJS.enc.Base64.stringify(words);
}
四、致命误区剖析:为什么绝不能使用 UTF-8 中转?
在初学者的代码中,最容易出现以下这类写法:
// 典型错误示范:千万不要这么写!
const words = CryptoJS.enc.Base64.parse(b64Cipher);
const brokenStr = CryptoJS.enc.Utf8.stringify(words); // 致命错误:强行当作 UTF-8 解码!
const hex = CryptoJS.enc.Hex.stringify(CryptoJS.enc.Utf8.parse(brokenStr));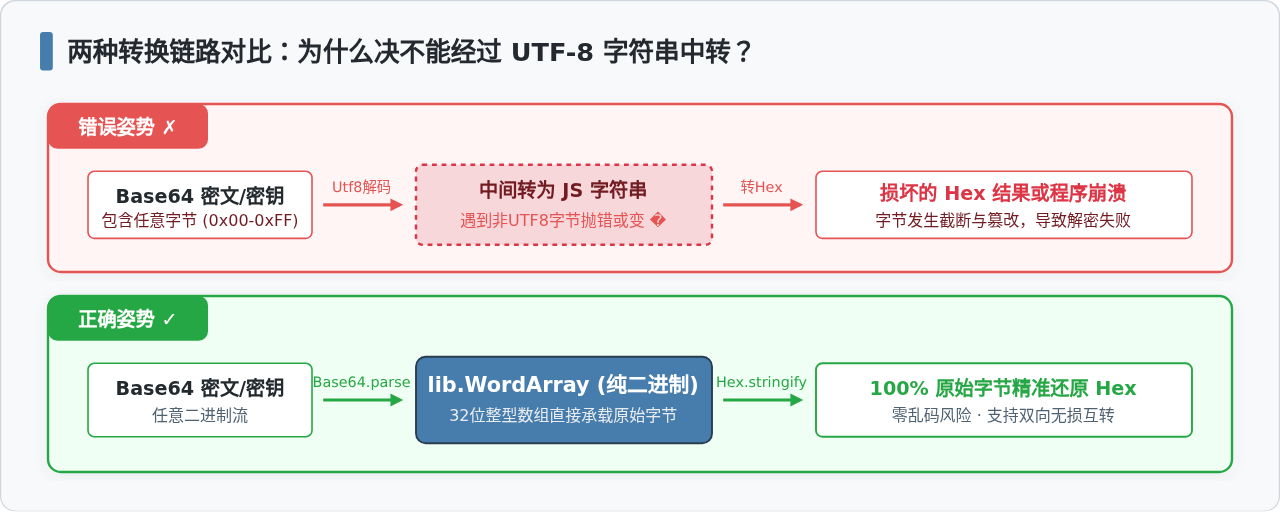
为什么这种写法是致命的?因为 UTF-8 是一种字符集编码规则,而非透明的字节通道:
- 合规校验约束:UTF-8 对连续字节有严格的高位规则(例如单字节以
0xxxxxxx开头,双字节以110xxxxx 10xxxxxx组合)。而加密密文、哈希值或随机构建的 AES 密钥,其字节在0x00 ~ 0xFF之间完全随机分布。 - 字节截断与替换:当
CryptoJS.enc.Utf8.stringify()遇到不符合 UTF-8 格式的非法字节序列时,JavaScript 引擎或解码函数会将其替换为 Unicode 替代字符(�),或者直接抛出Malformed UTF-8 data异常。 - 不可逆的数据损坏:一旦原始字节被替换,后续再调用
CryptoJS.enc.Utf8.parse()生成的字节已经不再是最初的字节序列,导致解密完全失败。
五、算法输出(Hash / AES)的直接转换姿势
除了纯文本转码,许多人在做摘要签名(如 MD5、SHA256)或对对称加密(AES)结果取值时,常常反复做无谓的字符串解析。
1. 散列计算输出 Hex 与 Base64
计算哈希时,CryptoJS.SHA256() 返回的就是一个 WordArray。可以直接输出为 Hex 或 Base64:
const message = "Hello, World!";
const hashWords = CryptoJS.SHA256(message);

// 默认输出是 Hex(长度为 64 个字符)
const hashHex = hashWords.toString(); // 等价于 hashWords.toString(CryptoJS.enc.Hex)

// 直接输出为 Base64(长度为 44 个字符)
const hashBase64 = hashWords.toString(CryptoJS.enc.Base64);

console.log("Hex:   ", hashHex);
console.log("Base64:", hashBase64);
2. AES 加密输出 Hex 与 Base64
调用 CryptoJS.AES.encrypt() 返回的是一个 CipherParams 对象,它包装了密文(ciphertext,一个 WordArray):
const key = CryptoJS.enc.Utf8.parse("1234567890123456");
const encrypted = CryptoJS.AES.encrypt("用户敏感数据", key, {
  mode: CryptoJS.mode.ECB,
  padding: CryptoJS.pad.Pkcs7
});

// 1. 默认 toString() 输出的是 Base64 格式密文
const cipherBase64 = encrypted.toString();

// 2. 如果接口需要 Hex 密文,直接从 ciphertext 取值转为 Hex,切勿先 toString 再转!
const cipherHex = encrypted.ciphertext.toString(CryptoJS.enc.Hex);

console.log("Base64 密文:", cipherBase64);
console.log("Hex 密文:   ", cipherHex);
六、高频场景与 API 速查矩阵
为了便于在日常开发中查阅与规范代码,下表与图示总结了 crypto-js 中涉及 Hex 与 Base64 互转的标准调用方式。
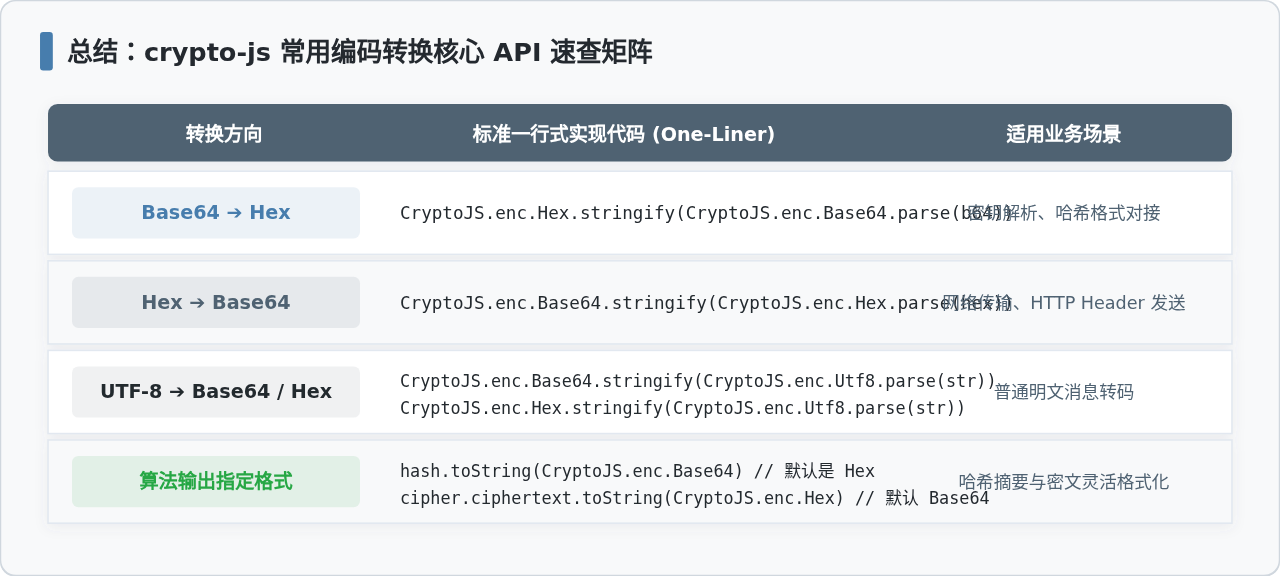
| 输入格式 | 目标格式 | 标准调用方法 | 注意事项 |
|---|---|---|---|
| Base64 字符串 | Hex 字符串 | CryptoJS.enc.Hex.stringify(CryptoJS.enc.Base64.parse(s)) |
确保已去除 URL-safe 替换符(- 与 _) |
| Hex 字符串 | Base64 字符串 | CryptoJS.enc.Base64.stringify(CryptoJS.enc.Hex.parse(s)) |
确保 Hex 长度为偶数位;若有 0x 应先剔除 |
| UTF-8 明文 | Base64 字符串 | CryptoJS.enc.Base64.stringify(CryptoJS.enc.Utf8.parse(s)) |
仅用于正常人类可读文本的转码 |
| UTF-8 明文 | Hex 字符串 | CryptoJS.enc.Hex.stringify(CryptoJS.enc.Utf8.parse(s)) |
每个中文字符在 UTF-8 下对应 3 个字节(6 个十六进制字符) |
| WordArray 二进制 | Base64 / Hex | words.toString(CryptoJS.enc.Base64) / words.toString() |
不带参数时默认序列化为 Hex |
✓ 核心要决记忆法则
输入无论是什么格式,统一用
parse() 变回 WordArray;输出需要什么格式,统一用 stringify() 输出目标字符串。紧扣 WordArray 二进制中枢,即可彻底杜绝编码转换中的乱码与数据损坏。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章