

深入解析JavaScript中编码、加密与混淆的本质区别,详细剖析在线解密工具的工作原理,以及在线解密到底能还原哪些内容、哪些内容属于永久不可逆的物理边界。
JS混淆、加密与编码的区别:在线解密能还原哪些内容
作者:缓存笔记
时间:2026-11-03
浏览:346
文章目录
技术深度对比
适用场景:前端安全 · 逆向工程 · 代码审计
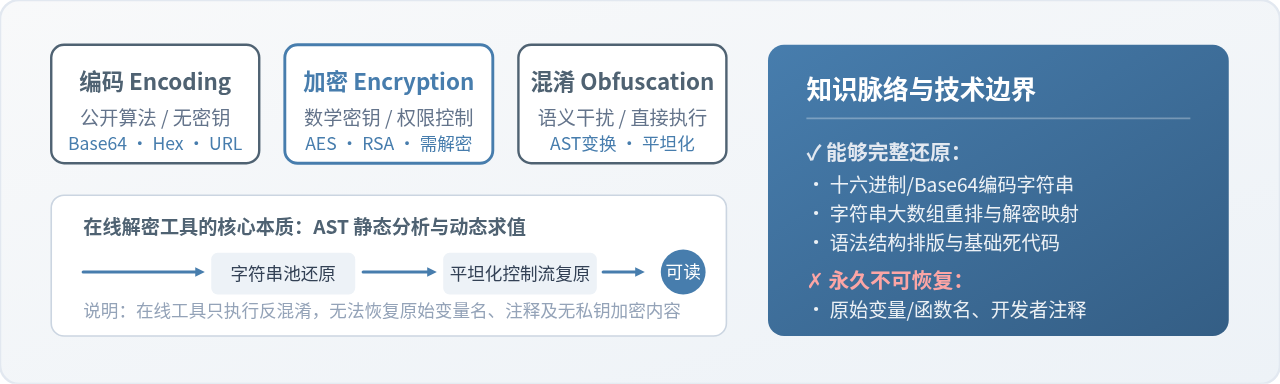
图 0:JS 编码、加密、混淆机制与在线解密还原边界概览
在日常前端开发与接口调试中,面对被大量十六进制字符、不可读变量名和复杂跳转包裹的代码,许多人习惯将其笼统地称为“加密代码”,并寄希望于各大“在线JS解密平台”一键还原源码。然而,编码(Encoding)、加密(Encryption)与混淆(Obfuscation)在计算机科学中存在严格的数学与工程边界。所谓“在线解密工具”,其底层本质几乎全部是基于 AST(抽象语法树)的反混淆重构与字面量求值。本文将清晰拆解三者的技术本质,并详细说明在线工具到底能还原哪些内容,以及哪些信息属于永久不可逆的物理丢失。
一、编码、加密与混淆:本质差异与运行机制
要判断一段代码能否被解密,必须先明确它到底经历了哪种处理。很多时候,大家以为代码被“加密”了,其实它只是被编码或进行了语法混淆。
1. 编码(Encoding):数据格式的公开转换
编码的核心目的是兼容传输媒介与协议,解决特殊字符、二进制字节在不同网络通道中传输时的丢失或转义问题。例如,Base64 将任意 8 位二进制字节转换为可打印的 64 个 ASCII 字符;URL 编码(Percent-encoding)将空格和斜杠转化为 %20 和 %2F;JavaScript 源码中的十六进制转义(ab)则是将字符以其 ASCII 码的十六进制表示。
编码的核心特点是:算法完全公开,没有任何密钥或访问控制机制。任何人只要知道采用的是何种编码格式,都可以使用对应的标准算法 100% 无损还原原始数据。
2. 加密(Encryption):基于密钥的数学机密性保障
加密的根本目的是数据的保密性。它通过密码学算法(如对称加密 AES、ChaCha20,或非对称加密 RSA、ECC)结合高强度的秘密密钥(Key),将明文映射为统计学上随机分布的密文。
加密的核心特征在于:安全性完全依赖于密钥的保密性,而非算法的保密性。如果不知道密钥,即便是世界上最顶级的超级计算机,也无法在有限时间内还原密文。更关键的一点在于浏览器执行环境:V8 等主流 JavaScript 引擎无法直接执行密文。如果一段 JS 代码真正被 AES 加密了,浏览器在运行它之前,必须在客户端内存中通过 JS 解释器或 WebAssembly 将其解密为明文字符串,再通过 eval() 或 new Function() 动态执行。
3. 混淆(Obfuscation):保持可执行性的语法语义混淆
混淆的主要诉求是提高代码逆向分析的门槛,保护商业逻辑。混淆器(如 JavaScript-Obfuscator、Terser、UglifyJS 等)会对合法的 JavaScript AST 语法树进行等价变换:将具有业务语义的变量名重命名为无规律的随机字符(如 _0x4a1b),将连续的控制流打散进复杂的 switch-case 状态机,将常规字符串提取到外部大数组并通过动态函数索引计算调用。
混淆的关键特征是:混淆后的代码依然是 100% 合法且能被浏览器直接执行的 JavaScript 代码。它不需要任何解密密钥,V8 引擎直接读取即可直接运行。
| 对比维度 | 编码 (Encoding) | 加密 (Encryption) | 混淆 (Obfuscation) |
|---|---|---|---|
| 核心目标 | 传输兼容、格式转换 | 机密性保护、权限受控 | 增加人眼阅读难度、防逆向 |
| 是否依赖密钥 | 完全无密钥 | 严格依赖密钥 (Key) | 无密钥(可附加自执行解密壳) |
| 引擎能否直接执行 | 不能(需解码) | 不能(密文非合法语法) | 能直接被 JS 引擎执行 |
| 典型算法/工具 | Base64, Hex, URL Encode | AES-256, RSA, ChaCha20 | Terser, JS-Obfuscator, Sojson |
| 可逆性与还原难度 | 100% 完全可逆,零门槛 | 无密钥数学上不可逆 | 结构可反混淆,变量名不可逆 |
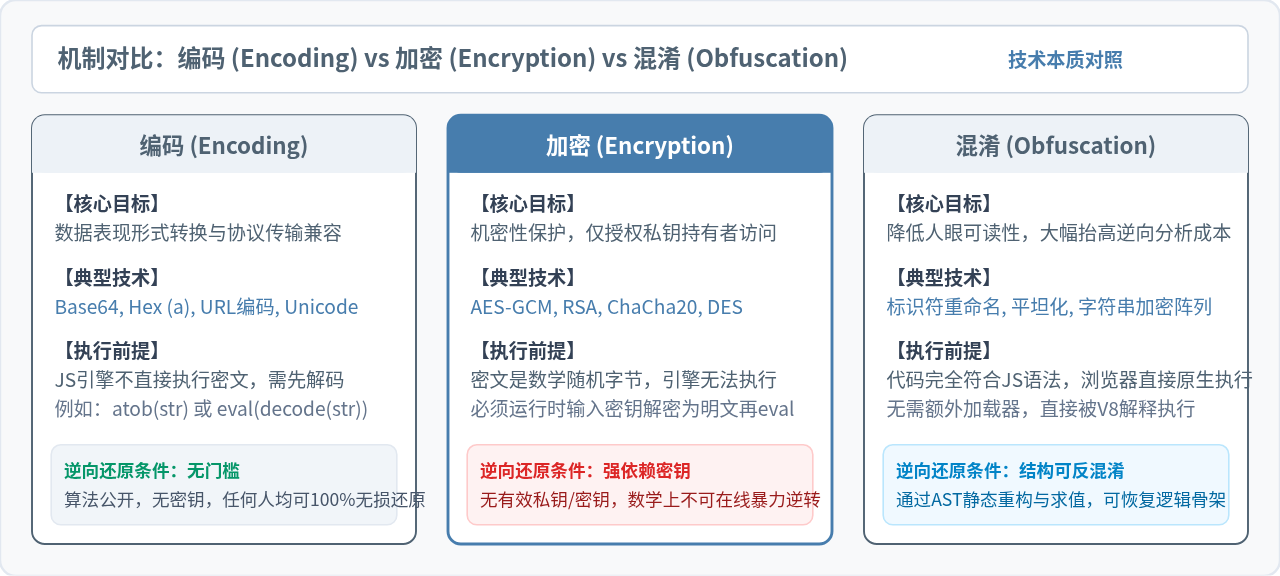
图 1:编码、加密与混淆三者的核心机制与执行链路对比
二、为什么“在线JS解密”本质上是“语法树反混淆”?
在网络上搜索“JS 在线解密”,会弹出大量在线工具站点。很多人感到困惑:既然是“加密”,为什么把代码粘贴进去,点击一个按钮就能“解密”出可读的逻辑?
答案很简单:网络上绝大多数声称“解密”的工具,处理的根本不是真正的密码学加密,而是前端代码混淆。这里存在一个最基础的前端运行逻辑:浏览器要执行一段代码,就必须在运行时刻知道这段代码想干什么。如果一段代码无需用户输入密码就能在浏览器里正常工作,就意味着执行它所必需的一切逻辑(包括字符串提取算法、执行顺序分发器)都已经明明白白地放在了这段 JavaScript 源码本身里。
在线反混淆工具的工作流程正是利用了这一特性。它们不会去暴力破解所谓的加密算法,而是通过成熟的编译原理技术,对 JavaScript 代码进行抽象语法树(AST)静态遍历与动态仿真:
- 词法分析与 AST 构建:使用如 Babel Parser、Acorn 等语法解析器,将代码字符串解析成由
Identifier(标识符)、CallExpression(函数调用)、SwitchStatement(分支语句)等构成的抽象语法树。 - 字符串数组提取与自执行位移计算:混淆代码通常会在顶部声明一个包含所有字符串的全局大数组(如
_0x12ab = ['login', 'POST', ...]),紧接着一个立即执行函数(IIFE)对数组进行元素移位。在线工具会静态提取该数组并在沙箱中执行移位算法,得到正确的字符串索引映射表。 - 解密包装函数求值与字面量内联:在 AST 中搜索所有指向解密函数的调用节点(例如
_0x2b(0x1)),用沙箱执行得到其计算结果'POST',随后直接将该调用节点替换为原生字符串字面量StringLiteral("POST")。 - 控制流平坦化重构:混淆器常用
while(true) { switch(arr[i++]) { ... } }打乱代码执行顺序。在线工具解析出分发控制变量的跳转序列后,提取各个case块中的语句,按实际执行顺序串联重组,消除冗余的循环和分支。 - 代码净化与格式化输出:剔除未引用的解密辅助函数和死代码分支,通过代码生成器按缩进规范输出排版整齐的 JavaScript 代码。
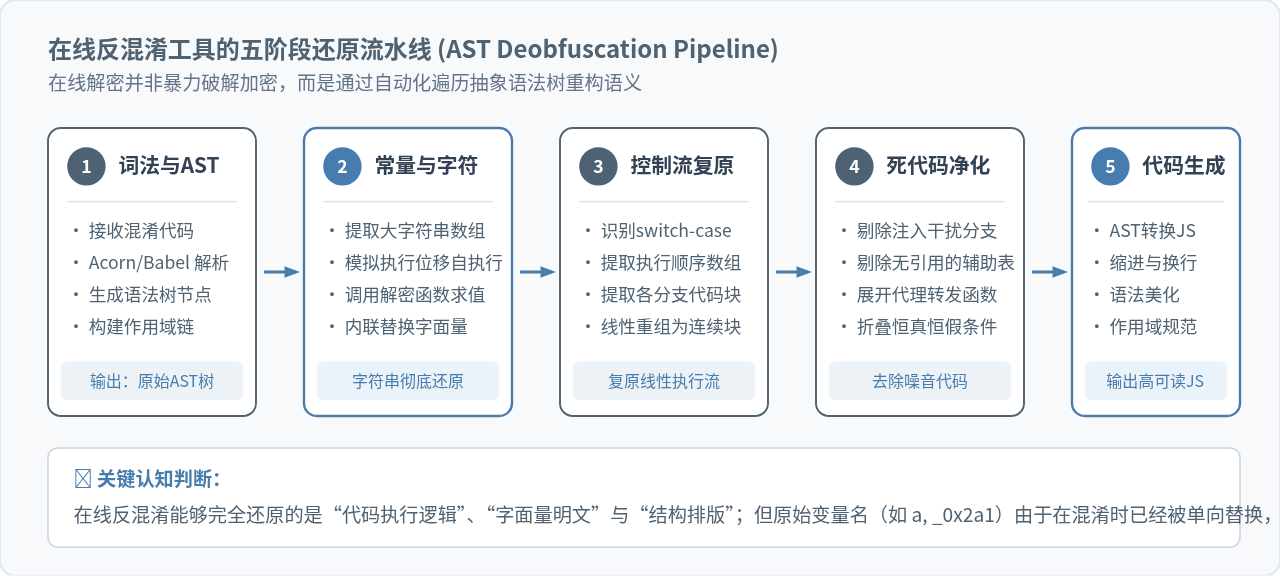
图 2:在线反混淆工具的五阶段还原流水线 (AST Deobfuscation Pipeline)
三、实测盘点:在线解密工具到底能还原哪些内容?
为了让读者直观理解解密工具的能力边界,我们来看一个典型的混淆代码片段以及经过在线工具处理后的还原对比。
假设原始代码在进行混淆后呈现如下形态:
// 经过混淆后的前端代码
var _0x4d12 = ['login', 'POST', 'api/v1'];
function _0x2b(a, b) {
  return _0x4d12[a - 0x0];
}
var _0x51c = "1|0|2".split('|'), _0x1 = 0;
while (true) {
  switch (_0x51c[_0x1++]) {
    case '0': req.send(payload); continue;
    case '1': req.open(_0x2b(1), _0x2b(2) + '/' + _0x2b(0)); continue;
    case '2': return true;
  }
}
将这段代码丢入成熟的在线解密/反混淆工具后,输出的结果通常如下:
// 在线工具还原后的代码形态
req.open("POST", "api/v1/login");
req.send(payload);
return true;
从上面的对比可以清晰看出,在线反混淆工具具有以下极高确定性的还原能力:
- 1. 转义编码与 Base64 字符串 100% 明文化:十六进制形式(如
POST)以及 Unicode 转义,会在 AST 转换阶段直接解析为明文字符串"POST"。 - 2. 字符串数组抽离与解密映射调用彻底清除:混淆代码用来掩盖请求接口名、参数名的
_0x2b(1)等间接调用,全被替换成了直接的字符串常量,开发者一眼就能看清接口地址与提交参数。 - 3. 代理包装函数自动内联:混淆器为了干扰静态分析,常把简单的二元加法写成
function _0xadd(a, b) { return a + b; }。反混淆工具能够扫描出纯函数包装器,将其直接内联替换回a + b。 - 4. 控制流平坦化大幅重组:原本被打散在
while-switch状态机里的执行步骤,被按照真实的分发序列提取出来,重新整理成自上而下的线性结构。 - 5. 代码排版格式完全复原:压缩成一整行、去掉所有换行的代码,会被重新添加科学的缩进、空行和花括号匹配,使结构清晰易读。
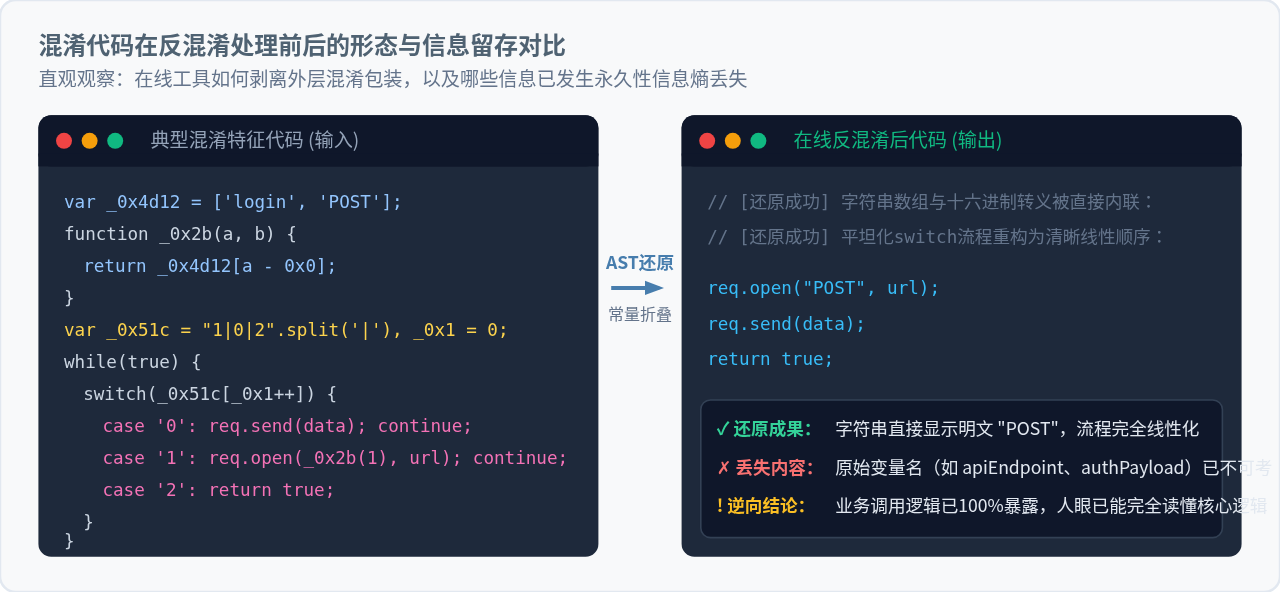
图 3:反混淆还原能力实例对照:代码转换与解析深度
四、无法跨越的边界:哪些内容在线解密永远无法还原?
很多初学者在使用在线解密工具后,常常追问:“为什么解出来的代码里,变量名还是 a、b、_0x1a?原作者写的 userAuthToken 到哪里去了?”
必须明确指出:在编译与混淆工程中,存在真正不可逆的“单向信息丢弃”。在线工具哪怕算法再强大,也无法凭空还原以下内容:
1. 原始变量名、函数名与类名(标识符语义)
混淆器(以及基础的压缩打包器 Webpack / Vite)在处理源码时,会将局部作用域内的所有标识符替换成短字符或随机字符(如 e, t, n, _0x2a1b)。在生成最终 JS 文件的那一刻起,原始变量名与混淆变量名之间的映射表(Source Map)已经被剥离,根本没有跟随 JS 文件发布到生产环境。
对于反混淆工具来说,它面对的只是一段合法的 AST。它知道这是一个变量,但这个变量在原作者电脑里到底叫 userPassword 还是 loginCounter,数学上属于信息熵的彻底丢失。在线工具至多根据常见特征给出类似 param1、func1 的格式化重命名,绝不可能原样找回作者最初定义的变量名。
2. 源码中的所有注释与文档说明
不管是单行注释 // 还是 JSDoc 块级注释 /** ... */,在现代打包工具词法分析(Lexer)的第一步就会被直接剔除。最终下发给客户端的 JS 文件里压根没有这些字符,任何解密工具都无法“还原”不存在于输入文件中的信息。
3. 编译优化消除的工程架构与模块分界
现代前端工程采用 TypeScript、Babel、Rollup 等工具。经过 Tree-shaking(摇树优化)、作用域提升(Scope Hoisting)和常量折叠后,原有的多个组件文件会被缝合成一个紧凑的闭包,冗余的类与接口定义被抹平。反混淆工具只能还原出可读的纯 JavaScript,无法还原出最初的 Vue / React 模板结构或 TypeScript 类型注解。
4. 真加密且私钥未下发的安全数据
如果前端代码中包含一段用 RSA 公钥加密后的密文,或者从服务端下发了一段用 AES 加密的业务逻辑,而解密私钥始终保存在后端服务器上,那么任何前端在线解密工具面对该密文均束手无策。这类场景属于真正意义上的密码学保护,不存在“反混淆破译”的可能。
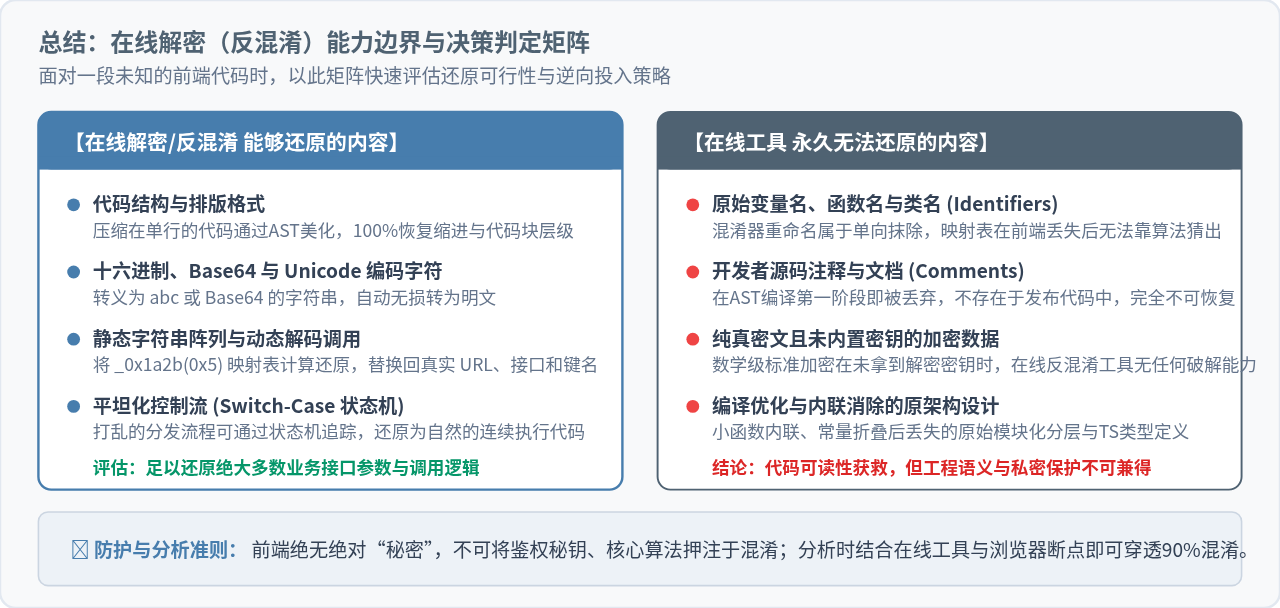
图 4:在线解密(反混淆)能力边界与决策判定总结矩阵
五、常见混淆类型的应对与分析建议
在面对不同类型的混淆与防护手段时,机械地依赖单一在线工具往往容易遇到瓶颈。结合实际工程经验,可按以下建议进行排查与分析:
📌 实用分析方法
- 先做代码格式化:拿到混淆代码的第一步,不要盲目找各种破解站。先利用浏览器开发者工具(F12)自带的 Pretty-print(代码美化,即大括号
{}按钮)对代码进行换行与缩进。很多所谓的“加密”,格式化后立刻原形毕露。 - 识别混淆器特征:如果看到顶部带有大量十六进制数组和
shift()/push()自执行函数,通常是javascript-obfuscator或类似变体。此时使用基于 Babel 的专用反混淆脚本,即可快速恢复字符串。 - 善用浏览器控制台动态求值:混淆代码最难读的是它的字符串解码函数。既然代码可以在浏览器中无报错运行,直接在 Console 控制台中输入其解密函数名加参数(如
_0x2b(0x1)),浏览器引擎会立刻返回真实的解密字符串,无需手动逆向其内部的异或与位移算法。
⚠️ 前端安全核心警示
对于前端开发者而言:永远不要将混淆等同于安全。由于 JavaScript 运行在客户端这一天然属性,只要业务代码能够在浏览器中被执行,就意味着它的一切参数组装、签名计算和接口逻辑都可以通过反混淆与断点调试被完整还原。切勿在前端代码中存放任何数据库密码、支付私钥或核心验签秘钥;真正的安全控制必须全部由后端鉴权与服务网关来保障。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章