

深入解析JavaScript在检测浏览器环境时应对User-Agent伪造的系统化方案。涵盖能力检测优先原则、User-Agent Client Hints规范应用、多维硬件特征交叉核验、原型链原生性描述符审计及端网协同安全防御。
JS检测浏览器时怎么处理User-Agent伪造问题
作者:小圆点
时间:2026-11-18
浏览:636
文章目录
WEB RUNTIME SECURITY // 前端运行环境安全
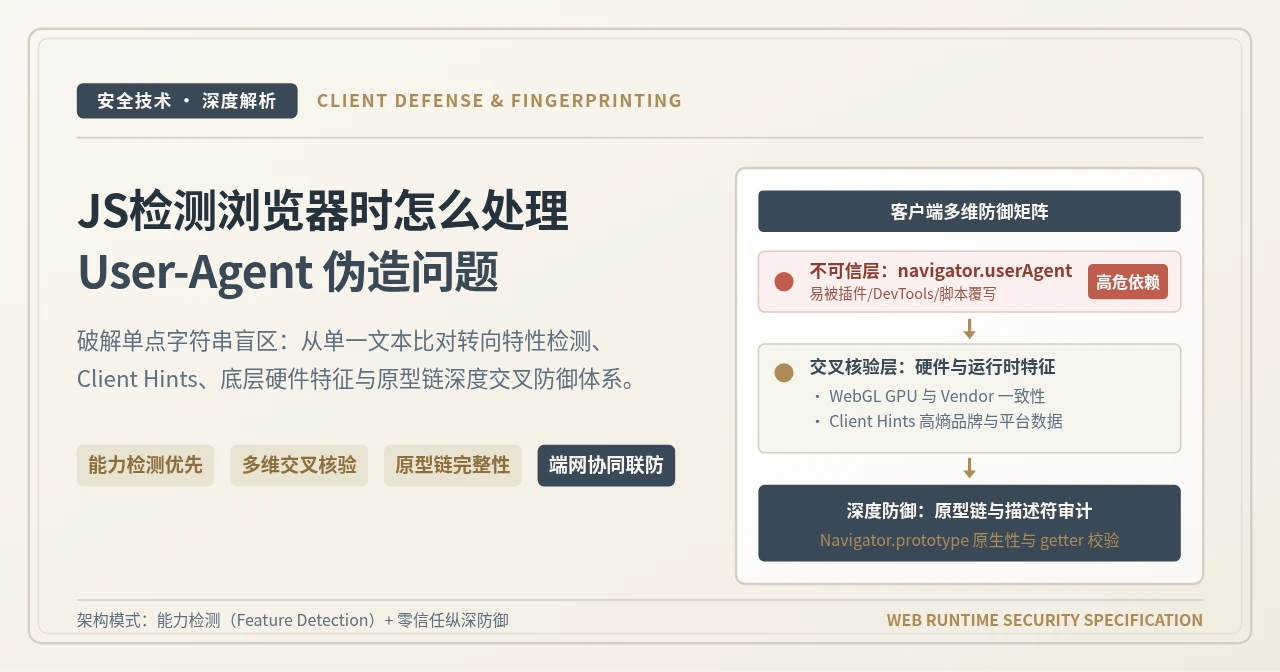
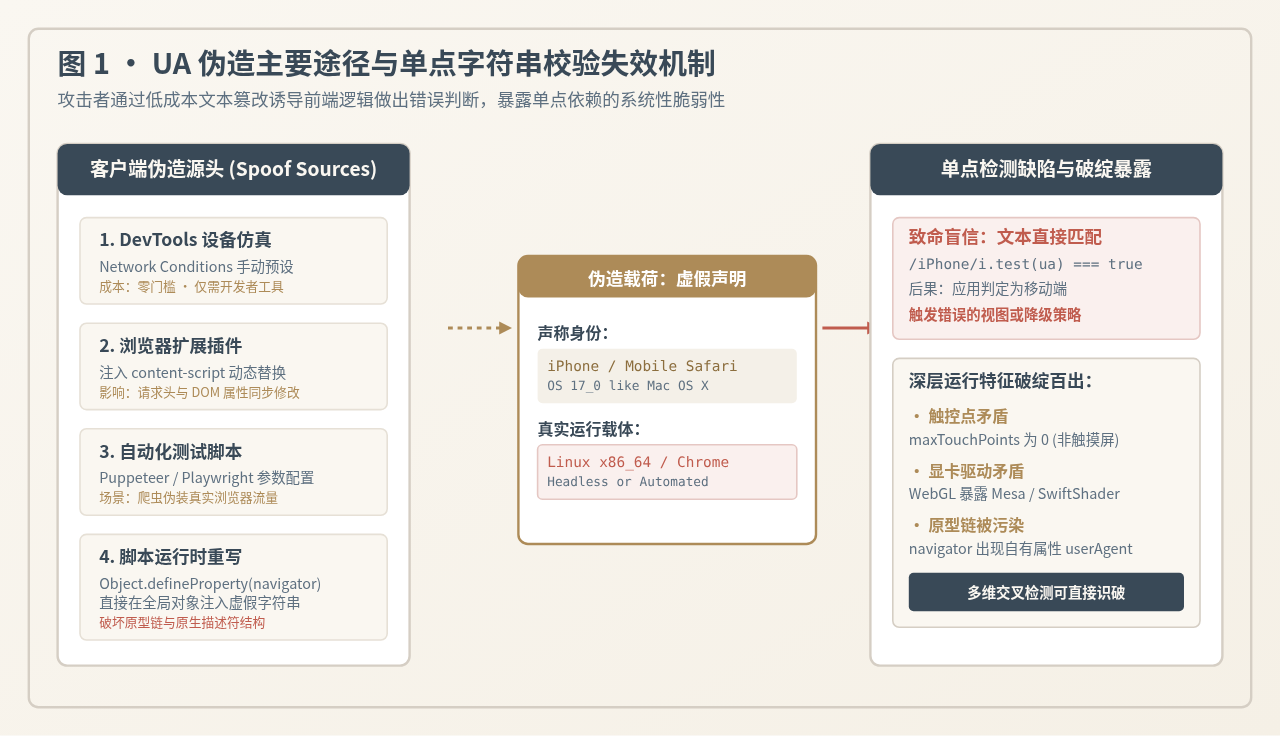
图 1 核心解析:展示了从客户端发起 UA 伪造的四大源头,到中间虚假声明传输,以及单点字符串正则校验在面对底层硬件(如显卡、触控能力)矛盾时的必然破绽。
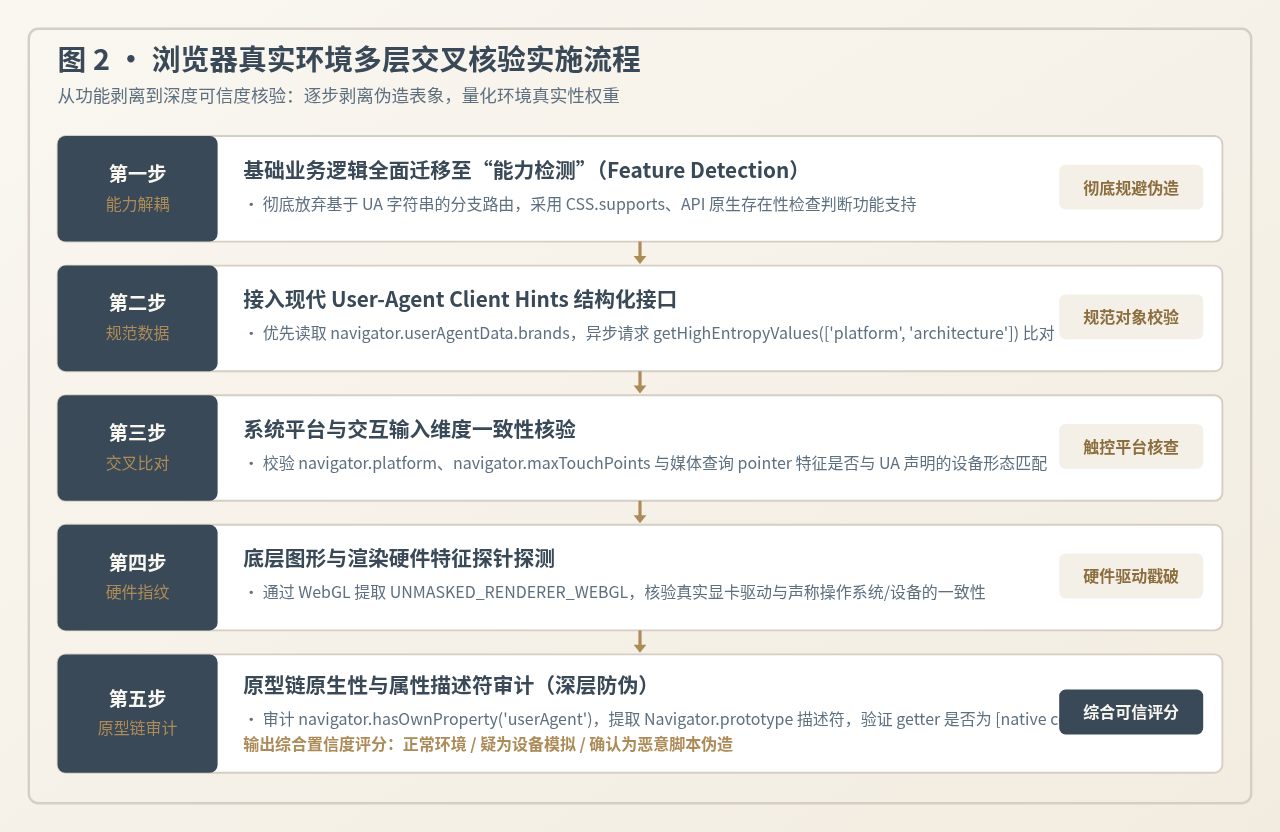
图 2 流程图解:展示了从能力解耦、Client Hints 数据提取、平台触控比对,到 WebGL 底层硬件探测与原型链审计的五步标准化校验推进流程。
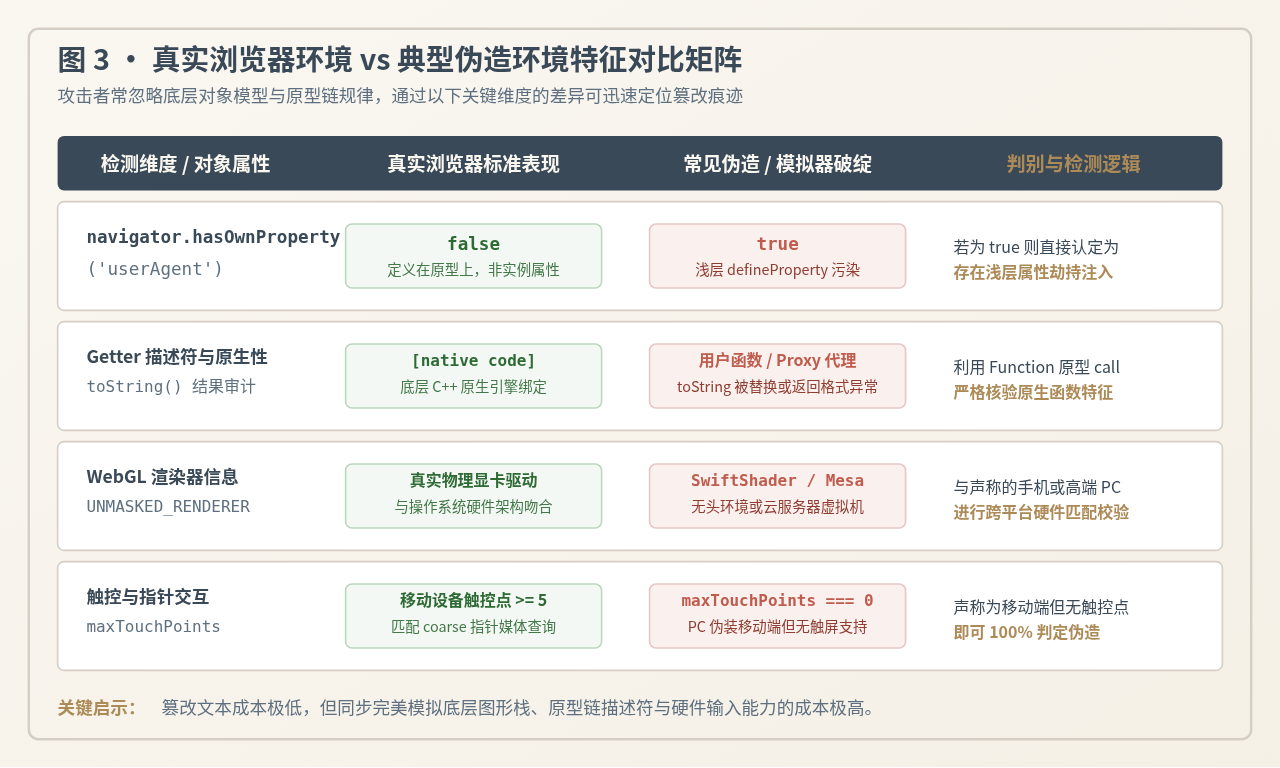
图 3 对比矩阵:全面罗列了原生标准环境与典型脚本注入环境下,在属性属主、原生代码标记、底层驱动以及指针支持等关键维度的技术差异与判定依据。
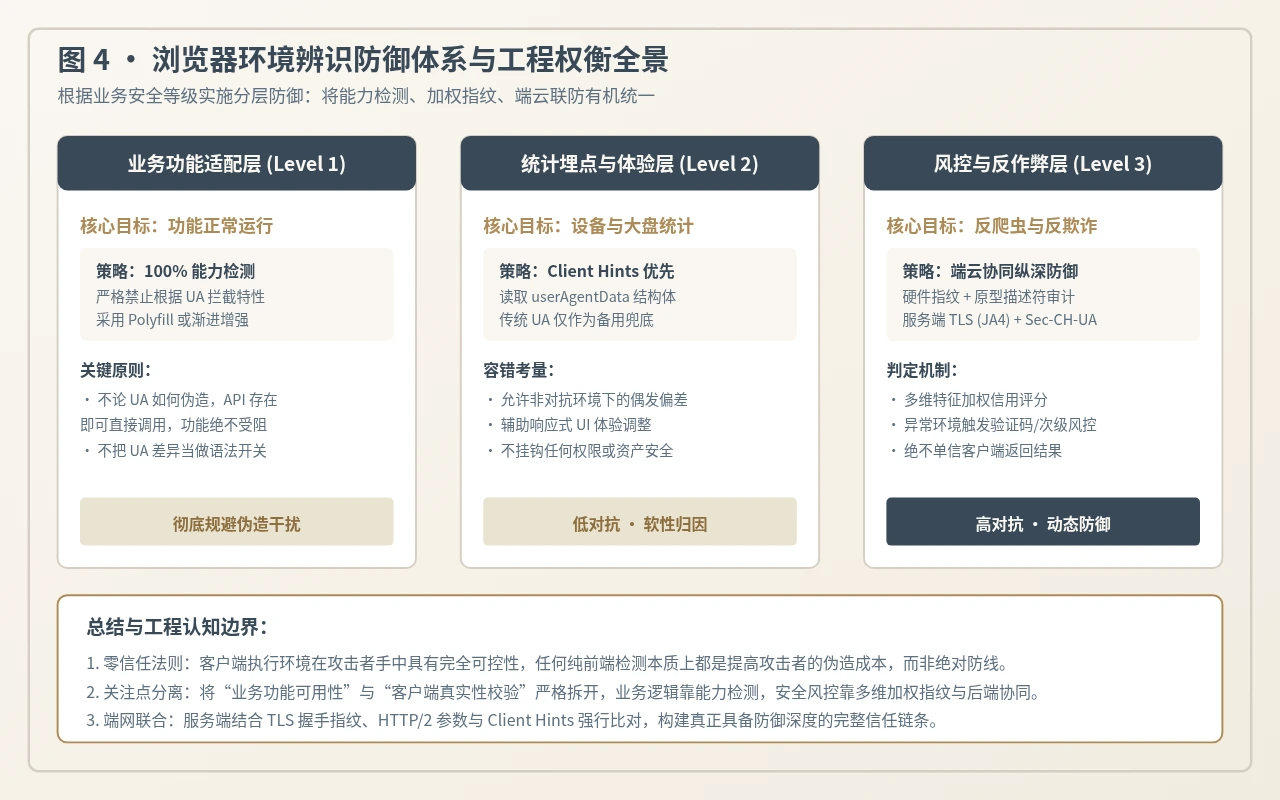
图 4 架构全景:归纳了业务功能、统计分析与风控反作弊三个层次的防御策略权衡,明确了零信任架构与端网协同的核心防护矩阵。
在现代 Web 应用中,单凭
navigator.userAgent 判断浏览器环境已完全不可靠。解决 User-Agent 伪造的根本思路是:在功能适配层面彻底摒弃“以 UA 猜功能”的做法,全面转向以 CSS.supports 和原生对象校验为核心的能力检测(Feature Detection);在设备识别与风控场景中,通过现代 User-Agent Client Hints、底层硬件特征(如 WebGL 显卡驱动)、交互输入特性以及原型链描述符审计构建多维交叉核验链路,并在高对抗场景下结合服务端网络协议特征进行协同防御。
一、User-Agent 伪造的常见途径与单点校验失效的根源
User-Agent(UA)本质上只是一段由客户端在 HTTP 请求头与 JavaScript 全局对象 navigator 中单方面声明的纯文本字符串。由于其生成与传输过程完全位于客户端控制之下,缺乏任何内置的防伪验签机制,攻击者或测试环境可以以极低的技术成本进行随意覆写。
在实际业务场景中,导致 JavaScript 获取到虚假 User-Agent 的途径主要有以下四种:
- 浏览器开发者工具仿真:Chrome 或 Edge DevTools 的“Network conditions”面板内置了设备模拟菜单,只需下拉选择即可秒级将 PC 端浏览器的 UA 替换为 iPhone Safari 或 Android Chrome。
- 浏览器扩展插件注入:各类“User-Agent Switcher”扩展利用
declarativeNetRequest接口重写网络请求头,并在 DOM 加载的最早阶段注入 content-script 修改全局navigator.userAgent。 - 自动化爬虫工具配置:Puppeteer、Playwright 等自动化测试框架提供开箱即用的
page.setUserAgent()方法,无需任何黑客手段即可批量伪造目标设备的特征字符串。 - 运行时脚本直接覆写:恶意脚本或第三方外挂脚本直接通过
Object.defineProperty(navigator, 'userAgent', { value: '...' })修改当前上下文的属性读取结果。
单点检测的失效之处在于:开发者往往将“客户端声明的字符串”等同于“当前宿主环境的物理真实能力”。当一段 PC 端的 Linux 爬虫通过修改 UA 声称自己是“运行在 iOS 上的 Mobile Safari”时,如果前端仅执行 /iPhone/i.test(navigator.userAgent),系统就会盲目放行并加载针对移动端优化的轻量逻辑,甚至绕过针对桌面爬虫的基础反作弊防线。
二、业务层面的核心策略:从“身份猜测”走向“能力检测”(Feature Detection)
在深入探讨如何识破伪造之前,必须首先对业务需求进行准确解耦:大部分在前端检测浏览器的需求,本质上并非为了获取“浏览器品牌名称”,而是为了判断“当前环境是否支持某项语法、API 或特定 CSS 样式”。
如果检测的目的仅仅是为了决定是否启用某项功能或是否加载 Polyfill,那么依赖 UA 字符串本身就是一种反模式。处理伪造最有效、成本最低的做法就是完全不理会 UA,直接进行“能力检测”。能力检测直接测试运行时实际暴露的对象、方法或属性,无论 UA 被伪造为何种字符串,不支持的 API 依然不存在,具备的特性依然可正常调用。
// ❌ 传统高危做法:依赖 UA 字符串判断浏览器及其版本并决定功能分支
function copyTextBad(text) {
  const isChrome = /Chrome\/([0-9]+)/.test(navigator.userAgent);
  if (isChrome) {
    navigator.clipboard.writeText(text); // 若攻击者伪造了 Chrome UA 但实际在不支持的旧环境中,将直接抛出 TypeError
  } else {
    legacyExecCopy(text);
  }
}

// ✅ 推荐现代解法:无视 UA,直接探测当前宿主提供的原生能力(Feature Detection)
async function copyTextGood(text) {
  if (navigator.clipboard && typeof navigator.clipboard.writeText === 'function') {
    try {
      await navigator.clipboard.writeText(text);
      return true;
    } catch (err) {
      return legacyExecCopy(text);
    }
  }
  return legacyExecCopy(text);
}

// ✅ CSS 样式支持检测:使用标准 CSS.supports 接口
const supportsContainerQueries = window.CSS && CSS.supports('container-type', 'inline-size');
const supportsBackdropFilter = window.CSS && CSS.supports('backdrop-filter', 'blur(10px)');
工程设计准则
只要能够通过 typeof window.SomeAPI !== 'undefined' 或 CSS.supports(...) 直接验证的具体功能,绝不允许引入任何基于 navigator.userAgent 的正则逻辑。这一步能直接将 90% 以上的日常业务功能从 UA 伪造风险中解救出来。
三、设备与环境识别场景:多维特征交叉验证的实施步骤
然而,在风控反作弊、设备指纹分析、数据埋点归因以及特定客户端专有引导等场景中,系统确实需要准确知晓用户当前运行的真实设备类型。此时,单一维度无法提供信任基础,必须建立一套多维属性交叉验证链路。
这套实施流程的核心思想是:伪造一段字符串容易,但要在受限的浏览器沙箱内同步伪造整套操作系统底层的硬件拓扑、图形渲染器与交互行为,成本呈指数级上升。
步骤一:提取现代 User-Agent Client Hints 结构化对象
在现代 Chromium 内核浏览器中,W3C 推出了更具结构化的 Client Hints API(即 navigator.userAgentData)。传统的伪造扩展通常仅劫持 navigator.userAgent 字符串,往往忽略对 userAgentData 的深度同步。通过比对 userAgentData.brands 以及异步获取高熵值(High Entropy Values),可以形成第一道校验屏障:
async function verifyClientHints(claimedBrowser) {
  if (!navigator.userAgentData) {
    // 非 Chromium 内核(如 Safari/Firefox)或旧版本环境,降级执行后续步骤
    return { supported: false };
  }

  const brands = navigator.userAgentData.brands.map(b => b.brand);
  // 获取高熵信息进行深层核验
  const highEntropy = await navigator.userAgentData.getHighEntropyValues([
    'platform',
    'platformVersion',
    'architecture',
    'model'
  ]);

  return {
    supported: true,
    brands,
    platform: highEntropy.platform,
    architecture: highEntropy.architecture,
    isMobile: navigator.userAgentData.mobile
  };
}
步骤二:比对操作系统平台与触控输入维度
当 UA 字符串声称为“iPhone”或“Android”移动设备时,系统必须核验该设备在物理上是否具备触摸交互能力。如果一个声称是 iPhone 的浏览器其实运行在攻击者的 PC 桌面端,navigator.maxTouchPoints 通常为 0,并且媒体查询 (pointer: coarse) 不匹配:
function checkTouchConsistency(isClaimedMobile) {
  const maxTouchPoints = navigator.maxTouchPoints || 0;
  const hasTouchEvent = 'ontouchstart' in window;
  const matchCoarse = window.matchMedia && window.matchMedia('(pointer: coarse)').matches;

  if (isClaimedMobile) {
    // 现代移动设备触控点数通常大于等于 1(iOS/Android 真实设备普遍 >= 5)
    if (maxTouchPoints === 0 && !hasTouchEvent) {
      return { valid: false, reason: '声称移动端但无任何触控硬件支持' };
    }
  }
  return { valid: true, maxTouchPoints, matchCoarse };
}
步骤三:探测 WebGL 底层图形驱动与渲染引擎
WebGL API 允许 JavaScript 与底层的 GPU 驱动进行直接握手。通过 WEBGL_debug_renderer_info 扩展提取出的渲染器信息(Renderer)是由显卡固件和操作系统图形驱动决定的。攻击者即便在浏览器层把 UA 改写成了苹果手机,显卡驱动仍然会暴露 ANGLE (NVIDIA ...) 或 Linux 虚拟机的 SwiftShader / Mesa Gallium 软件渲染器,从而瞬间戳破伪装:
function getGPUFingerprint() {
  try {
    const canvas = document.createElement('canvas');
    const gl = canvas.getContext('webgl') || canvas.getContext('experimental-webgl');
    if (!gl) return null;

    const debugInfo = gl.getExtension('WEBGL_debug_renderer_info');
    if (!debugInfo) return null;

    const vendor = gl.getParameter(debugInfo.UNMASKED_VENDOR_WEBGL);
    const renderer = gl.getParameter(debugInfo.UNMASKED_RENDERER_WEBGL);

    return { vendor, renderer };
  } catch (e) {
    return null;
  }
}

// 校验逻辑示例
const gpu = getGPUFingerprint();
const ua = navigator.userAgent;
if (/iPhone|iPad/i.test(ua)) {
  // 真实的 iOS 移动设备 GPU 渲染器必须为 Apple GPU,绝不可能出现 NVIDIA、Intel 或 SwiftShader
  if (gpu && (gpu.renderer.includes('NVIDIA') || gpu.renderer.includes('SwiftShader') || gpu.renderer.includes('Intel'))) {
    console.warn('捕获到 User-Agent 伪造:声称 iOS 但 GPU 显卡暴露桌面环境特征!');
  }
}
四、进阶防御:原型链与属性描述符的底层防伪审计
大部分注入脚本或第三方修改库(如早期的插件)往往使用 Object.defineProperty 强行覆盖全局 navigator 对象的字段。这种粗糙的篡改方式会在 JavaScript 引擎的原型继承结构中留下明显的特征畸变。
通过对原型链和底层函数描述符进行严谨的断言审计,可以有效发现浅层注入行为:
1. 属性属主检查(OwnProperty Check)
在标准浏览器实现中,userAgent 属性是定义在 Navigator.prototype 原型对象上的 Accessor(访问器属性),而不是 navigator 实例自身的自有属性。因此,直接在实例上检测自有属性是识破浅层注入的第一步:
// 真实环境下,navigator 实例自身并不拥有 userAgent 属性,而是通过原型链委托读取
const isDirectlyOverridden = Object.prototype.hasOwnProperty.call(navigator, 'userAgent');
if (isDirectlyOverridden) {
  console.warn('环境异常:navigator 存在自有属性 userAgent,极可能是浅层 defineProperty 注入!');
}
2. 属性描述符与原生 getter 校验
真实的 userAgent 必须具备定义在 Navigator.prototype 上的原生 getter 函数,且不包含独立的 value 字段。我们可以利用未被污染的 Function.prototype.toString 来检验 getter 函数的源码表示是否为受信任的原生绑定:
function auditPrototypeIntegrity() {
  const descriptor = Object.getOwnPropertyDescriptor(Navigator.prototype, 'userAgent');

  if (!descriptor) {
    return { passed: false, reason: 'Navigator.prototype 上缺少 userAgent 描述符' };
  }

  if (typeof descriptor.get !== 'function') {
    return { passed: false, reason: 'userAgent 属性缺少合法 getter' };
  }

  // 使用 Function 原型链上的原生 toString 方法,规避函数被自身覆写的干扰
  const getterString = Function.prototype.toString.call(descriptor.get);
  const isNativeCode = getterString.indexOf('[native code]') !== -1;

  if (!isNativeCode) {
    return { passed: false, reason: 'getter 函数非 [native code] 原生引擎绑定' };
  }

  return { passed: true };
}
3. 使用独立 iframe 隔离沙箱交叉校准
部分高级脚本即便在当前全局作用域篡改了原型链,也可能忽略了动态新建的子页面环境。我们可以动态创建一个无同源隔离的同源空白 iframe,直接读取干净全局环境中的原型链行为作为参考基准:
function getCleanNavigatorPrototype() {
  const iframe = document.createElement('iframe');
  iframe.style.display = 'none';
  document.body.appendChild(iframe);

  try {
    const cleanProto = iframe.contentWindow.Navigator.prototype;
    const cleanDescriptor = Object.getOwnPropertyDescriptor(cleanProto, 'userAgent');
    const cleanValue = cleanDescriptor.get.call(navigator); // 用纯净的原型 getter 读取当前实例
    return cleanValue;
  } finally {
    document.body.removeChild(iframe);
  }
}
五、前后端协同与客户端环境的安全边界认知
在设计防御方案时,技术人员必须具备清醒的安全边界认知:在攻击者完全可控的物理主机与运行环境中,不存在任何能够抵御 100% 逆向与伪造的前端 JavaScript 方案。
如果攻击者直接修改 Chromium 的 C++ 底层源代码重新编译,或者使用 Frida 等注入工具直接在底层 V8 引擎与显卡驱动通信层劫持返回值,前端所有的原型检查、WebGL 读取与 Client Hints 调用均可被协同伪造。因此,对抗 UA 伪造不能单兵作战,必须将客户端采集与服务端校验深度结合。
服务端协同的关键防御措施:
- Client Hints HTTP 请求头校验:要求客户端在受信任请求中携带
Sec-CH-UA、Sec-CH-UA-Mobile、Sec-CH-UA-Platform请求头,并在服务端与User-Agent标头做一致性强比对。 - TLS 握手指纹(JA3 / JA4)对齐:每个浏览器内核在建立 TLS 握手协商时,其 Cipher Suites(加密套件列表)、Extensions(扩展顺序)以及椭圆曲线参数都是固定的。如果请求头声称是 Safari,但 TLS 握手呈现的标准指纹却是 Python Requests 或 Chrome 90,服务端可在传输层直接识破伪装。
- HTTP/2 与 HTTP/3 协议栈帧特征:Chromium、Firefox 与 Safari 的网络协议栈在发送 HTTP/2 SETTINGS 帧的优先级、初始流窗口大小等细节上存在固定特征。这种协议层特征无法通过页面内的 JavaScript 扩展进行修改。
防作弊工程公理:关注防御成本而非绝对防御
前端 JavaScript 收集的硬件特征与原型链审计数据,其真正价值在于大幅拉高黑产与攻击者的伪造门槛——让攻击者从“只需修改一串文本”退化为“必须开发深度 hook 工具甚至自行编译浏览器内核”。将这些多维指标通过加密信道回传服务端,由服务端的风控模型赋予不同的信用分(Trust Score),结合验证码或二次认证,才是防范 User-Agent 伪造的最优工程实践。
六、总结
在前端处理 User-Agent 伪造问题,关键在于彻底扭转传统的单点依赖思维:
- 对于业务功能开发:坚决贯彻能力检测(Feature Detection),用
typeof和CSS.supports判定 API 是否可用,彻底切断业务逻辑与 UA 伪造风险的关联。 - 对于设备环境辨识:弃用基于单一 UA 的正则匹配,引入
navigator.userAgentData规范接口,并通过maxTouchPoints、WebGL 显卡驱动等底层特征实施交叉验证。 - 对于安全防御场景:增加对
Navigator.prototype属性描述符与原生函数特性的完整性审计,同时将最终判定权下沉至服务端,依托网络层 TLS 与 HTTP/2 协议指纹构建端云联防体系。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章