

详细讲解在JavaScript解析不可信HTML时如何彻底过滤script标签并防御跨站脚本(XSS)攻击。深入剖析正则黑名单失效的根本原因,提供基于DOMPurify与原生DOMParser的白名单净化实践,以及纯文本降级与CSP防御纵深方案。
JS解析HTML时怎么过滤script标签防止XSS攻击
作者:安全边界
时间:2026-11-18
浏览:233
文章目录
Web 安全与前端架构
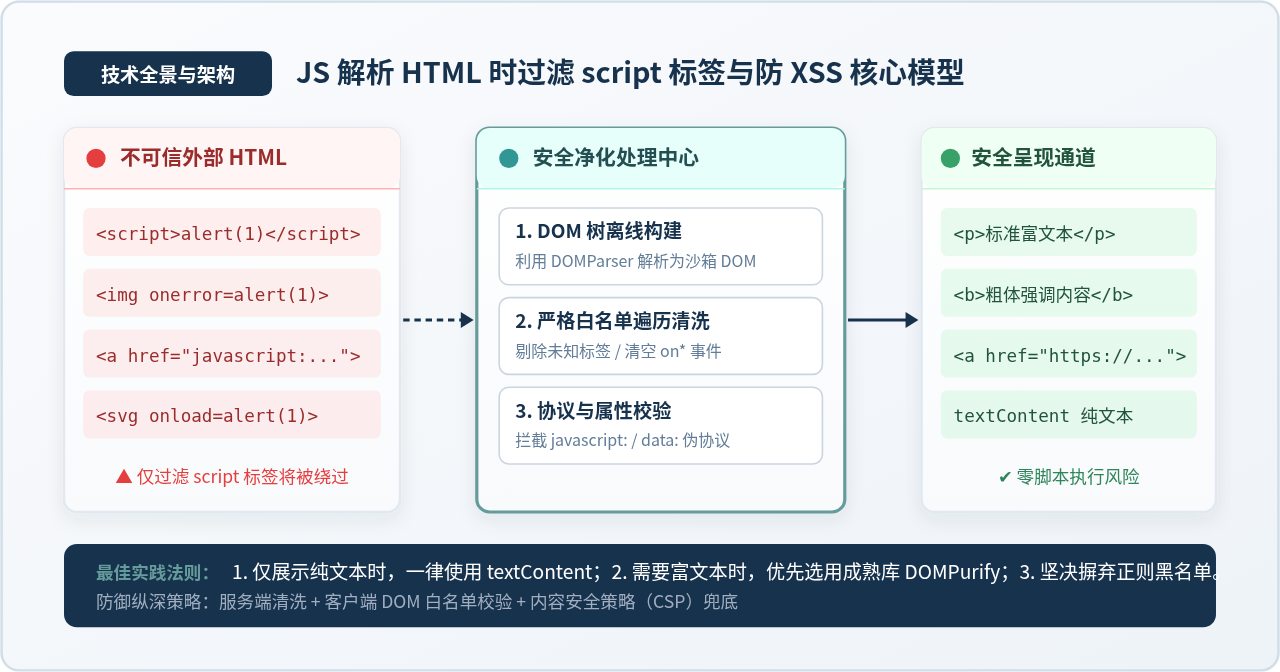
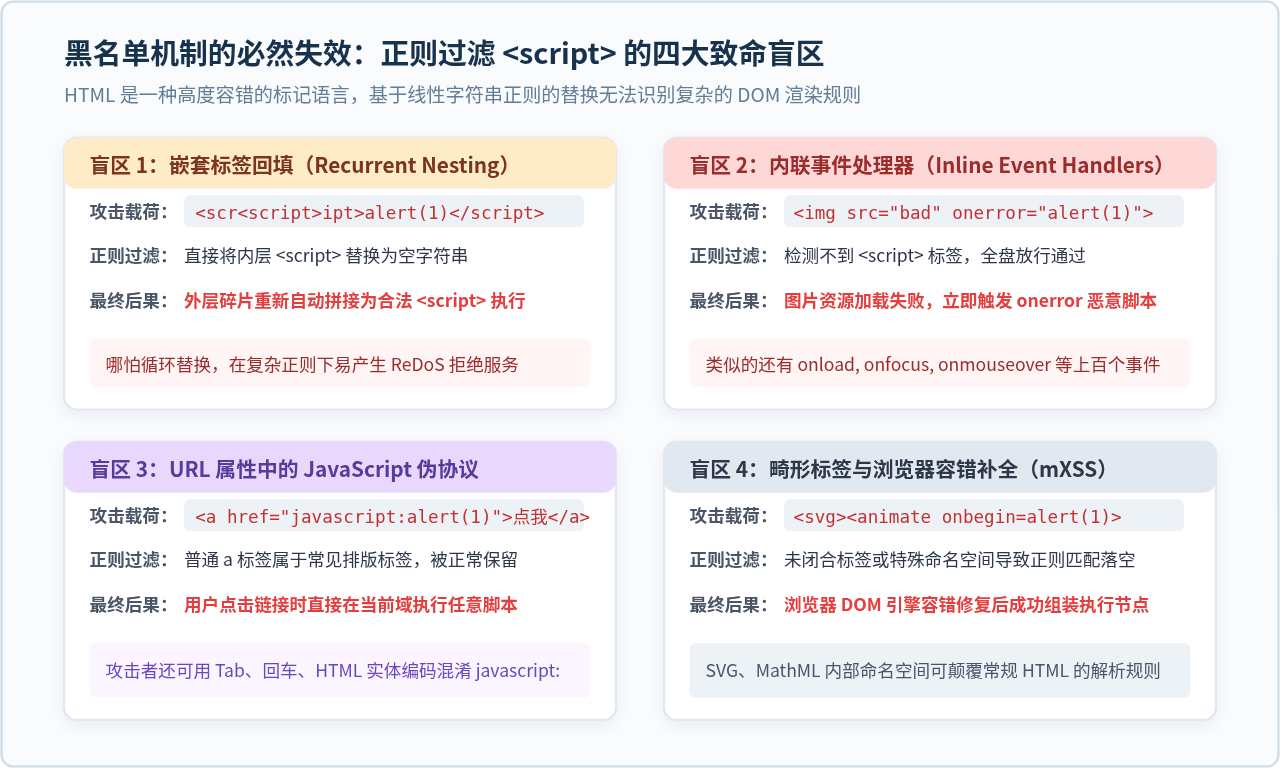
图 1:基于字符串正则过滤 script 标签的四大失效盲区与绕过机制
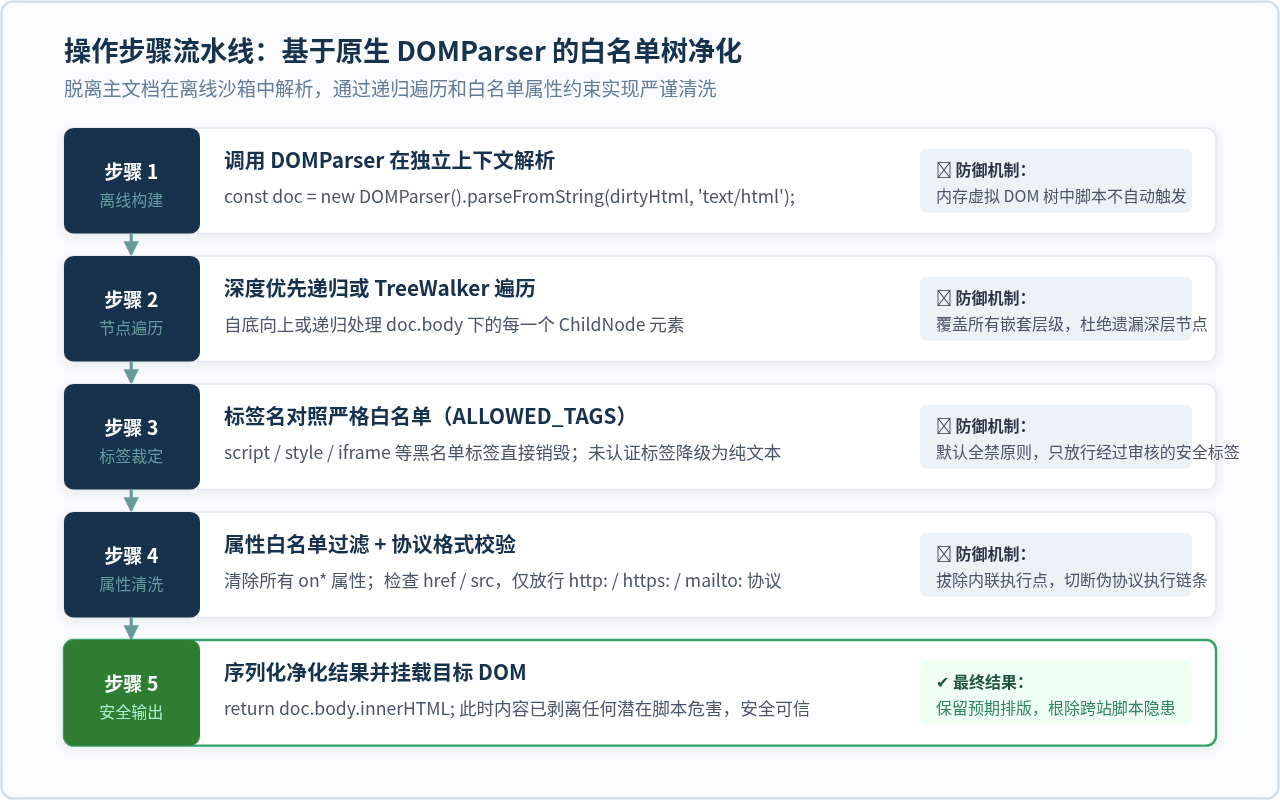
图 2:原生 DOMParser 白名单过滤的标准执行流水线
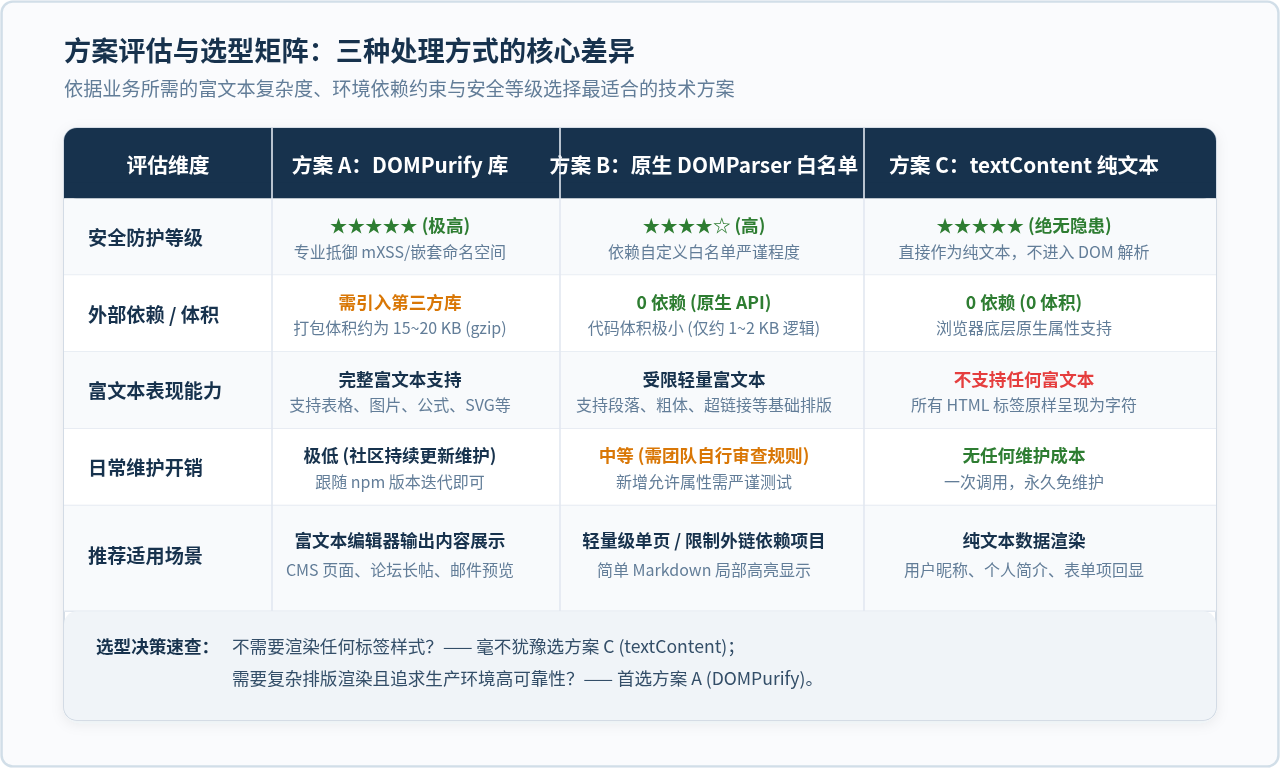
图 3:三种主流处理方案在安全性、依赖体积与富文本能力上的多维对比矩阵
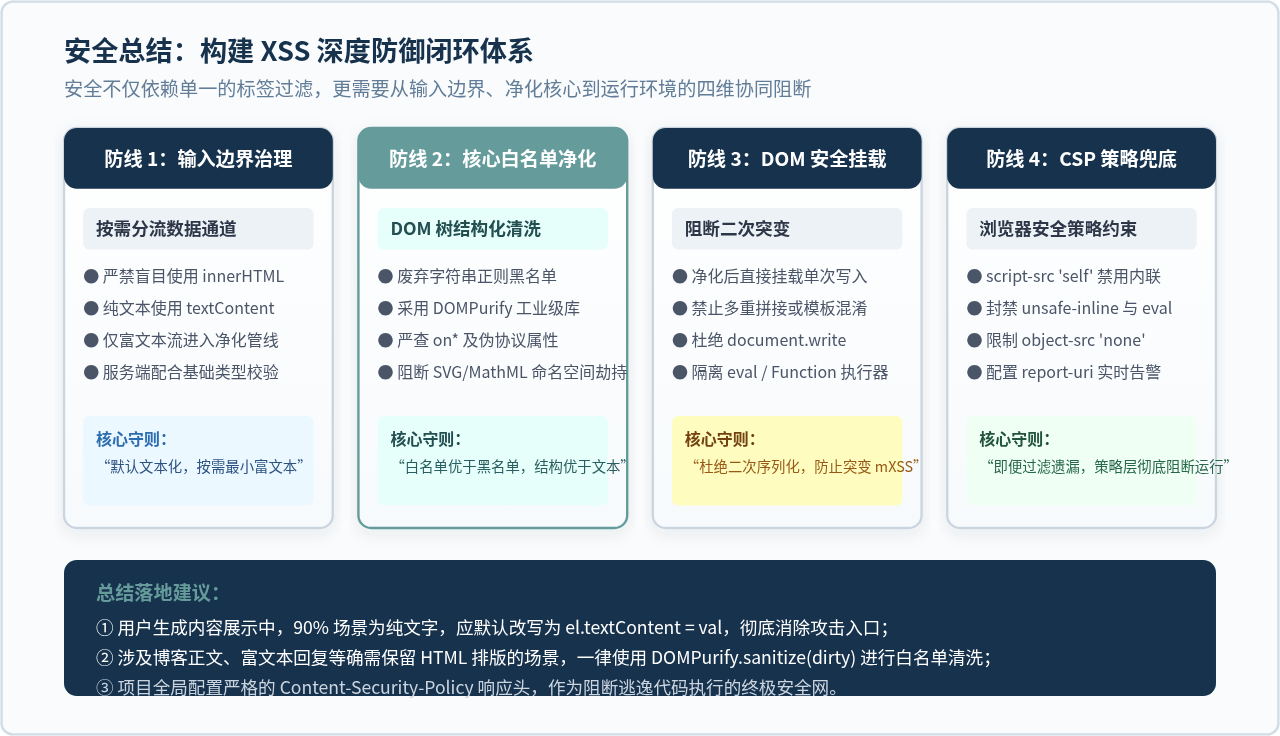
图 4:输入边界治理、白名单净化、安全挂载与 CSP 策略协同构筑的 XSS 深度防御闭环
在 JavaScript 中解析和渲染不可信的 HTML 时,直接使用正则表达式粗暴替换 <script> 标签不仅无法抵御跨站脚本(XSS)攻击,反而会因为嵌套回填、内联事件监听器和伪协议留下致命安全后门。彻底防范 XSS 攻击的唯一可靠路径,是基于 DOM 树构建严格的白名单清洗机制(优先使用工业级净化库 DOMPurify 或基于离线 DOMParser 实现白名单属性遍历);若业务只需显示纯文字,则应彻底放弃 HTML 解析直接改用 textContent。本文将详细剖析正则黑名单的失效根源,演示两种可落地的结构化清洗方案,并梳理全链路防御矩阵。
一、为什么单纯过滤 script 标签必然失败?
许多初学者常尝试通过字符串正则来“干掉”脚本标签,例如编写形如 str.replace(/<script[\s\S]*?<\/script>/gi, '') 的代码。从前端安全与 HTML 规范的角度来看,这类**基于黑名单特征匹配**的做法存在天然盲区。
HTML 规范并非标准的严格语法体系,而是一种具备高度容错机制的标记语言。浏览器内核在将字符流转换为 DOM 节点树时,存在大量纠错补全和特殊语义规则,这导致攻击者无需编写任何显式的 <script> 标签即可直接执行 JavaScript 代码:
-
嵌套标签自动回填:攻击者构造
<scr<script>ipt>alert(1)</script>。当一次性正则将内部完整的<script>剥离后,外层两端的碎片字符会重新拼接成一个全新的<script>标签,并顺利被浏览器解析执行。 -
元素内联事件监听器:例如
<img src="invalid" onerror="alert(1)">或<svg onload="alert(1)">。这些载荷根本没有<script>字符,但只要浏览器尝试加载图像失败或渲染 SVG,对应的 JavaScript 就会立即在当前上下文触发。 -
URL 属性中的伪协议:例如
<a href="javascript:alert(1)">点此领取福利</a>。超链接标签<a>往往是必须保留的合法排版标签,但若不校验href属性的具体协议,用户点击时就会直接触发任意脚本。 -
浏览器容错补全与突变(mXSS):攻击者利用未闭合标签或特殊控制字符(如
<svg><animate onbegin=alert(1)>),普通正则无法穷举所有变异组合,而浏览器内核在构建 DOM 树时会自动规范化节点结构,使攻击代码在宿主页面“合法复活”。
⚠️ 危险做法警示
不要试图通过“死循环反复正则替换”来解决嵌套问题。面对精心构造的超长恶意字符串,非贪婪回溯的复杂正则表达式极易引发 ReDoS(正则表达式拒绝服务攻击),导致用户浏览器直接卡死崩溃。
二、方案一:使用业界成熟的净化库 DOMPurify(推荐首选)
在生产环境中,如果业务必须渲染富文本(例如富文本编辑器导出的文章、评论区排版、Markdown 转换后的 HTML),最稳健、经受过最多黑盒攻击检验的方案是使用专门的 HTML 净化库——DOMPurify。
DOMPurify 不依赖脆弱的正则替换,而是在浏览器沙箱中先将输入解析为实际的 DOM 树,然后以深度优先的方式递归检查每一个节点。它不仅能彻底剥离 <script>、onerror 和 javascript: 伪协议,更能主动防御深层嵌套突变(Mutation XSS)。
1. 安装与引入方式
在现代模块化前端工程中,可以通过 npm 安装;在轻量页面中也可以直接引入单文件 CDN:
// 方式 A:npm 安装并在模块中导入
// npm install dompurify
import DOMPurify from 'dompurify';

// 方式 B:HTML 页面直接引入 CDN 脚本
// <script src="https://cdn.jsdelivr.net/npm/dompurify@3.0.6/dist/purify.min.js"></script>
2. 基础使用与挂载
基础调用极为精简,只需传入不可信的外部 HTML 字符串,DOMPurify 会返回完全清洗后的安全 HTML:
// 包含多种 XSS 攻击载荷的不可信输入
const untrustedInput = `
  <p>这是一段正常正文,<b>包含粗体</b>。</p>
  <script>alert("XSS 1");</script>
  <img src="missing.png" onerror="alert('XSS 2')">
  <a href="javascript:alert('XSS 3')">恶意链接</a>
  <a href="https://example.com" target="_blank">安全超链接</a>
`;

// 核心调用:执行净化
const cleanHtml = DOMPurify.sanitize(untrustedInput);

// 安全挂载至目标 DOM 容器
const container = document.getElementById('content-box');
container.innerHTML = cleanHtml;

// 净化后输出的实际内容:
// <p>这是一段正常正文,<b>包含粗体</b>。</p>
// <img src="missing.png">  (onerror 事件已被精准拔除)
// <a>恶意链接</a>          (javascript: 伪协议已被移除)
// <a href="https://example.com" target="_blank">安全超链接</a>
3. 生产级进阶配置:指定白名单规则
在严密的安全体系中,遵循“最小特权原则”配置严格的白名单。例如,如果业务只允许段落、强调和普通超链接,可以明确限制允许的标签与属性:
// 仅允许基础排版标签与特定属性
const cleanHtmlStrict = DOMPurify.sanitize(untrustedInput, {
  ALLOWED_TAGS: ['p', 'b', 'strong', 'i', 'em', 'a', 'ul', 'ol', 'li', 'br'],
  ALLOWED_ATTR: ['href', 'title', 'target'],
  ALLOW_DATA_ATTR: false // 禁用自定义 data-* 属性,防止框架属性注入
});
三、方案二:基于原生 DOMParser 实现轻量白名单过滤(操作步骤)
在某些特定场景下(例如不允许引入第三方 npm 依赖的内网工具、极低包体积限制的轻量微前端组件),开发者需要手写净化逻辑。此时严禁自行编写正则,必须使用浏览器原生提供的 DOMParser 在内存沙箱中进行白名单清洗。
步骤 1
离线构建沙箱文档
调用 new DOMParser().parseFromString(dirtyHtml, 'text/html')。该方法会在一个完全与主页面渲染树隔离的上下文解析 HTML。在此内存树中,即使存在 <script> 标签或 onerror,也不会自动执行脚本,这为后续安全检查提供了纯净的操作空间。
步骤 2
深度优先递归遍历节点
从 doc.body 开始递归检查每个子节点。注意必须递归处理所有嵌套层级,确保深层嵌套的子元素无法逃逸审查。
步骤 3
标签名与白名单裁定
对于元素节点(nodeType === Node.ELEMENT_NODE),检查其标签名。若属于高危黑名单(如 script, style, iframe, object, embed, svg),直接通过 node.remove() 彻底销毁;若不在白名单中,则提取其 textContent 转换为纯文本节点替换自身;仅当在允许列表中时保留标签结构。
步骤 4
属性白名单过滤与协议清洗
遍历保留节点的所有属性:凡是以 on 开头的属性(内联事件处理器)无条件剔除;不在属性白名单的属性剔除;对于 href 或 src 等 URL 属性,必须使用标准 URL 规范检测协议,仅允许 http:、https: 或 mailto:,坚决阻断 javascript: 与 data:text/html 伪协议。
步骤 5
导出净化结果安全挂载
清洗完成后,提取 doc.body.innerHTML 注入到目标节点。此时所有危险载荷已在离线状态下被彻底剔除。
完整原生实现代码
下面是一套可在浏览器控制台或前端项目中直接运行的完整过滤函数:
/**
 * 基于原生 DOMParser 的白名单 HTML 净化器
 * @param {string} dirtyHtml - 未经验证的原始 HTML 字符串
 * @returns {string} 净化后的安全 HTML 字符串
 */
function sanitizeHtmlNative(dirtyHtml) {
  if (!dirtyHtml || typeof dirtyHtml !== 'string') return '';

  // 1. 定义严谨的白名单集合
  const ALLOWED_TAGS = new Set([
    'p', 'b', 'strong', 'i', 'em', 'u', 's', 'span',
    'h1', 'h2', 'h3', 'h4', 'h5', 'h6',
    'ul', 'ol', 'li', 'br', 'hr', 'blockquote',
    'a', 'code', 'pre'
  ]);

  const ALLOWED_ATTRS = new Set(['href', 'title', 'class', 'target']);
  const SAFE_PROTOCOLS = new Set(['http:', 'https:', 'mailto:']);
  const DANGEROUS_TAGS = new Set(['script', 'style', 'iframe', 'object', 'embed', 'svg', 'math']);

  // 2. 步骤 1:利用 DOMParser 离线解析
  const parser = new DOMParser();
  const doc = parser.parseFromString(dirtyHtml, 'text/html');

  // 3. 递归清洗函数
  function cleanNode(node) {
    // 文本节点和文档片段天然安全,直接保留
    if (node.nodeType === Node.TEXT_NODE) return;

    if (node.nodeType === Node.ELEMENT_NODE) {
      const tagName = node.nodeName.toLowerCase();

      // 命中高危黑名单:连同子节点彻底销毁
      if (DANGEROUS_TAGS.has(tagName)) {
        node.remove();
        return;
      }

      // 非白名单标签:将其降级为其内部纯文本,避免隐藏恶意标签结构
      if (!ALLOWED_TAGS.has(tagName)) {
        const textNode = doc.createTextNode(node.textContent || '');
        node.replaceWith(textNode);
        return;
      }

      // 4. 清洗属性:从后向前遍历 attributes 防止删除属性时索引移位
      const attrs = Array.from(node.attributes);
      for (const attr of attrs) {
        const attrName = attr.name.toLowerCase();
        const attrValue = attr.value.trim();

        // 剔除任何内联事件属性 (例如 onclick, onerror, onload)
        if (attrName.startsWith('on')) {
          node.removeAttribute(attr.name);
          continue;
        }

        // 剔除不在白名单内的属性
        if (!ALLOWED_ATTRS.has(attrName)) {
          node.removeAttribute(attr.name);
          continue;
        }

        // 重点防护:校验 href / src 的 URL 协议
        if (attrName === 'href' || attrName === 'src') {
          try {
            // 基于当前页面 origin 校验相对/绝对地址
            const parsedUrl = new URL(attrValue, window.location.origin);
            if (!SAFE_PROTOCOLS.has(parsedUrl.protocol)) {
              node.removeAttribute(attr.name); // 阻断 javascript: 伪协议
            }
          } catch (err) {
            // 畸形 URL 直接移除
            node.removeAttribute(attr.name);
          }
        }

        // 如果 a 标签设置了 target="_blank",强制补充 rel 属性防止 tabnabbing 钓鱼
        if (tagName === 'a' && node.getAttribute('target') === '_blank') {
          node.setAttribute('rel', 'noopener noreferrer');
        }
      }

      // 5. 递归处理当前元素的子节点(注意转为数组以防动态变更)
      Array.from(node.childNodes).forEach(cleanNode);
    }
  }

  // 执行遍历
  Array.from(doc.body.childNodes).forEach(cleanNode);

  // 返回净化后的 HTML
  return doc.body.innerHTML;
}
⚠️ 绝对禁忌:不要在主文档中使用隐藏 div 净化
切记不可写成 const div = document.createElement('div'); div.innerHTML = dirty;。即便未将此 div 挂载到 body 上,向 innerHTML 赋值的瞬间,浏览器解析器就会立即触发 <img src="x" onerror="..."> 的错误回调或加载外部资源,攻击代码随即引爆!必须使用 new DOMParser() 生成的完全独立文档。
四、方案三:仅展示纯文本时的零成本防 XSS 方案
在很多真实的业务场景中,开发者本意只是想在界面上输出用户发表的文字评论、用户名或反馈,页面根本不需要呈现任何粗体、链接或颜色排版,却顺手写了 el.innerHTML = commentText。这是最普遍的 XSS 诱因。
1. 原生 textContent:性能最优、绝对免疫
如果无需呈现富文本,一律使用 textContent 赋值:
// 纯文本展示的最佳实践
const userInput = '<script>alert("XSS")</script>';
const userBox = document.getElementById('username-display');

// 浏览器将输入视作纯文本字面量,不触发 HTML 标记解析,零 XSS 风险
userBox.textContent = userInput;
使用 textContent 时,浏览器底层会将字符串作为单一 TextNode 节点挂载,HTML 实体与标签均被原封不动以字面量绘制,既不需要加载外部库,也无需进行任何复杂的遍历运算,执行耗时接近于零。
2. 字符实体转义函数的边界与局限
如果由于旧有架构限制必须拼接字符串生成 HTML 模板,可以使用标准的 HTML 实体转义函数:
// 安全的 HTML 实体转义辅助函数
function escapeHtml(str) {
if (!str) return '';
return String(str)
.replace(/&/g, '&')
.replace(/</g, '<')
.replace(/>/g, '>')
.replace(/"/g, '"')
.replace(/'/g, ''');
}
// 模板拼接示例
const safeMarkup = `<span class="user-badge">${escapeHtml(userInput)}</span>`;
注意局限性:HTML 实体转义仅在普通的 HTML 元素内容节点中安全。如果你把转义后的字符串放入属性引号外(如 <div id=${escapeHtml(val)}>)或者放置于动态脚本上下文中(如 <script>var id = "${escapeHtml(val)}";</script>),攻击者依然可以通过换行、空格或反引号实现上下文逃逸。
五、方案对比与选型决策指南
面对不同的业务形态与环境限制,应当建立清晰的选型标准。不要在一个仅需展示姓名的字段上引入庞大的富文本净化库,更不要在一个支持用户发表富文本长文的编辑器输出端手写简陋过滤。
技术选型决策原则:
-
纯数据展示场景:(如列表数据、用户名、手机号、日志展示)坚决选择
textContent,彻底关闭 HTML 解析通道。 - 标准 Web 生产项目富文本渲染:(如 CMS 后台、社区讨论区、邮件预览、Markdown 渲染)首选 DOMPurify。它拥有极佳的性能和完善的边界测试用例覆盖,能最大程度降低安全风险。
- 极度受限环境或轻量级单页:(无法引入第三方依赖,只需加粗、换行、简单外链)选用本文提供的原生 DOMParser 白名单过滤函数,严格限定允许的标签与协议。
六、深度防御:配合 CSP 与现代浏览器安全机制
信息安全的基本原则是“假定单层防线可能被穿透”。即使净化逻辑十分精密,未来代码重构、配置失误或不可预见的内核特性变动仍可能引入风险。因此,前端应当与运维/后端配合,构筑纵深防御(Defense-in-Depth)体系。
1. 配置内容安全策略(CSP,Content Security Policy)
CSP 是浏览器内置的强力安全沙箱。通过在 HTTP 响应头中声明 CSP 策略,可以从根本上限制网页执行未经授权的代码。即使过滤逻辑偶发遗漏了一个 <script> 或 onerror,浏览器也会在策略层面拒绝执行该脚本。
推荐的现代生产环境基础 CSP 响应头:
# Nginx 或后端网关设置响应头
Content-Security-Policy: default-src 'self'; script-src 'self'; object-src 'none'; base-uri 'self';
script-src 'self':只允许加载来自当前同源服务器的外部脚本文件,彻底禁用所有内联脚本(inline script)及内联事件监听器;object-src 'none':禁止执行 Flash、Java Applet 等历史遗留插件;- 封禁
unsafe-eval:切断eval()与setTimeout("string")的动态代码编译能力。
2. 前瞻:现代浏览器的原生 Sanitizer API
为了解决长久以来网页缺乏原生富文本净化标准的问题,W3C 与主要浏览器厂商(Chrome、Firefox、Safari)已在规范中推进 Sanitizer API。未来浏览器将直接支持原生的安全挂载:
// 检查浏览器是否已原生支持 Sanitizer API
if (window.Sanitizer) {
  const sanitizer = new Sanitizer();
  // 现代 API: setHTML 会自动通过底层引擎进行安全过滤
  element.setHTML(dirtyInput, { sanitizer });
} else {
  // 降级回退至 DOMPurify
  element.innerHTML = DOMPurify.sanitize(dirtyInput);
}七、常见问题与避坑指南 (FAQ)
Q1: 后端接口入库时已经做过清洗,前端还需要二次过滤吗?
必须做。首先,现代 Web 架构中后端往往作为数据中立提供方(同一个接口可能同时供给 iOS/Android 原生 App、小程序及第三方开放 API),各客户端对标记语言的渲染规则完全不同;其次,数据来源可能包含第三方接口、本地 LocalStorage 缓存、URL 参数等未经后端的直接输入;更重要的是,前端作为执行 JavaScript 代码的最终场所,必须秉持“零信任”原则,对所有外来数据进行落地清洗。
Q2: 为什么有些攻击载荷会把属性值拆开用 Tab 或回车混淆?
例如 <a href="jav
ascript:alert(1)">。在 HTML 规范中,浏览器在解析 URL 时会自动忽略控制字符(如换行符
或制表符 ),从而顺利识别为 javascript: 协议并执行;但如果是基于字符串正则匹配 /javascript:/i,这一规则就会被完全绕开。这也正是方案二中必须通过标准 new URL() 对象来解析协议的根本原因。
Q3: 为什么在过滤规则中,SVG 和 MathML 元素需要特别小心?
SVG 和 MathML 采用独立的 XML 命名空间。当浏览器解析到这些标签时,其内部的词法解析器会从 HTML 模式切换为 XML 模式,许多在普通 HTML 中被视为非法的字符和标签在 XML 命名空间中会被正常解析。这种跨命名空间突变(Mutation XSS)极难通过简易的白名单处理,因此如果业务不需要绘制矢量图或数学公式,建议在白名单中直接将 svg 和 math 标签列为禁止项。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章