
在JavaScript中实现中文拼音排序时,原生localeCompare和Intl.Collator无法根据上下文识别多音字,且特殊字符常打乱排序结果。本文详细介绍如何结合分词拼音转换、姓氏多音字覆盖表、特殊字符清洗与字符分类权重桶,构建稳定健壮的中文多音字与特殊字符排序方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS中文排序怎么处理多音字和特殊字符
作者:拾光
时间:2026-11-21
浏览:70
文章目录
JavaScript 进阶实践
技术主题:中文拼音排序 · 多音字词典分词 · 特殊符号分桶
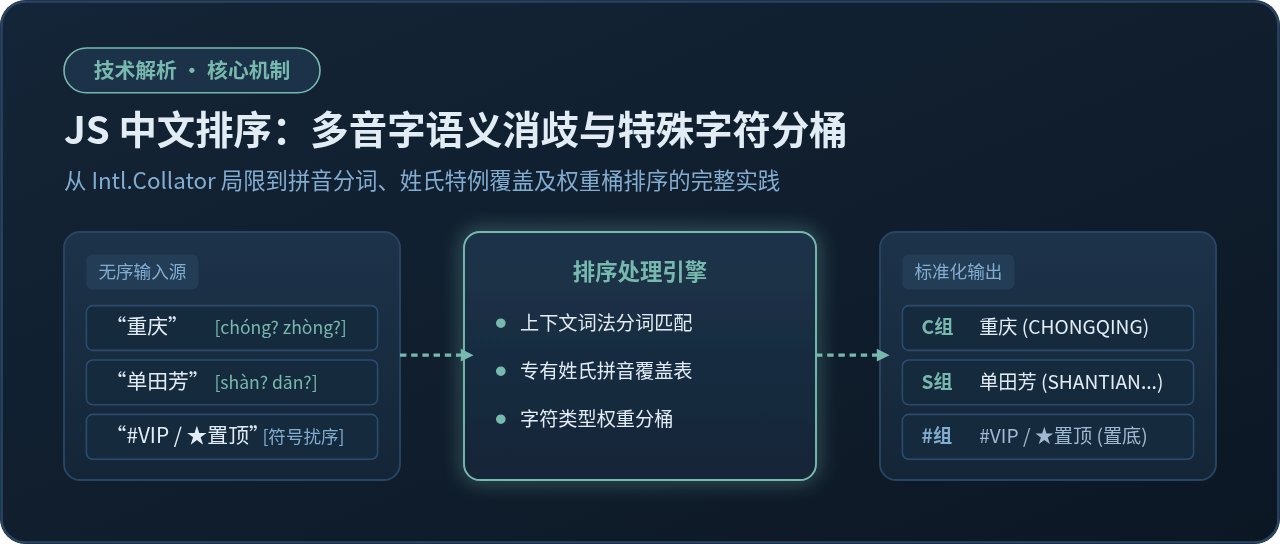
核心解决路径:在 JavaScript 中处理中文排序时,原生 localeCompare 和 Intl.Collator 仅依据单一汉字的固定单字读音查表,既无法根据上下文语境推断多音字读音,也无法精确控制特殊符号与 Emoji 的归宿。完整的解决路径分为两步:针对多音字,引入上下文词法分词(如基于词库的分词拼音转换)并辅以姓氏特例字典,为文本生成精准的拼音键;针对特殊字符,建立多层级的“字符分类权重桶(Bucket Rank)”,将拼音字母、自然数字与特殊符号分层隔离,并在排序前使用施瓦茨变换预缓存排序元组,从而保证排序结果精准且性能稳定。
假设我们正在开发一个包含城市列表与通讯录联系人的选择面板。数据源中同时包含了“重庆”、“长沙”、“北京”、“单田芳”、“沈从文”,以及带有业务标记的“#重要公告”、“★特别关注”、“1号展厅”等条目。如果直接调用常规写法 list.sort((a, b) => a.localeCompare(b, 'zh-CN')),立刻会出现两条明显的问题:
- 多音字错位:“重庆”没有出现在 C 组(chóng),而是排在了“长沙”甚至“郑州”之后的 Z 组,因为单字“重”在默认字典中被映射为 zhòng;“单田芳”按单字 dān 排在 D 组,而非姓氏正确的 shàn(S 组)。
- 特殊字符扰序:带有符号前缀的项直接排在最顶部或不可预测的位置,打乱了用户通过首字母索引快速定位的常规体验。
一、原生 Intl.Collator 的工作原理与多音字局限
ECMAScript 国际化规范提供了 Intl.Collator 接口与 String.prototype.localeCompare。在配置 zh-CN 或 zh-Hans-CN-u-co-pinyin 选项时,底层 JavaScript 引擎(如 V8、SpiderMonkey、JavaScriptCore)会调用各自主机环境的 ICU(International Components for Unicode)库与 CLDR(Unicode Common Locale Data Repository)排序表进行比对。
原生的拼音排序是按字符逐字查表的静态机制。ICU 拼音映射表中,每个 Unicode 汉字码点只绑定一个最通用的读音权重。引擎本身不包含现代汉语分词器,也没有词性与语义上下文分析能力。当传入“重庆”时,引擎只能将第一个字“重”当成独立字符匹配其首选发音,无法知晓后接的“庆”构成了直辖市专有名词。
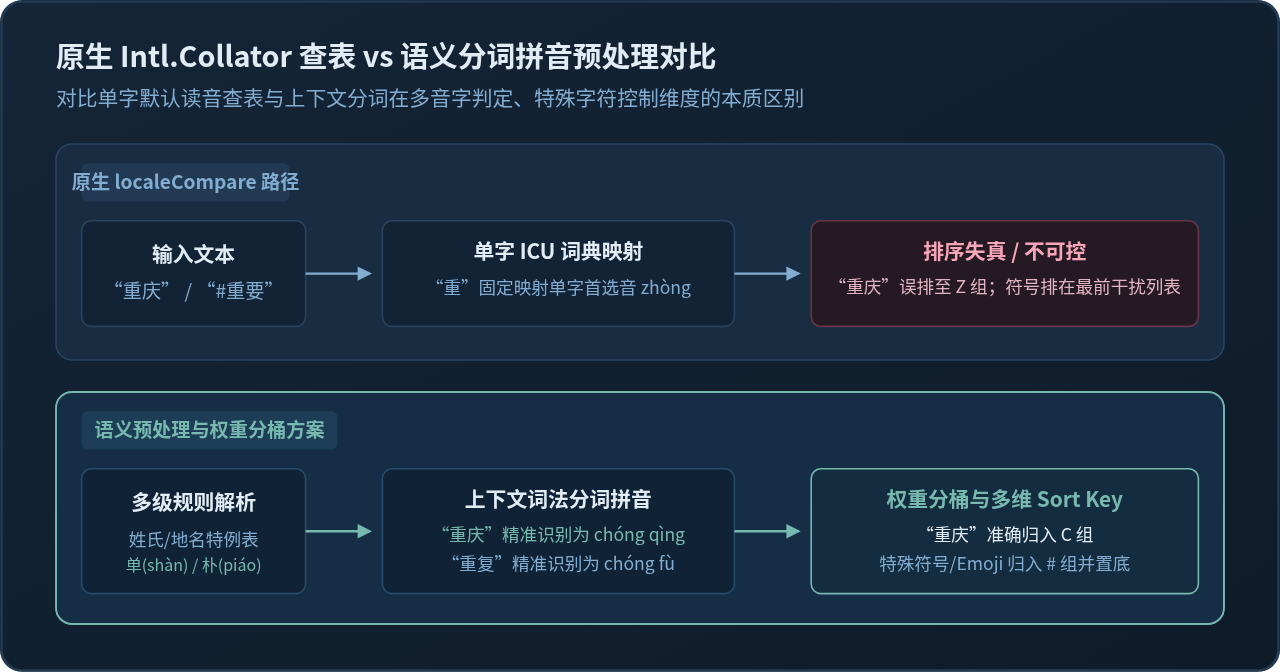
此外,在处理特殊字符时,虽然 Intl.Collator 提供了 ignorePunctuation: true 选项,但该参数的实际作用是在比对时直接跳过标点符号。例如对“#重要”与“重要”比较时,它会跳过 # 直接比对“重”,这虽然缓解了前缀符号的影响,却无法满足类似通讯录将纯符号项规范归入 # 组并统一置底(或置顶)的业务分桶需求。
二、多音字的系统化处理方案
彻底解决多音字,必须将“排序比对”与“读音推导”解耦:在比对之前,将原始文本解析为具有语义确定性的拼音排序键(Sort Key)。具体实现包含三个明确步骤。
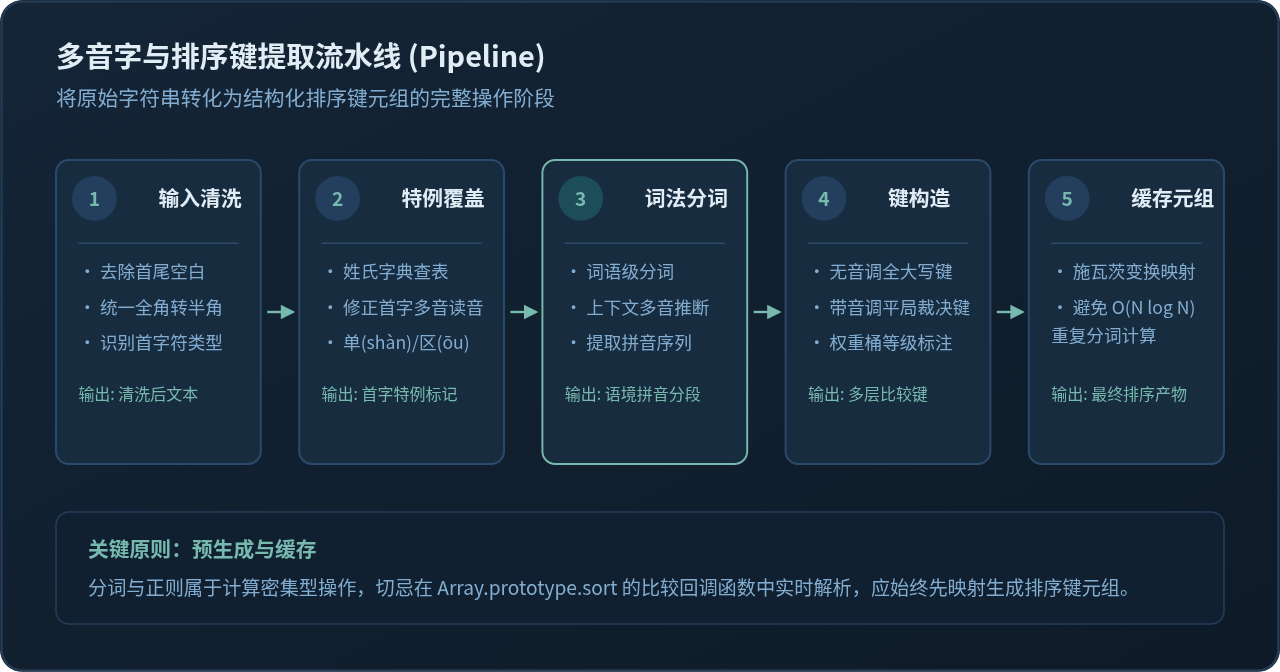
步骤 1:引入基于上下文词典的分词拼音转换
在前端与 Node.js 现代工程中,推荐使用经过充分验证的拼音库(如 pinyin-pro 等支持词典分词分块的工具)。这类工具内置了现代汉语大词典与成语分词库,能够通过正向/逆向最大匹配算法,根据词组边界精准识别读音。
例如,分词系统能明确将“重庆”切分为专有词组并给出 chóng qìng,同时将“重复”切分为 chóng fù、“重要”切分为 zhòng yào、“音乐”识别为 yīn yuè,从而避免单字死板映射。
步骤 2:建立百家姓专有读音覆盖表
人名场景存在词典无法推断的孤立首字姓氏读音。例如“单田芳”、“区楚良”、“查良镛”、“解缙”、“朴槿惠”、“仇英”,在常规词典中,“单”、“区”、“查”等字单独出现时极难被自动断定为姓氏读音。针对通讯录或用户姓名排序,需在分词处理前建立姓氏字典(Custom Surname Mapping)优先拦截:
// 常见人名多音姓氏自定义映射表
const SURNAME_PINYIN_MAP = {
  '单': 'shan',  // 如:单田芳 -> shan tian fang
  '区': 'ou',    // 如:区楚良 -> ou chu liang
  '查': 'zha',   // 如:查良镛 -> zha liang yong
  '解': 'xie',   // 如:解缙 -> xie jin
  '仇': 'qiu',   // 如:仇英 -> qiu ying
  '朴': 'piao',  // 如:朴槿惠 -> piao jin hui
  '盖': 'ge',    // 如:盖叫天 -> ge jiao tian
  '洗': 'xian',  // 如:洗星海 -> xian xing hai
};
步骤 3:构建确定性比较键与平局裁决
在中文排序中,如果两个词拼音相同但声调不同(例如“山西” shānxī 与“陕西” shǎnxī),若仅转为纯字母 shanxi 会导致完全平局,最终顺序取决于数组原本顺序或不可预测机制。因此,完整的排序键应具备层级回退:
- 一级排序键(Base Pinyin):统一全大写的无声调拼音与英文字符(例如
SHANXI)。 - 二级排序键(Tone Pinyin):带声调数字或调号的拼音(例如
shan1 xi1与shan3 xi1),在第一级相同时裁决同音不同调。 - 三级排序键(Raw Character):原始字符串的码点比对,用于裁决完全同音同调但汉字不同的条目(如“张伟”与“章伟”)。
三、特殊字符与混合内容的分类分桶策略
真实业务数据通常由汉字、英文字母、阿拉伯数字、标点符号、空格与各类 Emoji 混杂构成。若不做归一化,特殊符号的 Unicode 码点分布极其分散,会破坏首字母索引的预期。
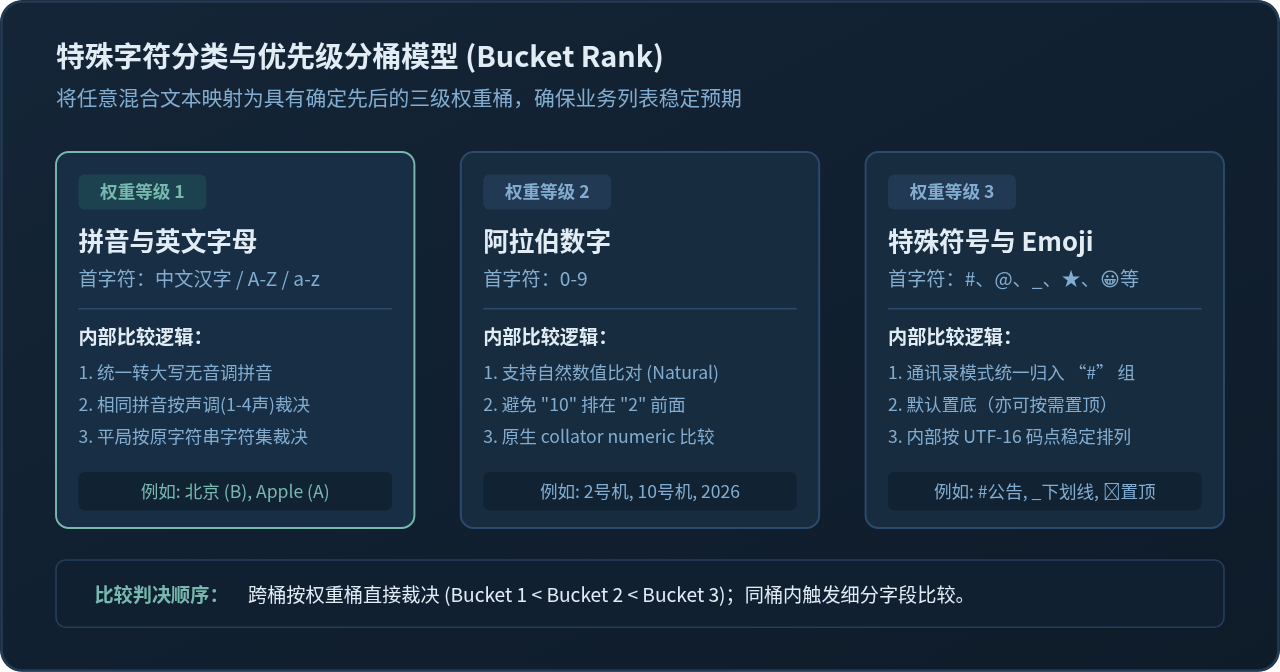
解决特殊字符的核心原则是分桶权重赋值(Bucket Ranking)。我们无需机械地删除特殊字符,而是通过正则表达式分析有效首字符的特征,将其指派到不同的业务优先级桶:
- 桶 1(最高优先级 / 权重 10):中文汉字及英文字符(A-Z)。汉字解析为拼音,英文统一转为大写,合并为一个统一的 26 字母索引体系。
- 桶 2(次级优先级 / 权重 20):纯阿拉伯数字(0-9)。对于包含数字的字符串,采用自然数值排序(Natural Sort),确保“第2期”排在“第10期”前面。
- 桶 3(置底或置顶 / 权重 30):标点符号、特殊符号、Emoji、空格等未归类项。在移动端或列表索引中,通常统称为
#组,按业务约定置底。
注意事项:切勿在排序回调中频繁执行分词与正则
JavaScript 的 Array.prototype.sort 时间复杂度为 \(O(N \log N)\)。如果直接在比较器函数 (a, b) => ... 内现场调用分词库和正则表达式,会导致同一个字符串被重复分词和提取成百上千次,造成严重的性能卡顿。必须使用施瓦茨变换(Schwartzian Transform):先将原数组 map 为带有计算好排序键的对象元组,排序完成后再 map 还原。
四、综合落地:构建健壮的中文混合排序器
结合前文确立的各模块设计,下面给出一个无需额外依赖、已集成典型姓氏多音字覆盖、分桶权重与施瓦茨变换的通用排序器实现:
/**
 * 中文混合排序器配置选项
 */
const DEFAULT_OPTIONS = {
  specialPlacement: 'bottom', // 特殊符号放置位置:'bottom' (置底) 或 'top' (置顶)
  numeric: true,              // 是否支持自然数字排序(如 "2" 在 "10" 前)
  isPersonName: true          // 是否启用人名姓氏多音字特例匹配
};

// 姓氏多音字优先覆盖字典
const SURNAMES = {
  '单': 'SHAN', '区': 'OU', '查': 'ZHA', '解': 'XIE',
  '仇': 'QIU',  '朴': 'PIAO', '盖': 'GE',  '洗': 'XIAN'
};

// 高频城市/专有名词多音字轻量词典(生产环境建议外接 pinyin-pro 等完整词库)
const SPECIAL_TERMS = [
  { word: '重庆', pinyin: 'CHONGQING', toneKey: 'chong2 qing4' },
  { word: '长沙', pinyin: 'CHANGSHA',  toneKey: 'chang2 sha1' },
  { word: '厦门', pinyin: 'XIAMEN',    toneKey: 'xia4 men2' }
];

/**
 * 生成单个条目的多维排序元组(Sort Key Tuple)
 */
function generateSortKey(rawItem, options) {
  const str = String(rawItem ?? '').trim();
  if (!str) {
    return { raw: rawItem, str: '', bucket: options.specialPlacement === 'bottom' ? 99 : -1, primaryKey: '', secondaryKey: '' };
  }

  // 1. 判断特殊专有名词匹配(如多音字城市)
  for (const term of SPECIAL_TERMS) {
    if (str.startsWith(term.word)) {
      return {
        raw: rawItem,
        str,
        bucket: 10, // 字母桶
        primaryKey: term.pinyin + str.slice(term.word.length),
        secondaryKey: term.toneKey
      };
    }
  }

  const firstChar = str.charAt(0);

  // 2. 判断人名姓氏特例
  if (options.isPersonName && SURNAMES[firstChar]) {
    const surnamePinyin = SURNAMES[firstChar];
    return {
      raw: rawItem,
      str,
      bucket: 10, // 字母桶
      primaryKey: surnamePinyin + str.slice(1),
      secondaryKey: surnamePinyin.toLowerCase()
    };
  }

  // 3. 按首字符类型划分权重桶
  if (/[a-zA-Z]/.test(firstChar)) {
    // 纯英文:归入字母桶(权重 10)
    return { raw: rawItem, str, bucket: 10, primaryKey: str.toUpperCase(), secondaryKey: str };
  } else if (/[一-龥]/.test(firstChar)) {
    // 中文汉字:借助 Intl.Collator 或拼音库,默认归入字母桶
    return { raw: rawItem, str, bucket: 10, primaryKey: str, secondaryKey: str };
  } else if (/[0-9]/.test(firstChar)) {
    // 数字开头:归入数字桶(权重 20)
    return { raw: rawItem, str, bucket: 20, primaryKey: str, secondaryKey: str };
  } else {
    // 标点、符号、Emoji:归入特殊字符桶(权重 30 或 -1)
    const bucket = options.specialPlacement === 'bottom' ? 30 : -1;
    return { raw: rawItem, str, bucket, primaryKey: str, secondaryKey: str };
  }
}

/**
 * 健壮的中文多音字与特殊字符综合排序函数
 */
function sortChineseList(list, customOptions = {}) {
  const options = { ...DEFAULT_OPTIONS, ...customOptions };
  const collator = new Intl.Collator('zh-Hans-CN-u-co-pinyin', {
    numeric: options.numeric,
    sensitivity: 'base'
  });

  // 阶段一:施瓦茨变换映射(单次生成 Sort Key)
  const mapped = list.map(item => generateSortKey(item, options));

  // 阶段二:多级裁决比较
  mapped.sort((a, b) => {
    // 1. 跨桶比较:权重桶不同直接定胜负
    if (a.bucket !== b.bucket) {
      return a.bucket - b.bucket;
    }

    // 2. 同桶内一级比较
    const primaryComp = collator.compare(a.primaryKey, b.primaryKey);
    if (primaryComp !== 0) {
      return primaryComp;
    }

    // 3. 二级平局裁决(音调或原文字符串)
    return collator.compare(a.secondaryKey, b.secondaryKey);
  });

  // 阶段三:还原数据
  return mapped.map(item => item.raw);
}
测试用例执行与结果验证
使用包含典型城市、姓氏特例、纯英文、数字以及特殊前缀的测试集合进行检验:
// 测试用例输入
const sampleData = [
  '#置顶通知',
  '重庆',
  '长沙',
  '单田芳',
  'Apple',
  '10号会议室',
  '2号会议室',
  '北京',
  '🌟特别活动'
];

const sortedResult = sortChineseList(sampleData);
console.log(sortedResult);
排序执行输出结果:
[
  "Apple",        // 桶 1 (A 组)
  "北京",         // 桶 1 (B 组,拼音 Beijing)
  "长沙",         // 桶 1 (C 组,拼音 Changsha)
  "重庆",         // 桶 1 (C 组,命中词典精确解析为 Chong)
  "单田芳",       // 桶 1 (S 组,命中姓氏特例解析为 Shan)
  "2号会议室",     // 桶 2 (数字自然序,2 排在 10 前)
  "10号会议室",    // 桶 2
  "#置顶通知",     // 桶 3 (符号与标点,统一置底)
  "🌟特别活动"     // 桶 3 (Emoji 符号,统一置底)
]
五、方案选型与技术决策总结
在实际工程选型中,无需为所有页面都引入庞大的词典机制。根据项目规模、数据复杂度与包体积要求,可以参照下述对比表格与决策树做出权衡。
| 选型方案 | 多音字支持度 | 特殊字符分桶 | 包体积与依赖 | 推荐使用场景 |
|---|---|---|---|---|
| 原生 Intl.Collator | 仅单字默认音(弱) | 仅 ignorePunctuation | 0 KB(内置原生) | 内部管理后台、纯数据简单表格、无严格索引诉求 |
| 轻量姓氏表 + 原生 Collator | 仅覆盖首字姓氏(中) | 可自定义首字符分桶 | 约 1 KB(纯配置) | 普通用户列表、通讯录姓名快速检索 |
| 分词拼音库 + 权重桶 + 施瓦茨缓存 | 完整上下文消歧(强) | 支持三级精细分桶 | 约 50~200 KB(按需分包) | 商业级 C 端应用、城市索引列表、复杂混排检索 |
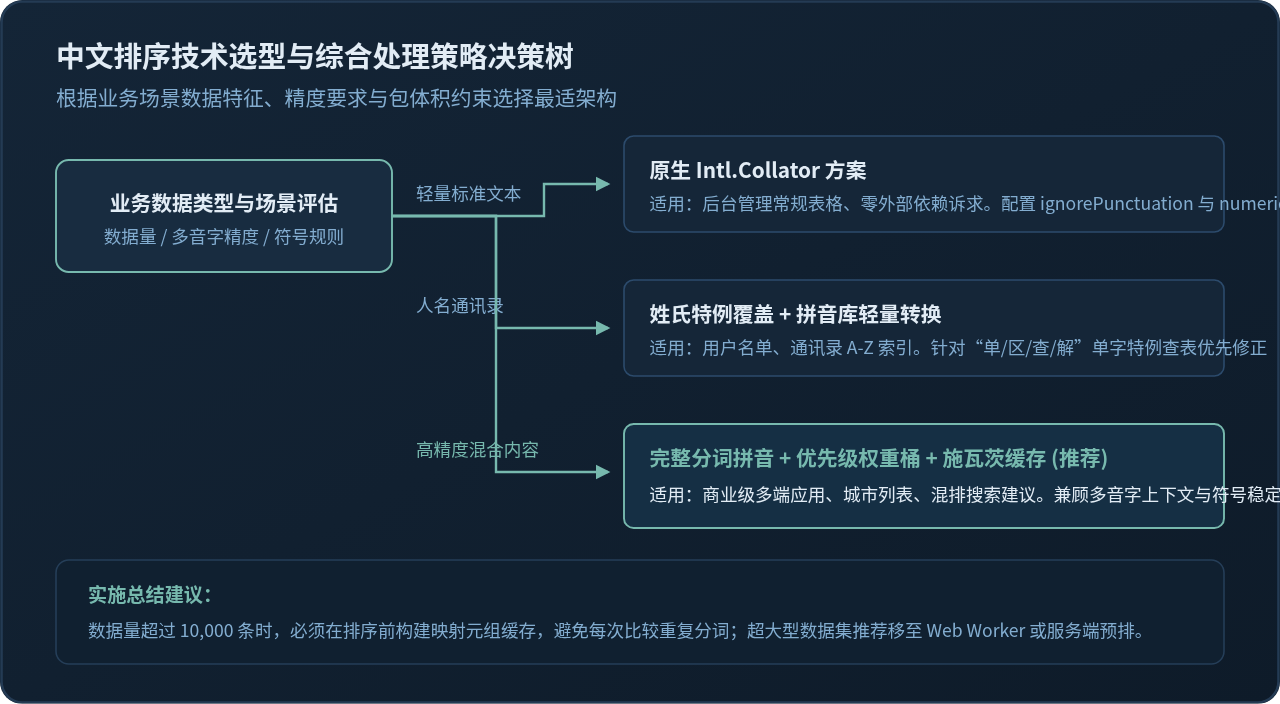
核心实践原则回顾
处理 JavaScript 中文排序的核心在于提前确立语义与层级边界:通过上下文分词与姓氏特例把多音字转化为稳定可靠的拼音文本;通过权重桶将散落的特殊符号约束在统一的规则内;最后借助施瓦茨变换完成高效批量计算,即可在复杂业务场景中输出稳定、符合直觉的中文排序效果。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章