
深入讲解在JavaScript中高效处理嵌套结构JSON对象数组的实用方法,包含多层链式安全访问、任意深度树递归检索、面包屑路径回溯、平铺与树形双向转换及不可变深层更新。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
怎么在JavaScript中处理嵌套结构的JSON对象数组
作者:拾光
时间:2026-11-20
浏览:385
文章目录
JavaScript 数据结构进阶
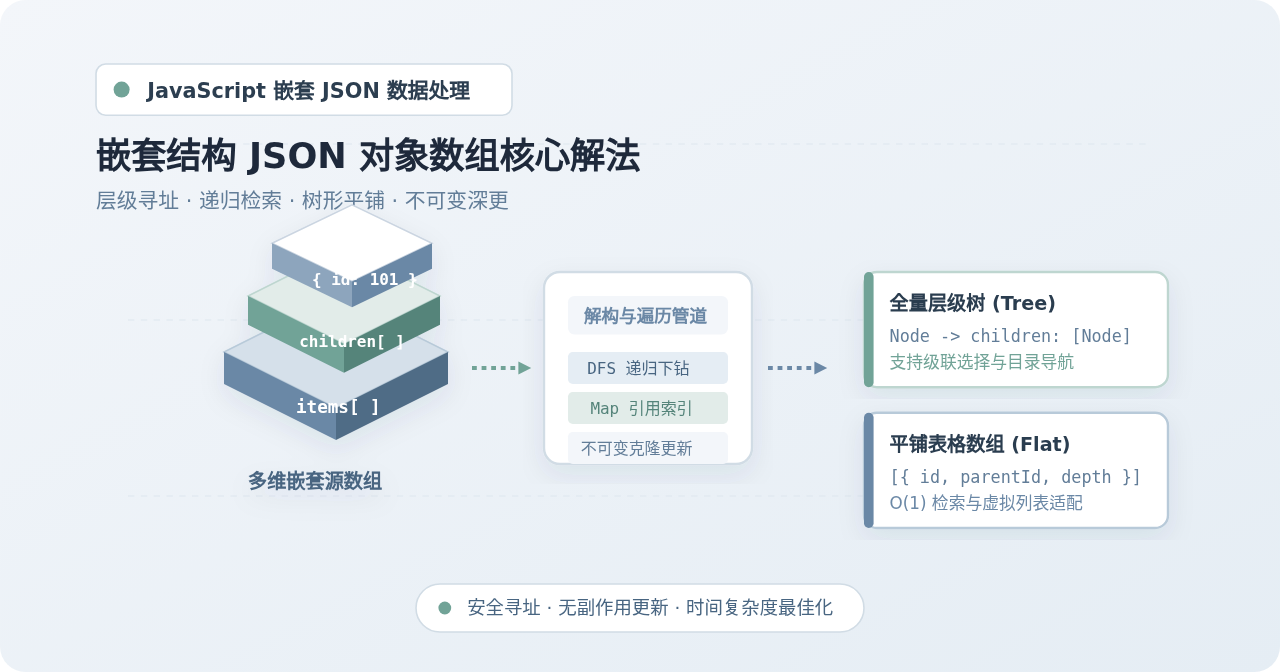
图 0(缩略图与全景概述):嵌套 JSON 对象数组的核心解法流转图,涵盖层级寻址、递归检索、形态转换与深更机制。
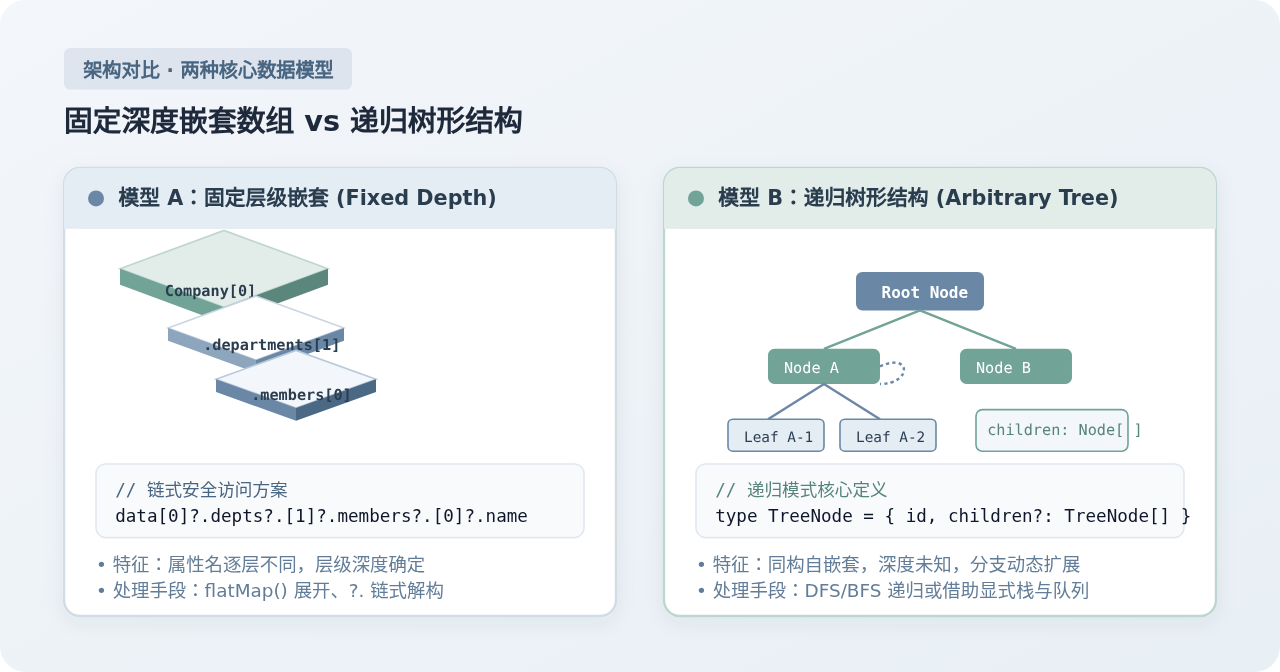
图 1(架构对比):固定深度嵌套数组与任意深度同构树的数据层级结构与内存引用模型对比。
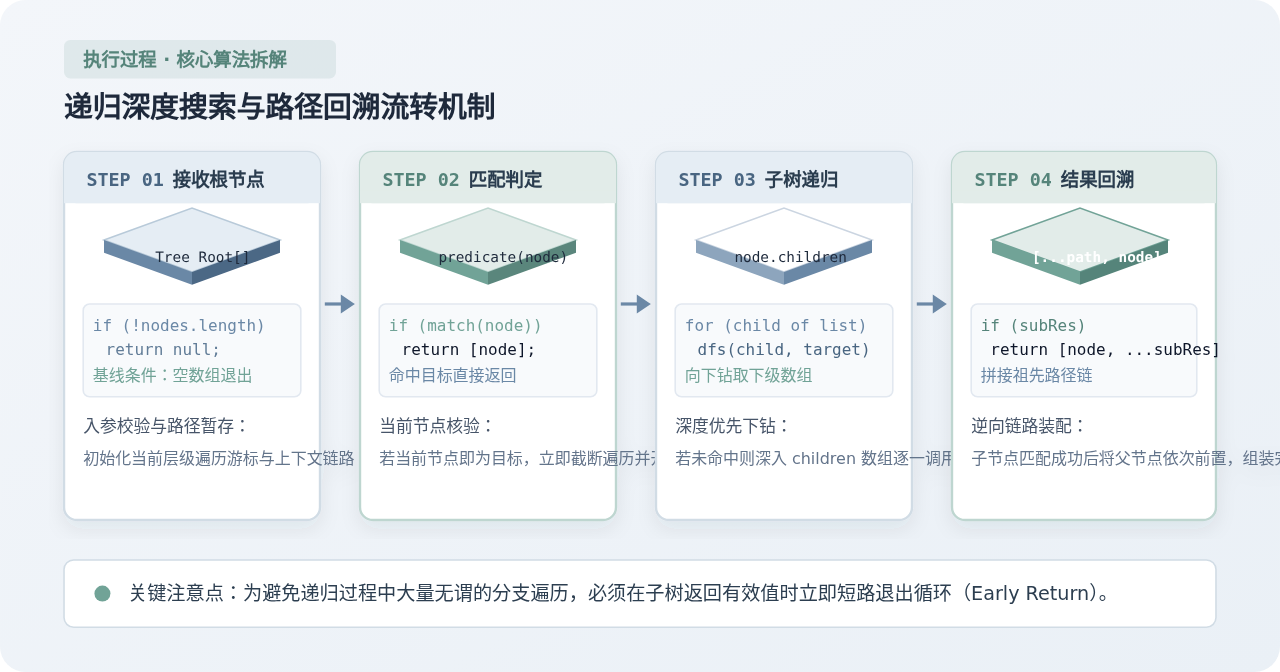
图 2(执行过程):深度优先遍历(DFS)与祖先链路回溯的四步流转流程。
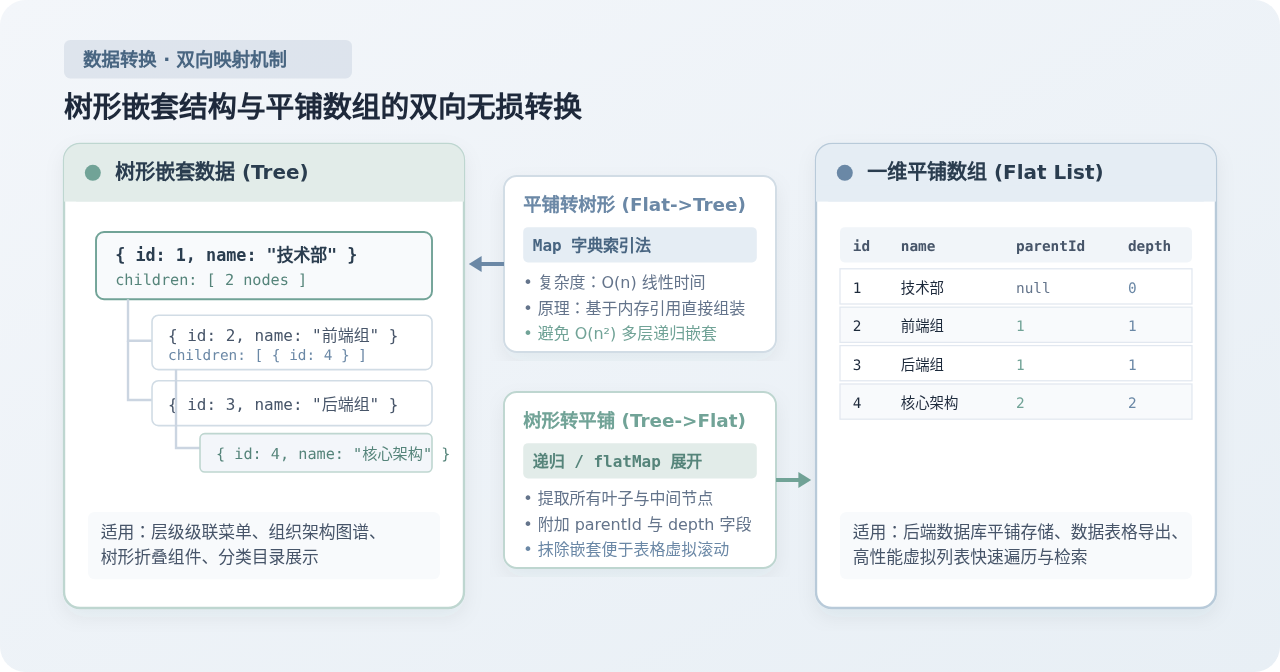
图 3(原理与映射):树形嵌套结构与扁平一维数组的双向转换流程与 O(n) Map 索引原理。
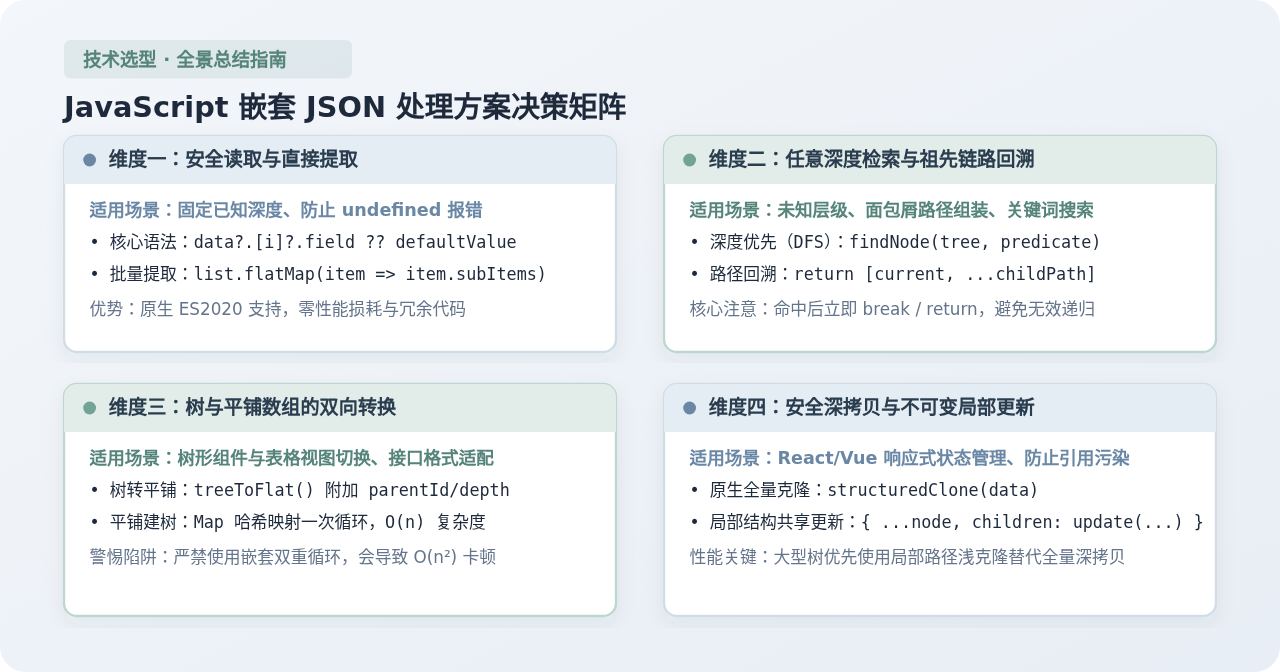
图 4(总结指南):处理嵌套结构 JSON 对象数组的四大功能维度与技术决策矩阵。
适用环境:现代浏览器 / Node.js 16+
技术标准:ECMAScript 2020+
主题:嵌套对象数组、树形遍历、递归与状态更新
处理嵌套结构的 JSON 对象数组,本质上是在解决多层路径安全寻址、未知深度遍历查找、树形与扁平结构双向转换以及不可变深层数据更新四大核心问题。本文以现代 JavaScript(ES2020+)规范为基础,提供一套可直接用于工程实践的完整解法与代码实现。
一、嵌套结构的数据形态与链式安全访问
在实际业务场景中,后端返回的嵌套 JSON 对象数组通常划分为两类形态:第一类是固定层级的多维嵌套(如组织列表中包含固定层级的子部门与人员数组),第二类是任意深度的同构树形结构(如权限目录、分类树,每个节点通过 children 数组持有下级节点)。
1. 使用可选链(?.)与空值合并(??)防止解构异常
直接使用多层属性访问(例如 data[0].departments[1].members[0].name)是极其脆弱的写法。一旦中间某个节点为 null 或 undefined,JavaScript 会立即抛出 TypeError: Cannot read properties of undefined。现代规范中应当统一采用可选链操作符配合空值合并操作符:
// 示例数据:公司-部门-成员固定嵌套结构
const companyData = [
  {
    companyId: "c_100",
    departments: [
      {
        deptId: "d_201",
        deptName: "技术中心",
        members: [
          { id: 1001, name: "张三", role: "架构师" },
          { id: 1002, name: "李四", role: "前端工程师" }
        ]
      }
    ]
  }
];

// 安全读取多层嵌套属性:若中间链条断裂,安全返回默认值 "未分配"
const firstMemberName = companyData[0]?.departments?.[0]?.members?.[0]?.name ?? "未分配";
console.log(firstMemberName); // 示例输出: 张三
2. 使用 flatMap() 提取固定深度的全部子集合
当只需要提取固定嵌套数组中的所有叶子数据时(例如提取全公司所有部门的成员列表),不需要编写多重 for 循环,使用原生 Array.prototype.flatMap() 可以实现一步展开:
// 将所有公司下所有部门的 members 拍平为一个一维数组
const allMembers = companyData
  .flatMap(company => company.departments ?? [])
  .flatMap(dept => dept.members ?? []);

console.log(allMembers);
// 示例输出: [ { id: 1001, name: "张三", role: "架构师" }, { id: 1002, name: "李四", role: "前端工程师" } ]
二、任意深度树结构的递归检索与路径回溯
对于层级无限深或深度动态变化的树状 JSON(例如无限级分类菜单),固定索引访问将不再适用,必须使用深度优先搜索(DFS)递归算法。
1. 任意深度查找单个目标节点
在递归遍历中,核心是确立基线条件(Base Case)并在子分支命中目标时立即短路返回(Early Return),避免无意义的遍历计算:
/**
 * 在任意深度的嵌套树中查找满足断言条件的第一个节点
 * @param {Array} tree 嵌套对象数组
 * @param {Function} predicate 判定函数
 * @returns {Object|null} 匹配的节点对象,未找到返回 null
 */
function findTreeNode(tree, predicate) {
  if (!Array.isArray(tree) || tree.length === 0) return null;

  for (const node of tree) {
    // 判定当前节点
    if (predicate(node)) return node;

    // 递归检查子数组
    if (Array.isArray(node.children) && node.children.length > 0) {
      const found = findTreeNode(node.children, predicate);
      if (found) return found; // 命中后截断循环立即返回
    }
  }

  return null;
}

// 测试树结构数据
const categoryTree = [
  {
    id: "cat_1",
    name: "数码家电",
    children: [
      {
        id: "cat_1_1",
        name: "智能手机",
        children: [
          { id: "cat_1_1_1", name: "折叠屏手机" }
        ]
      }
    ]
  }
];

// 检索 ID 为 "cat_1_1_1" 的目标节点
const targetNode = findTreeNode(categoryTree, node => node.id === "cat_1_1_1");
console.log(targetNode?.name); // 示例输出: 折叠屏手机
2. 面包屑导航场景:查找节点并返回其完整祖先路径
前端常见需求不仅是找到目标节点,还需要获取该节点在树中的上级链条(例如面包屑导航:数码家电 / 智能手机 / 折叠屏手机)。这需要利用回溯思想,将子递归返回的成功链路前置拼接当前节点:
/**
 * 查找目标节点,并返回由根至叶的完整路径数组
 * @param {Array} tree 树形数组
 * @param {Function} predicate 判定函数
 * @returns {Array} 包含沿途所有节点的数组;未找到返回空数组 []
 */
function findTreePath(tree, predicate) {
  if (!Array.isArray(tree)) return [];

  for (const node of tree) {
    // 1. 若当前节点匹配,路径初始包含自身
    if (predicate(node)) {
      return [node];
    }

    // 2. 向子节点下钻搜索
    if (Array.isArray(node.children) && node.children.length > 0) {
      const childPath = findTreePath(node.children, predicate);
      if (childPath.length > 0) {
        // 3. 回溯组装:父节点置于子链路之前
        return [node, ...childPath];
      }
    }
  }

  return [];
}

const breadcrumbPath = findTreePath(categoryTree, n => n.id === "cat_1_1_1");
console.log(breadcrumbPath.map(n => n.name).join(" / "));
// 示例输出: 数码家电 / 智能手机 / 折叠屏手机
三、树形结构与扁平列表的双向无损转换
在前后端交互中,后端的关联型数据库多采用扁平的带有 id 与 parentId 的结构存储,而前端组件库(如树组件、级联选择器)则需要层级嵌套的 children 树。掌握两者的双向转换是必备基本功。
1. 树形结构扁平化(Tree to Flat List)
将嵌套树展开为一维数组时,关键在于提取所有节点的同时记录层级关系(保存 parentId 和 depth),避免展开后丢失层级信息:
/**
 * 将树形结构转换为带有 parentId 和 depth 的一维扁平数组
 */
function treeToFlat(tree, parentId = null, depth = 0) {
  if (!Array.isArray(tree)) return [];

  return tree.reduce((acc, curr) => {
    const { children, ...itemWithoutChildren } = curr;

    // 当前节点拍平存入,保留父 ID 与深度标记
    acc.push({
      ...itemWithoutChildren,
      parentId,
      depth
    });

    // 若存在子节点,递归拍平并追加
    if (Array.isArray(children) && children.length > 0) {
      acc.push(...treeToFlat(children, curr.id, depth + 1));
    }

    return acc;
  }, []);
}
2. 扁平数组高效还原为树形结构(Flat List to Tree)
许多初学者会使用嵌套的双重循环或反复递归来构建树,其时间复杂度为 $O(n^2)$,当节点数量超过数千时会导致主线程明显卡顿。最优工业解法是利用 Map 哈希字典建立内存引用映射,只需单次遍历即可在 $O(n)$ 线性时间内完成树形组装:
/**
 * 线性时间 O(n) 将扁平列表转换为嵌套树结构
 * @param {Array} flatList 包含 id 与 parentId 的一维对象数组
 * @returns {Array} 顶层根节点树形数组
 */
function flatToTree(flatList) {
  if (!Array.isArray(flatList)) return [];

  const nodeMap = new Map();
  const roots = [];

  // 第一步:浅克隆节点并存入哈希字典,初始化 children 容器
  for (const item of flatList) {
    nodeMap.set(item.id, { ...item, children: [] });
  }

  // 第二步:遍历字典项,通过父节点引用建立树连接
  for (const item of flatList) {
    const current = nodeMap.get(item.id);
    const parent = nodeMap.get(item.parentId);

    if (parent) {
      parent.children.push(current);
    } else {
      // 没有父节点或父节点不存在,归为根节点
      roots.push(current);
    }
  }

  return roots;
}

// 验证数据
const flatData = [
  { id: 1, name: "研发中心", parentId: null },
  { id: 2, name: "前端组", parentId: 1 },
  { id: 3, name: "后端组", parentId: 1 },
  { id: 4, name: "架构小组", parentId: 2 }
];

const reconstructedTree = flatToTree(flatData);
console.log(reconstructedTree[0].children.length); // 示例输出: 2
四、嵌套数据的深拷贝与不可变安全更新
在现代前端框架(如 React、Vue 3)的状态驱动机制中,直接修改嵌套对象的内部属性会引发“数据隐式突变”或“视图无法响应刷新”的问题。
注意浅拷贝陷阱:使用
const copy = [...tree] 或 Object.assign() 只能克隆最外层数组,内层的子对象依然保持原始内存引用。修改 copy[0].children[0].title 会直接污染原始数据。
1. 现代原生深拷贝方案:structuredClone()
在 Node.js 17+ 及主流现代浏览器中,应当优先使用原生的 structuredClone() 代替历史遗留的 JSON.parse(JSON.stringify())。原生 API 能正确处理循环引用,并完整保留 Date、RegExp、Map、Set 等特殊内置类型:
// 原生现代深拷贝
const clonedTree = structuredClone(categoryTree);
clonedTree[0].children[0].name = "修改后的分类";

// 原始数据保持不变
console.log(categoryTree[0].children[0].name); // 智能手机
2. 局部不可变更新(结构共享)
若整个树规模庞大(包含数万节点),全量 structuredClone 会产生高昂的内存与性能开销。在函数式编程与状态管理中,推荐使用路径局部克隆(Structural Sharing)更新特定节点,未发生变动的分支直接复用原引用:
/**
 * 局部不可变更新树中的指定节点
 * @param {Array} tree 原树形数组
 * @param {string|number} targetId 目标节点 ID
 * @param {Function} updateFn 更新逻辑函数
 * @returns {Array} 产生的新树数组(未变动分支引用保持不变)
 */
function updateTreeNodeImmutable(tree, targetId, updateFn) {
  if (!Array.isArray(tree)) return [];

  return tree.map(node => {
    // 命中目标节点:克隆并应用更新函数
    if (node.id === targetId) {
      return updateFn({ ...node });
    }

    // 若存在子节点,递归处理子节点数组
    if (Array.isArray(node.children) && node.children.length > 0) {
      return {
        ...node,
        children: updateTreeNodeImmutable(node.children, targetId, updateFn)
      };
    }

    // 未涉及变动的分支,直接返回原引用
    return node;
  });
}
五、处理方案选型与技术总结
针对不同的工程目标与数据规模,下表总结了在 JavaScript 中处理嵌套 JSON 对象数组的主流手段与选型建议:
| 操作维度 | 推荐方法 / 核心 API | 时间复杂度 | 空间复杂度 | 典型适用场景与限制 |
|---|---|---|---|---|
| 浅层安全访问 | ?. 可选链 + ?? 默认值 |
$O(1)$ | $O(1)$ | 固定层级读取,避免 TypeError 报错中断。 |
| 固定深度展开 | Array.prototype.flatMap() |
$O(n)$ | $O(n)$ | 已知嵌套层数的子数组批量提取与聚合。 |
| 任意深度检索 | DFS 深度优先递归 + 短路返回 | $O(n)$ | $O(h)$ 递归栈 | 未知深度节点查找;极端深树需改用显式栈防溢出。 |
| 面包屑回溯 | 回溯法(前置拼接父节点) | $O(n)$ | $O(h)$ 链路存储 | 级联目录、菜单展开路径、关联标签反查。 |
| 平铺转树形 | Map 哈希索引法 | $O(n)$ 线性 | $O(n)$ 字典存储 | 严禁使用双重循环递归;需保证 parentId 准确。 |
| 全量深拷贝 | structuredClone() |
$O(n)$ | $O(n)$ | 需彻底解耦原数据;不支持函数及 DOM 节点克隆。 |
| 局部不可变更新 | 纯函数式递归 + 展开运算符 | $O(n)$ 最坏 | $O(h)$ 变动分支 | React/Vue 响应式状态管理,保持无变动引用复用。 |
递归栈溢出防护提醒:在 V8 引擎中,调用栈深度上限约为 10000 层。若处理的数据来源包含极端超深层级或存在循环引用,应当将函数递归替换为显式数组模拟的迭代栈(Stack)或队列(Queue),以确保运行时的绝对健壮。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章