

深入解析前端JavaScript加密过程中中文出现乱码的核心根源,涵盖UTF-16与UTF-8字节流差异、CryptoJS解码陷阱与前后端字符集对齐,提供完整的AES与原生Web Crypto修复代码与排查方案。
前端JS加密出现中文乱码的原因及修复方案
作者:寒星
时间:2026-11-19
浏览:297
文章目录
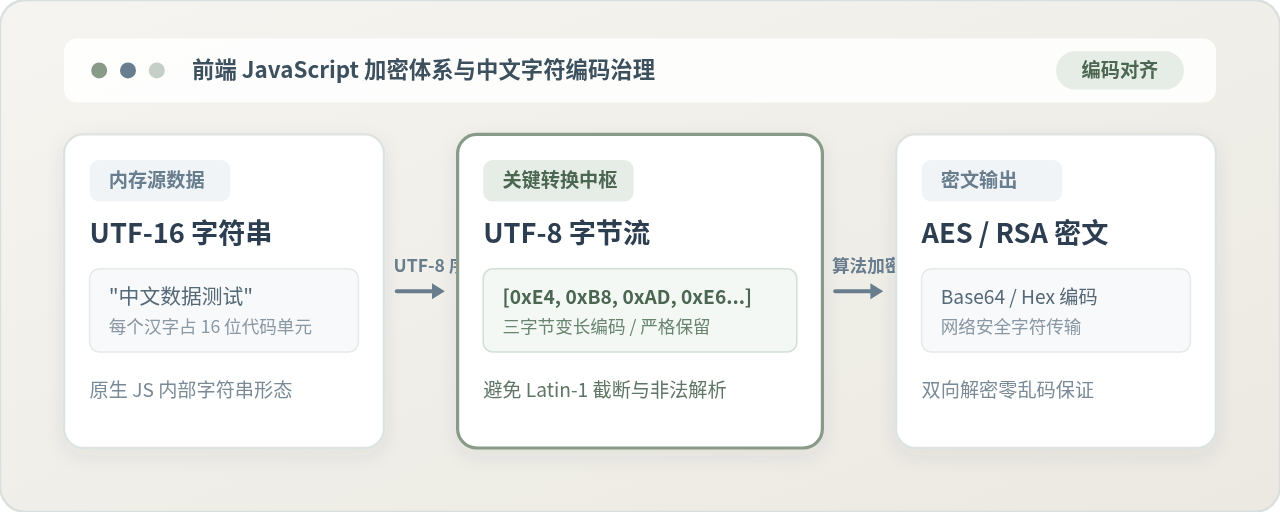
在前端使用 JavaScript 进行数据加密时,中文出现乱码或解密失败的根本原因,在于加密算法底层只接收二进制字节序列,而 JavaScript 字符串在内存中默认使用 UTF-16 代码单元;若在将字符串转为字节数组、或者解密后将字节还原为字符串时,未显式声明并统一使用 UTF-8 编码规范,就会因为高位字节截断、默认字符集(如 ISO-8859-1 或 GBK)不匹配而导致乱码。解决这一问题的标准路径是:加密前将明文统一转为 UTF-8 字节流,解密后使用 UTF-8 解码器严格还原,并在前后端交互链路中保持填充方式与字符集的一致性。
一、常见乱码现象与快速归因
在实际项目开发中,前端加密涉及中文字符时,往往在联调或解密阶段暴露问题。开发者常遇到的乱码现象主要表现为以下四种形态,每种形态都对应着明确的底层断点:
| 乱码表现形态 | 典型输出示例 | 根本原因归类 |
|---|---|---|
| 生僻欧文符号拼凑 | æµè¯æ°æ® 或 éè |
UTF-8 编码生成的多字节序列,在解密或传输时被误当成 Latin-1(ISO-8859-1)单字节字符集重新解释。 |
| 黑色菱形带问号 | �� |
多字节 UTF-8 序列发生物理截断(如 charCodeAt 截取丢失高位,或网络传输中字节丢失),解码器无法识别非法前缀。 |
| 输出纯十六进制串 | e6b58be8af95 |
CryptoJS 解密后直接调用 toString(),未传参时默认采用了 Hex 格式输出,而非 UTF-8 字符。 |
| 运行时抛出异常 / 空串 | Malformed UTF-8 data |
解密密钥不匹配、IV 偏移损坏或解密填充失效,导致解密出的垃圾字节不符合 UTF-8 编码结构。 |
注意事项:当遇到解密直接抛出
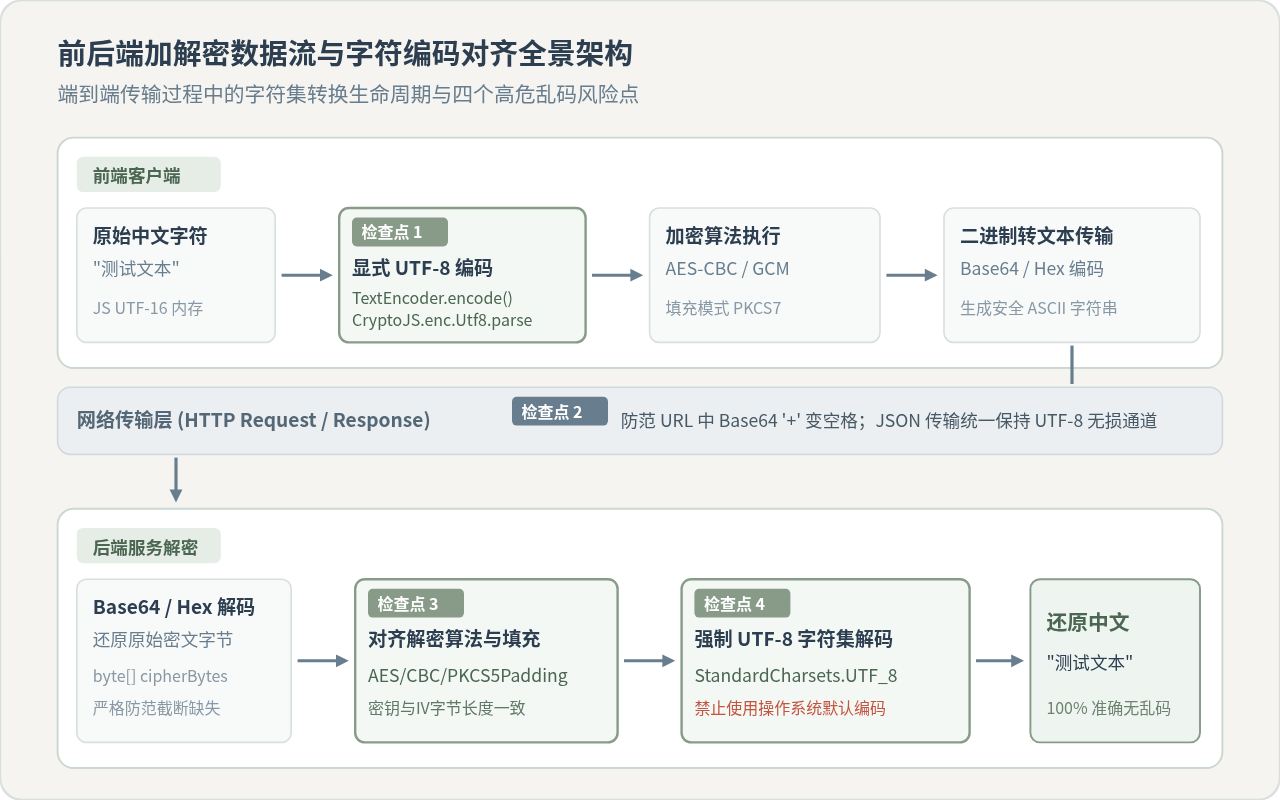
Error: Malformed UTF-8 data 时,第一排查点不是字符集声明,而是解密密钥、初始向量(IV)或填充方式(Padding)是否与加密端完全一致。如果算法解出的字节本身就是损坏的伪随机字节,UTF-8 解码器校验其引导位时必然报错。
二、底层原理:JS 内存编码与加密字节流的冲突
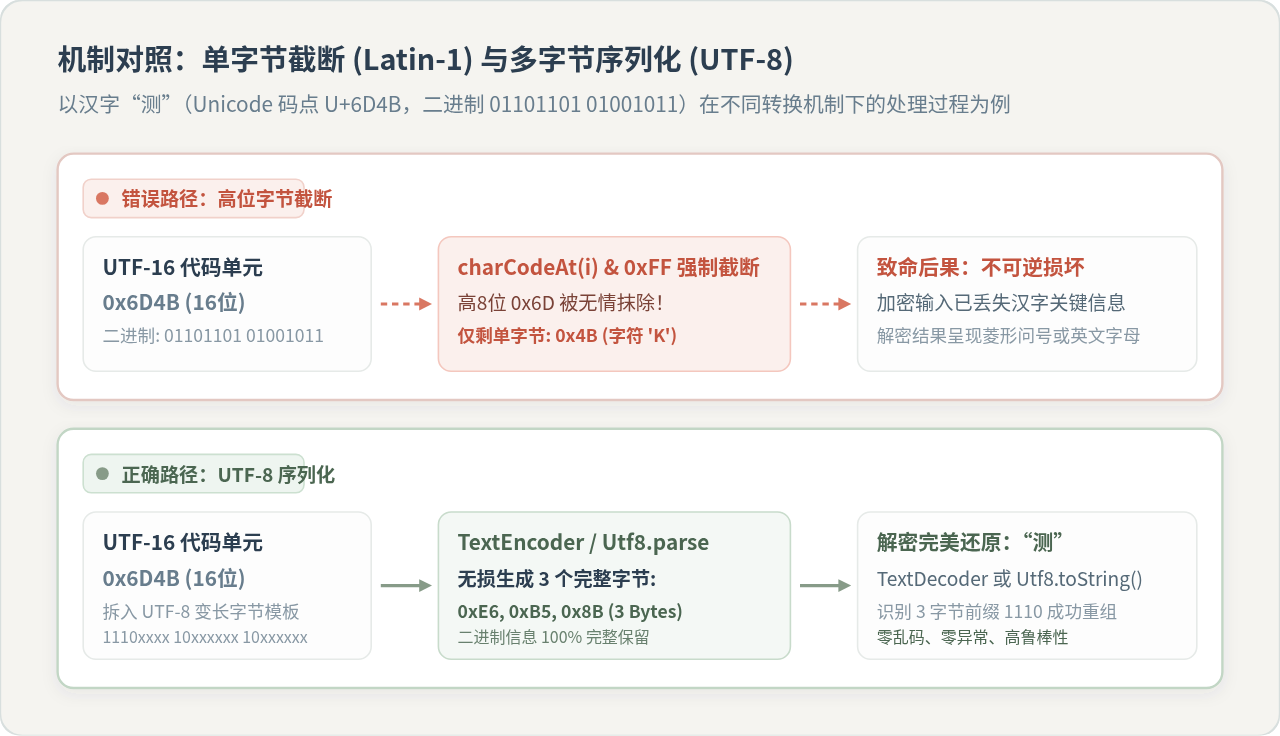
JavaScript 引擎内部(ECMAScript 规范)对字符串的存储基于 UTF-16 编码,每个常见字符(基本多语言平面 BMP)以一个 16 位的代码单元(Code Unit)表示。例如汉字“测”的 Unicode 码点为 U+6D4B,其 16 位二进制数值为 01101101 01001011。
然而,所有的现代加密算法(如 AES、DES、RSA)在数学层面都是针对 8 位无符号整数(Uint8Array,即 Byte)构成的二进制数据块进行运算的。这就必然引出一个核心问题:如何把 16 位的 JS 字符序列转换成加密算法所需的 8 位字节流?
两种转换机制的关键差异
早期前端代码或部分编写不规范的工具库,往往直接采用按字符遍历并强行截取低 8 位的方式处理输入;而现代规范做法则是严格进行 UTF-8 变长字节序列化。这两种做法在一致条件下的对比揭示了乱码产生的本质:
-
单字节强转 / Latin-1 截断:如果通过
str.charCodeAt(i) & 0xFF获取字节,对于字符“测”(0x6D4B),其高 8 位0x6D被直接抹除,只留下了低 8 位的0x4B(对应 ASCII 字符 'K')。汉字原本的语义结构在加密前就已经被物理破坏,后续无论怎样解密都不可能还原。 -
UTF-8 变长序列化:UTF-8 是一种针对 Unicode 的可变长度字符编码。对于码点在
U+0800到U+FFFF之间的中文字符,UTF-8 采用 3 个字节进行封装(格式为1110xxxx 10xxxxxx 10xxxxxx)。汉字“测”经 UTF-8 转换后精确生成 3 个字节:0xE6, 0xB5, 0x8B。所有位信息完整保留,解密后可通过三字节引导位完整恢复原汉字。
三、典型加密场景的乱码成因与修复代码
场景 1:CryptoJS 中的 AES 对称加解密标准修复
在主流的 crypto-js 库中,很多开发者习惯直接将字符串传入 CryptoJS.AES.encrypt("中文", key)。虽然 CryptoJS 内部对明文会尝试使用 Utf8 处理,但对于 key、iv 以及解密后的输出却极其容易掉入陷阱。
最致命的常见错误发生在解密后:调用 decrypted.toString() 时如果不传递参数,CryptoJS 默认使用的是 CryptoJS.enc.Hex(十六进制编码),而不是 UTF-8 文本!
// =================== 错误写法示范 ===================
const rawKey = "1234567890123456";
const ciphertext = CryptoJS.AES.encrypt("测试中文内容", rawKey).toString();

const decrypted = CryptoJS.AES.decrypt(ciphertext, rawKey);
// 错误!decrypted.toString() 默认返回 Hex 编码字符串,如 "e6b58be8af95..."
const result = decrypted.toString();

// =================== 正确标准写法 ===================
// 1. 显式将密钥与初始向量解析为 UTF-8 WordArray
const key = CryptoJS.enc.Utf8.parse("1234567890123456");
const iv  = CryptoJS.enc.Utf8.parse("1234567890123456");

// 2. 明文显式转为 UTF-8 字节流后再加密
const message = "测试中文内容:精准治理字符集";
const messageUtf8 = CryptoJS.enc.Utf8.parse(message);

const encrypted = CryptoJS.AES.encrypt(messageUtf8, key, {
  iv: iv,
  mode: CryptoJS.mode.CBC,
  padding: CryptoJS.pad.Pkcs7
});
const base64Ciphertext = encrypted.toString(); // 密文转为 Base64 字符串

// 3. 解密时显式传参 CryptoJS.enc.Utf8 进行还原
const decryptedBytes = CryptoJS.AES.decrypt(base64Ciphertext, key, {
  iv: iv,
  mode: CryptoJS.mode.CBC,
  padding: CryptoJS.pad.Pkcs7
});

// 关键修复:显式使用 UTF-8 编码器输出明文
const originalText = decryptedBytes.toString(CryptoJS.enc.Utf8);
console.log("解密还原成功:", originalText);
场景 2:原生 Web Crypto API 的现代化无依赖方案
现代浏览器已全面内置 window.crypto.subtle(Web Crypto API)。相比第三方库,原生 API 完全基于原生的 ArrayBuffer 和 Uint8Array,配合 TextEncoder 与 TextDecoder,能从语法层面彻底杜绝字符集的隐式转换风险。
// 使用原生 Web Crypto API 实现安全的中文 AES-GCM 加解密
async function aesGcmEncrypt(plainText, keyBytes) {
  // 1. 严格使用 TextEncoder 转为 UTF-8 字节流
  const encoder = new TextEncoder();
  const data = encoder.encode(plainText);

  // 2. 导入 256 位密钥
  const cryptoKey = await window.crypto.subtle.importKey(
    "raw", keyBytes, { name: "AES-GCM" }, false, ["encrypt"]
  );

  // 3. 生成 12 字节随机 IV 并执行加密
  const iv = window.crypto.getRandomValues(new Uint8Array(12));
  const encryptedBuffer = await window.crypto.subtle.encrypt(
    { name: "AES-GCM", iv: iv }, cryptoKey, data
  );

  return { iv, ciphertext: new Uint8Array(encryptedBuffer) };
}

async function aesGcmDecrypt(ciphertext, iv, keyBytes) {
  const cryptoKey = await window.crypto.subtle.importKey(
    "raw", keyBytes, { name: "AES-GCM" }, false, ["decrypt"]
  );

  const decryptedBuffer = await window.crypto.subtle.decrypt(
    { name: "AES-GCM", iv: iv }, cryptoKey, ciphertext
  );

  // 4. 严格使用 UTF-8 TextDecoder 还原中文字符串
  const decoder = new TextDecoder('utf-8');
  return decoder.decode(decryptedBuffer);
}
场景 3:RSA 非对称加密中的“分段截断”乱码
RSA 加密算法对每次加密的数据长度有严格限制。例如 1024 位的 RSA 密钥(128 字节)在采用 PKCS#1 v1.5 填充时,最大只能加密 128 - 11 = 117 字节的数据。很多开发者会对长字符串进行切片分段加密。
常见陷阱:如果直接对中文字符串使用 str.slice(0, 50) 按字符个数切片,由于中文字符在 UTF-8 中占用 3 字节,若某一个汉字的 3 个字节恰好跨越了分段边界,该汉字就会被劈成两半,导致解密端在这两个分段交界处均发生 UTF-8 校验失败并输出乱码问号。
修复准则:RSA 分段加密必须先将全文字符串转为 UTF-8 的 Uint8Array 字节数组,在字节数组的层面上按照最大安全字节数(如 117 字节)切片,然后再逐段加密。
四、系统排查与分步修复流程
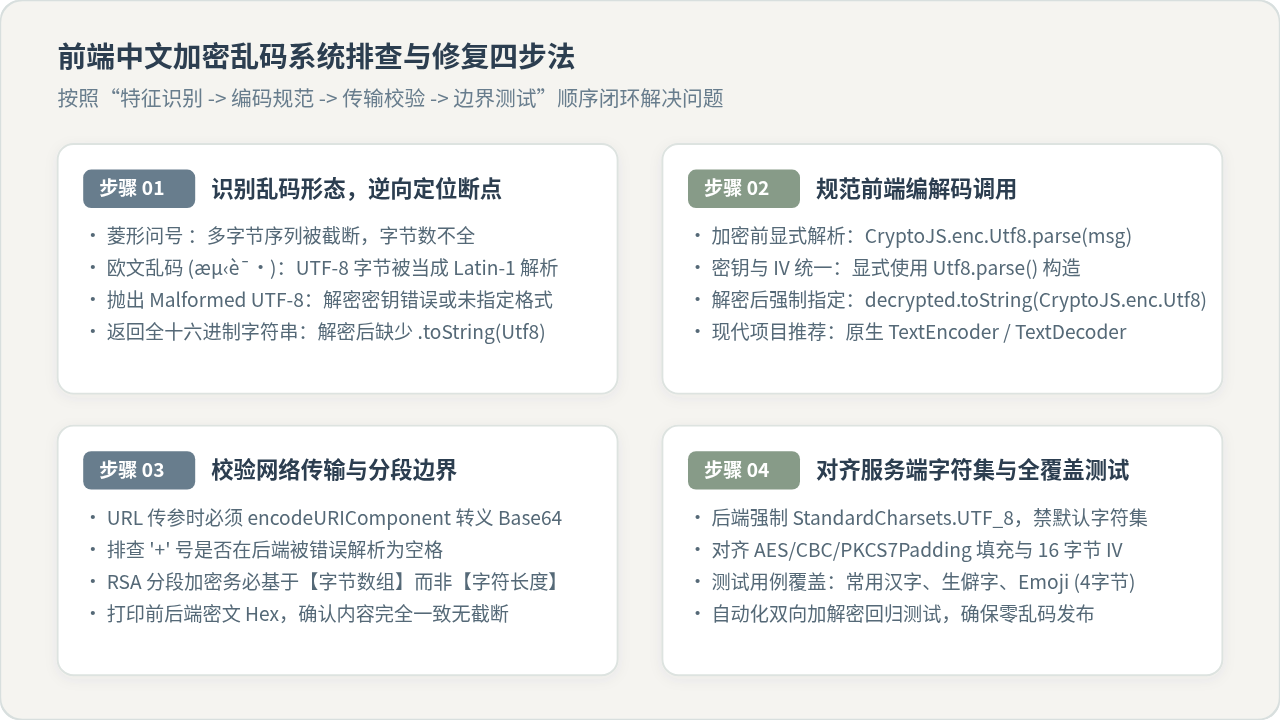
当遇到线上或联调中文字符加密乱码时,推荐遵循以下四个标准步骤进行定位排查,由表及里快速闭环:
步骤 1:定位乱码特征形态
观察解密端输出。如果中文字符变成了类似 æµè¯ 的西欧字符,说明 UTF-8 字节被错误地以 Latin-1 或 Windows-1252 解码;如果全变成菱形问号 ,说明字节序列在加密前或分段时遭遇了高位截断;如果直接抛出 Malformed UTF-8,应首先确认加解密的 Key、IV 与算法模式是否完全一致。
步骤 2:检查输入与输出的编码器调用
检查前端源码中所有加密函数的入口与出口。确认明文输入是否包裹了 CryptoJS.enc.Utf8.parse() 或 new TextEncoder().encode();确认解密结果输出是否传入了 CryptoJS.enc.Utf8 或通过 TextDecoder 还原。
步骤 3:验证密文网络传输与 URL 转义
密文字节流通常以 Base64 形式在网络上传输。在 Base64 字符表中包含 +、/ 和 =。如果密文是通过 HTTP GET 请求的 URL Query 参数或 application/x-www-form-urlencoded 格式提交,加号 + 会被标准 Web 服务器(如 Nginx、Tomcat、Express)自动解析为空格!这会导致服务端 Base64 解码出现字节错位,引发解密失败或局部乱码。
修复方案:前端在拼接 URL 参数时,必须对 Base64 密文使用 encodeURIComponent(ciphertext) 转义,或使用 URL 安全的 Base64 替换方案(将 + 替换为 -,/ 替换为 _)。
步骤 4:对齐服务端解码字符集
检查后端服务代码(如 Java、Node.js、Python、Go)。后端在对解密出来的字节数组(byte[])构建字符串时,绝不能调用无参的 new String(bytes),因为这会读取服务端操作系统的环境变量默认编码(在 Windows 下常为 GBK,在容器内可能为 POSIX-C)。必须显式声明字符集:
- Java:
new String(decryptedBytes, StandardCharsets.UTF_8); - Node.js:
Buffer.from(decryptedBytes).toString('utf-8'); - Python:
decrypted_bytes.decode('utf-8') - Go:
string(decryptedBytes)(Go 语言标准字符串原生即为 UTF-8 编码)
五、前后端联调核对清单与防范总结
为了防止中文乱码问题再次发生,项目团队在接入前端加解密组件时,应将字符编码治理纳入工程规范,并建立常态化的自查机制。
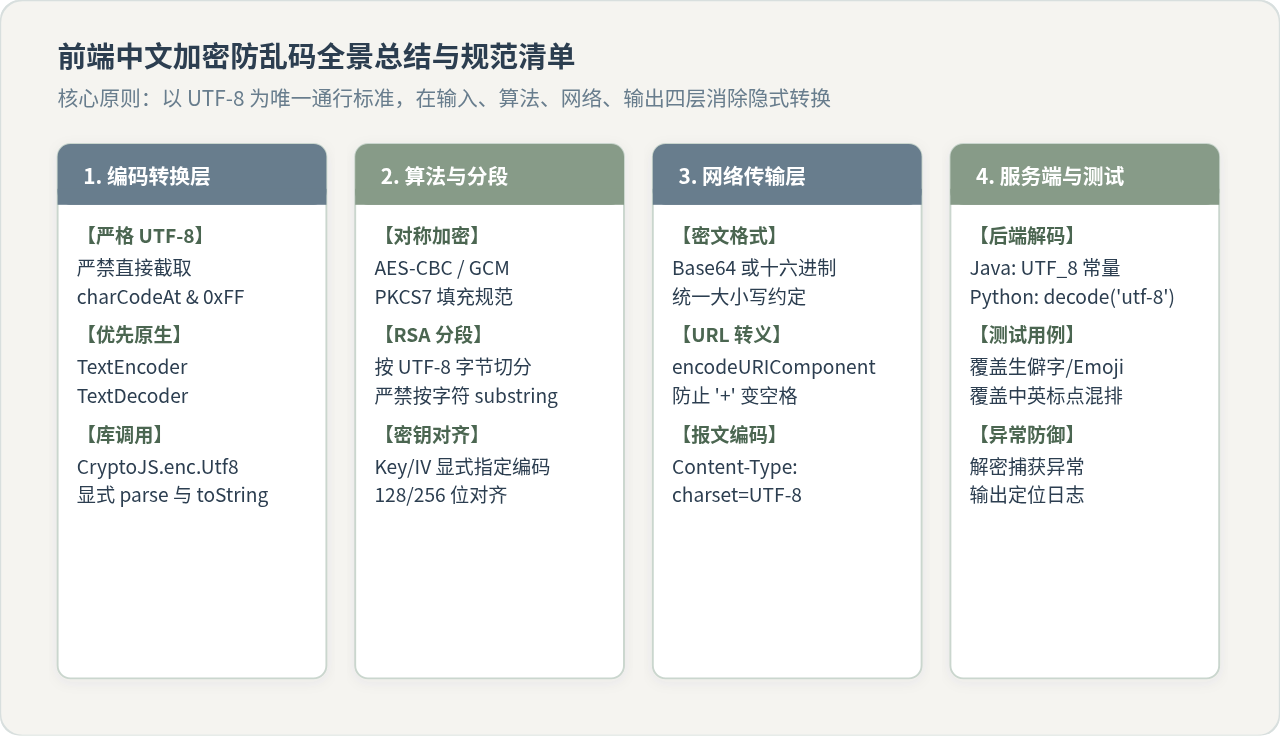
测试用例覆盖清单
在上线前,必须执行包含以下极端字符的加解密单元测试用例,确保双向传输无损:
- 标准简体与繁体汉字:如
"中华人民共和国"、"繁體中文測試"(验证标准 3 字节 UTF-8 处理)。 - 中英文与标点混合:如
"Order #12345:已支付 ¥99.80 (CN)"(验证不同字节长度交替时的边界处理)。 - Unicode 辅助平面 4 字节字符:如生僻字
"𠮷"(U+20BB7)或常见表情符号"🚀🔒"(验证是否完整支持代理对 Surrogate Pairs 转换)。 - 空字符串与纯空格:验证加解密管道对空边界的健壮性。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章