
深入讲解JavaScript前端搜索功能中大小写不敏感匹配、正则表达式特殊字符转义、Unicode变音符号归一化处理及高亮XSS防护,提供完整可运行的代码方案与避坑指南。

当前位置:首页 > JavaScript 基础 > 正文
JS搜索功能怎么处理大小写和特殊字符
作者:寒星
时间:2026-11-19
浏览:78
文章目录
实现前端搜索时,大小写不匹配会导致搜不到预期内容,而未转义的特殊字符更会直接让正则表达式抛出
SyntaxError 报错导致页面崩溃。解决这一问题的核心逻辑非常清晰:大小写依赖数据与输入的统一标准化折叠(toLowerCase 与 Unicode 归一化);特殊字符则依据检索方式分流——纯文本匹配使用 includes,正则匹配则必须通过元字符转义函数(escapeRegExp)将特殊符号还原为字面量,并在输出高亮时做好 HTML 防注入。
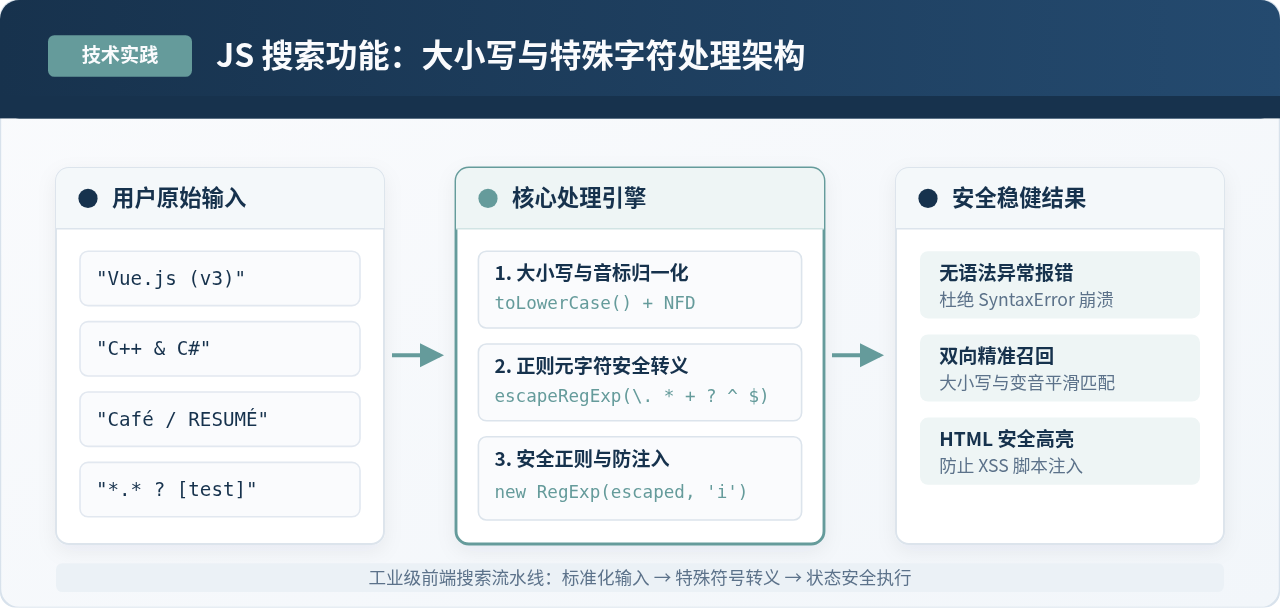
一、大小写不敏感匹配的实现与进阶处理
在默认情况下,JavaScript 中的字符串比对(如 indexOf、includes 或正则)都是严格区分大小写的。输入小写的 vue 无法匹配到 Vue 或 VUE。解决大小写问题有两种常见路径。
1. 统一大小写折叠(toLowerCase)
最直接、执行效率最高的方法是在比对前,将“待搜索的目标文本”与“用户输入的关键词”同时转为小写:
// 基础的字符串小写匹配
function simpleSearch(list, query) {
  const normalizedQuery = query.trim().toLowerCase();
  if (!normalizedQuery) return list;

  return list.filter(item =>
    item.name.toLowerCase().includes(normalizedQuery)
  );
}
这种做法性能优秀且没有语法报错的风险,适用于纯列表过滤场景。但它的不足在于:如果界面需要将匹配项高亮显示,直接比对无法保留原文本本身的大小写形式。
2. 使用正则的 i 修饰符
如果希望在过滤的同时保留原文本的大小写,或者后续需要进行文本替换高亮,正则表达式的 i(ignoreCase)修饰符是标准解法:
// 正则忽略大小写(注意:未转义特殊字符前存在安全隐患)
const regex = new RegExp(query, 'i');
const isMatch = regex.test(targetText);
3. 变音符号与 Unicode 归一化(Normalize)
在涉及包含重音符号或多语言拼写的词汇时(例如 café 与 cafe、résumé 与 resume),普通的 toLowerCase() 仍会判定为不相等。现代 JavaScript 提供了标准的 String.prototype.normalize() API,可以通过分解(NFD)形式将字母与附加符号分离,再去除音标:
// 剥离变音符号的归一化函数
function stripDiacritics(str) {
  return str
    .normalize('NFD')
    .replace(/[̀-ͯ]/g, '')
    .toLowerCase();
}
通过先将待检索文本与查询词均执行该函数,即使用户输入不带音标的 cafe,也能准确搜出包含 café 的条目。
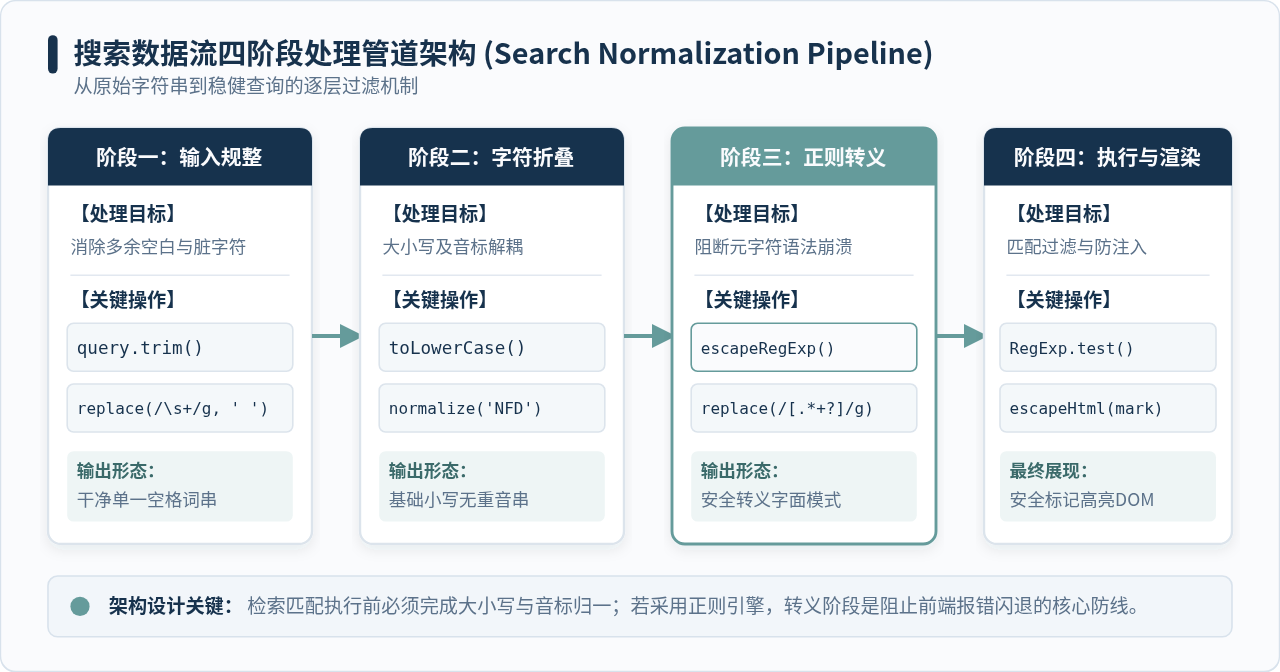
二、特殊字符引发的问题与转义策略
相比大小写匹配,特殊字符是前端搜索中引发 Bug 和异常中断的最高发区域。很多开发者测试时仅输入英文或汉字,一旦用户在搜索框中键入 (、[、*、+、? 或 .,程序就会立即出现意外行为。
1. 为什么特殊字符会导致崩溃?
在正则表达式中,以下 14 个字符被定义为元字符(Metacharacters),具有特殊的语法含义:
. * + ? ^ $ { } ( ) | [ ] \ /
当开发者编写 new RegExp(query, 'i') 时,JavaScript 会将 query 视为正则表达式语法解析:
- 如果用户输入未闭合的左括号
(,引擎会解析为未完成的分组捕获,直接抛出Uncaught SyntaxError: Invalid regular expression: /(/: Unterminated group,导致整段 JS 脚本中断。 - 如果用户输入星号
*或加号+,会抛出SyntaxError: Invalid regular expression: nothing to repeat。 - 如果用户输入单句点
.,它在正则中代表“匹配除换行符外的任意单个字符”,从而导致输入点号时召回了所有数据,产生虚假全匹配。
2. 工业级特殊字符转义函数(escapeRegExp)
要安全地在正则中使用用户输入的字符串,必须在将变量传入 new RegExp() 之前,对所有保留元字符添加反斜杠 \ 进行字面量转义。以下是经过社区长期验证的标准转义函数:
/**
 * 将字符串中的正则元字符安全转义为字面量字符
 * 覆盖字符:.*+?^${}()|[]\
 */
function escapeRegExp(string) {
  return string.replace(/[.*+?^${}()|[\]\\]/g, '\$&');
}
代码解析:
1. /[.*+?^${}()|[\]\\]/g:方括号内的集合列举了所有正则元字符。由于 ]、\ 在字符集中也具有语法意义,因此进行了单独的反斜杠转义。
2. '\$&':替换字符串中的 $& 是特殊替换变量,表示“本次正则匹配到的整个子串”。\$& 即在匹配到的每一个特殊字符前面拼接一个转义反斜杠。
例如输入 "C++ (v2.0) [test]",经过该函数后会变成 "C\+\+ \(v2\.0\) \[test\]",再传入正则构造器就能完全当作普通文本字符进行精准比对。
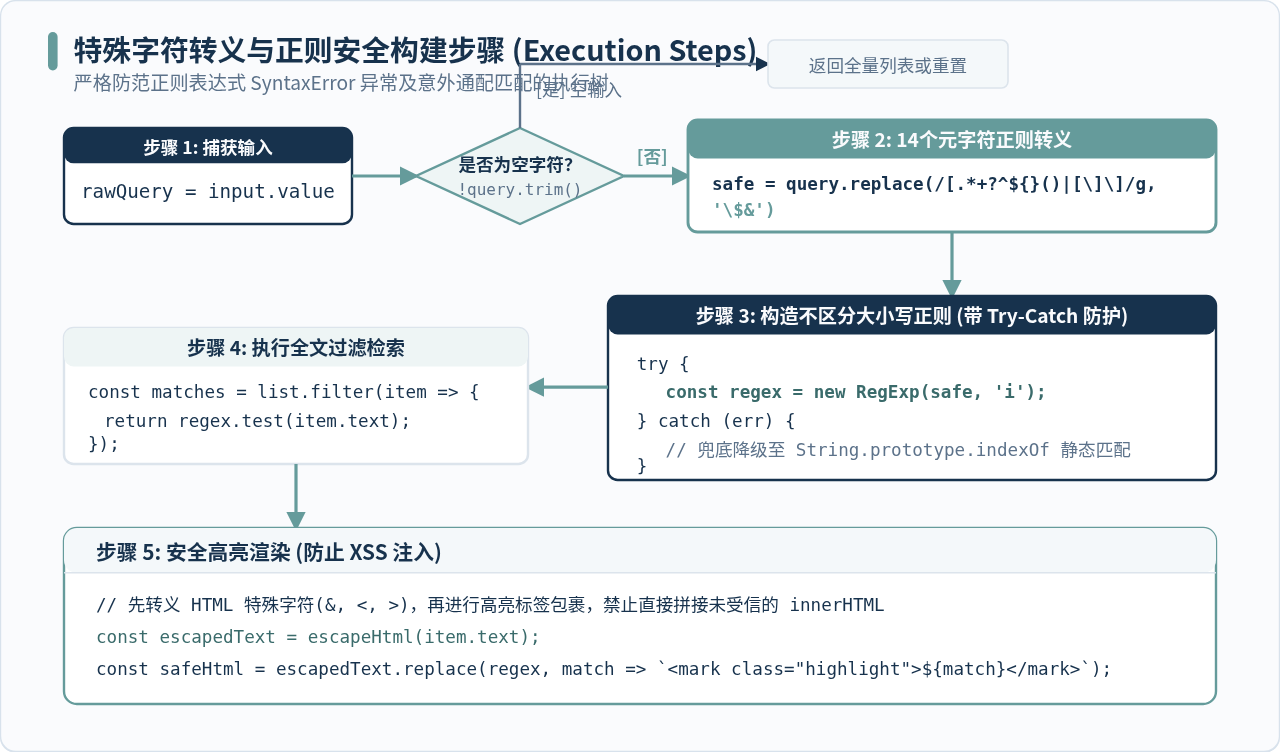
三、匹配方案对比与选型指南
在实际项目中,面对大小写与特殊字符处理,常见有三种不同的技术路线。了解其差异有助于根据数据量和 UI 交互合理选择:
- 方案 A(原生 includes + toLowerCase):实现最简单,纯字符串比对,完全不经过正则编译器,因此绝对不存在特殊字符崩溃的问题。但缺点是难以直接完成关键词精准高亮。
- 方案 B(escapeRegExp + RegExp):兼顾灵活性与安全性,使用
i修饰符天然处理大小写,转义函数解决特殊字符报错,通过replace可以轻松将命中片段包裹为高亮标签,是综合体验最佳的推荐方案。 - 方案 C(第三方模糊搜索库,如 Fuse.js):适用于长文本、错别字容错或权重打分场景。内部已处理字符规范,但引入了额外的体积与索引开销。
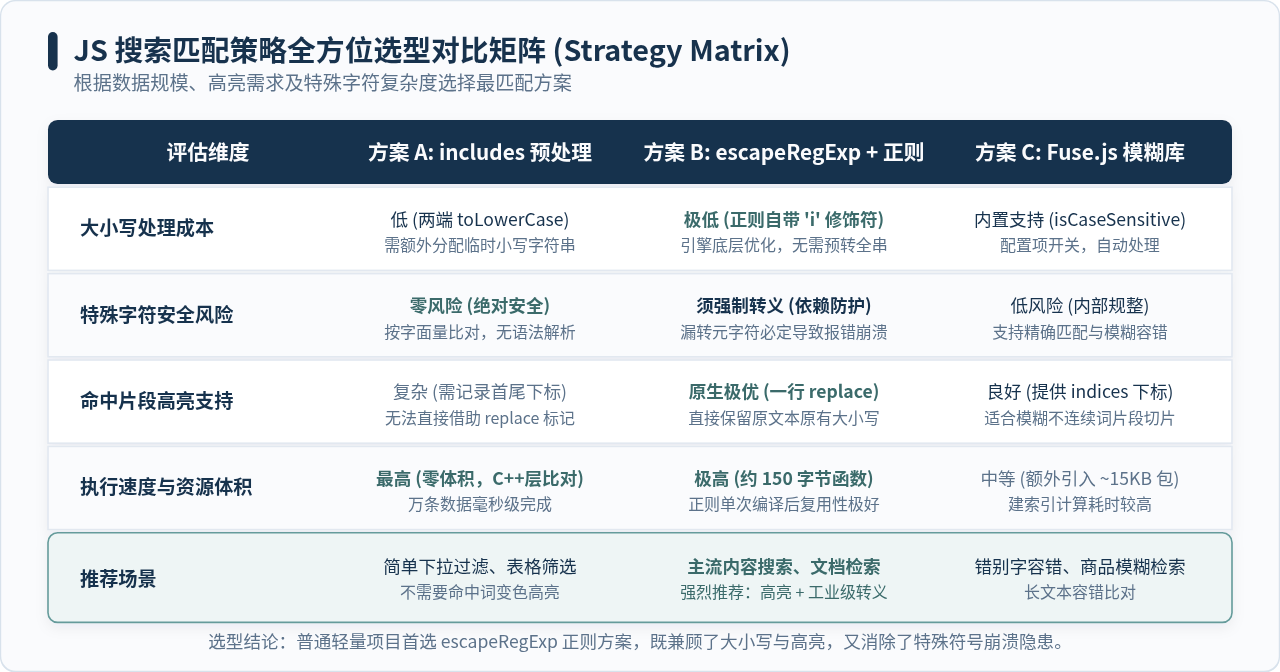
四、完整可运行实战方案封装
结合前面分析的大小写归一化、特殊字符转义以及高亮防 XSS 注入,我们可以封装一个通用、稳健的搜索匹配器。
1. 完整封装代码
/**
* 健壮的前端搜索工具集
*/
const SearchHelper = {
// 1. 正则元字符转义
escapeRegExp(str) {
return String(str).replace(/[.*+?^${}()|[\]\\]/g, '\$&');
},
// 2. HTML 实体转义(防范高亮拼接导致的 XSS 注入)
escapeHtml(str) {
const htmlEntities = {
'&': '&',
'<': '<',
'>': '>',
'"': '"',
"'": '''
};
return String(str).replace(/[&<>"']/g, tag => htmlEntities[tag] || tag);
},
// 3. 安全创建不区分大小写的 RegExp 实例
createSafeRegExp(query, flags = 'i') {
const trimmed = String(query).trim();
if (!trimmed) return null;
const escaped = this.escapeRegExp(trimmed);
try {
return new RegExp(escaped, flags);
} catch (e) {
console.warn('正则初始化失败,降级为空匹配:', e);
return null;
}
},
// 4. 执行数据列表检索与安全高亮渲染
searchAndHighlight(items, query, textField = 'title') {
const regex = this.createSafeRegExp(query, 'gi');
// 查询词为空时,直接返回原列表且转义文本
if (!regex) {
return items.map(item => ({
...item,
_highlighted: this.escapeHtml(item[textField])
}));
}
const results = [];
for (const item of items) {
const rawText = String(item[textField] || '');
// 重置 lastIndex,防范带 'g' 标记时的状态累加Bug
regex.lastIndex = 0;
if (regex.test(rawText)) {
// 先对内容做 HTML 转义,再执行高亮标记包裹
const safeContent = this.escapeHtml(rawText);
const highlighted = safeContent.replace(regex, match =>
`<mark class="highlight">${match}</mark>`
);
results.push({
...item,
_highlighted: highlighted
});
}
}
return results;
}
};2. 验证效果示例
假设我们有以下待检索的示例数据列表:
const mockData = [
{ id: 1, title: "Vue.js (v3.2) 入门指南" },
{ id: 2, title: "精通 C++ / C# 异步编程" },
{ id: 3, title: "Web 前端 <script> 脚本安全实践" },
{ id: 4, title: "巴黎的 Café 文化探讨" }
];
// 测试用例 1:搜索带括号与小写的 "vue.js ("
const res1 = SearchHelper.searchAndHighlight(mockData, "vue.js (");
// 输出:精准命中 ID:1,高亮展示为 "<mark class="highlight">Vue.js (</mark>v3.2) 入门指南",不报错
// 测试用例 2:搜索带加号的 "c++"
const res2 = SearchHelper.searchAndHighlight(mockData, "c++");
// 输出:精准命中 ID:2,高亮展示为 "精通 <mark class="highlight">C++</mark> / C# 异步编程"
// 测试用例 3:搜索含 HTML 标签的 "<script>"
const res3 = SearchHelper.searchAndHighlight(mockData, "<script>");
// 输出:精准命中 ID:3,且标签被转义为 <script> 并被高亮包裹,杜绝 XSS 执行风险五、生产环境高频踩坑点与排查
在交付搜索模块前,以下 3 个隐蔽问题务必逐一排查:
1. 全局修饰符 g 导致的交替匹配失败 Bug
很多开发者在声明正则表达式时习惯性加上 'g'(例如 new RegExp(keyword, 'gi'))。在 JavaScript 中,带有 'g' 标志的正则对象是一个有状态对象,其 lastIndex 属性会记录上一次匹配结束的索引位置。
如果连续对多条数据调用同一个正则实例的 test() 方法,lastIndex 会不断向后移动。当它超出目标字符串长度时,test() 会返回 false,随后 lastIndex 自动归零重置。这会导致完全相同的字符串在循环检测中出现一次 true、一次 false 的交替漏检现象。解决办法是:若仅检测匹配,不加 'g' 标志;或者每次执行 test() 之前显式将 regex.lastIndex = 0;。
2. 忽略高亮替换时的 XSS 漏洞
搜索高亮通常需要把包含 <mark> 标签的字符串渲染到页面中(例如 Vue 的 v-html 或 React 的 dangerouslySetInnerHTML)。如果直接将原文本或用户输入替换后注入 DOM,一旦数据源或搜索词中包含 <img src=x onerror=alert(1)>,就会直接触发 XSS 攻击。正确的操作规范是:先将原文本全部转换为纯文本实体编码,再对转义后的文本进行正则高亮标签替换。
3. 忽略空字符串匹配导致的性能卡顿
当用户在搜索框输入纯空格或删除完内容时,如果未提前拦截 query.trim() === '',直接将其作为检索词,正则可能产生空匹配;若使用 replaceAll 或循环匹配可能导致空字符串无限替换,引发浏览器主线程卡死。务必在流水线的第一步设置非空短路门禁。
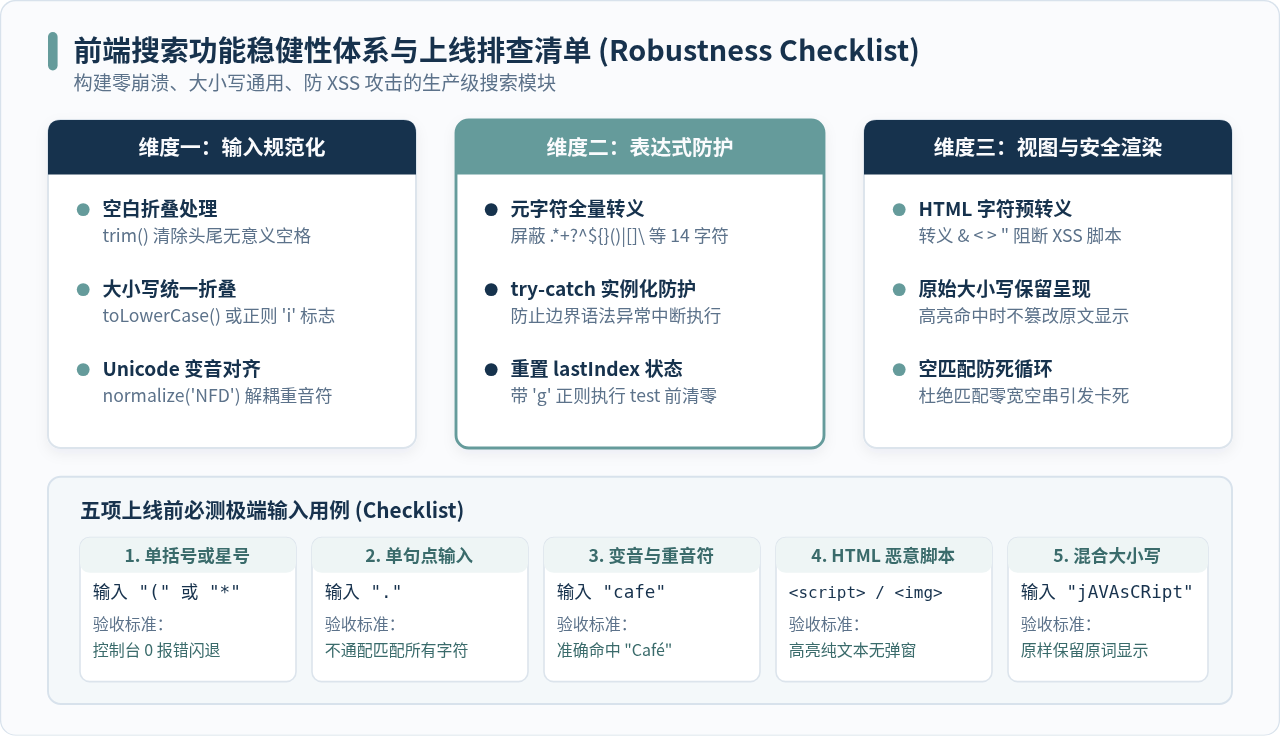
六、总结
在 JavaScript 中开发搜索功能,核心要点在于区分场景与守住边界:
- 对于简单的数据筛选,优先使用
toLowerCase()配对includes(),实现简单且天然免疫特殊字符异常; - 如果涉及富文本展示和关键词高亮,必须采用“
escapeRegExp转义特殊符号 +new RegExp(..., 'i')忽略大小写”的组合; - 对于包含变音符号的多语言搜索,引入
normalize('NFD')进行分解降噪; - 涉及 DOM 节点渲染时,时刻遵循“先做 HTML 实体转义,再做高亮标记”的安全准则。
按照上述处理管道,即可构建出一个既能够包容各类复杂特殊符号、又能流畅处理大小写差异的稳健前端搜索功能。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章