
深入剖析为什么在 JavaScript 中不建议使用 arr.sort(() => Math.random() - 0.5) 实现数组洗牌,详解排序比较器传递性破坏、概率分布严重偏斜的根本原因,并提供标准的 Fisher-Yates 算法实现与工程实践方案。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JS数组随机打乱:为什么不建议用sort实现洗牌
作者:木棉
时间:2026-11-19
浏览:349
文章目录
算法设计与前端实践
作者:技术专栏作者
分类:JavaScript / 算法
关键词:洗牌算法 / Array.sort / Fisher-Yates
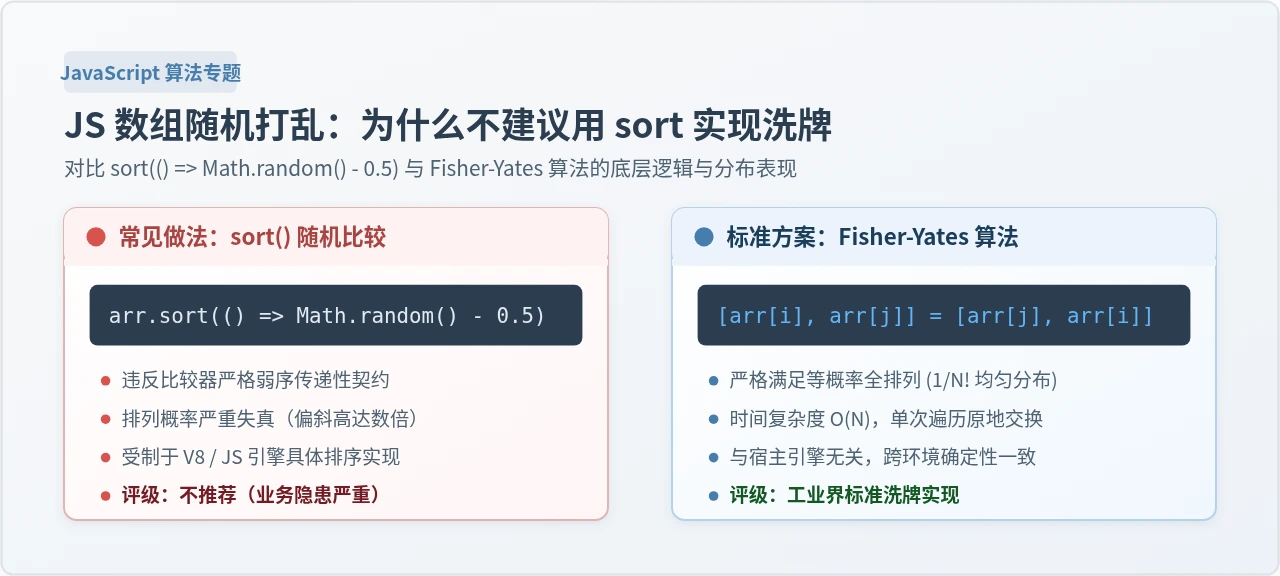
在日常 JavaScript 开发中,很多开发者习惯随手写出 arr.sort(() => Math.random() - 0.5) 来打乱一个数组。这段代码极其简短,表面上看也能让数组元素的位置发生变动。然而在严肃的工程与算法场景下,这种写法存在根本性的理论缺陷:它不仅公然违背了排序算法比较器的数学传递性契约,而且受现代 JavaScript 引擎内部排序机制的影响,生成的置换分布存在极大的概率偏斜,某些排列的出现频率甚至可能是另一些排列的数倍之多。真正严谨、均匀且时间复杂度为 O(N) 的解决方案是经典的 Fisher-Yates(Knuth)洗牌算法。本文将从底层数学逻辑、引擎实现机制及实际执行过程三个层面,剖析为何应当彻底摒弃 sort 洗牌,并给出可靠的标准实现。
一、常见的快捷写法及其直觉假象
希望将一个数组随机打乱时,初学者甚至部分有经验的前端开发者常常会使用如下代码:
// 表面看起来非常简洁的打乱方式
const numbers = [1, 2, 3, 4, 5, 6, 7, 8];
numbers.sort(() => Math.random() - 0.5);
这种写法的直觉逻辑很单纯:Math.random() 的返回值区间为 [0, 1),减去 0.5 之后,返回值就以相等的概率落在正数(> 0)或负数(< 0)区间。开发者往往推论:在排序过程中,任意两个元素比较时,有 50% 的几率保持相对顺序,50% 的几率调换相对顺序,多次交换后整个数组理应被充分且均匀地打乱。
然而,这种推论建立在一个完全错误的先决假设上:它把排序算法当成了随机两两交换机。实际上,排序算法的设计初衷从来不是进行无规则的乱序交换,而是假定所有元素之间存在客观、稳定且自洽的大小关系,并基于这一假设极力省略不必要的比较操作。
二、深入原理:为什么 sort 洗牌在数学与底层均不成立
1. 违反比较函数的严格弱序(Strict Weak Ordering)契约
ECMAScript 规范对 Array.prototype.sort(compareFn) 传入的比较函数提出了明确的数学契约要求,即比较逻辑必须满足严格弱序。具体而言,必须同时满足以下三个性质:
- 反自反性(Irreflexivity):
compareFn(a, a) === 0,即元素与自身比较必须相等。 - 反对称性(Antisymmetry):若
compareFn(a, b) > 0,则必须保证compareFn(b, a) < 0。 - 传递性(Transitivity):若
compareFn(a, b) > 0且compareFn(b, c) > 0,则必有compareFn(a, c) > 0。
当传入 () => Math.random() - 0.5 时,每一次调用比较函数都会重新生成独立的随机数。这就意味着,对于同一组元素,完全可能在上一毫秒判定 A > B,下一毫秒又判定 B > C,而紧接着比较时却得出 C > A。这种自相矛盾的回路破坏了数学自洽性,使得排序算法陷入逻辑闭环冲突。
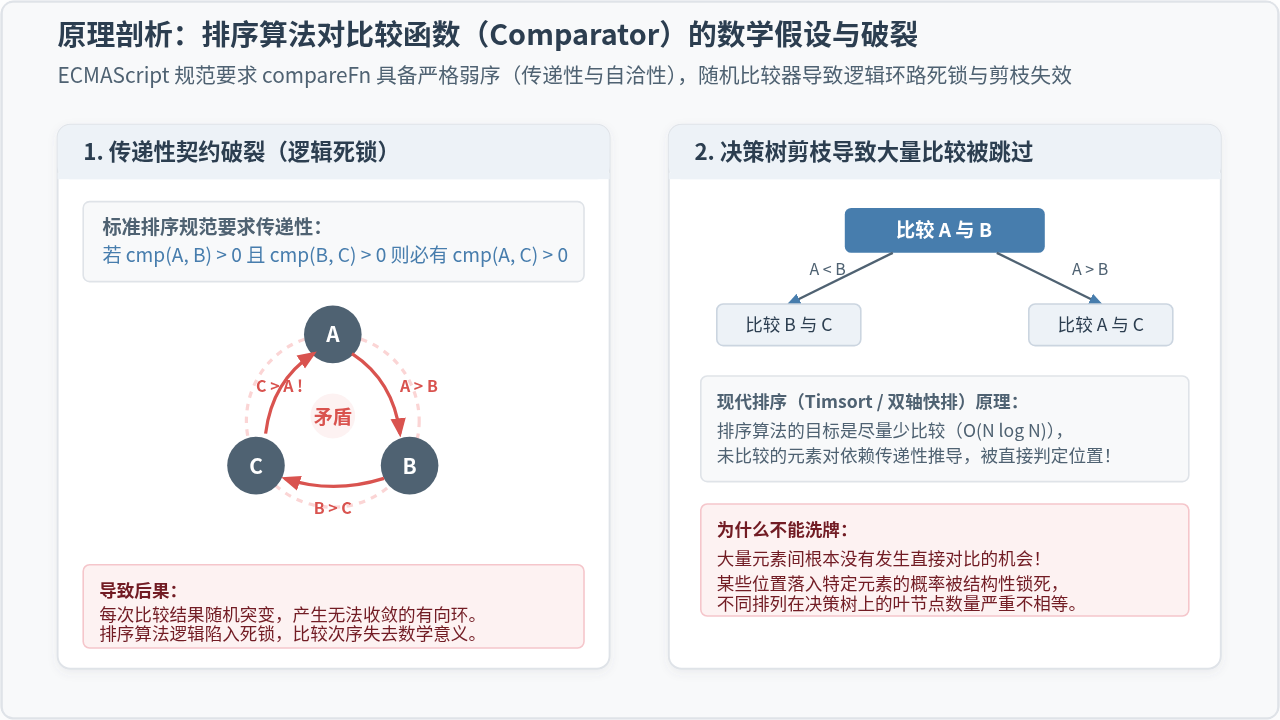
2. 排序算法的决策树剪枝导致大量元素根本未发生比较
无论是 V8 引擎采用的 Timsort 算法(一种结合了插入排序与归并排序的高效自适应排序算法),还是早期使用的双轴快速排序(Dual-Pivot QuickSort),其核心优化目标都是尽可能减少元素间的比较次数,将时间复杂度压缩在 O(N log N) 以内。
为此,算法高度依赖“传递性”进行状态剪枝。例如,当算法确定 A < B 且 B < C 时,它会直接确立 A < C 的相对位置,而绝不会再调取比较函数去对 A 和 C 进行多余的对比。然而在洗牌场景中,若要实现彻底的随机分布,数组中任意两个元素都应当具备均等的机会进行相互置换。由于大量比较路径在排序过程中被直接剪除,许多元素被过早地固化在局部有序块(Run)中,导致某些位置的排列组合永远无法被触达。
3. 二叉决策树叶子节点与排列数的不可整除性
从信息论与离散数学的角度来看,包含 N 个元素的数组共有 N!(N 的阶乘)种不同的排列可能。一个完全公平的洗牌算法,必须让每一种排列出现的概率严格等于 1 / N!。
任何基于比较的排序算法,其所有可能的比较路径都可以抽象为一棵二叉决策树(Binary Decision Tree)。经过 k 次比较后,决策树最终能够到达的叶子节点总数为 2^k 个。如果希望这 2^k 条分支能完全均等地分配给 N! 种排列,必须满足:
数学定理约束:
当数组长度 N > 2 时,N! 必然包含大于 2 的奇数质因子(例如 N=3 时 3!=6,含因子 3;N=4 时 4!=24,同样含因子 3)。根据算术基本定理,2^k 是纯粹的 2 的幂次,永远不可能被任何包含奇数质因子的 N! 整除!
这意味着,无论排序算法比较了多少次、树结构如何复杂,决策树的末端叶子节点都绝不可能均匀地平摊到所有的排列上。某些排列对应的叶节点必定更多,而另一些排列对应的叶节点必定较少,这在数学本质上注定了概率的系统性失真。
三、实测验证:排列概率分布的严重偏斜
为了让理论问题更加直观,我们以一个极度简化的 3 元素数组 ['A', 'B', 'C'] 为例进行实测。3 个元素的全排列共有 3! = 6 种可能:ABC, ACB, BAC, BCA, CAB, CBA。理论上,如果打乱算法是真正均匀的,每一种排列出现的概率应该极为接近 1/6 ≈ 16.67%。
我们在 Chrome V8 运行时环境下,分别执行 100,000 次 sort(() => Math.random() - 0.5) 与 100,000 次标准 Fisher-Yates 算法,统计 6 种排列出现的实际频率:
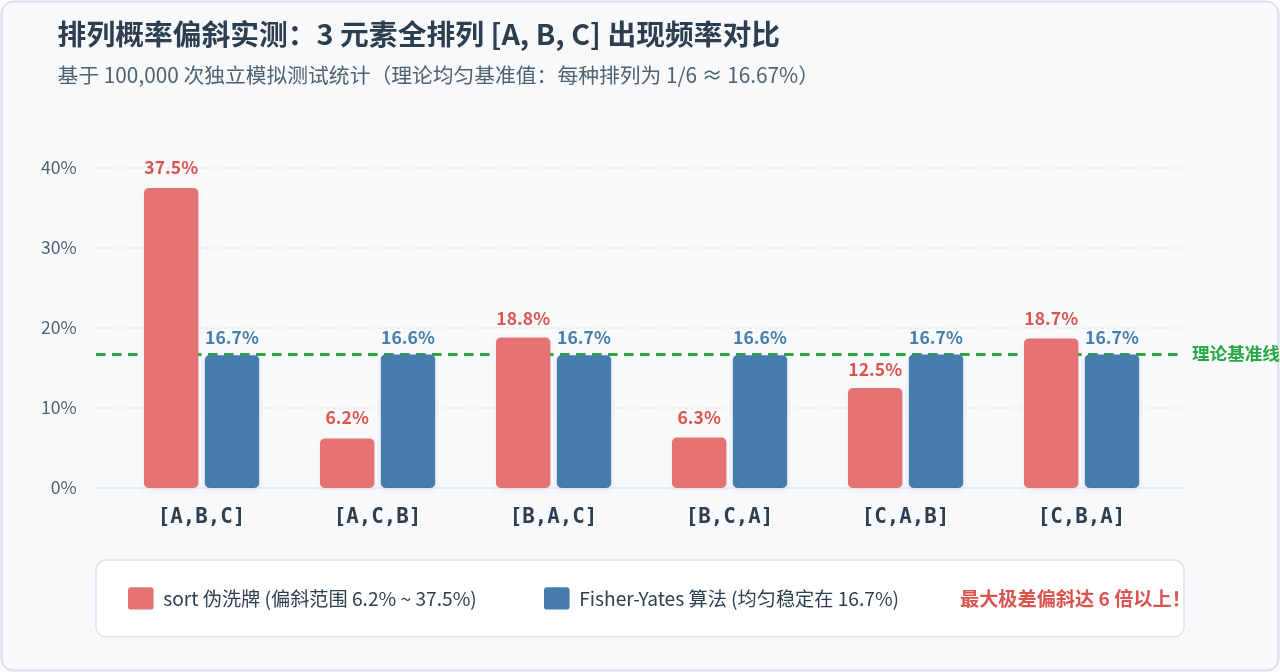
测试数据清晰地揭示了问题:
- 在 Fisher-Yates 算法 下,6 种排列的出现频率高度平稳,均收敛在
16.6% ~ 16.7%之间,最大极差微乎其微,符合真实随机分布规律。 - 在 sort 伪洗牌 下,初始排列
[A, B, C]的留存率高达 37.5%,而[A, C, B]和[B, C, A]的出现率却被腰斩至仅有 6.2% 左右!
警惕隐蔽缺陷:
高达 6 倍以上的概率差距,如果在抽奖发牌、问卷题目乱序、AB 测试随机分流等业务中使用,将直接导致业务规则的严重不公,且这种偶发性偏斜在普通单元测试中极难被直接捕获。
四、标准解法:Fisher-Yates (Knuth) 洗牌算法
解决数组洗牌问题的正统方案是 Fisher-Yates 洗牌算法(由 Ronald Fisher 与 Frank Yates 提出,后经 Donald Knuth 推广为现代计算机算法版本)。
1. 算法核心思路
Fisher-Yates 算法的逻辑非常直观且自洽:
- 将指针
i从数组的最后一个元素(索引n - 1)向前遍历至第 2 个元素(索引1)。 - 在每一轮迭代中,从未处理的前缀子数组(索引区间
[0, i])中,以等概率随机挑选一个索引j。 - 将
arr[i]与arr[j]进行数值互换。 - 互换后,索引
i位置的元素正式锁定,后续循环不再对其进行移动;指针i前移,进入下一个更短的前缀子区间重复上述过程。
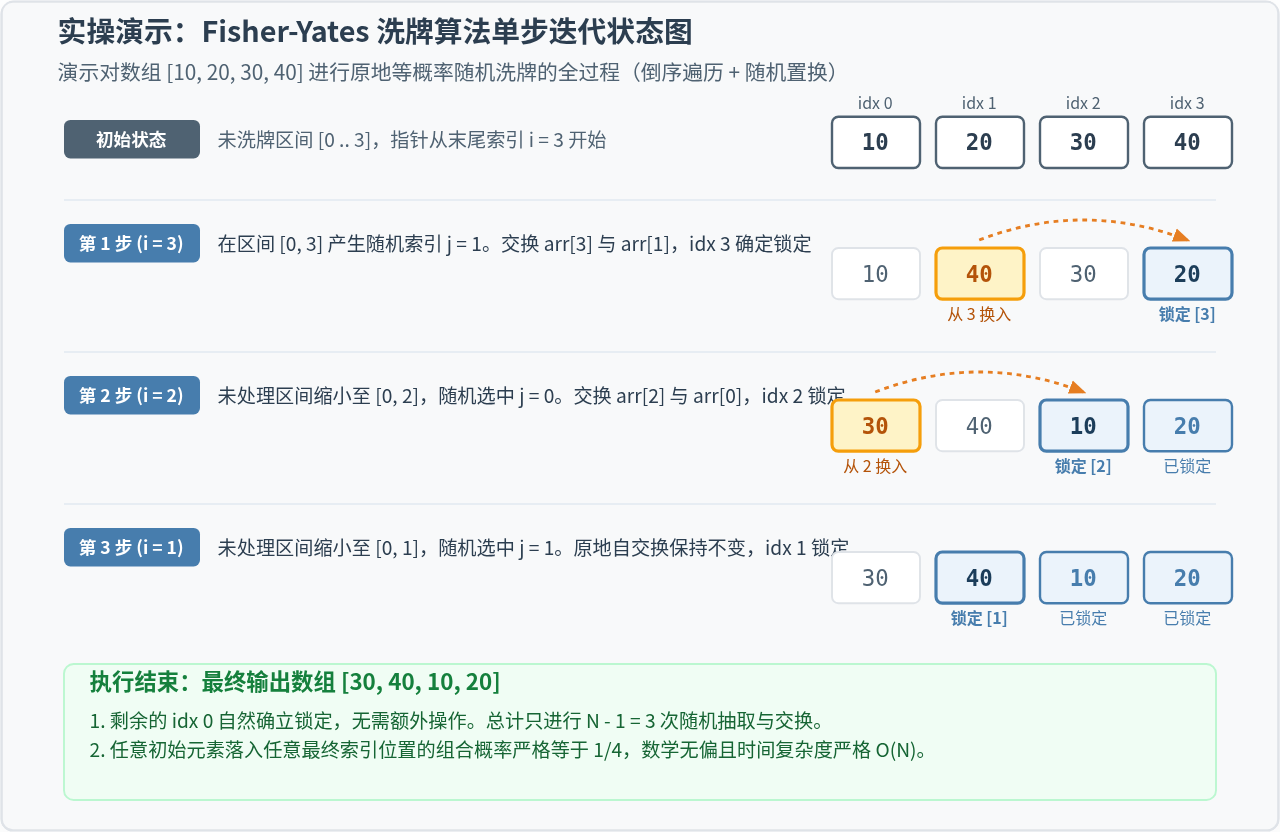
2. 数学等概率证明
对于长度为 N 的数组,任意一个元素落入最终某个指定位置(例如末尾索引 N-1)的概率是:在第 1 步从 N 个元素中选中它的几率,严格为 1 / N。
而对于倒数第二个位置(索引 N-2),该元素在第 1 步未被选中的概率为 (N-1) / N,而在第 2 步从剩余的 N-1 个元素中被选中的概率为 1 / (N-1)。二者相乘:
P = ((N - 1) / N) × (1 / (N - 1)) = 1 / N
以此类推,通过数学归纳法可知,任何元素落入数组任何位置的概率均严格等于 1 / N。该算法只经历一次线性遍历,总计交换 N - 1 次,时间复杂度恒定为 O(N),空间复杂度为 O(1)。
3. 生产环境可用的标准 JavaScript 实现
在日常业务开发中,我们通常需要考虑“原地修改”与“不可变纯函数”两种形态。以下提供经过严格检验的代码范式:
方案 A:原地洗牌(In-place Shuffle)
适用于大型数组或对内存敏感、允许直接改变原数组的场景:
/**
 * Fisher-Yates 原地洗牌算法
 * @param {Array} arr - 待打乱的原始数组
 * @returns {Array} 返回被打乱的原数组引用
 */
function shuffleInPlace(arr) {
  if (!Array.isArray(arr) || arr.length <= 1) {
    return arr;
  }

  // 倒序遍历数组
  for (let i = arr.length - 1; i > 0; i--) {
    // 在 [0, i] 区间内随机选取一个整数索引
    const j = Math.floor(Math.random() * (i + 1));

    // ES6 解构赋值原地交换
    [arr[i], arr[j]] = [arr[j], arr[i]];
  }

  return arr;
}

// 使用示例
const cards = ['A', '2', '3', '4', '5', '6', '7', '8', '9', '10', 'J', 'Q', 'K'];
shuffleInPlace(cards);
console.log(cards);
方案 B:不可变纯函数(Immutable Shuffle)
在 React、Redux、Vue 3 等现代前端框架中,保持状态的不可变性(Immutability)是避免视图渲染异常的重要规范:
/**
 * 不可变洗牌纯函数(不修改原始输入数组)
 * @template T
 * @param {T[]} arr - 待打乱的目标数组
 * @returns {T[]} 返回打乱后的全新数组实例
 */
function shuffleImmutable(arr) {
  if (!Array.isArray(arr)) return [];
  // 浅拷贝原数组副本
  const result = [...arr];

  for (let i = result.length - 1; i > 0; i--) {
    const j = Math.floor(Math.random() * (i + 1));
    [result[i], result[j]] = [result[j], result[i]];
  }

  return result;
}

// 在 React 组件状态更新中的典型应用
// setQuestionList(prevList => shuffleImmutable(prevList));
五、方案横向对比与技术选型
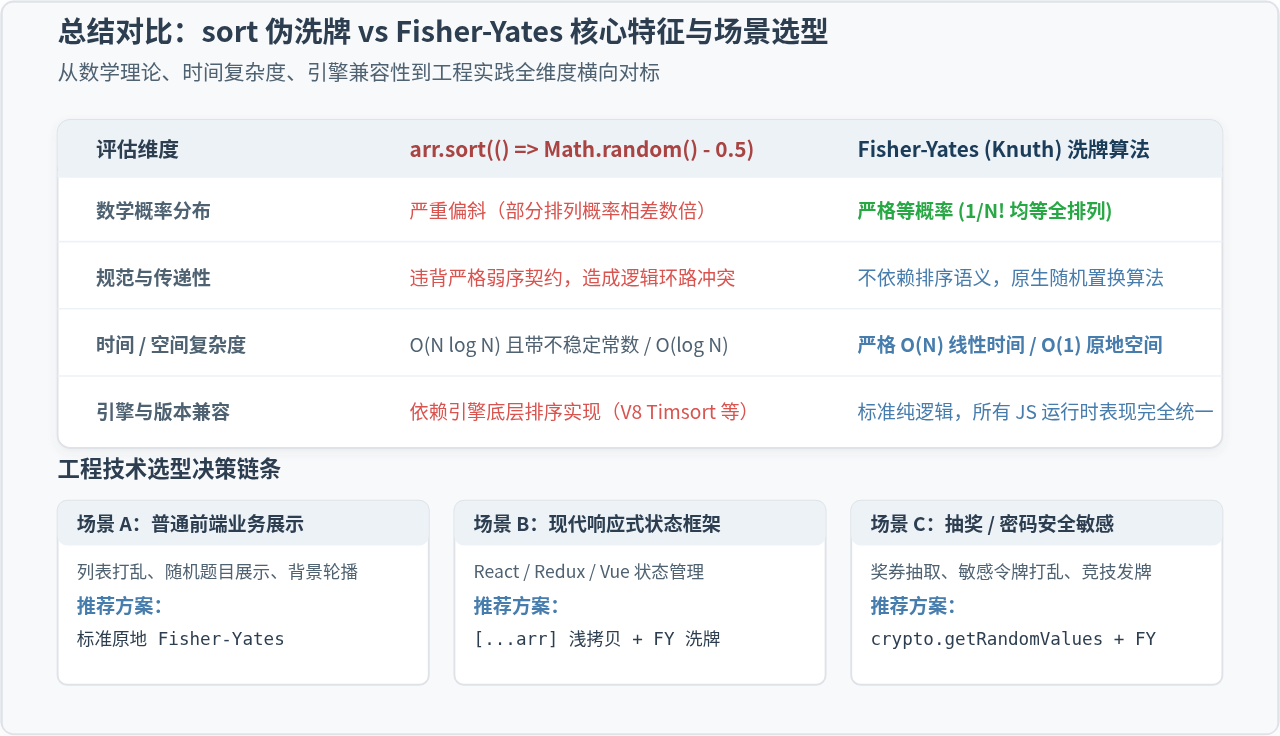
为了全面评估两套洗牌思路的差异,我们将关键特征梳理如下表:
| 对比指标 | arr.sort(() => Math.random() - 0.5) | Fisher-Yates (Knuth) 洗牌算法 |
|---|---|---|
| 概率数学分布 | 严重不均,某些排列极值偏离可达 5~6 倍以上 | 严格数学均匀,全排列等概率 1/N! |
| 时间复杂度 | O(N log N),比较器不稳定时性能降级 | 严格 O(N),单次线性正向/反向扫描 |
| 空间复杂度 | O(log N) 依赖引擎调用栈开销 | O(1) 原地指针交换 |
| 规范合规性 | 违背 ECMAScript 比较函数严格弱序规范 | 原生算法逻辑,与排序规范无绑定 |
| 跨引擎一致性 | 高度依赖特定浏览器内核排序算法版本 | 全平台全引擎表现 100% 统一稳定 |
六、常见工程问题与注意事项
1. 为什么手写洗牌时绝对不能写成 Math.random() * i?
在编写 Fisher-Yates 算法时,最容易出现的边界失误就是写漏了加一操作:
// 错误写法示范:
const j = Math.floor(Math.random() * i); // 永远抽不到索引 i 本身!

// 正确写法:
const j = Math.floor(Math.random() * (i + 1));
如果写成 Math.floor(Math.random() * i),生成的随机整数 j 只能落在 [0, i - 1] 区间内。这意味着当前元素永远不可能留在原位。在严谨的概率学中,任何元素都应当有固定几率保留在当前位置,剥夺这一可能性同样会导致某些排列组合无法产生,从而引入新的偏斜。
2. Math.random() 在高安全需求场景下的局限
Math.random() 本身属于伪随机数生成器(PRNG,大多数浏览器使用 xorshift128+ 算法)。对于普通的界面展示、题库随机乱序等场景,它已足够胜任;但在涉及真实资金抽奖、安全凭证打乱、竞技扑克发牌等对随机性质量要求极高的场景中,伪随机数可能存在可预测性安全隐患。
针对此类高安全场景,推荐接入现代浏览器提供的 Web Crypto API:
/**
 * 基于密码学安全随机源的 Fisher-Yates 洗牌算法
 * 适用于金融抽奖、竞技博弈等安全敏感场景
 */
function cryptographicallySecureShuffle(arr) {
  const result = [...arr];
  const randomBuffer = new Uint32Array(1);

  for (let i = result.length - 1; i > 0; i--) {
    // 使用 Web Crypto API 生成密码学强随机数
    window.crypto.getRandomValues(randomBuffer);
    // 映射到 [0, i] 区间
    const j = randomBuffer[0] % (i + 1);
    [result[i], result[j]] = [result[j], result[i]];
  }

  return result;
}
总结
技术开发中常常存在“看起来能用”与“真正正确”的差异。arr.sort(() => Math.random() - 0.5) 凭借短短一行代码的便利性,在网络教程与初级代码中流传甚广,但其背后隐藏的传递性破裂、决策树剪枝偏差以及高达数倍的排列不均,使其成为不合格的工程实践。在需要对数组进行打乱时,应当始终选择具有严格数学证明的 Fisher-Yates 算法,用清晰、高效且无偏的 O(N) 代码保障业务系统的公平与稳定。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章