
深入解析基于 filter 与 indexOf 组合的 JavaScript 数组去重方案。讲解首现索引对比核心原理、执行流水线、IE8至IE11兼容适配策略及特殊边界(NaN与引用对象)处理技巧。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
兼容IE的JS数组去重写法:filter与indexOf组合
作者:半夏
时间:2026-11-19
浏览:513
文章目录
在需要兼顾旧版 Internet Explorer 浏览器(或各类采用 Trident 内核的内网客户端、工控宿主应用)的项目中,现代 ES6 提供的
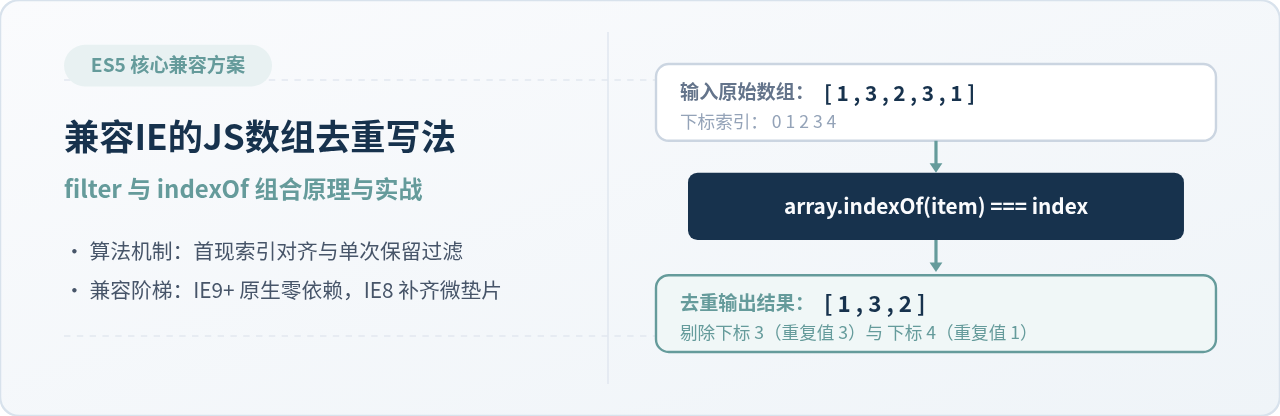
new Set() 往往无法直接运行或需要沉重的编译转译包。利用 ECMAScript 5 规范中的 Array.prototype.filter 与 Array.prototype.indexOf 组合,是原生支持度最高、代码极轻量且无须额外辅助库的经典数组去重方案。本文将详细拆解该方案的底层判别机制、执行时序流水线、IE8至IE11的实际兼容表现以及特殊边界值的避坑方法。
一、核心写法与快速上手
我们首先来看这一组合的标准实现代码。整个去重逻辑可以直接浓缩为一个简洁的通用纯函数:
// 兼容 IE9+ 原生环境的基础去重函数
function unique(arr) {
  if (!arr || !arr.length) {
    return [];
  }
  return arr.filter(function (item, index, self) {
    return self.indexOf(item) === index;
  });
}

// 示例调用验证
var sampleArray = [1, 2, 2, 3, 1, 'a', 'b', 'a'];
var result = unique(sampleArray);
// 示例输出结果:[1, 2, 3, 'a', 'b']
这段代码的核心灵魂只有一句话:self.indexOf(item) === index。为了理解它为什么能精准去重,我们需要搞清楚 filter 回调提供的参数以及 indexOf 的查找特质:
item:当前正在被filter遍历到的数组元素值。index:当前元素在原数组中所处的实际遍历下标索引(从 0 开始递增)。self:正在被遍历的原数组引用(即代码中的arr)。self.indexOf(item):从数组最左端(下标 0)开始线性向右查找,返回该元素在数组中第一次出现的绝对下标。
二、原理解析:首现索引与当前索引的比对机制
去重的本质是:对于每一个数值,我们只在它第一次亮相时允许其进入结果集合,随后的所有重复亮相都予以拒之门外。
Array.prototype.indexOf(item) 具有一个恒定不变的性质:无论我们在数组多靠后的位置调用它,它返回的永远是该项在原数组中最左侧那次出现的下标。因此:
- 当元素是首次出现时,它的当前遍历索引
index一定恰好等于它在数组中第一次被找到的索引indexOf(item),等式成立,返回true,filter将该元素保留。 - 当元素是后续重复出现时,
indexOf(item)找到的依然是前面那个已经出现过的最靠前的下标,而当前遍历的index已经往后走了,因此indexOf(item) < index,等式self.indexOf(item) === index判定为false,filter将其剔除。
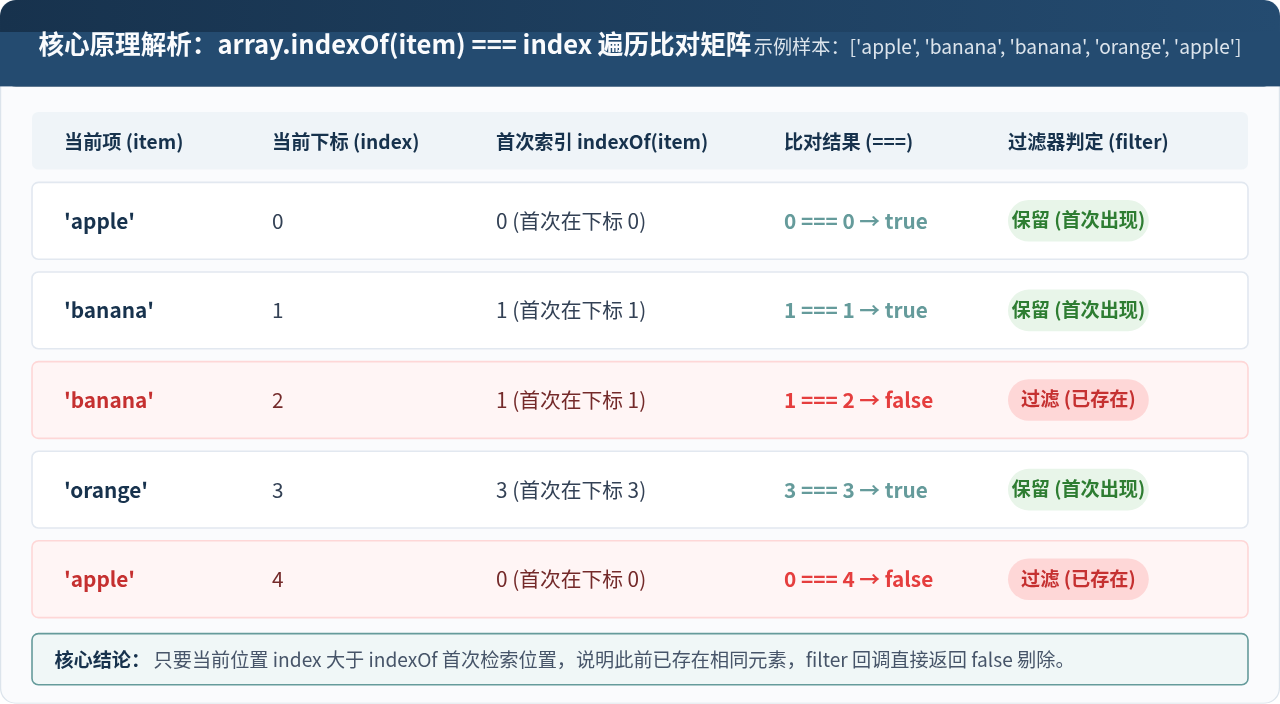
正如上图所示,当遍历到索引为 2 的第二个 'banana' 时,indexOf('banana') 计算出的仍然是其首次出现的下标 1。由于 1 === 2 计算为 false,第二个 'banana' 就会被过滤器直接丢弃,从而严密确保了输出结果的唯一性。
三、操作流水线:去重函数的执行步骤
在实际执行过程中,整个去重过程被组织为一个确定性的数据处理流水线。了解每一个执行阶段有助于我们在排查问题或进行工程防御时做到心中有数。
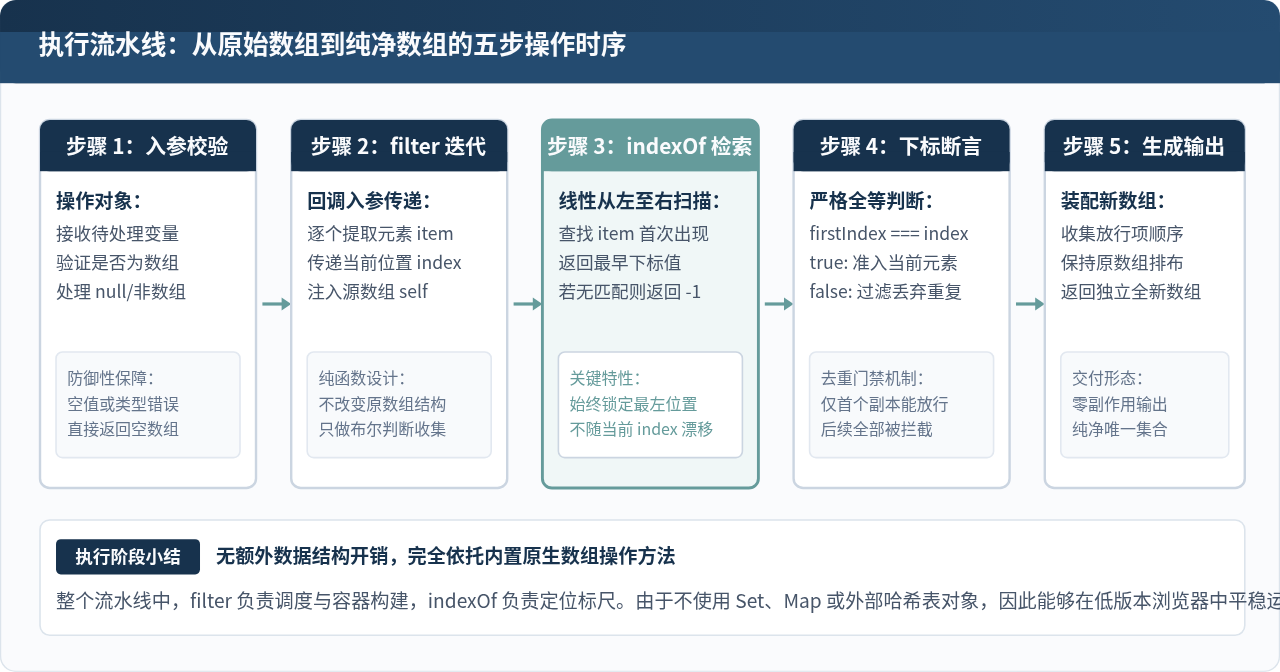
完整流水线分为以下五个标准化步骤:
- 步骤 1:入参校验与防御
接收待处理的原始变量。为了防止调用方传入null、undefined或非数组对象导致脚本直接抛出TypeError,首先进行类型与长度安全检查,异常时安全回退为空数组。 - 步骤 2:启动 filter 迭代上下文
调用数组内置的filter迭代器,为数组中的每个合法元素依次派发回调上下文,注入item、index与源数组self。 - 步骤 3:触发 indexOf 线性检索
回调函数内部将当前元素作为参数传给self.indexOf(item),底层引擎在原数组内自首至尾扫描并反馈最早的匹配索引。 - 步骤 4:严格布尔断言筛选
执行恒等比较firstIndex === index。只有首发元素才能产出true,重复副本均被阻断在收集器之外。 - 步骤 5:构建并返回全新数组
filter收集所有返回true的元素,装配为一个全新独立的数组对象返回,保证原输入数组内容不受任何篡改与污染。
四、深入底层:IE 浏览器的兼容层级与 IE8 垫片(Polyfill)
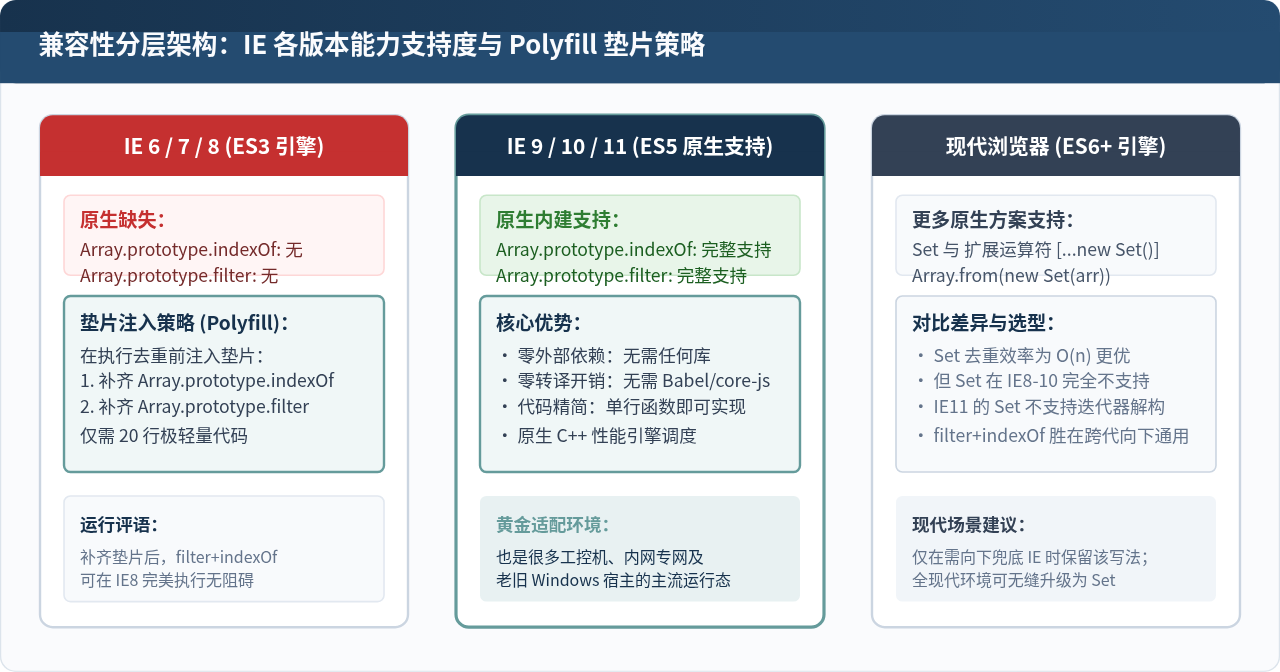
开发者在老旧系统开发中经常遇到一个误区:“只要是 filter + indexOf,就一定能在所有 IE 浏览器里直接跑通”。事实上,需要准确区分 IE 的版本代际:
1. IE9、IE10 与 IE11:原生黄金适配区
微软从 IE9 开始正式引入了对 ECMAScript 5 (ES5) 规范的核心支持。在 IE9、IE10 及 IE11 中,Array.prototype.indexOf 和 Array.prototype.filter 均作为原生内置函数提供。因此,上述基础写法在这三个版本中不需要加载任何 Polyfill,不需要 Babel 转译,开箱即用,执行速度依托原生 C++ 引擎,非常流畅稳定。
2. IE8 及更低版本(IE6/7/8):ES3 引擎与必须的 Polyfill 垫片
老旧的 IE8 及更早版本 仅支持 ES3 规范,其 Array.prototype 原型上既没有 indexOf 也没有 filter。如果在未加载垫片的情况下直接调用,会直接抛出 Object doesn't support property or method 'indexOf' 错误。
如果你的项目必须向下兼容至 IE8,只需在业务逻辑执行前补充以下两段标准且精简的原型垫片代码:
// 补齐 IE8 缺失的 Array.prototype.indexOf
if (!Array.prototype.indexOf) {
  Array.prototype.indexOf = function (searchElement, fromIndex) {
    var k;
    if (this == null) {
      throw new TypeError('"this" is null or not defined');
    }
    var o = Object(this);
    var len = o.length >>> 0;
    if (len === 0) {
      return -1;
    }
    var n = fromIndex | 0;
    if (n >= len) {
      return -1;
    }
    k = Math.max(n >= 0 ? n : len - Math.abs(n), 0);
    while (k < len) {
      if (k in o && o[k] === searchElement) {
        return k;
      }
      k++;
    }
    return -1;
  };
}

// 补齐 IE8 缺失的 Array.prototype.filter
if (!Array.prototype.filter) {
  Array.prototype.filter = function (fun/*, thisArg*/) {
    if (this == null) {
      throw new TypeError();
    }
    var t = Object(this);
    var len = t.length >>> 0;
    if (typeof fun !== "function") {
      throw new TypeError();
    }
    var res = [];
    var thisArg = arguments.length >= 2 ? arguments[1] : void 0;
    for (var i = 0; i < len; i++) {
      if (i in t) {
        var val = t[i];
        if (fun.call(thisArg, val, i, t)) {
          res.push(val);
        }
      }
    }
    return res;
  };
}
加入上述两段轻量级垫片后,即使在最严苛的 IE8 纯净虚拟机中,filter 与 indexOf 组合去重也能完全畅通无阻地运行。
五、边界陷阱排查与应对方案
虽然 filter + indexOf 写法在处理绝大多数常规业务数据(字符串、数值、布尔值等)时非常完美,但在遇到特殊 JavaScript 数据类型时存在几个隐蔽的边界陷阱,需要开发者充分掌握。
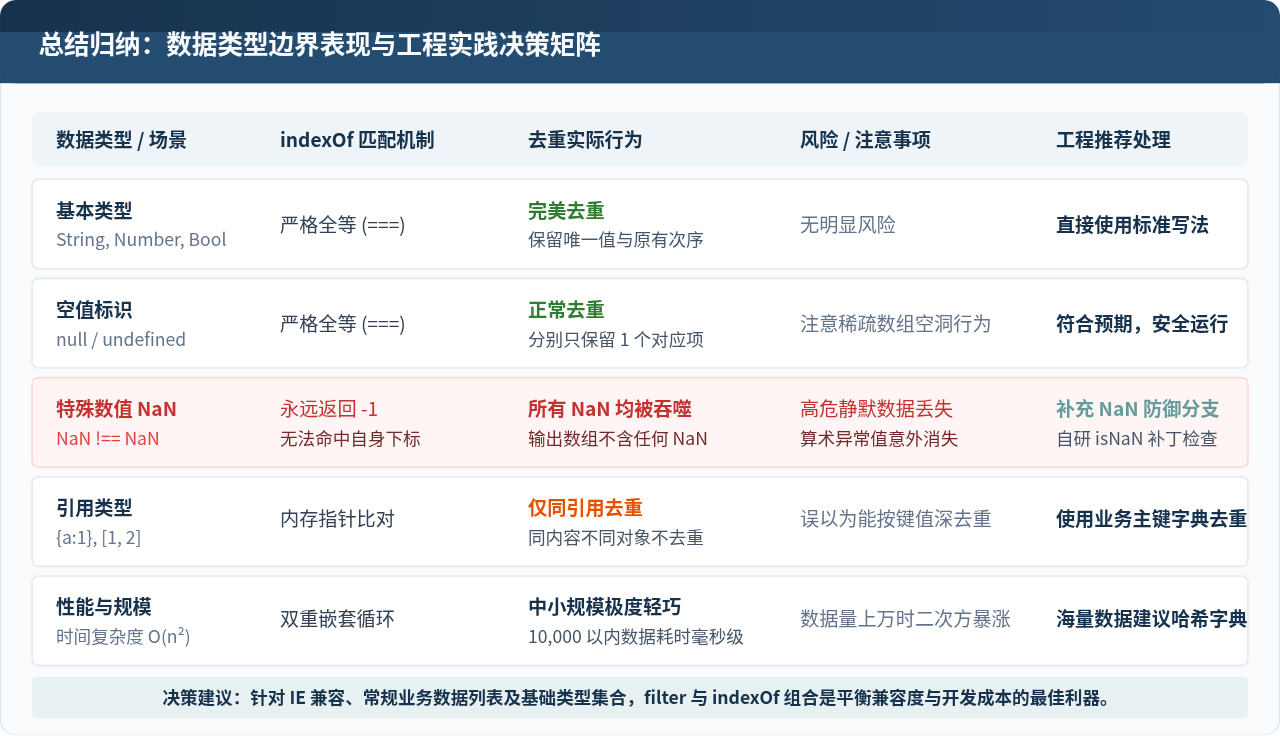
1. 特殊数值 NaN 的“被吞噬”陷阱
高危注意:NaN !== NaN 导致的所有 NaN 元素丢失
在 JavaScript 规范中,NaN 是唯一一个与自身都不严格全等的特殊数值:NaN === NaN 结果为 false。
因此,[NaN].indexOf(NaN) 在线性匹配时无法命中自身,执行结果固定返回 -1。这样在 filter 回调中,-1 === index 永远不成立!
表现后果:原始数组中的所有 NaN 项在去重后会被全部静默剔除,连一个副本都不会保留。如果业务数据流中可能产生算术异常值(如 0/0),需格外警惕。
2. 引用类型对象(Object / Array)的比对限制
indexOf 内部采用严格全等比较(===)。对于引用类型(如 { id: 1 }),比较的是它们在内存中的地址指针,而非键值内容:
// 两个独立字面量对象内存地址不同
var list = [{ id: 1 }, { id: 1 }];
var uniqueList = unique(list);
// uniqueList 长度依然为 2,无法按业务字段去重!
如果要对对象数组去重,建议根据业务主键(例如 item.id)借助辅助标记对象进行提取,而不是直接依赖基础 indexOf。
3. 时间复杂度与数据规模权衡
filter 自身是一个循环遍历,耗时为 $O(n)$;而在每次回调中调用的 indexOf 又是从前向后扫描的线性检索,平均耗时为 $O(n)$。两者嵌套导致整体算法的时间复杂度达到 $O(n^2)$。
- 在一般业务场景(数组长度在 5,000 以内)下,现代机器与甚至 IE 引擎的执行耗时通常仅需几毫秒至十几毫秒,代码简洁度收益远大于微秒级开销。
- 若需要处理超大规模数据(例如十万级以上的数据表格),$O(n^2)$ 可能会导致页面脚本执行超时警告,此时应优先考虑基于键值哈希的算法方案。
六、生产环境高健壮性通用封装与测试验证
综合考虑类型保护、IE 兼容以及对 NaN 的容错防御,我们可以封装一个工业级的健壮去重函数:
/**
 * 健壮的数组去重工具函数(兼容 IE9+ 原生,IE8 引入垫片后支持)
 * @param {Array} arr - 待去重的目标数组
 * @returns {Array} - 去重后的全新数组
 */
function robustUnique(arr) {
  // 1. 防御非数组或空值
  if (!arr || Object.prototype.toString.call(arr) !== '[object Array]') {
    return [];
  }

  var hasNaN = false;

  return arr.filter(function (item, index, self) {
    // 2. 针对 NaN 的防御性分支(NaN 与自身不相等)
    if (typeof item === 'number' && isNaN(item)) {
      if (!hasNaN) {
        hasNaN = true;
        return true; // 仅保留第一个出现的 NaN
      }
      return false;   // 过滤后续重复的 NaN
    }

    // 3. 常规类型的核心首现索引断言
    return self.indexOf(item) === index;
  });
}

// ========================
// 完整示例执行与结果验证
// ========================
var testData = [
  'apple', 'orange', 'apple',
  10, 20, 10, 30,
  true, false, true,
  null, undefined, null,
  NaN, 42, NaN
];

var cleanResult = robustUnique(testData);

// 示例输出结果验证(保留原始顺序,精确去重且安全保留单个 NaN):
// [
//   "apple", "orange",
//   10, 20, 30,
//   true, false,
//   null, undefined,
//   NaN, 42
// ]
通过这一结构严谨的实现,代码不仅保留了 filter 与 indexOf 无须额外臃肿依赖的极简优势,同时彻底化解了特殊值被吞噬的问题,是面向各类需要长期兼容 IE 运行环境的前端工程的理想基石。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章