
系统梳理JavaScript中遍历字符串的5种常用方法:传统for循环、for...of迭代器、扩展运算符/Array.from、split('')以及for...in。深度解析UTF-16码元与Unicode码点差异,分析Emoji截断乱码原因,提供清晰的性能与选型指南。

当前位置:首页 > JavaScript 基础 > 正文
JS遍历字符串的5种常用方法:从for循环到for...of
作者:半夏
时间:2026-11-16
浏览:467
文章目录
JavaScript 实战
技术领域:前端 / 核心规范
阅读时长:约 8 分钟
标准版本:ES5 / ES6+
在 JavaScript 中,字符串本质上是由 16 位 UTF-16 码元组成的不可变字符序列。遍历字符串主要有两类底层逻辑:一类是传统的“按物理下标与码元索引”推进,另一类是 ES6 引入的“按可迭代协议与 Unicode 码点”解析。本文将系统拆解 5 种最主流的遍历方式:经典
for 循环、for...of 循环、展开运算符 [...str] / Array.from()、split('') 拆分法以及 for...in 属性枚举。通过原理比对、Emoji 乱码陷阱剖析和场景矩阵,帮助你在开发中做出清晰且健壮的技术选型。
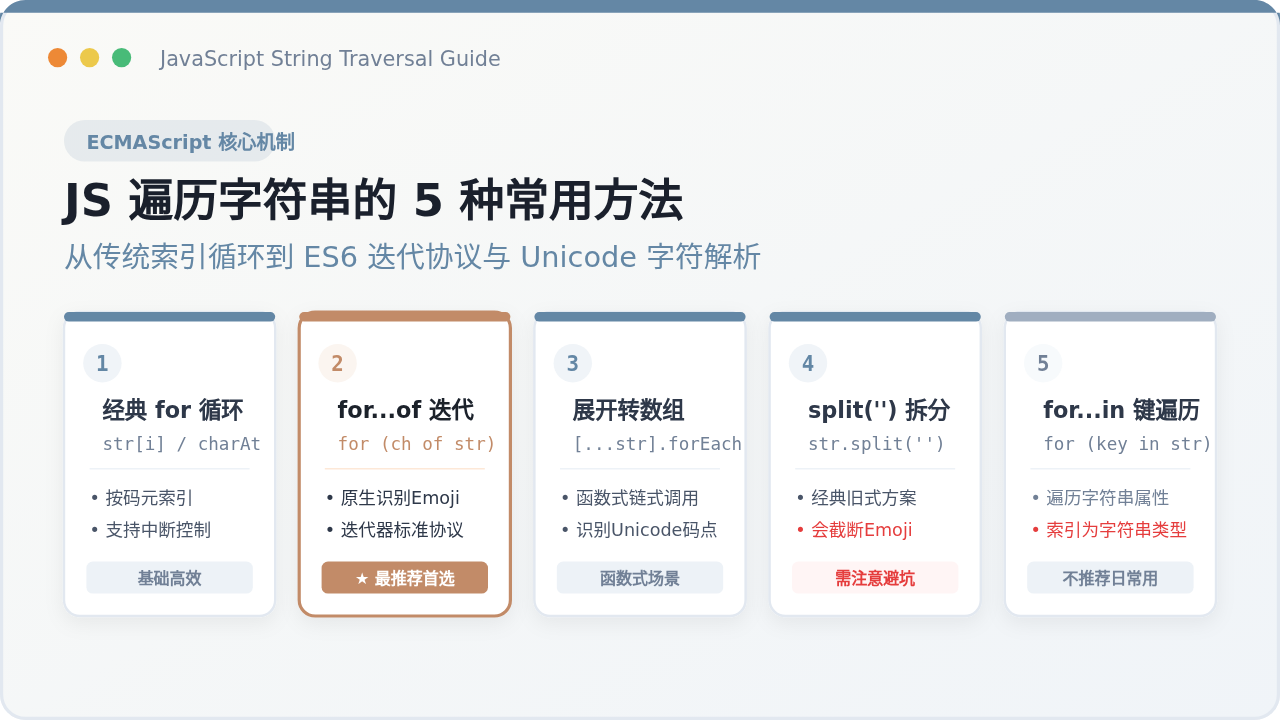
一、5 种常用遍历方法逐一详解与代码实战
在实际业务中,遍历字符串的需求五花八门:有时需要按序检索并提前中断,有时需要过滤重组,有时则需要精确获取每个字符的下标。针对不同需求,JavaScript 提供了语法风格和运行机制各异的方案。
1. 经典普通 for 循环(基于索引与下标访问)
普通 for 循环是 JavaScript 最基础的循环结构。它通过维护一个整型游标 i,利用 str.length 确定边界,并在循环体内通过 str[i] 或 str.charAt(i) 逐个读取字符。
// 示例 1:传统 for 循环遍历字符串
const text = "Frontend";

for (let i = 0; i < text.length; i++) {
  const char = text[i]; // 或 text.charAt(i)
  console.log(`索引 ${i}: ${char}`);
}
示例输出 (Console Output)
索引 0: F
索引 1: r
索引 2: o
索引 3: n
索引 4: t
索引 5: e
索引 6: n
索引 7: d
索引 1: r
索引 2: o
索引 3: n
索引 4: t
索引 5: e
索引 6: n
索引 7: d
核心优势与限制:普通 for 循环的最大优势在于完全可控与极高执行性能。开发者随时可以通过 break、continue 或 return 跳出循环,也可以任意调整游标步长(例如每次加 2 反向遍历)。并且它不需要创建任何中间对象,内存消耗为 O(1)。然而,它的致命弱点在于只按 UTF-16 单码元读取,在遇到占用 4 字节的 Emoji 或生僻汉字时会产生截断(后文将深入剖析)。
2. for...of 循环(现代 ES6 首选迭代方式)
ECMAScript 2015 (ES6) 为字符串原生实现了可迭代协议(Iterable Protocol),其底层挂载了 String.prototype[Symbol.iterator]。for...of 循环专门用于消费可迭代对象,是现代 JavaScript 遍历字符串的首选官方标准语法。
// 示例 2:使用 for...of 遍历含普通字符与 Emoji 的字符串
const message = "Hi!🚀";

for (const char of message) {
  console.log(`字符: ${char}`);
}
示例输出 (Console Output)
字符: H
字符: i
字符: !
字符: 🚀
字符: i
字符: !
字符: 🚀
为什么是现代首选:代码简洁且语义清晰,不需要手动维护计数器。更为重要的是,for...of 内部的迭代器是按 Unicode 码点(Code Point)而不是按 16 位码元推进的,因此遇到 4 字节的火箭图标 🚀 时,它会自动感知并合成完整字符输出,绝不产生半字乱码。同时,它同样原生支持 break 和 continue 控制流。
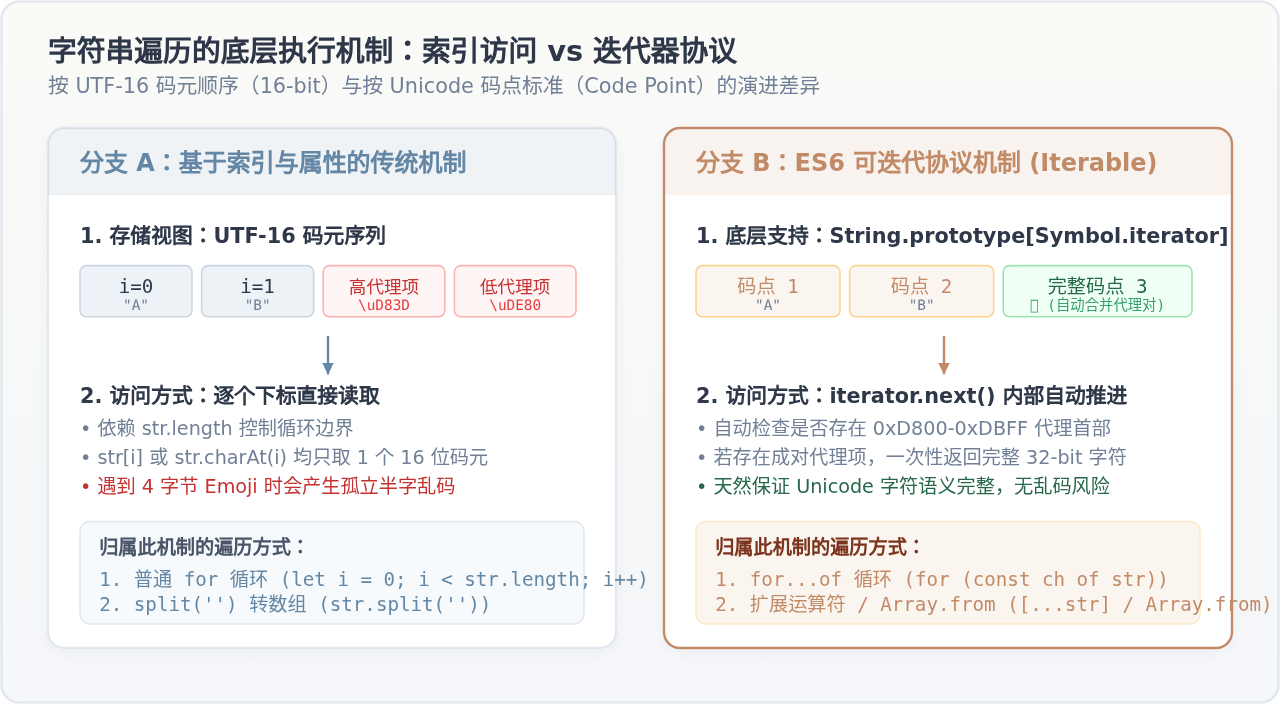
3. 展开运算符 [...] 或 Array.from() 结合数组方法
如果开发场景偏向函数式编程,或者需要结合 forEach()、map()、filter() 链式处理字符,可以借助扩展运算符(Spread Operator)或 Array.from() 将字符串快速转为真正的字符数组。
// 示例 3:通过展开语法转化为数组后遍历
const word = "Code🔥";

// 方式 A:扩展运算符
[...word].forEach((char, index) => {
  console.log(`位置 ${index} -> ${char}`);
});

// 方式 B:Array.from 自带映射回调
Array.from(word, (char, index) => {
  // 适合边遍历边转换
  return char.toUpperCase();
});
示例输出 (Console Output)
位置 0 -> C
位置 1 -> o
位置 2 -> d
位置 3 -> e
位置 4 -> 🔥
位置 1 -> o
位置 2 -> d
位置 3 -> e
位置 4 -> 🔥
机制解释:展开运算符和 Array.from() 的内部机制与 for...of 一致,都是调用 Symbol.iterator 协议完成元素采集。因此,它们同样能够完美处理包含 Emoji 的多字节字符。但需要警惕的是,这种方式会预先分配一个长度为 N 的新数组,在处理超大文本时会造成不必要的内存开销,且 forEach 内部无法直接使用 break 提前跳出。
4. split('') 拆分法转数组(经典旧式方案及隐患)
在 ES6 普及之前,前端开发者广泛使用 str.split('') 传入空字符串作为分隔符,将字符串切碎为数组,随后调用 forEach 遍历。
// 示例 4:split('') 遍历
const greeting = "Hello";

greeting.split('').forEach((char, idx) => {
  console.log(`Index ${idx}: ${char}`);
});
示例输出 (Console Output)
Index 0: H
Index 1: e
Index 2: l
Index 3: l
Index 4: o
Index 1: e
Index 2: l
Index 3: l
Index 4: o
注意避坑:
split('') 是依照 UTF-16 码元进行物理切分的。如果字符串中存在表情符号或生僻字,例如 "🚀".split(''),结果并不是 ["🚀"],而是长度为 2 的乱码数组 ["\uD83D", "\uDE80"]。在现代 JavaScript 项目中,除非明确只处理 ASCII 纯英文,否则强烈建议使用 [...str] 替代 str.split('')。
5. for...in 循环(属性键遍历及陷阱解析)
在 JavaScript 中,字符串字面量在访问属性时会被隐式包装为 String 包装对象,其字符索引会被视为主键属性。因此,for...in 语法也可以“跑通”字符串遍历。
// 示例 5:for...in 遍历字符串属性键
const lang = "JS";

for (const key in lang) {
  console.log(`key 类型: ${typeof key}, key 值: ${key}, 字符: ${lang[key]}`);
}
示例输出 (Console Output)
key 类型: string, key 值: 0, 字符: J
key 类型: string, key 值: 1, 字符: S
key 类型: string, key 值: 1, 字符: S
为什么日常开发绝不推荐 for...in:
- 索引类型为字符串:输出的
key是"0"、"1"等字符串类型而非数字,如果不小心进行key + 1计算,会变成"01"发生隐式字符串拼接。 - 原型链污染风险:
for...in会枚举对象及其原型链上所有可枚举的自定义属性。如果第三方库在String.prototype上扩展了方法,该方法名也会被错误地作为循环项枚举出来。 - 遍历顺序无保证:虽然现代引擎对数字键有排序约定,但 ECMAScript 规范并未严格保证
for...in在不同环境下的枚举顺序。
二、深入底层:Unicode、UTF-16 编码与 Emoji 踩坑解析
为什么同为遍历,普通 for 和 split('') 会在 Emoji 上翻车,而 for...of 却安全可靠?核心原因在于 JavaScript 引擎底层的字符串编码规范。
JavaScript 诞生于 1995 年,最初采用了 16 位的 UCS-2 编码,后来演进为 UTF-16。在 UTF-16 中:
- 常用字符(基本多语言平面 BMP,码点范围
U+0000至U+FFFF)占用 1 个 16 位码元(Code Unit)。 - 辅助平面字符(如 Emoji 表情
🚀、罕见汉字“𠮷”等,码点超过U+FFFF)必须使用 2 个 16 位码元表示,这两个码元分别称为高位代理(High Surrogate)和低位代理(Low Surrogate)。
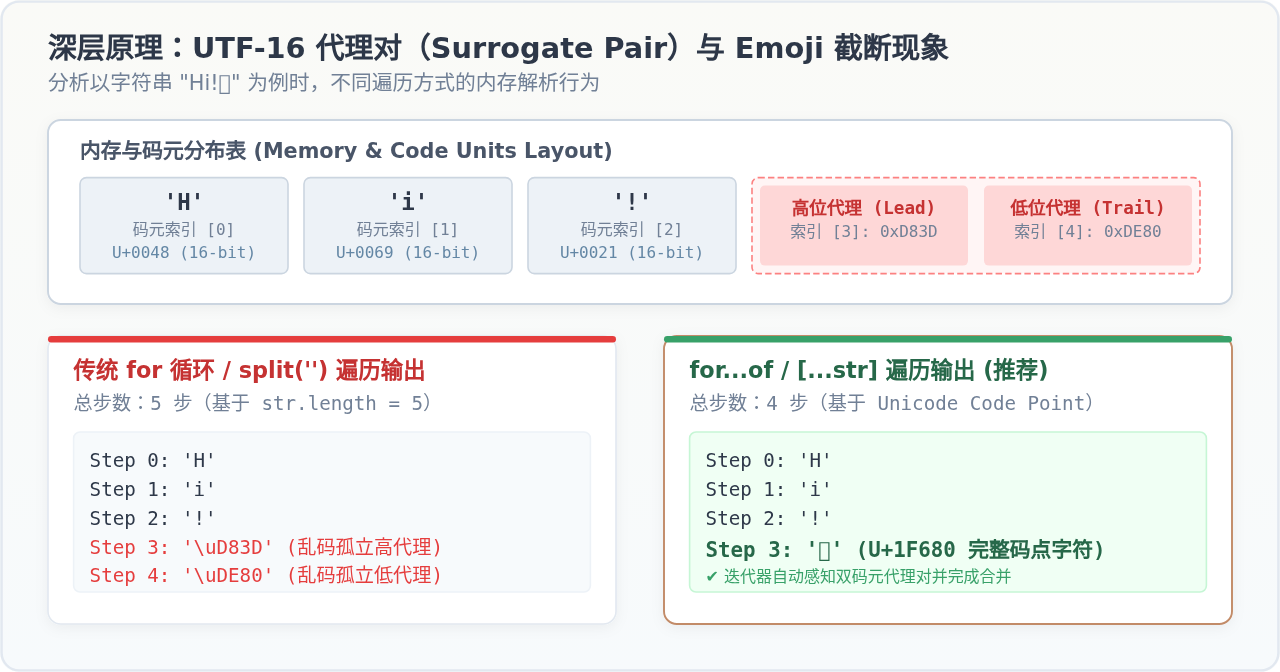
以火箭表情 🚀 为例,其 Unicode 码点为 U+1F680。在 UTF-16 内存中被编码为两个码元:0xD83D(高代理)和 0xDE80(低代理)。
当执行 "🚀".length 时,返回值是 2,因为 .length 统计的是码元个数而非人类肉眼看到的字符数。普通 for 循环按 length 遍历,分别取出这两个无意义的孤立代理项,在控制台就会呈现问号乱码 ;而 for...of 内部实现了 Unicode 规范的代理项合并逻辑,能够精准识别完整的字形单元。
三、实战操作与流程控制决策指南
在实际编写代码时,开发者应该依据具体约束条件进行选型。下面的决策流程图展示了在面对不同功能要求时的最佳路径:
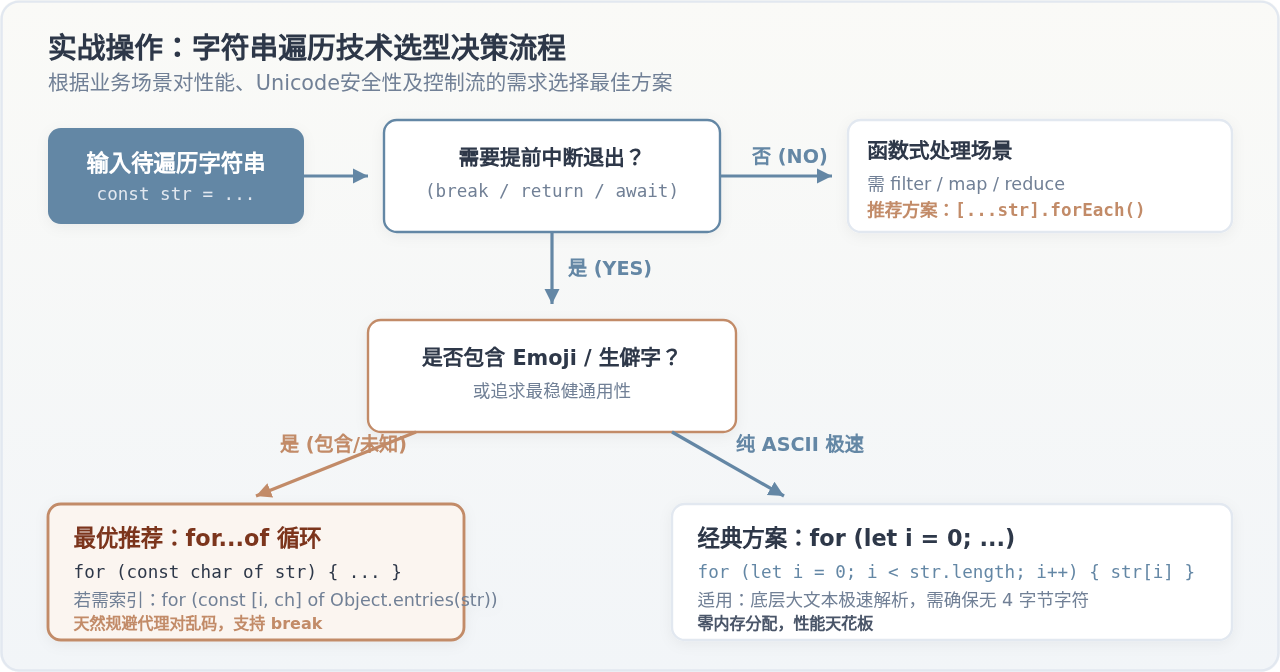
常见应用场景与写法建议:
-
需要提前中断(Early Exit):
若检索到目标字符即刻终止,必须选择常规控制流。优先采用
for...of,若需索引可结合entries():// 包含索引且支持 break 的最佳实践 const str = "Hello🚀World"; for (const [index, char] of Object.entries([...str])) { if (char === '🚀') { console.log(`在位置 ${index} 找到目标,终止遍历`); break; } } -
函数式清洗与转换:
若对字符进行映射并重新拼接,推荐使用
[...str].map().join(''):// 将字符串中所有英文字母转为大写,同时保留多字节字符完整 const raw = "apple🍎pie🥧"; const processed = [...raw] .map(ch => (ch >= 'a' && ch <= 'z' ? ch.toUpperCase() : ch)) .join(''); console.log(processed); // 示例输出: "APPLE🍎PIE🥧" -
性能极致敏感的纯 ASCII 大文本解析:
例如在解析上兆字节的 JSON、CSV 或日志文件时,若已在输入层验证为纯 ASCII 字符集,经典普通
for循环具有无可匹敌的零分配与高内联性能。
四、5 种遍历方式核心特性全景对比
为了帮助大家在日常代码审查与技术架构设计中快速核对,下表及图示全方位对比了这 5 种方法在语法简洁性、中断支持、Unicode 安全性及额外资源开销方面的表现:
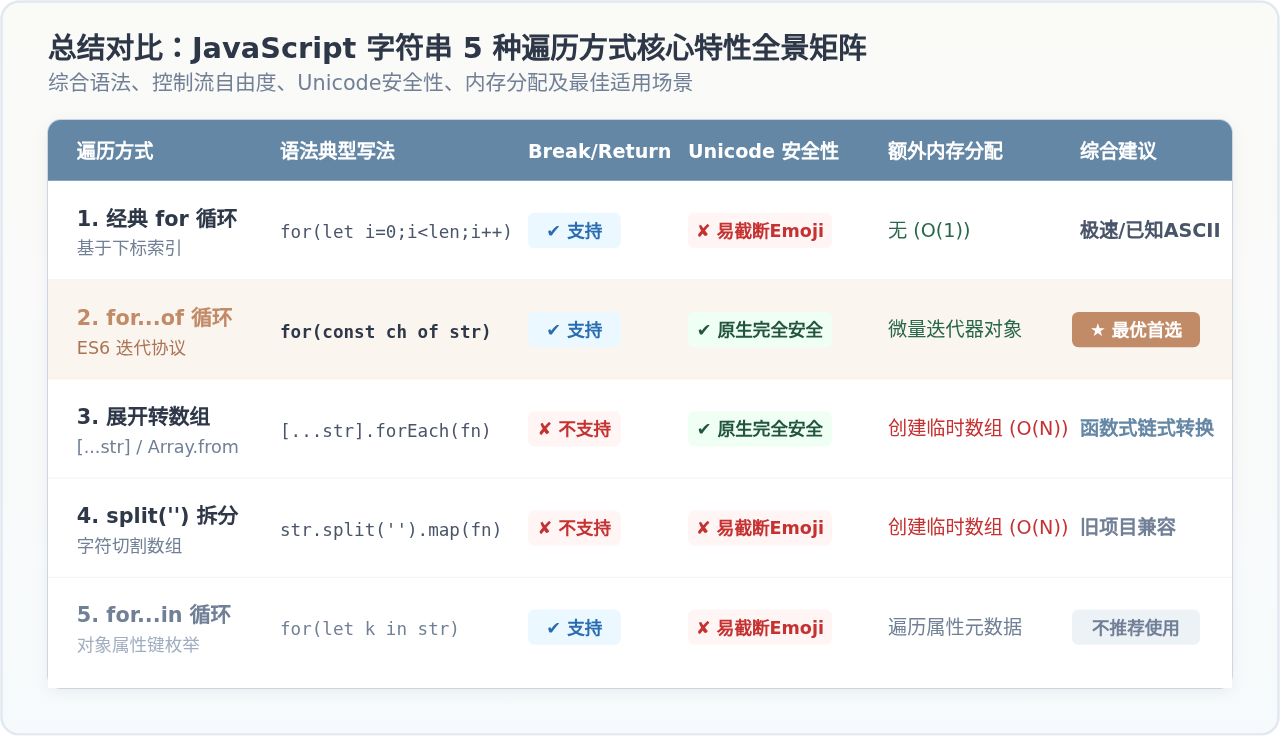
| 遍历方式 | 语法形式 | 支持 break/return | Unicode 码点安全 | 额外内存分配 | 推荐使用场景 |
|---|---|---|---|---|---|
| 经典 for 循环 | for (let i = 0; i < len; i++) |
支持 | 否(易拆裂代理对) | 无(O(1)) | 纯 ASCII 极速计算、自定义复杂步长 |
| for...of 循环 | for (const ch of str) |
支持 | 是(原生自动合并) | 微量迭代器对象 | 日常遍历、通用逻辑首选方案 |
| 展开运算符 / Array.from | [...str].forEach(...) |
不支持 break | 是(原生自动合并) | 创建临时数组(O(N)) | 函数式链式转换、快速过滤映射 |
| split('') 拆分法 | str.split('').forEach(...) |
不支持 break | 否(按码元切分) | 创建临时数组(O(N)) | 老旧 ES5 项目兼容,新项目不建议 |
| for...in 循环 | for (const k in str) |
支持 | 否(读取码元) | 枚举对象属性 | 不推荐(索引为 string,有原型污染风险) |
五、注意事项与常见陷阱排查
在处理 JavaScript 字符串遍历的过程中,以下几点属于极易被忽略的高频陷阱,需在开发过程中重点防范:
-
字符串是原始值(Primitive),具有不可变性(Immutability):
在经典
for循环中,初学者常误认为可以通过str[i] = 'X'原地替换某个字符。在 JavaScript 中,对字符串索引进行赋值操作在非严格模式下会被静默忽略,在严格模式('use strict')下会抛出TypeError。修改字符串必须通过拼接或创建新字符串实现。 -
复合 Emoji(ZWJ 序列)的特殊性:
虽然
for...of解决了单个 4 字节码点的解析,但现代很多 Emoji 是由多个码点通过零宽连字线(Zero Width Joiner,)组合而成的。例如家庭图标👨👩👧👦实际上由 4 个独立人物 Emoji 与 3 个连字线共 7 个码点拼接而成。如果业务对字形簇(Grapheme Cluster)有极苛刻的分词需求,应使用Intl.SegmenterAPI(ES2022):// 使用 Intl.Segmenter 精确按字形簇(Grapheme)分词遍历 const complexEmoji = "👨👩👧👦"; const segmenter = new Intl.Segmenter('zh-CN', { granularity: 'grapheme' }); for (const { segment } of segmenter.segment(complexEmoji)) { console.log(`独立字形: ${segment}`); } // 示例输出: 独立字形: 👨👩👧👦 (不会被拆成多个人物) -
forEach中使用return的行为差异: 在使用[...str].forEach()时,如果在回调函数中写return,其效果仅相当于continue(跳过当前回调继续执行下一次),并不能像普通的for或for...of一样直接终止外层函数。如果需要提前跳出,请选用for...of。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章