

深入解析JavaScript中filter、map、includes、展开运算符与闭包等常用函数的性能陷阱与底层机制,提供单次遍历、哈希索引、原地赋值等切实可行的优化方案与排查实操指南。
怎么避免JS常用函数的性能陷阱?
作者:半夏
时间:2026-11-16
浏览:229
文章目录
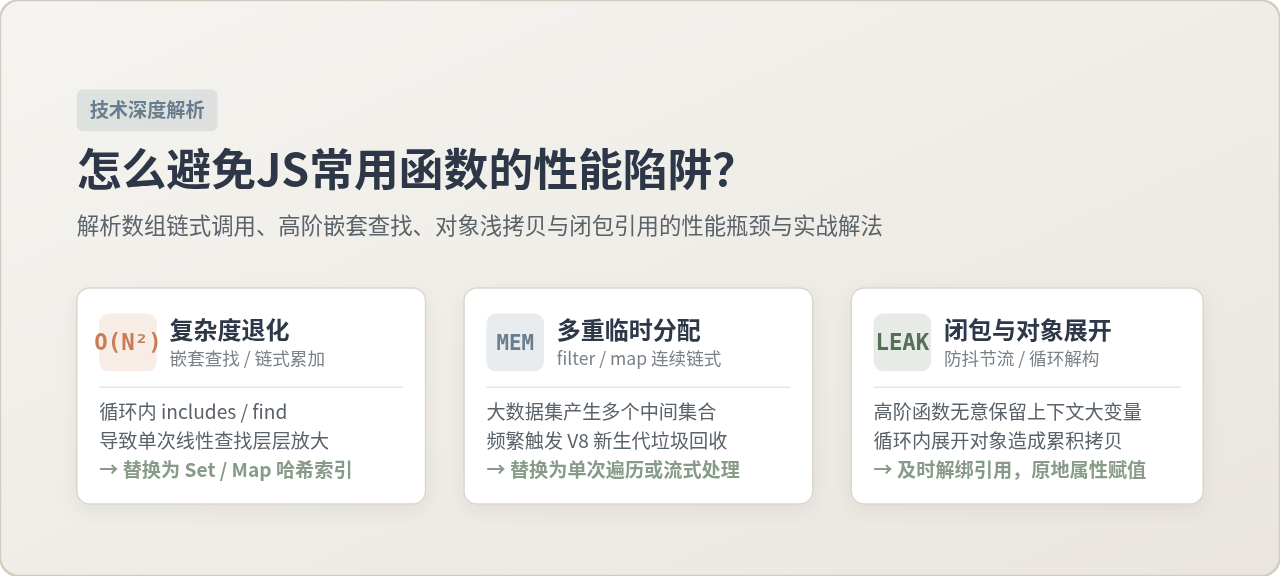
避免 JavaScript 常用函数性能陷阱的核心,在于平衡“算法时间复杂度”、“堆内存临时分配”以及“垃圾回收(GC)开销”。在绝大多数业务场景中,诸如
filter 与 map 的链式调用、高频循环内部的 includes 查找、循环中展开运算符(...)引发的对象重复复制,以及高阶闭包无意保留庞大外部变量,是最容易引发页面掉帧和内存上涨的典型瓶颈。解决这些问题的基本路径是:在大数据量下改用单次遍历消除中间临时数组、使用 Set 或 Map 将多次线性搜索降阶为常数时间哈希查找、在累加操作中采用原地修改,并在异步或事件闭包中规范清理大对象引用。
一、数组高阶方法的链式调用与中间数组分配陷阱
JavaScript 提供的 Array.prototype.filter()、map()、slice() 等链式 API 具备出色的声明式表达能力。但在实际执行时,每一个链式节点都会触发一轮完整的数组遍历,并且都会在堆内存中完整实例化一个全新的中间数组。
当处理的数据体量达到万级以上,或者函数处于高频执行的热点路径(如鼠标移动采样、Canvas 帧渲染循环、实时数据流过滤)时,多重链式调用不仅会导致 CPU 执行时间成倍增加,还会向 V8 引擎的新生代内存区(New Space)瞬间塞入大量生命周期极短的临时集合,迅速触发新生代垃圾回收(Scavenge)甚至主垃圾回收(Mark-Sweep),造成主线程微停顿与页面跳帧。
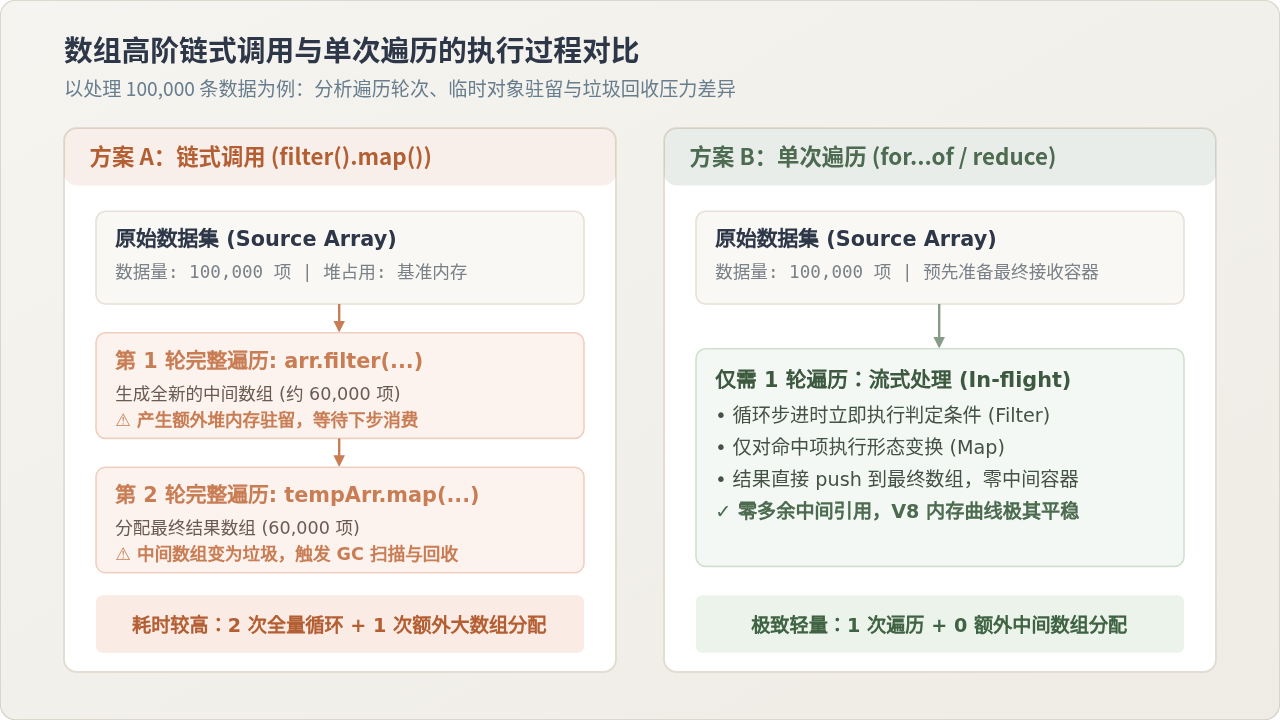
1. 关键差异对比:链式调用 vs 单次遍历
在一致输入条件下(处理 100,000 条包含未支付订单的数据集,筛选出金额大于 100 的订单并提取其金额),对比两者的实际执行逻辑:
// 做法 A:直觉化的链式调用(存在性能陷阱)
function getHighValueAmountsChain(orders) {
  return orders
    .filter(order => order.status === 'unpaid')     // 完整遍历 100k 项,分配 60k 项的中间临时数组
    .filter(order => order.amount > 100)            // 再次完整遍历 60k 项,分配 20k 项的中间临时数组
    .map(order => order.amount);                    // 第 3 次遍历 20k 项,分配最终数组
}

// 做法 B:单次流式遍历(推荐实践)
function getHighValueAmountsSingleLoop(orders) {
  const result = [];
  for (let i = 0, len = orders.length; i < len; i++) {
    const order = orders[i];
    if (order.status === 'unpaid' && order.amount > 100) {
      result.push(order.amount);
    }
  }
  return result; // 仅遍历 1 轮,0 临时对象分配,内存波形近乎水平直线
}
适用边界说明
并不是所有数组处理都需要手动重构为 for 循环。当数组长度在几十到数百项之间时,现代 JavaScript 引擎的优化能力足以抵消这点开销,此时链式调用的清晰与可读性更为重要;但是当数据量超过 5,000 项,或者函数在动画帧 / 定时器内高频执行时,必须将多重链式调用整合为单次遍历。
二、循环嵌套中查找函数退化为 O(N × M) 的陷阱
在批量数据比对、白名单过滤、去重或数据关联映射时,很多开发者习惯在数组的 filter、map 或普通循环体内直接调用 Array.prototype.includes()、indexOf() 或 find()。
由于 includes() 在底层是顺序线性遍历数组指针,单次调用的时间复杂度为 \(O(N)\)。如果将其放置在外层长度为 \(M\) 的循环中,整段逻辑的综合时间复杂度将直接退化为 \(O(N imes M)\)。
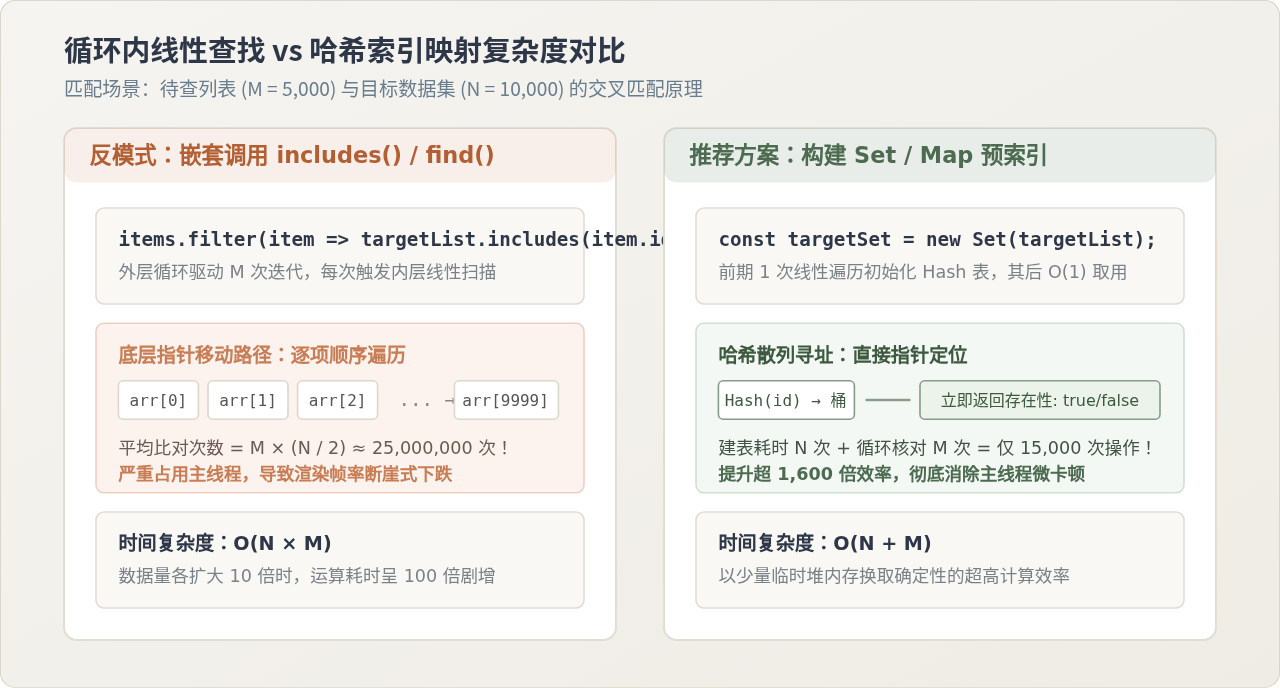
2. 改造方案:预先构建哈希索引(Set / Map)
利用 JavaScript 原生的 Set 或 Map 结构,在循环启动前投入一次性的 \(O(N)\) 开销完成哈希表构建,随后在循环内即可享受 \(O(1)\) 常数时间的精确寻址。
// 陷阱场景:在 5,000 个待处理项中匹配 10,000 个违规 ID 构成的黑名单

// 做法 A:反模式,复杂度 O(N * M),约 25,000,000 次元素指针比对
function filterBlockedBad(users, blockedIds) {
  return users.filter(user => blockedIds.includes(user.id));
}

// 做法 B:哈希化优化,复杂度 O(N + M),仅约 15,000 次操作,耗时从数百毫秒降至个位数
function filterBlockedGood(users, blockedIds) {
  // 步骤 1:预先将数组转化为 Set 哈希集合
  const blockedSet = new Set(blockedIds);

  // 步骤 2:利用 set.has() 在 O(1) 复杂度下进行瞬时核对
  return users.filter(user => blockedSet.has(user.id));
}
如果需要匹配的不仅仅是标量 ID,而是需要根据复杂属性提取对象(类似 SQL 中的 JOIN),则应使用 new Map() 预先将数据集转为字典索引,杜绝使用 arr.find(item => item.key === targetKey) 进行内层暴力扫描。
三、对象展开与浅拷贝的二次方(O(N²))累积复制
在编写数据聚合或统计函数时,使用 reduce 配合对象展开运算符(...)是一种非常常见的函数式写法,例如:
// 隐藏的二次方陷阱写法
const idToUserMap = userList.reduce((acc, user) => {
  return {
    ...acc,           // ⚠ 致命陷阱:每次迭代都会浅拷贝已有 acc 的全部键值对!
    [user.id]: user
  };
}, {});
3. 陷阱本质与原地解法
当 userList 包含 1,000 项时,第 1 次迭代复制 0 个属性,第 2 次复制 1 个,第 1,000 次复制 999 个。总共复制的属性次数为 \(0 + 1 + 2 + \dots + (N-1) = rac{N(N-1)}{2}\),属于典型的 \(O(N^2)\) 二次方算法复杂度。
这不仅造成数百万次无意义的属性键值拷贝,还会瞬间产生 1,000 个在下一次迭代中立刻作废的旧累加对象,引发严重的垃圾回收滞后。
// 修复方案:直接在累积容器上进行原地属性挂载,保持 O(N) 线性复杂度
const idToUserMap = userList.reduce((acc, user) => {
  acc[user.id] = user; // 原地赋值,复用同一对象引用
  return acc;
}, {});

// 或者直接使用更为直接的 Object.fromEntries 配合 map 生成器:
const idToUserMap = Object.fromEntries(userList.map(u => [u.id, u]));
警惕深拷贝函数的滥用
使用 JSON.parse(JSON.stringify(obj)) 实现深拷贝虽然省心,但其内部需要经历全量 JSON 字符串序列化、格式转义与语法解析两整套原生 C++ 管道,执行速度非常缓慢,且无法处理 Date、RegExp、undefined、BigInt 和循环引用。若只需结构化深克隆,应优先使用现代标准 API structuredClone(obj);而对于状态更新场景,更推荐只针对被修改的分支做局部的浅层复制。
四、闭包高阶函数与事件回调的隐匿作用域常驻
防抖(debounce)、节流(throttle)以及事件总线订阅是前端高频使用的辅助函数。这类函数的典型特征是通过返回一个闭包来维护内部的计时器状态(如 timerId)。
由于 JavaScript 词法作用域的闭包机制,内层函数被持久化引用时,它所在的外层函数词法环境(Lexical Environment)中的所有变量都不会被垃圾回收器释放。如果在外层函数作用域中声明了大体积数据结构(如批量请求返回的原始缓冲区或数十兆的日志明细),这些变量将长期被锁定在内存堆中。
// 典型内存滞留示例
function setupSearchFilter(largeDataset) {
  // largeDataset 包含 100,000 条未脱敏原始数据
  const cleanIndex = largeDataset.map(item => ({ id: item.id, name: item.name }));

  // 返回的闭包本意仅使用 cleanIndex
  return debounce(function(keyword) {
    return cleanIndex.filter(i => i.name.includes(keyword));
  }, 300);
  // ⚠ 注意:即使下方没有直接用到 largeDataset,某些 JS 引擎仍可能保留整个词法环境!
}

// 规范做法:显式解除无用的大引用,或将数据处理提取为独立纯函数
function setupSearchFilterSafe(largeDataset) {
  const cleanIndex = largeDataset.map(item => ({ id: item.id, name: item.name }));
  largeDataset = null; // 显式解除对大原始数据的引用,允许 GC 立即回收

  return debounce(function(keyword) {
    return cleanIndex.filter(i => i.name.includes(keyword));
  }, 300);
}
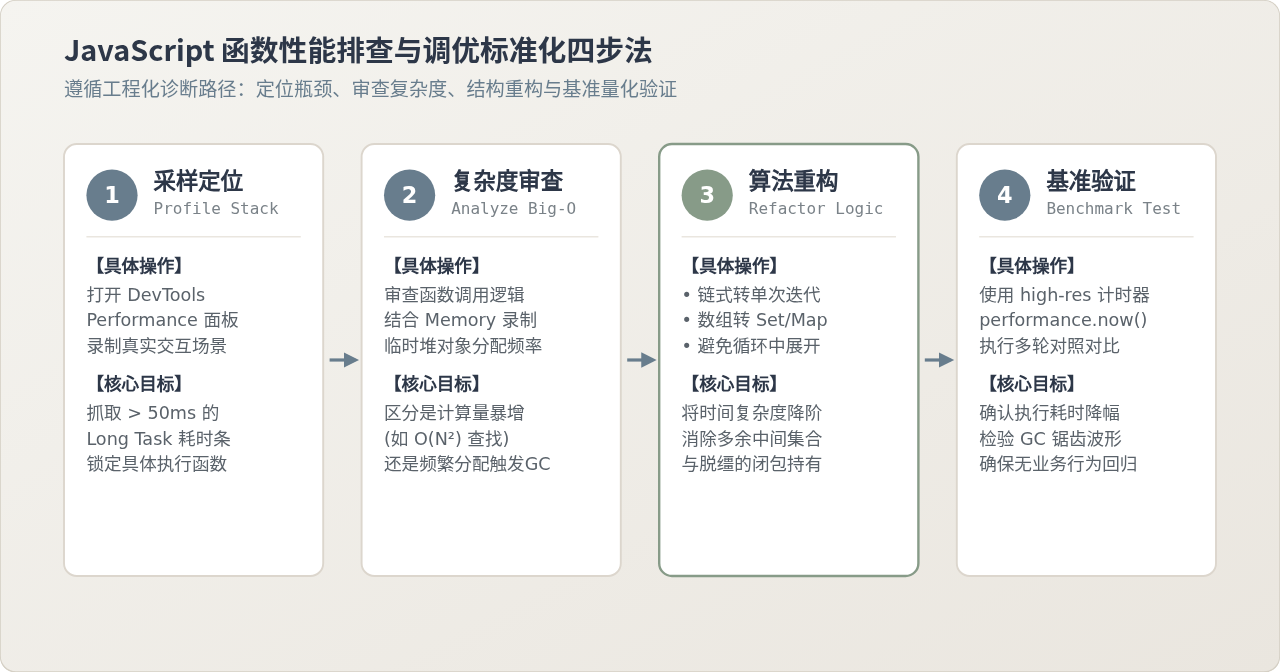
五、实操指南:JS 函数性能排查与调优标准化四步法
遇到运行卡顿或性能瓶颈时,切忌凭空猜测或过早过度优化。请遵循以下标准工程流程排查与验证:
-
步骤一:采样定位(Profile Stack)
打开 Chrome 开发者工具的 Performance 面板,勾选Screenshots和CPU Throttle(模拟 4x Slowdown 移动端环境),点击录制并复现业务操作。在生成的火焰图中,查找标红的Long Task(耗时超过 50ms 的任务条),逐层下钻展开 Call Tree,锁定耗时占比最突出的叶子函数。 -
步骤二:复杂度与分配审查(Analyze Big-O & Memory)
检查目标函数的源码实现:是否存在内层嵌套调用的includes/find/filter?是否存在高频的临时数组或对象展开?切换至 Memory 面板,录制Allocation instrumentation on timeline,观察是否存在密集出现的蓝色分配条与锯齿状的 GC 回收波形。 -
步骤三:算法与数据结构替换(Refactor Logic)
根据分析结果实施针对性重构:- 多层链式调用 → 整合为单次
for/for...of原生循环; - 循环内线性搜索 → 外置
new Set()或new Map()实现哈希常数级查询; - 对象展开累加器 → 改用单一对象的直接属性写入。
- 多层链式调用 → 整合为单次
-
步骤四:基准量化验证(Benchmark & Verify)
使用高精度时间戳performance.now()编写可复现的基准测试用例,在同一批次样本数据下对比重构前后的执行耗时中位数,并复测 DevTools 确认 Long Task 彻底消除。
// 基准测试验证模板
function runBenchmark(label, fn, iterations = 10) {
  const times = [];
  for (let i = 0; i < iterations; i++) {
    const start = performance.now();
    fn();
    const end = performance.now();
    times.push(end - start);
  }
  const avg = times.reduce((a, b) => a + b, 0) / iterations;
  console.log(`[${label}] 平均耗时: ${avg.toFixed(2)} ms`);
}
六、总结:常用函数性能避坑决策矩阵
为了在日常编码中快速决断,下表汇总了常见 JavaScript 内置函数的性能隐患点与优选重构方案:
| 函数类别与方法 | 典型性能隐患 | 触发敏感条件 | 首选重构替代方案 |
|---|---|---|---|
filter().map() |
多次遍历产生全量中间集合,频繁触发新生代 GC 停顿 | 数组项 > 5,000 或动画/高频事件循环中 | 单次 for...of 循环或原生 reduce 单次完成 |
includes() / indexOf() |
在循环内嵌套调用导致时间复杂度退化为 \(O(N imes M)\) | 外层迭代匹配、数据项大于 50 项 | 外部预构建 Set,利用 set.has() 实现 \(O(1)\) 判定 |
find() / findIndex() |
重复线性扫描对象数组中的关键属性 | 多对一关系聚合、字典键匹配 | 外部预构建 new Map([[key, item]]) 进行键值映射 |
{ ...acc, [k]: v } |
循环内展开对象造成累积浅拷贝,复杂度为 \(O(N^2)\) | 在 reduce 中逐步生成汇总大对象 |
原地给累加器挂载属性 acc[k] = v 并直接返回 |
JSON.parse(JSON.stringify()) |
双重文本序列化解析,消耗大量 CPU 且丢失特殊类型 | 深克隆大对象或在热点函数中频繁调用 | 现代标准 structuredClone() 或按需局部浅拷贝 |
debounce / 事件监听器 |
闭包词法环境无意保留大数组或临时变量,阻碍 GC 释放 | 长时间驻留的监听回调引用了局部庞大数据 | 对无用大变量显式置 null,提取纯函数消除上下文依赖 |
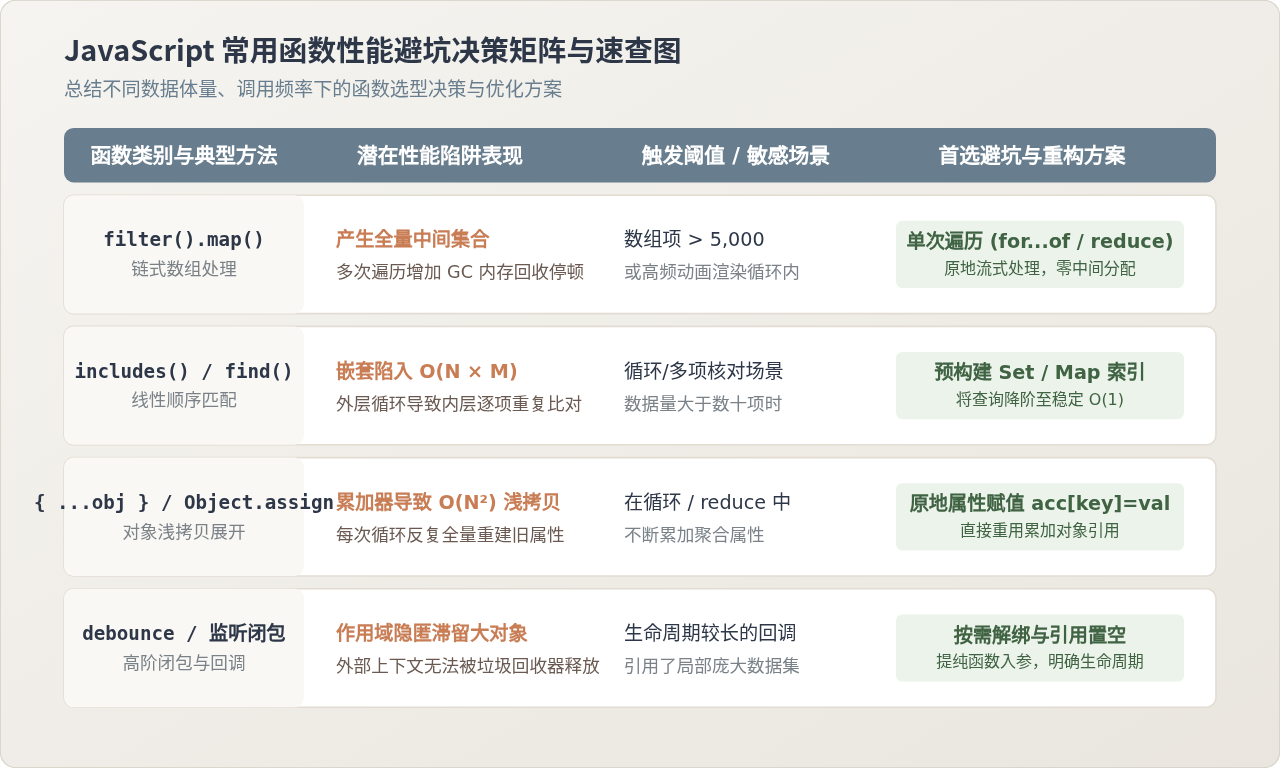
理解 JavaScript 引擎对内存分配与执行栈的处理机制,是写出高性能代码的关键。避免性能陷阱并不意味着放弃优雅的现代语法,而是在面对规模化数据与高频执行场景时,保持对底层时间复杂度与内存垃圾回收的敏锐度,用最合适的工具与数据结构解决对应规模的问题。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章