
深入讲解JavaScript数组去重与扁平化的几种实现方式。涵盖Set、Map、filter、双重循环等去重策略,以及flat、递归解构、显式栈迭代等扁平化方案,包含边界陷阱分析与工业级流水线选型实践。

当前位置:首页 > JavaScript 数组与数据处理 > 正文
JavaScript数组去重与扁平化的几种实现方式
作者:半夏
时间:2026-11-16
浏览:94
文章目录
技术指南
阅读时长:约 10 分钟
核心领域:ECMAScript / 数据结构处理
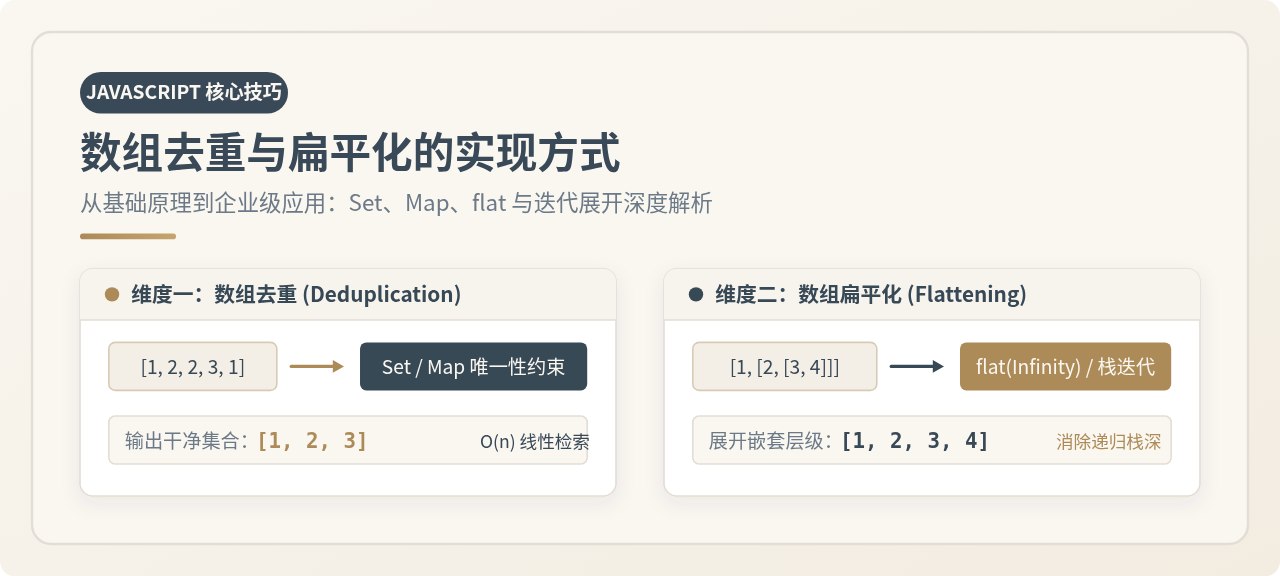
在 JavaScript 开发中,数组去重(去除多余重复元素)与扁平化(将多维嵌套结构降维展开)是清洗接口数据和组织业务状态的两项基础且高频的操作。本文将针对去重与扁平化分别展开剖析,列举工业开发中常见且实用的实现方案,阐明各种方案的内部原理、复杂度开销及边界限制,并展示两者结合处理复杂数据的流水线方案。
一、JavaScript 数组去重的实现方式
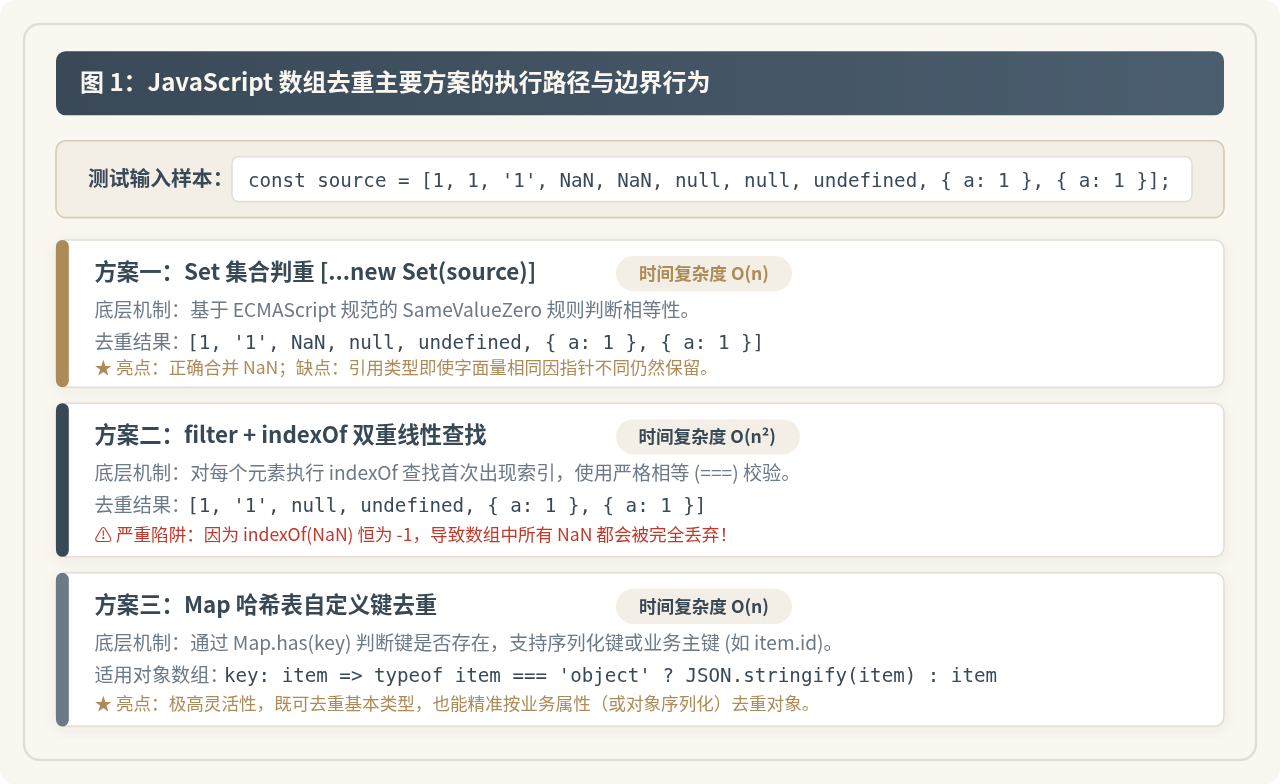
数组去重的核心目标是从包含重复项目的数组中筛选出互不相同的值。不同的判等机制对原始类型、NaN、null、undefined 以及对象引用的处理结果存在显著差异。以下是四种具有代表性的去重方式。
1. Set 集合结合扩展运算符
ES6 引入的 Set 数据结构天然具备元素唯一性约束。使用 new Set(arr) 将原始数组转为集合,再配合扩展运算符(Spread Operator)或 Array.from() 还原为数组,是目前最为推荐的标准做法。
// 基础类型数组去重
const rawNumbers = [1, 2, 2, 3, 1, 4, 3];
const uniqueNumbers = [...new Set(rawNumbers)];
console.log(uniqueNumbers); // 示例输出: [1, 2, 3, 4]

// 包含特殊值的去重
const mixedValues = [1, '1', NaN, NaN, null, null, undefined];
const uniqueMixed = Array.from(new Set(mixedValues));
console.log(uniqueMixed); // 示例输出: [1, '1', NaN, null, undefined]
原理与边界:
Set 内部基于 ECMAScript 规范的 SameValueZero 比较算法。该算法将两个 NaN 视作相等,因此能正确去除重复的 NaN,同时保留严格区分的 1 与 '1'。但对于字面量内容相同但内存引用不同的对象(如 { id: 1 }),Set 仍会视作独立元素保留。其时间复杂度为 O(n),空间复杂度为 O(n)。
2. filter 配合 indexOf / findIndex
在不支持 ES6 或需要利用函数式链式调用的场景中,Array.prototype.filter 是常用的声明式方案。它的原理是通过 indexOf(item) 返回元素在数组中首次出现的下标,若当前元素的下标 index 等于该首次下标,则代表首次遇到该值;反之则为重复项。
function dedupByFilter(arr) {
  return arr.filter((item, index) => arr.indexOf(item) === index);
}

const list = ['apple', 'banana', 'apple', 'orange', 'banana'];
console.log(dedupByFilter(list)); // 示例输出: ['apple', 'banana', 'orange']
陷阱提醒:
indexOf 内部使用严格相等(===)。在 JavaScript 规范中 NaN === NaN 返回 false,因此 arr.indexOf(NaN) 始终返回 -1,导致数组内的所有 NaN 都会被 filter 彻底过滤丢弃!此外,在外层循环中嵌套调用 indexOf 会形成双重扫描,在超大数组中时间复杂度达到 O(n²),性能较弱。
3. Map 哈希表与自定义键去重
在真实业务开发中,最普遍的需求是针对“对象数组”去重(例如根据用户的 id 或 key 字段剔除重复项)。此时 Set 无法直接奏效,使用 Map 以业务键作为哈希索引是最稳妥且高效的手段。
function dedupByProperty(arr, keyProp) {
  const map = new Map();
  return arr.filter(item => {
    const key = item[keyProp];
    if (!map.has(key)) {
      map.set(key, true);
      return true;
    }
    return false;
  });
}

const users = [
  { id: 101, name: '张三' },
  { id: 102, name: '李四' },
  { id: 101, name: '张三(重复)' }
];
console.log(dedupByProperty(users, 'id'));
// 示例输出: [{ id: 101, name: '张三' }, { id: 102, name: '李四' }]
4. 双重循环与排序比较(传统机制)
在旧版 JavaScript 环境中,还可以使用两层 for 循环,外层固定元素,内层向后比对并使用 splice 删除后续相同元素;或者先将数组通过 sort() 排序,使重复元素相邻排布,随后单层循环比对前后项完成剔除。
但这两种传统做法存在明显缺点:splice 会导致数组索引频繁重排,修改原数组破坏不可变性原则;而排序方案不仅会额外消耗 O(n log n) 的时间,还会强行打乱元素原本的排列顺序,因此现代生产环境中不作优先推荐。
二、JavaScript 数组扁平化的实现方式
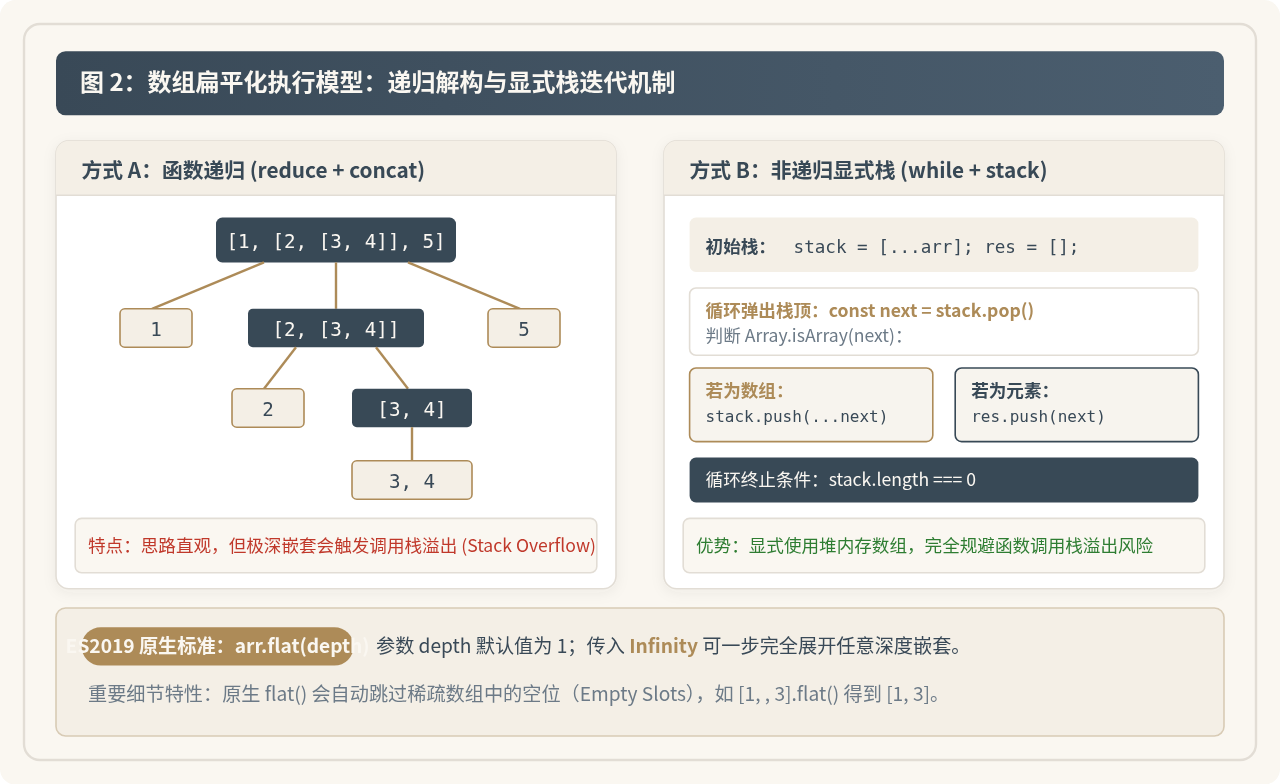
数组扁平化(Flatten)指将多维嵌套的数组(例如 [1, [2, [3, 4]]])转化为一维数组的过程。根据运行环境的支持程度和嵌套深度的不同,开发者可以选择原生 API、递归或非递归迭代等方案。
1. 原生 Array.prototype.flat()
ES2019(ES10)正式引入了原生的 flat() 方法。它接收一个可选的数值参数 depth,用于指定需要展开的嵌套深度,默认值为 1。
const nested = [1, [2, [3, [4]]]];

// 默认扁平化一层
console.log(nested.flat()); // 示例输出: [1, 2, [3, [4]]]

// 扁平化两层
console.log(nested.flat(2)); // 示例输出: [1, 2, 3, [4]]

// 展开任意深度的嵌套:传入 Infinity
console.log(nested.flat(Infinity)); // 示例输出: [1, 2, 3, 4]

// 原生 flat() 的额外特性:自动移除稀疏数组的空位
const sparse = [1, , 3, [4, , 5]];
console.log(sparse.flat()); // 示例输出: [1, 3, 4, empty, 5] (一层展开并跳过最外层空位)
评估:原生
flat() 由 JavaScript 引擎以底层 C++ 实现,运行性能极佳且代码意图直接。只要运行环境为现代浏览器或 Node.js 11+,均应优先采用原生 flat()。
2. 递归解法:reduce 配合 concat
当需要兼容较旧环境或实现自定义展开规则时,递归是最自然的实现手段。借助 Array.prototype.reduce 配合 Array.isArray(),若当前项是数组则递归调用自身,否则直接拼接到累加结果中。
function flattenDeep(arr) {
  return arr.reduce((accumulator, current) => {
    return accumulator.concat(
      Array.isArray(current) ? flattenDeep(current) : current
    );
  }, []);
}

// 扩展:支持自定义 deep 层级的递归函数
function flattenByDepth(arr, depth = 1) {
  if (depth <= 0) return arr.slice();
  return arr.reduce((acc, cur) => {
    if (Array.isArray(cur)) {
      return acc.concat(flattenByDepth(cur, depth - 1));
    }
    return acc.concat(cur);
  }, []);
}
调用栈风险:递归解法的本质是不断压入执行上下文栈。若输入数据源存在过深嵌套(如成千上万层的嵌套数组),会抛出
RangeError: Maximum call stack size exceeded(调用栈溢出错误)。因此在面对未知深度的海量数据时,需谨慎使用深层递归。
3. 非递归显式栈迭代(防栈溢出方案)
为了规避执行上下文调用栈溢出,我们可以利用堆内存中的显式数组模拟“栈”(Stack)数据结构,用循环代替递归展开元素:
function flattenByStack(arr) {
  const stack = [...arr];
  const result = [];

  while (stack.length > 0) {
    const next = stack.pop();
    if (Array.isArray(next)) {
      // 将子数组解开并重新压回栈中
      stack.push(...next);
    } else {
      result.push(next);
    }
  }

  // 因为 pop 导致逆序,返回前通过 reverse 修正顺序
  return result.reverse();
}

const deepArray = [1, [2, [3, [4, 5]]]];
console.log(flattenByStack(deepArray)); // 示例输出: [1, 2, 3, 4, 5]
该方案的所有待处理元素均保存在堆内存的 stack 数组中,不受 JavaScript 运行时函数调用栈深度的限制,能够从容应对极端深度的嵌套数据。
4. 字符串转换降维的适用场景与隐患
部分教程提及使用 arr.toString().split(',') 进行快速扁平化。这种方法利用了数组默认的隐式字符串拼接行为。但其存在严格的约束条件:
- 类型全部退化:原始数组中的数字(如
1)会被转化为字符串"1",后续需要额外的map(Number)转换。 - 对象被抹平:若数组中包含普通对象,对象会被转为
"[object Object]",导致原始数据结构损坏。 - 逗号混淆:若字符串元素本身包含逗号(例如
"hello, world"),按逗号分割会错误截断元素。
因此,字符串转换仅限于纯整型或确定不含逗号的简单标量数组,无法作为通用型扁平化方案。
三、综合流水线:扁平化与去重的协同处理
在前后端交互的复杂场景中,去重与扁平化往往是组合出现的。例如从多层嵌套的评论区中提取所有参与讨论的用户 ID,或者将多级品类目录下的全部标签聚合为一个无重复的列表。
1. 协同处理的执行顺序考量
处理“嵌套且含有重复项”的数据时,先扁平化后去重是标准且合理的处理顺序。原因在于:
- 先去重后扁平化:在多维状态下去重,需要对深层结构做深层对象比较,递归开销巨大,且无法识别“不同父级数组下出现的相同叶子节点”。
- 先扁平化后去重:先把所有叶子节点平铺到同一维度,随后便能以单次
O(n)的哈希扫描完成去重,总体执行效率最高。
2. 工业级流水线封装示例
以下是一个结合了异常保护、平铺降维与高效去重的通用数据清洗函数:
/**
 * 通用多维数组平铺与清洗管道
 * @param {Array} list 原始嵌套数组
 * @param {Function} keyResolver 自定义判重键提取函数(可选)
 * @returns {Array} 扁平化且去重后的标准化数组
 */
function sanitizePipeline(list, keyResolver = null) {
  if (!Array.isArray(list)) return [];

  // 阶段一:平铺至单一维度(忽略空洞元素)
  const flatList = list.flat(Infinity);

  // 阶段二:若未指定复杂对象的提取键,直接通过 Set 进行基础去重
  if (!keyResolver) {
    return [...new Set(flatList)];
  }

  // 阶段三:若包含复杂对象,使用 Map 按 keyResolver 提取的唯一键去重
  const seenMap = new Map();
  return flatList.filter(item => {
    const key = keyResolver(item);
    if (seenMap.has(key)) return false;
    seenMap.set(key, true);
    return true;
  });
}

// 运行验证示例:聚合多组标签数据
const rawTags = [
  ['JavaScript', 'Node.js'],
  ['Node.js', ['Vue', 'React']],
  ['React', 'TypeScript']
];
const cleanTags = sanitizePipeline(rawTags);
console.log(cleanTags);
// 示例输出: ['JavaScript', 'Node.js', 'Vue', 'React', 'TypeScript']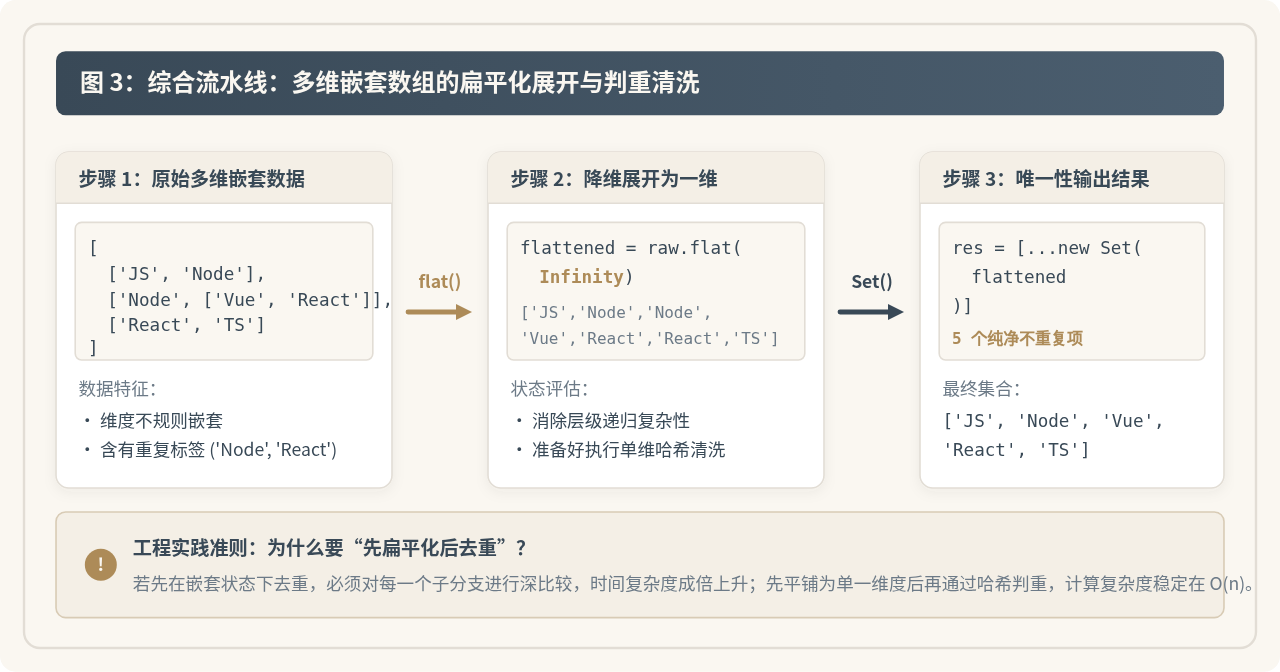
四、方案对比与技术选型指南
面对各种实现途径,开发者应当在算法复杂度、运行时环境支持以及极端数据规模之间做好权衡。下表总结了各方案的核心参数:
| 分类 | 实现方式 | 时间复杂度 | 空间复杂度 | NaN 处理能力 | 推荐适用场景 |
|---|---|---|---|---|---|
| 数组去重 | new Set(arr) |
O(n) | O(n) | 准确保留一个 NaN | 现代标准,基础类型数组首选方案 |
filter + indexOf |
O(n²) | O(n) | 丢失全部 NaN | 旧版 ES5 环境,且数据规模较小 | |
Map 键值映射 |
O(n) | O(n) | 准确支持 | 对象数组根据指定字段(如 ID)去重 | |
| 数组扁平化 | arr.flat(depth) |
O(n) | O(n) | 保留 | 现代运行时推荐方案,语法最简洁 |
reduce + 递归 |
O(n) | O(d) 栈空间 | 保留 | 不支持 flat 的旧环境且嵌套较浅 | |
显式堆栈循环 |
O(n) | O(n) 堆空间 | 保留 | 极深嵌套数据,彻底杜绝调用栈溢出 |
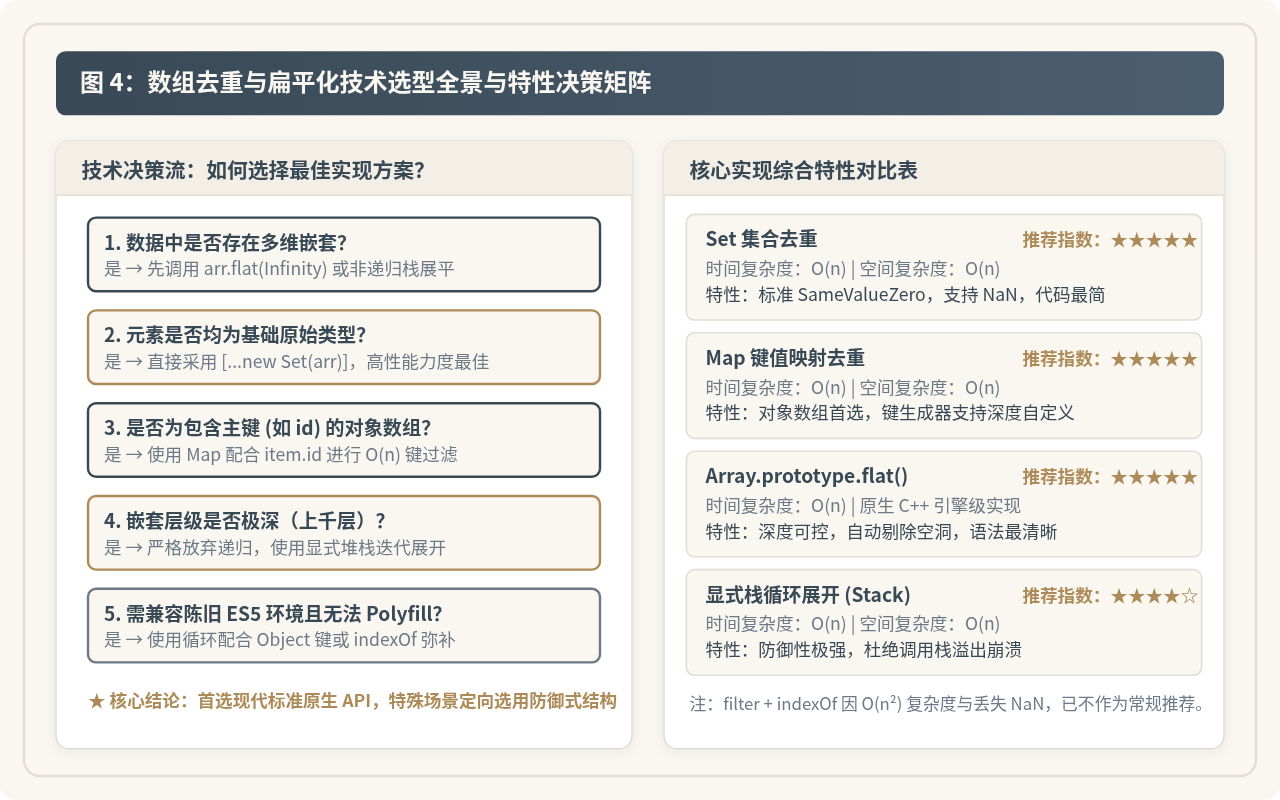
总结与最佳实践准则
- 优先采用 ECMAScript 标准原生能力:对于基础数组去重,优先采用
[...new Set(arr)];对于扁平化,首选arr.flat(Infinity)。它们不仅代码简洁直观,且享有 JavaScript 引擎层面的底层优化。 - 警惕引用类型的判等陷阱:
Set对对象去重依赖内存引用地址。如果需要基于对象属性(如id)去重,必须使用Map建立索引键。 - 防范深层嵌套的堆栈溢出:在构建公共工具库或处理不可控的外部树形输入时,扁平化逻辑建议采用显式栈迭代替代单纯递归,避免极端数据导致服务崩溃。
实用工具推荐
电子包浆
使用 ›绿化、压缩、噪点和虚拟水印,自由调节做旧程度。
图片压缩
使用 ›选择画质和输出格式,预览压缩前后的大小。
作者最新文章
相关文章